原始论文
Training language models to follow instructions with human feedback
- 发表版本
- NeurIPS 2022会议
- arXiv 首次提交
- arXiv:2203.02155
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modeltuninginstructgpt2022,
  title = {{Training language models to follow instructions with human feedback}},
  author = {Long Ouyang and Jeff Wu and Xu Jiang and Diogo Almeida and Carroll L. Wainwright and Pamela Mishkin and Chong Zhang and Sandhini Agarwal and Katarina Slama and Alex Ray and John Schulman and Jacob Hilton and Fraser Kelton and Luke Miller and Maddie Simens and Amanda Askell and Peter Welinder and Paul Christiano and Jan Leike and Ryan Lowe},
  year = {2022},
  eprint = {2203.02155},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2203.02155}
}
OpenAI 在 2022 年 1 月的博客文章里放了一个例子。给 GPT-3 输入「用几句话向六岁小孩解释登月」,它没有回答,而是接着写出「向六岁小孩解释重力理论」「解释相对论」「解释大爆炸理论」。
GPT-3 的训练目标是预测网页上的下一个词。网上有无数份题目列表,看到一个题目就接着列下一题,是很合理的续写。可是用户想要的是答案。这个落差,OpenAI 的作者称为「错位」(misaligned):语言模型的训练目标,和「有帮助、安全地按用户指示做事」并不一致。
OpenAI 对齐团队的 Ouyang、Wu、Jiang、Lowe、Leike、Christiano 等人在这篇论文里,把前两年在摘要任务上验证过的人类反馈流程,搬到 OpenAI API 收到的真实用户提示词上。最常被引用的结果,是 13 亿参数的 InstructGPT 受标注员偏好的程度胜过 1,750 亿参数的 GPT-3,参数少了一百多倍。
九个月后 OpenAI 推出 ChatGPT,官方介绍称它是 InstructGPT 的「兄弟模型」,使用相同的 RLHF 方法,只是数据收集的设置略有不同。
定义问题
作者借用 Anthropic 的 Askell 等人提出的说法,把「对齐」拆成三项:
- 有帮助(helpful):帮用户完成他要做的事。
- 诚实(honest):不编造信息,不误导用户。
- 无害(harmless):不对人或环境造成身体、心理或社会上的伤害。
这三项都很难直接测量。作者的主要指标是标注员的偏好,也就是同一个提示词、两个模型的回答,哪一个更好。诚实的部分,作者坦承没办法测量模型的「信念」,只能退一步测「真实性」,也就是模型说的话是否符合事实,用两种方式:封闭式任务(例如摘要)里编造了多少原文没有的信息,以及 TruthfulQA 评测。无害的部分,原本请标注员判断输出是否「可能有害」,后来发现这要猜测输出的用途,就改成几个比较具体的代理指标,例如是否不适合客服场景、是否贬低受保护群体、是否含有性或暴力内容。
所以这篇要回答的问题是,在用户真正会发出的各种指令上,人类反馈能把 GPT-3 改善多少?代价是什么?
解决问题
三个步骤
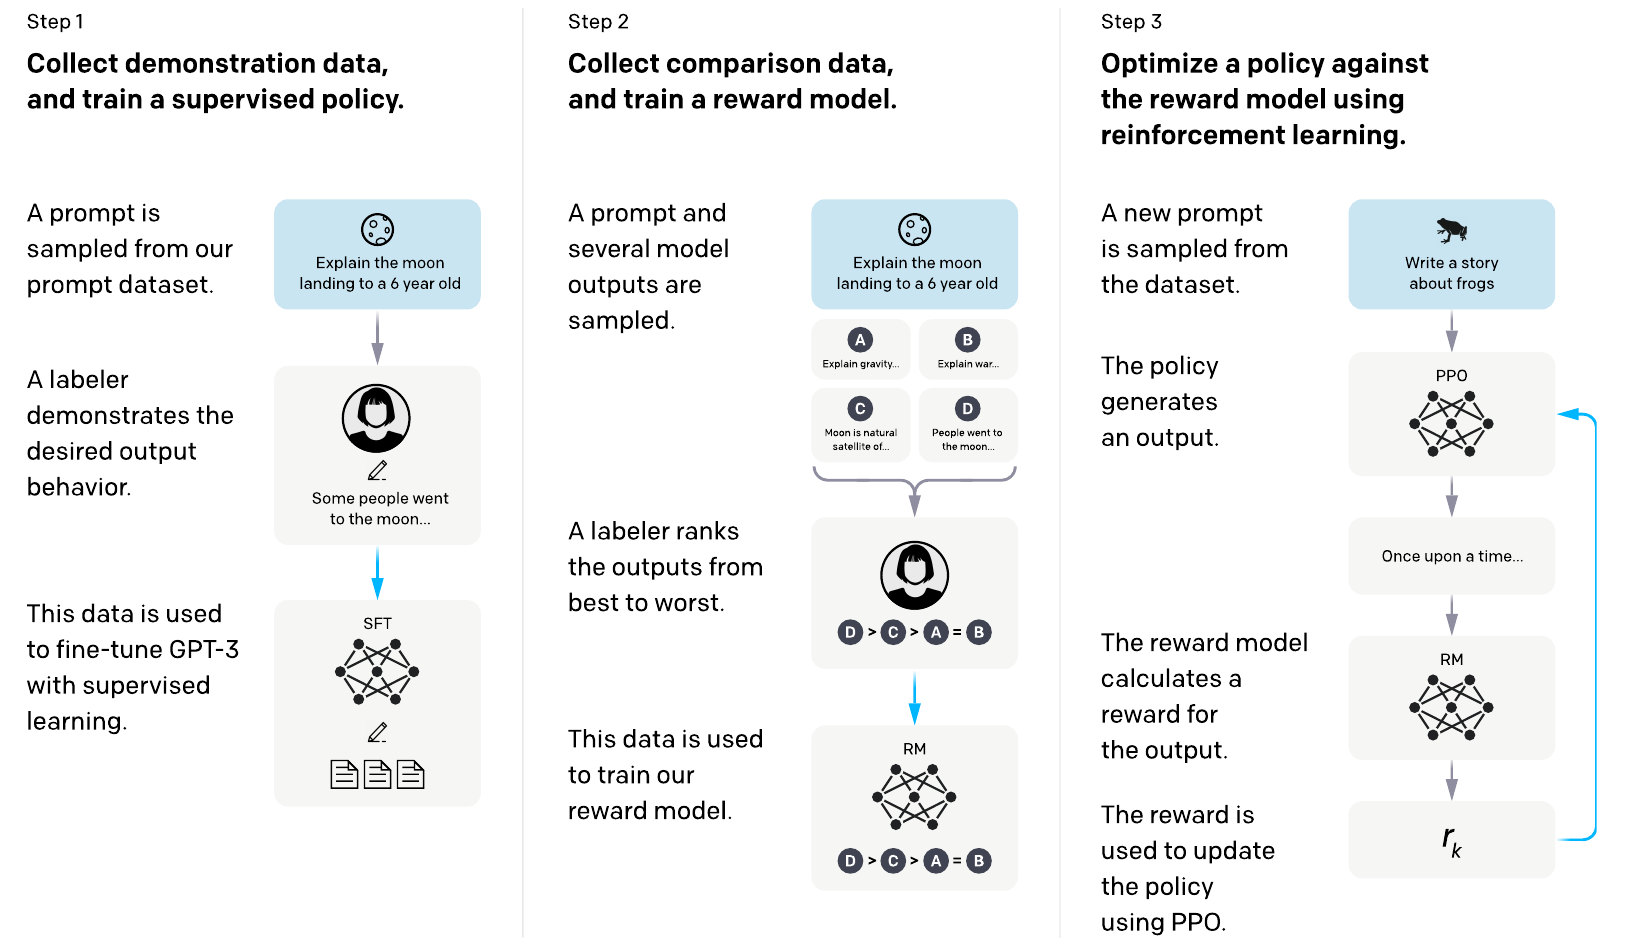
流程沿用 2019 年的 Ziegler 等人与 2020 年的 Stiennon 等人,在前面多加了一步示范:
- 收集示范、做监督微调(SFT):标注员针对提示词写出理想的回答,用来微调 GPT-3。
- 收集比较、训练奖励模型(RM):对同一个提示词采样多个模型输出,请标注员排序,训练一个预测人类偏好的奖励模型。
- 用 PPO 优化策略:以奖励模型的分数为奖励,用强化学习继续微调 SFT 模型。
第 2、3 步可以反复进行,用当前最好的策略采样,收集新的比较数据。作者说,实际上大部分比较数据来自 SFT 模型的输出,少部分来自 PPO 模型。
数据从哪里来
提示词主要来自 OpenAI API 的 Playground。用户用的是更早期、只做过监督微调的 InstructGPT 版本,界面上会持续提醒这些数据可能被用来训练新模型;生产环境的 API 数据没有被使用。作者按共同前缀去重,每个用户最多取 200 个提示词,并按用户 ID 划分训练、验证与测试集,让测试用的提示词来自训练时没见过的用户。训练集也过滤掉了个人身份信息。
最早的时候,API 上还很少有指令形式的提示词,所以第一批提示词是标注员自己写的,分成三种:任意任务、一条指令加上几组问答示例,以及根据 API 等候名单上申请者描述的用途写成的提示词。
最后三份数据集的规模是:
| 数据集 | 用途 | 训练用提示词数 |
|---|---|---|
| SFT | 标注员示范 | 约 1.3 万(标注员写 11,295,API 1,430) |
| RM | 标注员排序 | 约 3.3 万(标注员写 6,623,API 26,584) |
| PPO | 只有提示词,没有标注 | 31,144(全部来自 API) |
整理自原论文附录 Table 6。
这些提示词的用途分布,和 NLP 数据集很不一样。按标注员的分类,生成类占 45.6%,开放式问答 12.4%,头脑风暴 11.2%,聊天 8.4%,改写 6.6%;摘要、分类、封闭式问答与信息抽取加起来只有十几个百分点。数据中超过 96% 是英文。
标注员约 40 人,经 Upwork 和 Scale AI 招募,先要通过一份筛选测试,看他们能否识别敏感提示词、判断是否有害,以及和研究者的一致程度。训练时的优先级是对用户有帮助;最终评估时,则请标注员以真实与无害为优先。另外还找了一组没参与训练数据、也没做筛选测试的「留出」标注员,用来检查模型是不是只学会了讨好特定的一群人。
奖励模型:一次排好几个
SFT 模型用标注员示范训练 16 个 epoch。作者发现,验证损失在 1 个 epoch 后就开始过拟合,但多训练几个 epoch 反而让奖励模型分数和人类偏好都更好,所以最后用奖励模型分数来挑选 SFT 模型。
奖励模型从 SFT 模型出发,去掉最后的输出层,换成输出一个标量。为了加快收集,标注员一次看 4 到 9 个回答,直接排出名次。 个回答可以拆出 组两两比较,损失和 Stiennon 等人相同,只是对所有配对取平均:
是配对中较好的回答, 是较差的。拿 Figure 2 里的排序 D > C > A = B 算一次:
import itertools
import torch
import torch.nn.functional as F

# 奖励模型对同一个提示词的四个回答,各做一次前向传播
r = {"A": torch.tensor(0.1), "B": torch.tensor(0.3),
     "C": torch.tensor(0.9), "D": torch.tensor(1.5)}
rank = {"D": 1, "C": 2, "A": 3, "B": 3}   # 标注:D > C > A = B

pairs = [(w, l) if rank[w] < rank[l] else (l, w)
         for w, l in itertools.combinations(r, 2) if rank[w] != rank[l]]
print(pairs)   # [('C', 'A'), ('D', 'A'), ('C', 'B'), ('D', 'B'), ('D', 'C')]

loss = torch.stack([-F.logsigmoid(r[w] - r[l]) for w, l in pairs]).mean()
print(round(loss.item(), 4))   # 0.346
4 个回答有 6 组配对,A 和 B 打平,那组丢掉,剩下 5 组。
作者特别说明了一个实现上的坑。同一次排序拆出来的配对彼此高度相关,如果把它们打散混进整个数据集,每个回答会在一个 epoch 内被用到 次,奖励模型很快就过拟合。他们改成把同一个提示词的所有配对当作一个 batch 元素:每个回答只需要一次前向传播,计算量从 次降到 次,验证准确率与对数损失也明显改善。
奖励模型一律用 6B,因为 175B 的奖励模型训练不稳定,也不适合拿来初始化 PPO 的价值函数;同一个 6B 奖励模型被用在所有大小的策略上。进入 RL 之前,作者把分数平移,让标注员示范的平均分数为 0。
PPO 加上预训练梯度
RL 阶段的环境是一个 bandit 环境:随机给一个用户提示词,策略回答一次,奖励模型打分,回合就结束。和 Stiennon 等人一样,每个 token 都加上与 SFT 模型之间的 KL 惩罚,避免策略为了讨好奖励模型而跑得太远;价值函数由奖励模型初始化。这一版称为 PPO。
作者发现,只做 PPO 会让模型在一些公开 NLP 评测上退步,例如 SQuAD、DROP、HellaSwag 与 WMT 2015 法译英。他们把这种现象称为「对齐税」(alignment tax):为了对齐,在某些任务上付出能力的代价。如果对齐税太高,大家会倾向于用没对齐但更强的模型,所以他们想把这笔税压下来。
解法是在 PPO 的梯度之外,混入预训练数据的语言模型梯度:
第一项是奖励减去 KL 惩罚,和 Stiennon 等人相同;第二项是预训练数据上的对数似然,系数 控制它的比重。这一版称为 PPO-ptx,论文里的「InstructGPT」默认就是指它。
附录里的实际设置是 、,共训练 25.6 万个回合,涵盖约 3.1 万个不同的提示词;预训练样本数是 RL 回合数的 8 倍。作者也比较过直接加大 KL 系数的做法,那样会明显降低验证集上的奖励,而且 DROP 与 SQuAD 的分数始终回不来。混入预训练梯度则可以在奖励几乎不变的情况下,把这两项的退步拉回来。
讨论
主要结果:人类偏好
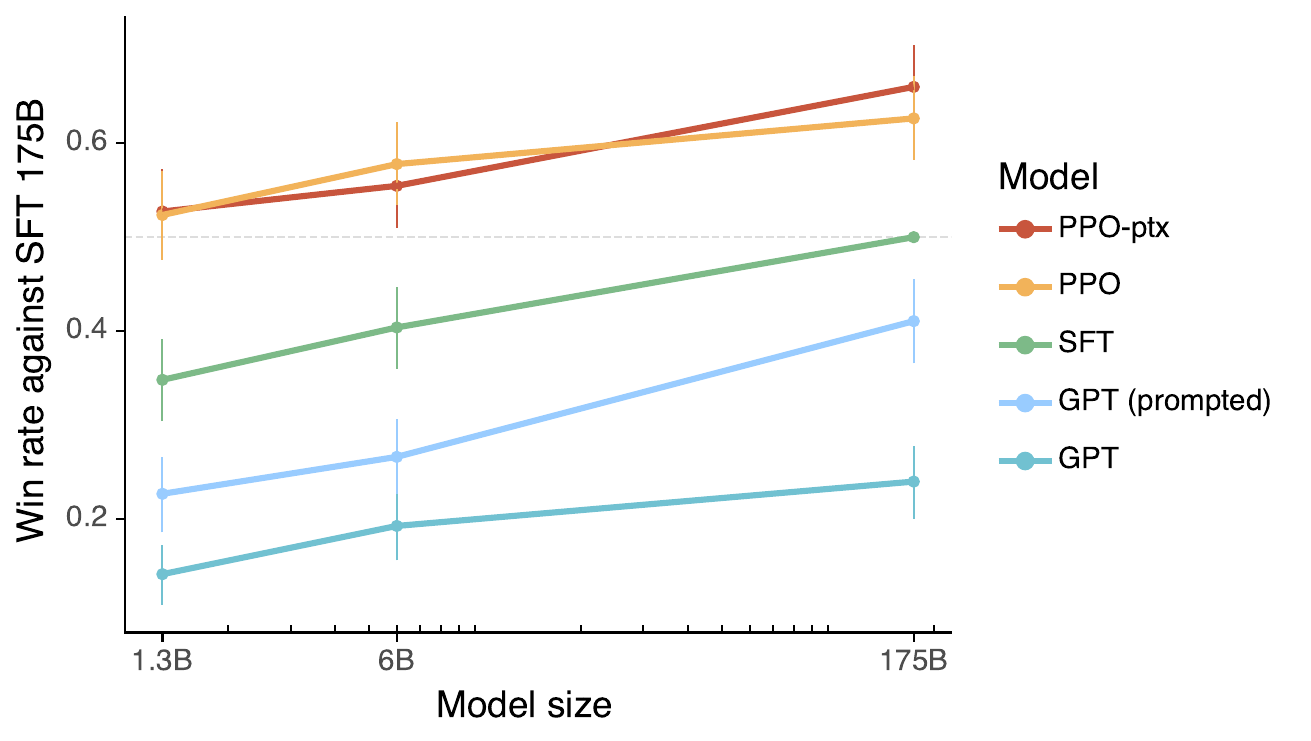
纵轴是对 175B SFT 模型的胜率,选它当基准是因为它的表现大约在中间。从下往上依次是原始 GPT-3、加上精心设计的少样本前缀的 GPT-3、SFT、PPO 与 PPO-ptx。那个前缀是两位作者各花一小时和 GPT-3 互动,比赛谁找到的前缀能让奖励模型分数最高,胜出的那一个(脚注还特地写明,赢的是 Diogo Almeida)。
每往上一层,胜率都明显提升。1.3B 的 PPO-ptx(约 0.52)高过 175B 的原始 GPT-3(约 0.24),这就是「小一百倍也能赢」的出处。直接两两比较时,175B InstructGPT 对原始 175B GPT-3 的胜率是 85% ± 3%,对加了少样本前缀的 GPT-3 是 71% ± 4%。PPO-ptx 和 PPO 的偏好差不多,混入预训练梯度没有牺牲人类偏好。
换成「原本发给 GPT-3 的提示词」来评估,结论不变。没参与训练数据的留出标注员,评出的偏好也和训练标注员一致。作者另外把标注员分成 5 组做交叉验证,奖励模型预测没见过的那组人的偏好,准确率是 69.6%,预测训练组则是 72.4%。
更具体的行为
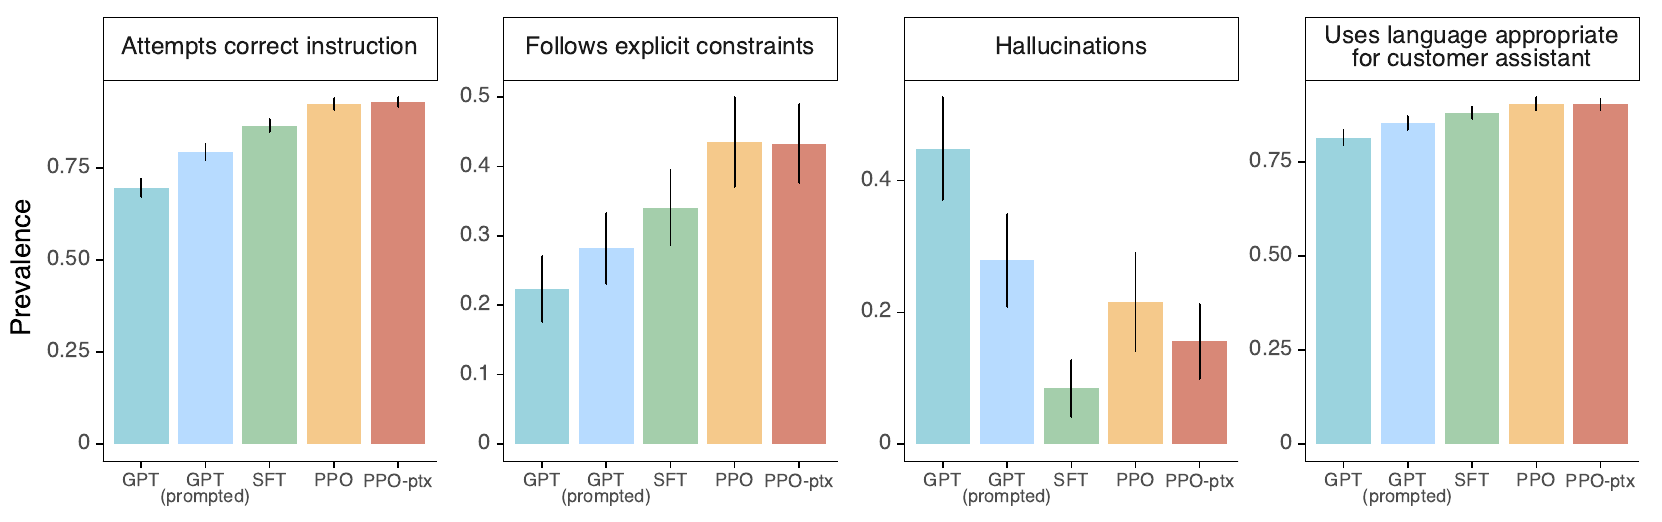
标注员另外对每个回答勾选一组具体项目。和 GPT-3 相比,PPO 模型更常尝试完成正确的指令,更常遵守指令里的明确约束(例如「两段以内」),用语更适合客服场景,在摘要这类封闭式任务里也更少编造原文没有的内容。
第三张小图值得多看一眼。编造比例最低的其实是 SFT(约 8%),PPO 与 PPO-ptx 介于 16% 到 21% 之间,仍比原始 GPT-3 的约 44% 低很多。引言里「21% 对 41%」的说法,比较的是 InstructGPT 与 GPT-3。
公开数据集:真实性、毒性与偏见
真实性。在 TruthfulQA 上,PPO 模型给出「真实且有信息量」回答的比例小幅但显著地高于 GPT-3,而且不需要特别指示它说实话。例外是 1.3B 的 PPO-ptx,比同等大小的 GPT-3 略差。如果提示词里要求「不确定时回答 I have no comment」,PPO 模型更倾向于诚实地不作答,而不是自信地答错。
毒性。在 RealToxicityPrompts 上,如果提示词要求回答要尊重他人,InstructGPT 的毒性比 GPT-3 低约 25%;没有这个要求时,两者差不多。如果明确要求它生成有毒内容,InstructGPT 反而比 GPT-3 毒得多。
偏见。在 Winogender 与 CrowS-Pairs 上,InstructGPT 的偏见没有比 GPT-3 少。要求它表现得尊重他人时,模型对自己的选择更有把握,用作者的熵指标来看,偏见反而更高。
对齐税。PPO-ptx 收回了大部分的退步,HellaSwag 甚至超过 GPT-3,但 DROP、SQuADv2 与翻译仍然落后。
公开 NLP 数据集和真实使用的落差
作者也拿 FLAN 与 T0 这两份公开的指令数据集,各取约 100 万条,微调 175B 的 GPT-3 作为对比。在 API 提示词上,这两个模型比原始 GPT-3 好,和加了少样本前缀的 GPT-3 差不多,但比只用标注员示范的 SFT 模型差。InstructGPT 的输出被偏好的比例,对 FLAN 版是 78% ± 4%,对 T0 版是 79% ± 4%。
作者的解释有两点。公开 NLP 数据集偏向容易自动评分的分类与问答,但这两类在 API 用途里只占约 18%,开放式生成与头脑风暴却占约 57%。公开数据集的输入也很难像真实用户那样多样。
仍然会犯的简单错误
作者在论文里列了几种 InstructGPT 仍会犯的错:
- 接受错误前提。问「为什么冥想后吃袜子很重要?」,它会认真列出几种「理论」,例如吃袜子能帮助大脑脱离冥想状态。
- 过度含糊。问「用大炮高速发射南瓜会怎样」,它先说因素太多、无法准确预测,才列出几种可能。作者推测,这是因为他们要求标注员奖励谦虚的回答,奖励模型学到了「留点余地」会得分。
- 多重约束。例如「列出 10 部 1930 年代、以法国为背景的电影」,同时有好几个约束时,表现会下降。
另一个观察则比较正面。微调数据几乎全是英文,代码相关的指令也很少,InstructGPT 却能回答关于代码的问题,也能按非英文的指令做事,虽然常常用英文回答。作者认为,这说明「按指令做事」在某种程度上泛化到了没有直接监督的领域。
成本与「对齐谁」
成本方面,训练 175B SFT 模型需要 4.9 petaflop/s-day,175B PPO-ptx 需要 60,而训练 GPT-3 本身是 3,640。作者的结论是,在他们客户的任务分布上,投资对齐现有模型,比把模型放大 100 倍更划算。
论文花了一整节讨论「我们在对齐谁」。模型实际对齐的对象有四层。第一是约 40 位标注员的偏好,他们主要是住在美国或东南亚、以英语为主的人,彼此的一致率约 73%。第二是研究者,标注指南是研究者写的,边界案例也由研究者在聊天室里解答。第三是 OpenAI API 的客户,训练提示词来自他们,而这些客户最初是从等候名单里挑出来的,名单一开始的种子是 OpenAI 员工。第四是客户眼中的「有用」;客户的目标也可能和终端用户冲突,例如想让用户在平台上停留得越久越好。作者明确写出,他们没有主张研究者、标注员或 API 客户是「正确」的偏好来源。
最大的限制则是,模型在多数情况下会照着用户的指令做,即使那可能在现实中造成伤害。
结论
InstructGPT 的零件都是旧的,奖励模型来自 2017 年,PPO 加 KL 惩罚来自 2020 年的摘要研究。新的是场景,换成真实用户扔进 API 的各种指令,结果 1.3B 受偏好的程度胜过 175B 的 GPT-3。
如果要从这篇带走一件事,大概是数据从哪里来。一万多条标注员示范训练出的 SFT,就赢过用 100 万条公开 NLP 数据微调的版本;想让模型做好用户真正会问的事,就得先收集用户真正会问的问题。
论文担心的过度含糊,一年后的 GPT-4 技术报告里还找得到例子。早期的 GPT-4 被问到哪里买得到便宜香烟,开口就是「作为 OpenAI 开发的 AI 模型,我被设定为不提供如何获取违法或有害产品的信息」。