原始论文
Learning to summarize from human feedback
- 发表版本
- NeurIPS 2020会议
- arXiv 首次提交
- arXiv:2009.01325
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modeltuninglearningtosummarize2020,
  title = {{Learning to summarize from human feedback}},
  author = {Nisan Stiennon and Long Ouyang and Jeff Wu and Daniel M. Ziegler and Ryan Lowe and Chelsea Voss and Alec Radford and Dario Amodei and Paul Christiano},
  year = {2020},
  eprint = {2009.01325},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2009.01325}
}
训练摘要模型的标准做法,是用人写的参考摘要做监督学习,再用 ROUGE 评分。
这两件事都只是「好摘要」的近似。最大似然估计会要求模型把概率分给每一份人写的摘要,包括写得很差的那些;它也分不出重要错误和无关紧要的错误,捏造事实和选错同义词,在损失函数里差不多。ROUGE 计算的是和参考摘要重叠的词,它和人类判断的相关性一直受到批评。
OpenAI 的 Stiennon、Ouyang、Wu、Ziegler 等人在 2020 年 9 月发表了这篇论文。他们直接让人比较两份摘要,学一个预测人类偏好的奖励模型,再用强化学习优化它。结果是 13 亿参数的模型,被标注者偏好的比例超过了规模大 10 倍的监督模型,也超过了数据集里人写的参考摘要。
这套流程沿用 2017 年 Christiano 等人的「从偏好学奖励」,把视频片段换成了文本摘要;团队负责人正是 Christiano。一年半后的 InstructGPT,几乎原封不动地用上了这三个步骤。
定义问题
作者选摘要作为测试任务,原因是它有很长的研究历史,而且质量很主观,不靠人判断很难衡量。
数据集是 Reddit 的 TL;DR:约 300 万篇帖子,每篇附有原作者自己写的「太长不看」摘要。作者过滤掉一般人看不懂的子版块,并且只保留参考摘要长度在 24 到 48 个 token 之间的帖子,尽量排除长度对质量判断的影响,最后剩下 123,169 篇。(这份过滤后的数据后来成了 RLHF 的常用考题,三年后 DPO 论文的摘要实验用的也是它。)
他们刻意没用更常见的 CNN/DailyMail 新闻摘要。在 CNN/DM 上,直接取文章前三句的 lead-3 基线就很强,标注者甚至更喜欢 lead-3,胜过数据集的参考摘要;低温采样的 T5 已经超过参考摘要,而且大量照抄原文。TL;DR 上的抽取式基线则表现很差,更能看出模型真正的摘要能力。
任务的定义是生成少于 48 个 token、质量尽可能好的摘要。质量看的是一位只读摘要、不读原文的读者,能多忠实地理解原文在说什么。
前一年,同团队的 Ziegler 等人已经在 TL;DR 和 CNN/DM 上试过人类反馈,但遇到一个问题。他们报告说,模型学到的「质量」和研究者想要的不一样。标注者觉得好的摘要,在研究者看来质量一般,而且模型变得几乎只会照抄原文。那么,要怎么让人类反馈真正反映研究者想要的质量?
解决问题
三个步骤
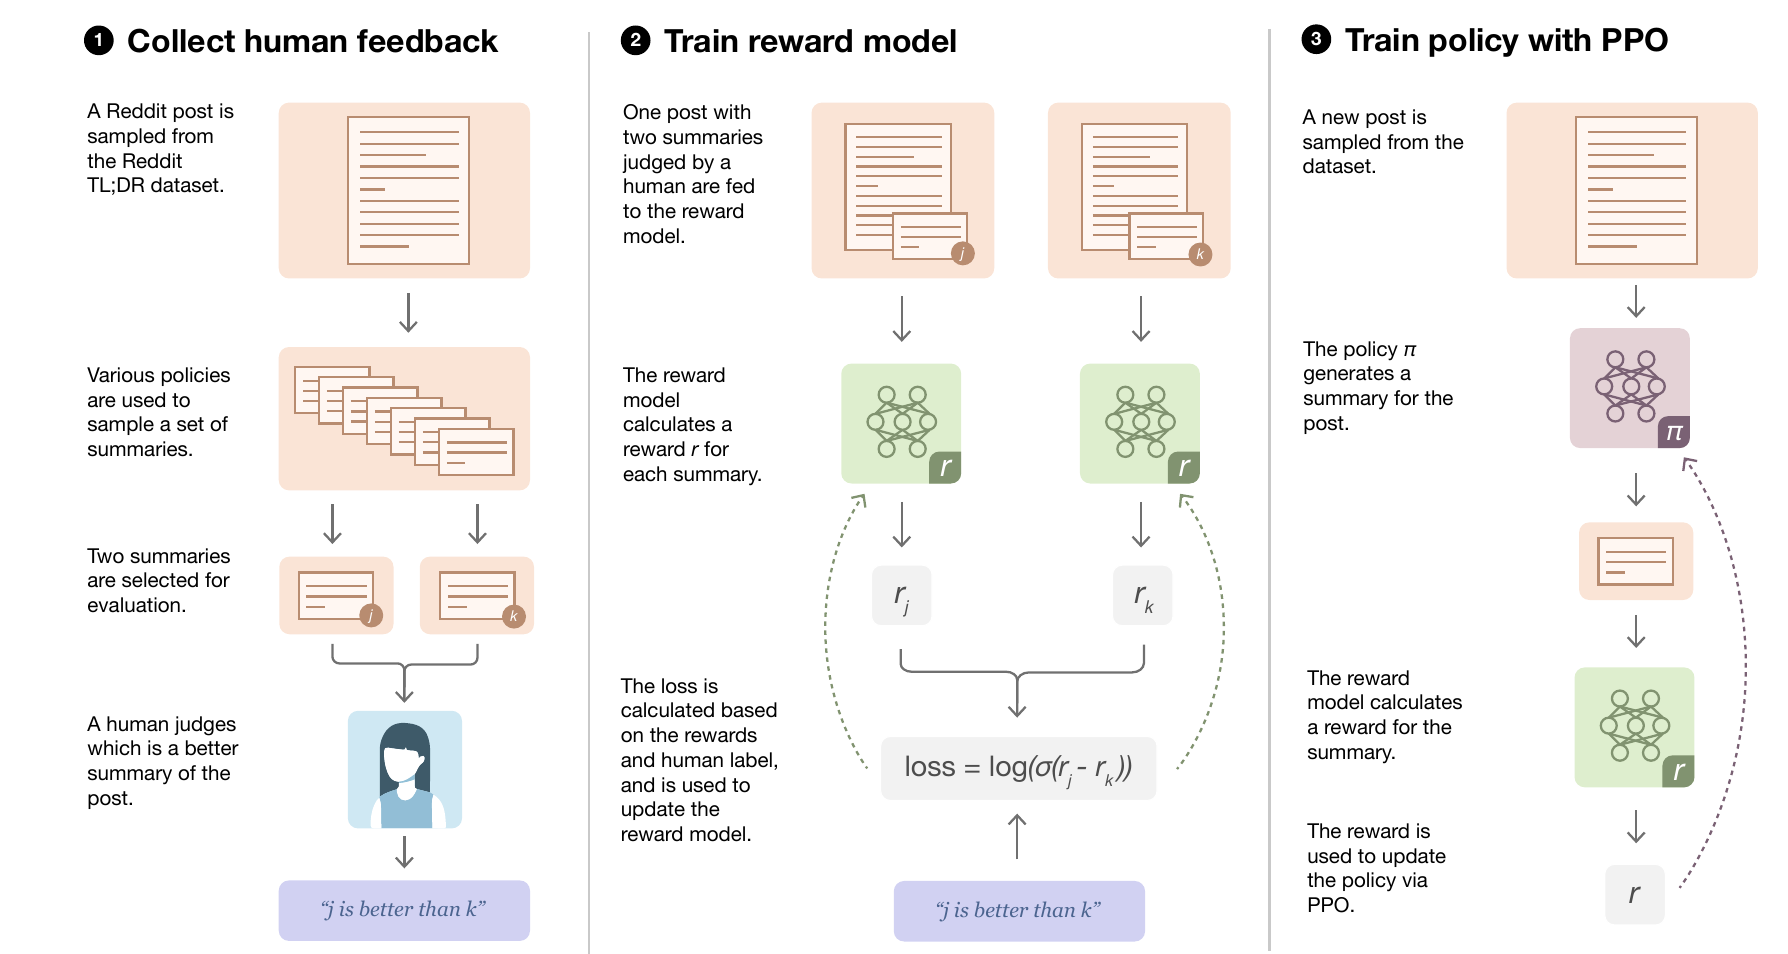
- 收集人类比较:对每篇帖子,从当前策略、初始策略、参考摘要与各种基线中采样摘要,两两交给标注者,请他们挑出更好的那份。
- 训练奖励模型:给定帖子与一份摘要,预测这份摘要被人选中的对数几率。
- 用 PPO 优化策略:把奖励模型的输出当作奖励,用强化学习训练摘要模型。
这三步可以反复进行,新策略的采样再送回去给人比较。作者也坦承,实际做法没有严格按轮次循环,而是在积累标注的过程中不断调整数据收集与训练方式。
所有模型都是 GPT-3 风格的 Transformer 解码器,主要实验用 13 亿(1.3B)和 67 亿(6.7B)参数。起点是在 TL;DR 上做过监督微调的模型,后面称为 SFT 模型;它同时用来生成最初的比较样本、初始化策略与奖励模型,也是比较的基线。
奖励模型
奖励模型从 SFT 模型出发,在最后接一个随机初始化的线性层,输出一个标量 , 是帖子, 是摘要。如果人选了 ,损失是:
这和 2017 年那篇的 Bradley–Terry 损失是同一回事,只是两段轨迹的奖励总和,换成了两份摘要各自的分数。 是 sigmoid,两份摘要的分差越大,模型越确定人会选哪一份。训练结束后,作者把输出平移到让参考摘要的平均分为 0。
策略:PPO 加上 KL 惩罚
策略同样从 SFT 模型初始化。每生成一个 BPE token 算一步,一份摘要结束(输出 EOS)就是一个回合,奖励模型只在最后给整份摘要打一次分,折扣因子 。
关键的设计是在奖励里加一项 KL 惩罚:
是正在训练的策略, 是冻结的 SFT 模型。如果策略生成的摘要,在 SFT 模型看来概率很低,第二项就会很大,扣掉的分数也多。
我们拿一份只有 4 个 token 的摘要算一遍。实现上常把 KL 惩罚分摊到每个 token,奖励模型的分数只加在最后一个 token 上:
import torch

beta = 0.05
rm_score = torch.tensor(2.0)                       # 奖励模型对整篇摘要的打分
logp_rl = torch.tensor([-1.2, -0.4, -2.0, -0.7])   # RL 策略生成每个 token 的对数概率
logp_sft = torch.tensor([-1.5, -0.5, -3.1, -0.9])  # SFT 模型对同样 token 的对数概率

log_ratio = logp_rl - logp_sft     # tensor([0.3000, 0.1000, 1.1000, 0.2000])
rewards = -beta * log_ratio        # 每个 token 先扣 KL 惩罚
rewards[-1] += rm_score            # 奖励模型的分数只加在最后一个 token 上
print(rewards)                     # tensor([-0.0150, -0.0050, -0.0550,  1.9900])
print(rewards.sum())               # tensor(1.9150)
加起来就是上面的 。第三个 token 是 RL 策略比 SFT 模型更偏好的写法,对数比值 1.1,被扣得最多。 在论文的主要实验里是 0.05。
作者说这项惩罚有两个作用。一是像熵奖励一样鼓励探索,避免策略坍缩到单一的写法。二是让策略的输出别离奖励模型在训练时见过的摘要太远;奖励模型只在 SFT 模型附近的摘要上学过,离得太远,它的分数就不可信。
PPO 的价值函数也是一个独立的 Transformer,和策略完全不共享参数,并用奖励模型的权重初始化。作者的消融显示,共享参数时,训练初期价值函数的更新会破坏预训练好的策略。代价是 RL 阶段要多占一整个模型的显存,策略、价值函数、奖励模型和计算 KL 用的 SFT 模型,是四个同样大小的模型。
标注的质量
前作的问题出在标注。作者做了两项改变。第一,完全改成离线收集:一次送一大批比较给标注者,收齐后用积累的所有数据重新训练,不再边训练边收。第二,和标注者保持密切合作。
研究者先自己做大量比较、讨论分歧,写出标注指南;标注者要经过一段付费的培训,前期会立即看到研究者选了哪一份、理由是什么;通过速度与一致率门槛的人才留下。正式标注时,标注者要先在不看原文的情况下,写下自己对摘要的「朴素解读」,再用 9 级量表表示自己多确定 A 比 B 好。每个人会分到 10% 到 20% 的共同题目用来校准;团队开了一个共享聊天室回答问题,偶尔和标注者一对一视频讨论分歧,并淘汰表现最差的人。
结果是标注者和研究者的一致率达到 77% ± 2%,研究者彼此之间只有 73% ± 4%。比较本身很主观,研究者之间也常有分歧,这组数字说明标注者和研究者的一致程度,已经和研究者彼此之间相当。最后公开的数据集有 64,832 条摘要比较。
讨论
主要结果:超过参考摘要
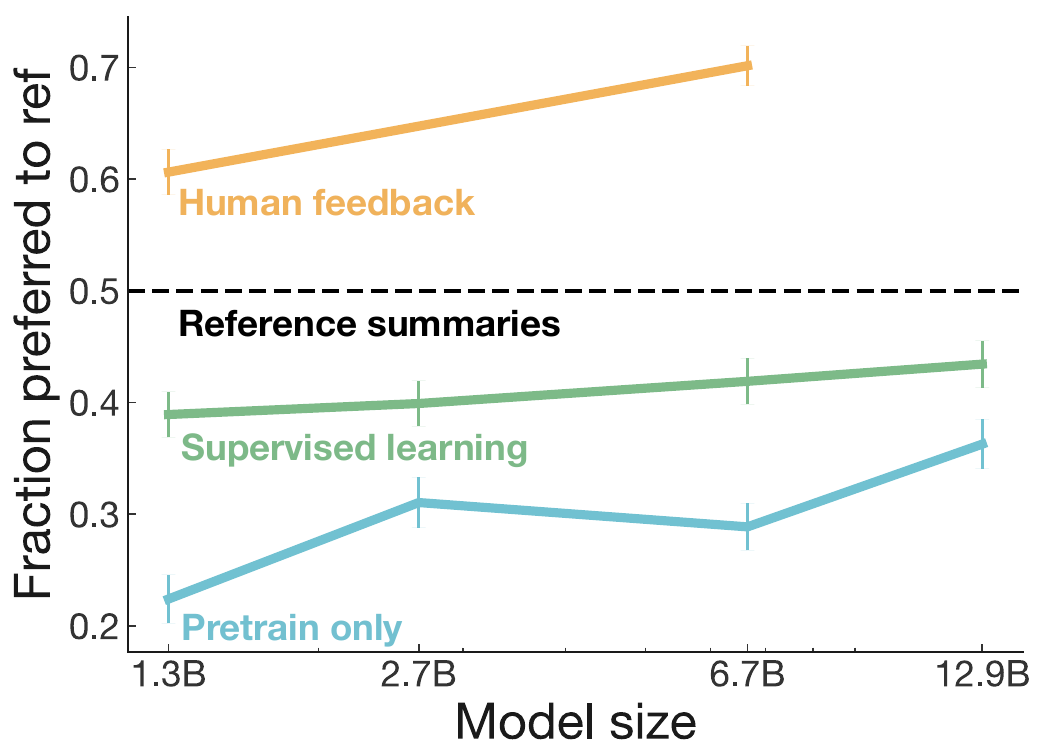
纵轴是标注者偏好模型摘要、胜过参考摘要的比例,0.5 的虚线表示和人写的摘要打平。三条线分别是只预训练(在提示里塞示例的零样本)、监督微调,以及人类反馈训练的模型。
1.3B 的人类反馈模型被偏好的比例是 61%,比规模大 10 倍的监督模型(12.9B,43%)高出一截。6.7B 的人类反馈模型再提升到约 70%,说明这个方法也受益于规模。监督模型即使放大到 12.9B,仍然输给参考摘要。
长度是一个干扰因素。人类反馈模型学会了写更长的摘要,在 48 个 token 的上限内,多写一点通常能涵盖更多信息。作者用逻辑回归控制长度后,人类反馈模型对参考摘要的偏好率下降约 5%,6.7B 模型仍有约 65%。图注里也写明,在 6.7B 时,长度大约解释了人类反馈与监督模型差距的三分之一。
作者还请标注者用 7 分量表,从覆盖度、准确度、连贯性与整体质量四个维度评分。人类反馈模型在每个维度上都胜过监督基线,差距最大的是覆盖度。6.7B PPO 模型有 45% 的摘要拿到整体 7 分满分,监督基线是 20%,参考摘要是 23%。
迁移到新闻
只在 Reddit 上训练的人类反馈模型,不做任何新闻相关的微调,直接拿去给 CNN/DM 的新闻做摘要。它明显胜过同样在 TL;DR 上训练的监督模型,6.7B 版本几乎追上直接在 CNN/DM 上监督微调的 6.7B 模型,而且摘要只有对方的一半左右长。
这里的比较用 7 分量表,因为两者的长度分布几乎没有重叠,很难直接两两比较。作者按长度分组后发现,人类反馈模型如果写得更长,分数可能更高。
优化过头会怎样
奖励模型只是标注者偏好的近似。它的容量有限,也只见过范围很窄的一批摘要。那么对它优化到什么程度,分数就开始不可信?
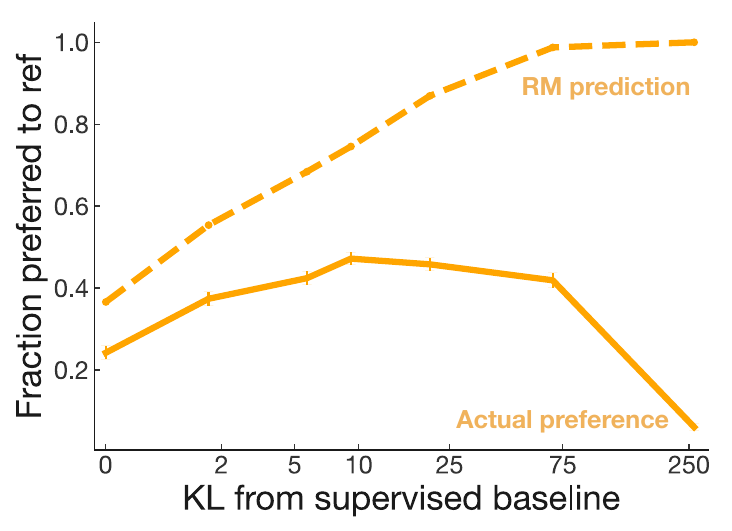
作者用一个较早版本的奖励模型,以不同的 KL 系数 训练出一系列策略。 越小,策略离 SFT 模型越远,横轴的 KL 就越大。虚线是奖励模型自己预测的偏好率,一路往上,到最右边接近 100%。实线是标注者实际的偏好:轻度优化时跟着上升,在 KL 约 10 的地方到顶,接着开始下滑,KL 250 时几乎掉到零。奖励模型最后和人的偏好呈负相关。
附录列出了 KL 250 那个策略的摘要。一篇 28 岁男性想学体操的帖子,被摘成「28yo dude stubbornly postponees start pursuing gymnastics hobby citing logistics reasons despite obvious interest???」,后面再接一串语法错乱、带脏话的句子。附录列出的几份摘要里,几乎每一份都冒出同一句「want change this ...」。作者的评价是,这些摘要又长又怪,但还勉强抓得到大意。
这就是前面 KL 惩罚要防的事。OpenAI 在 2022 年的 Scaling Laws for Reward Model Overoptimization 后来用一个固定的「黄金」奖励模型扮演人类,系统地测量了这条曲线,发现它的形状因优化方法而异,系数则随奖励模型的参数量平滑变化。ROUGE 也有一样的问题。用 best-of-N 采样对 ROUGE 做优化时,质量比对奖励模型做优化更早到顶,顶点也低得多。
奖励模型学到了什么
作者训练了 7 个奖励模型,参数从 1.6 亿到 130 亿,数据从 8k 到 64k 条比较。数据翻倍,验证准确率约提升 1.1%;模型翻倍,约提升 1.8%。用全部数据训练的 6.7B 奖励模型,准确率开始接近单个标注者的水平。
在没训练过的 CNN/DM 上,1.3B 和 6.7B 奖励模型与标注者的一致率分别是 62.4% 和 66.5%;标注者彼此之间是 66.9%。
它对细节也很敏感。请标注者对摘要做最小幅度的改进,6.7B 奖励模型有 82.8% 的概率选改进后的版本,另一组人类评估者是 84.1%。把参考摘要里两个人物的角色对调,6.7B 模型有 97.2% 的概率选回原本正确的版本。
偏差也找得到。对于「把摘要改短」的改进,6.7B 奖励模型只有 62.6% 的概率认同,人类是 76.4%。奖励模型偏好长摘要,这也呼应了前面人类反馈模型倾向写长的现象。
ROUGE 的表现则随模型变强而变差。比较监督模型的两份样本时,ROUGE 和标注者的一致率约 57%;比较人类反馈模型的两份样本时,掉到约 50%,相当于抛硬币。用监督模型的对数概率当指标也一样,在人类反馈模型的样本上降到 50% 以下,奖励模型仍有 62%。
代价
最直接的限制是成本。6.7B 模型的 RL 微调约需 320 GPU 天;训练集花了标注者数千小时,还需要研究者投入大量时间维持质量。也因为太贵,作者没能做一个重要的对照,也就是用同样多的高质量人类示范做监督学习,结果会如何。
2024 年,Huang 等人从头复现了这条流程,列出二十多个关键实现细节,并用 Pythia 模型重现了质量随模型规模上升的趋势。他们的 2.8B 和 6.9B 模型胜过 OpenAI 公开的 1.3B checkpoint。
结论
1.3B 的人类反馈模型,被偏好的程度胜过规模大 10 倍的监督模型,也胜过 Reddit 原作者自己写的 TL;DR。在写不出评分标准的任务上,让人比较、再让模型去追这个比较,是行得通的。
要自己做的话,这篇最值得照抄的反而是标注流程。先写指南、先做校准、留共同题、盯着和研究者的一致率,奖励模型才学得到你要的质量;PPO 那一段,相比之下好处理得多。
还有,KL 惩罚千万别省。少了它,模型很快就学会写出奖励模型爱看、人却看不懂的句子。