原始论文
SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
- 发表版本
- ICLR 2024会议
- arXiv 首次提交
- arXiv:2310.06770
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelevaluationswebench2023,
  title = {{SWE-bench: Can Language Models Resolve Real-World GitHub Issues?}},
  author = {Carlos E. Jimenez and John Yang and Alexander Wettig and Shunyu Yao and Kexin Pei and Ofir Press and Karthik Narasimhan},
  year = {2023},
  eprint = {2310.06770},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2310.06770}
}
2023 年,语言模型写代码的能力,大多用 HumanEval 这类评测来衡量:给一个函数签名和说明,写出函数体,跑几个单元测试。题目都是独立的,几行代码就能解决。
真实的软件开发不是这样。修一个 bug,可能要在几千个文件的项目里找到相关的代码,搞懂不同文件之间的函数怎么互相调用,从一团复杂的逻辑里找出写错的那一行,再改得不弄坏其他功能。
当时的评测一个接一个被做到接近满分,已经测不出最强的模型到底能做到什么程度。Princeton 的 Jimenez、Yang 等人把目光转向 GitHub:开源项目里有大量真实的问题报告(issue),以及实际修好它们的拉取请求(pull request,下称 PR),还附带项目自己的测试。
定义问题
好的评测要足够难,能难倒现有的模型;答案又要容易验证。编程题的好处在于能跑测试,但现有的编程评测太简单、太干净。
作者想要的评测要符合几个条件:题目来自真实的工作,输入很长、很杂,要改的地方可能分散在好几个文件里,用项目原本的测试来判断对错,而且能持续加入新题目,避免模型在训练时已经见过答案。
解决问题
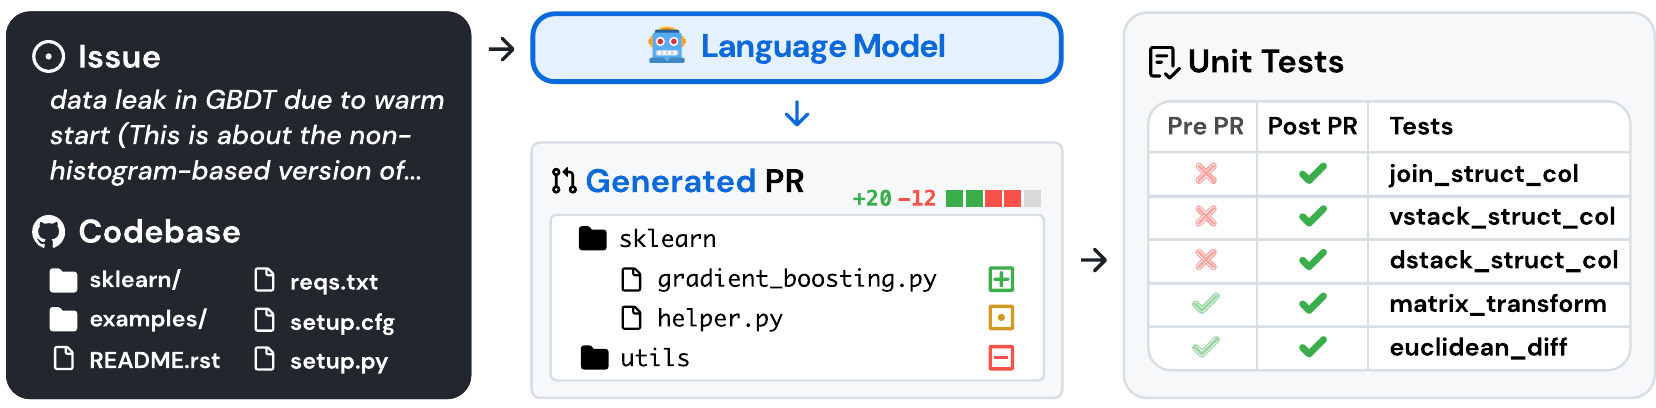
任务很直接。给模型一则 issue 的文字和整个代码库,要它生成一个修改,用 patch 文件的格式表示要改哪几行。评估时用 Unix 的 patch 程序把修改打上去,再执行这一题相关的测试;修改能成功打上、而且测试全部通过,才算解决。整份评测的成绩,就是解决的题目比例。
从九万个 PR 筛到 2,294 题
作者分三个阶段筛选:
- 挑项目、抓数据:选 12 个热门的 Python 开源项目,总共抓到约 9 万个 PR。热门项目通常维护得比较好,贡献规范清楚,测试也比较完整。每个 PR 对应的代码库版本,就是它的 base commit。
- 按属性筛选:只留下已经合并、解决了某个 issue,而且修改了测试文件的 PR。修改了测试文件,说明作者很可能加了测试来确认问题已经修好。
- 按执行结果筛选:先只应用 PR 里的测试修改,记录测试结果;再应用其余的代码修改,再记录一次。至少要有一个测试从失败变成通过,才留下来;安装失败或执行出错的也删掉。
最后剩下 2,294 题。
题目长什么样
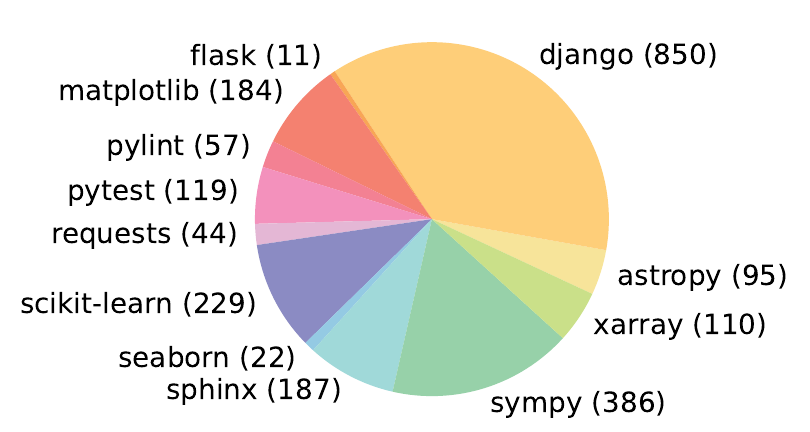
| 指标 | 平均 | 最大 |
|---|---|---|
| issue 文本长度(词) | 195.1 | 4,477 |
| 代码库的文件数(不含测试) | 3,010 | 5,890 |
| 代码库的行数(不含测试) | 438K | 886K |
| 标准修改改动的行数 | 32.8 | 5,888 |
| 标准修改改动的文件数 | 1.7 | 31 |
| 标准修改改动的函数数 | 3 | 36 |
| 修改前失败、修改后通过的测试数 | 9.1 | 1,633 |
| 测试总数 | 120.8 | 9,459 |
整理自原论文 Table 1;「标准修改」是实际合并的那份修改(gold patch)。
平均每题的代码库有 3,000 个文件、43.8 万行代码,要改的却只有 1.7 个文件、30 多行。模型得在一大片代码里,找到真正要改的那几行。
测试分成两种。修改前失败、修改后通过(fail-to-pass,F2P)的测试,检查 issue 报告的问题有没有修好,每题至少一个,40% 的题目有两个以上。修改前后都要通过(pass-to-pass,P2P)的测试,检查原本的功能有没有被改坏,每题的中位数是 51 个。
两种测试都要通过才算解决。举个简单的例子,issue 报告 1900 年被误判成闰年,F2P 测试就检查 1900 年;如果修复只加上「不能被 100 整除」,1900 年修好了,2000 年却也变成了平年,原本通过的 P2P 测试会抓到这个错误。
这样设计的好处
- 真实:题目和解答都是用户实际提交的,需要的是资深工程师的技能。
- 能持续更新:收集流程几乎不需要人工,可以套用到任何 Python 项目。只要拿模型训练截止之后才出现的 issue 来考,就能确定答案不在训练数据里。
- 输入又长又杂:issue 平均 195 个词,代码库动辄上千个文件。
- 跨文件修改:不像 HumanEval 只改一个函数,也不是填空式的题目,这里没有任何提示告诉你该改哪里。
- 解法开放:模型的修改不必和标准修改一样,只要通过测试就算数;检索、长上下文、智能体(agent)等各种做法都能在同一个标准下比较。
全部 2,294 题跑一次很花时间和 API 费用,作者另外挑了 300 题组成 SWE-bench Lite,偏向比较独立的功能性 bug,覆盖 12 个项目中的 11 个。
SWE-Llama
开源模型里,当时只有 CodeLlama 能处理这么长的上下文,但现成的版本不太会按指示生成整个代码库的修改,常常只输出占位文本或不相关的代码。作者用同样的流程,从另外 37 个 Python 项目收集了 1.9 万组 issue 和 PR,这次不要求一定要有测试修改,项目也和评测完全不重叠。
用这份数据微调 CodeLlama-Python 7B 和 13B,得到 SWE-Llama。为了节省显存,只用 LoRA 微调注意力层,并排除超过 3 万 token 的训练序列,实际用到约 1 万条。输入是指令、issue 和相关的代码文件,目标是生成标准修改。
怎么把代码库塞进上下文
平均 43.8 万行的代码库,不可能整个塞进当时的上下文。作者用两种方式挑文件:
- BM25 检索:用 issue 的文字作为查询,检索相关的文件,塞到 1.3 万、2.7 万或 5 万个 token 的上限为止。代码配上自然语言查询,而且查询和文档都很长,作者认为不适合用稠密检索。
- Oracle 检索:直接给出标准修改动到的那几个文件。这不切实际,工程师一开始也不知道要改哪些文件,但可以拿来做分析。
上限 2.7 万 token 时,BM25 在大约四成的题目上能把 oracle 的文件全部找到,但也有将近一半的题目,一个都没找到。
评测的模型有 ChatGPT-3.5(16K 上下文)、GPT-4(32K)、Claude 2(100K)和 SWE-Llama。上下文越短,能把 oracle 文件完整放进去的题目就越少,GPT-4 是 84.1%,ChatGPT-3.5 只有 58.1%。
讨论
几乎都解不出来
| 模型 | 解决 | 修改可应用 | Lite 解决 |
|---|---|---|---|
| Claude 3 Opus | 3.79 | 46.56 | 4.33 |
| Claude 2 | 1.97 | 43.07 | 3.00 |
| ChatGPT-3.5 | 0.17 | 26.33 | 0.33 |
| GPT-4-turbo | 1.31 | 26.90 | 2.67 |
| SWE-Llama 7b | 0.70 | 51.74 | 1.33 |
| SWE-Llama 13b | 0.70 | 53.62 | 1.00 |
整理自原论文 Table 5;BM25 检索,单位为 %。
最好的模型解决不到 4%,论文发表时最好的 Claude 2 不到 2%。一半以上的修改连格式都不对,根本打不上去。
给 oracle 文件会好一些。Claude 2 从不到 2% 升到 4.80%,SWE-Llama 13b 是 3.97%,GPT-4(只测了随机四分之一的题目)是 1.74%。
各项目的难度差很多
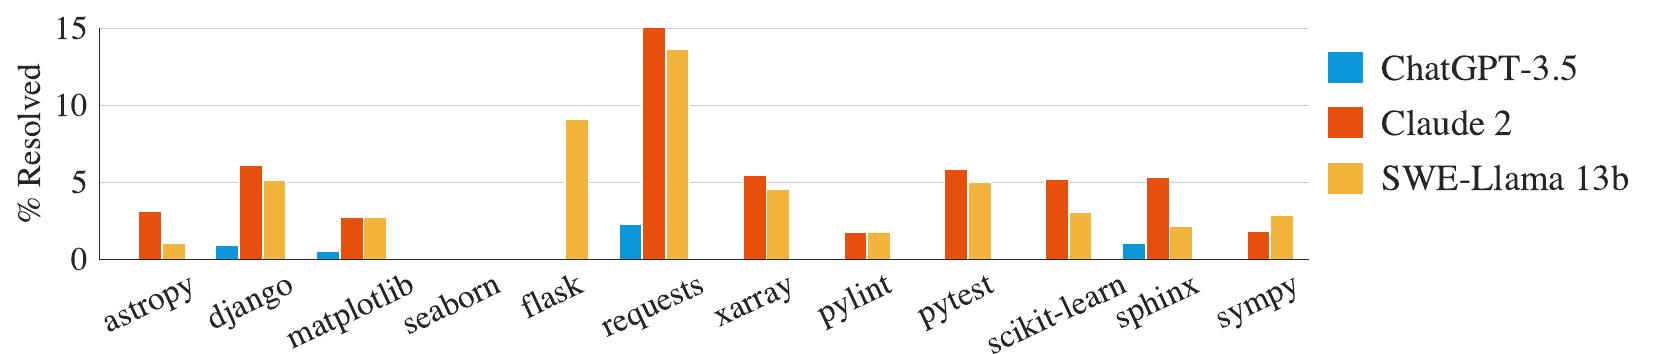
三个模型在各项目上的高低趋势相似,但解出来的题目重叠不多。oracle 设定下,Claude 2 解出 110 题,SWE-Llama 13b 解出 91 题,而 SWE-Llama 解出的题目,Claude 2 只解出了其中 42%。
有些项目的 issue 带图片,以 Markdown 图片链接的形式嵌在文字里。matplotlib 有 32% 的题目带图,seaborn 有 10%,整体只有 2%。这类题目可能需要多模态模型,或是能处理图片的工具。
上下文越长,表现越差
Claude 2 的表现随着输入总长度的增加而明显下降,其他模型也一样。BM25 的上限从 1.3 万放宽到 5 万 token,找到 oracle 文件的比例变高了,Claude 2 的解决率反而从 1.96% 降到 1.22%。模型看到太多和问题无关的代码,就找不到真正要改的地方。
作者另外做了一个「oracle 折叠」的实验:一样给 oracle 文件,但只保留标准修改动到的行,上下各留 15 行,其余全部折叠起来。Claude 2 从 4.8% 升到 5.9%,GPT-4 升到 3.40%。
其他观察
- 和 issue 的日期无关:把题目分成 2023 年以前和以后,大部分模型的表现差不多(GPT-4 只测了四分之一的题目,以后的那组是 0)。作者认为,这说明模型就算见过旧版的代码库,也很难靠背答案来作弊。
- 微调的模型怕换上下文:SWE-Llama 是用 oracle 文件训练的,学到的是「给我的每个文件都要改」;换成 BM25 给的一堆不相关文件,表现就很差。
- 写 patch 比重写整个文件容易:模型平常看的多半是完整的代码文件,很少看到 patch,作者试过让模型直接输出修改后的整个文件。结果反而更差,Claude 2 在 oracle 检索下从 4.8% 掉到 2.2%。
- 模型改得比较少:以整个 patch 文件的总行数(含上下文)来算,成功打上的修改平均只有 17 到 30 行,同一批题目的标准修改是 34 到 44 行,全部标准修改则是 74.5 行。模型几乎都只改一个文件。
一个没修好的例子
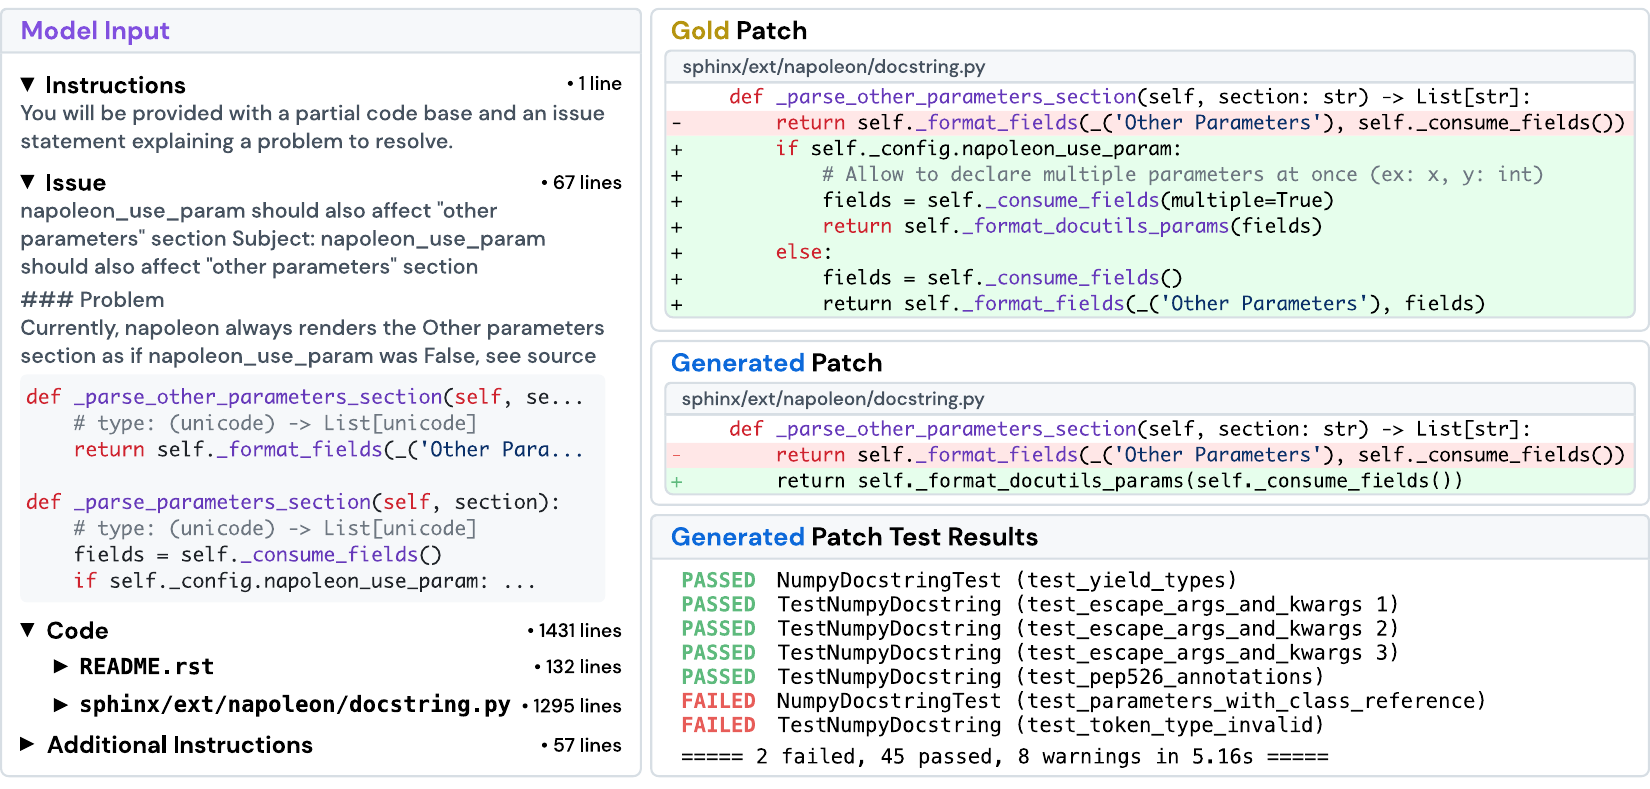
这则 issue 说,Sphinx 的 napoleon 扩展在 napoleon_use_param 设为 True 时,「Other Parameters」部分的格式不对。issue 写得很详细,还附上了可能有问题的代码片段。
oracle 设定下,输入共 1,558 行、20,882 个 token。SWE-Llama 改对了函数,却让它不管设定是什么,都当成 napoleon_use_param 为 True 来处理;标准修改则是先检查设定,照着隔壁 _parse_parameters_section 的写法来。有一个测试恰好在设定为 False 的情况下比对输出,马上抓到了这个错误。
作者看了 11 份 SWE-Llama 和 Claude 2 的输出,归纳出几个倾向。模型写的代码很原始,不太会用现成的库或代码库里已有的工具;解法很「贪心」,只针对 issue 描述的情况修,不太在意代码风格或项目的惯例,例如该用相对导入还是绝对导入。人写的标准修改,常常顺手做结构上的改进,连可能发生的相关问题也一起处理掉。
限制
- 只有 Python:作者希望未来把同样的收集流程用在其他语言上。
- 只建立了基线:论文用的是最简单的做法,检索几个文件、一次生成修改。作者鼓励之后尝试智能体、搭配工具等其他做法。
- 测试抓不到的地方:通过测试的代码,还是可能写得不完整、效率低或难读;模型写的修改常常在这些方面不如人写的。
后来的事
作者在限制里建议的智能体做法,很快由同一个团队做出来了。2024 年 5 月的 SWE-agent 为语言模型设计了一套专用的操作接口,让它能浏览整个代码库、打开文件、编辑、跑测试,在完整的 SWE-bench 上解决了 12.5% 的题目。
2024 年 8 月 13 日,OpenAI 发布了 SWE-bench Verified。他们请 93 位有经验的 Python 开发者检查了随机抽出的 1,699 题,排除描述不清楚、或测试对正确解法不公平的题目,留下 500 题。在当时最好的开源框架下,GPT-4o 解决了 33.2%。
之后 SWE-bench Verified 成了各家发布新模型时最常列出的编程能力指标。2024 年 10 月,升级版的 Claude 3.5 Sonnet 从 33.4% 提高到 49.0%;2025 年 5 月,Claude Opus 4 是 72.5%。这些都是在人工筛选过的 Verified 上测的,不能直接和原始 2,294 题的数字相比,但从不到 2% 走到七成,只花了一年半。
结论
SWE-bench 从 12 个热门 Python 项目的 9 万个 PR 里,筛出 2,294 个真实的 issue,用项目自己的测试判断有没有修好。论文发表时,最好的 Claude 2 只解出不到 2%,给它正确的文件也只有 4.8%。
难的地方不只是写代码。模型得在 43.8 万行的代码库里找到要改的那 30 行,给它的代码越多,反而越找不到;改了还不能弄坏其他功能,每题的 P2P 测试中位数有 51 个在旁边盯着。
这份评测设计得足够真实,所以没有很快被做到满分。一年半后,排行榜上的数字从个位数爬到七成,靠的不只是模型变强,还有模型学会了像工程师一样,在代码库里四处翻找、跑测试、看报错再改。