原始论文
Reflexion: Language Agents with Verbal Reinforcement Learning
- 发表版本
- NeurIPS 2023会议
- arXiv 首次提交
- arXiv:2303.11366
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{reinforcementlearningreflexion2023,
  title = {{Reflexion: Language Agents with Verbal Reinforcement Learning}},
  author = {Noah Shinn and Federico Cassano and Edward Berman and Ashwin Gopinath and Karthik Narasimhan and Shunyu Yao},
  year = {2023},
  eprint = {2303.11366},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2303.11366}
}
2023 年春天,用语言模型做智能体(agent)的研究一下子多了起来。ReAct 让模型边想边查资料,Toolformer 让模型自己调用工具,还有人让模型在游戏、网页、编程环境里做事。
这些智能体都一样,失败了也学不到东西。传统的强化学习可以从失败中学习,但需要大量的尝试和昂贵的微调,对几百亿参数的模型来说不太现实。所以当时的智能体只能靠提示词里的示例,这一次做错,下一次还是照样错。
美国 Northeastern University 的 Shinn 等人(后来的版本加入了 Princeton 的 Narasimhan 和 Yao)换了一个思路。人做错事之后,会回想自己哪里做错了、下次该怎么做;模型也可以这样做,把反思写成文字,放进下一次尝试的提示词里。权重完全不动,学到的东西全部写在文字里。
定义问题
智能体在环境里做一连串的动作,最后拿到反馈。这个反馈常常很稀疏,可能只有「成功」或「失败」,或者一个分数。
传统强化学习要从这种信号里学习,难在信用分配(credit assignment):一连串几十个动作,到底是哪一步出了错?只靠一个 0 或 1,很难回答。
作者想问的是,能不能让语言模型自己把这个稀疏的信号「放大」成具体的建议,例如「第 3 步拿错了东西,下次应该先去书桌找台灯」,再用这段文字引导下一次尝试?
解决问题
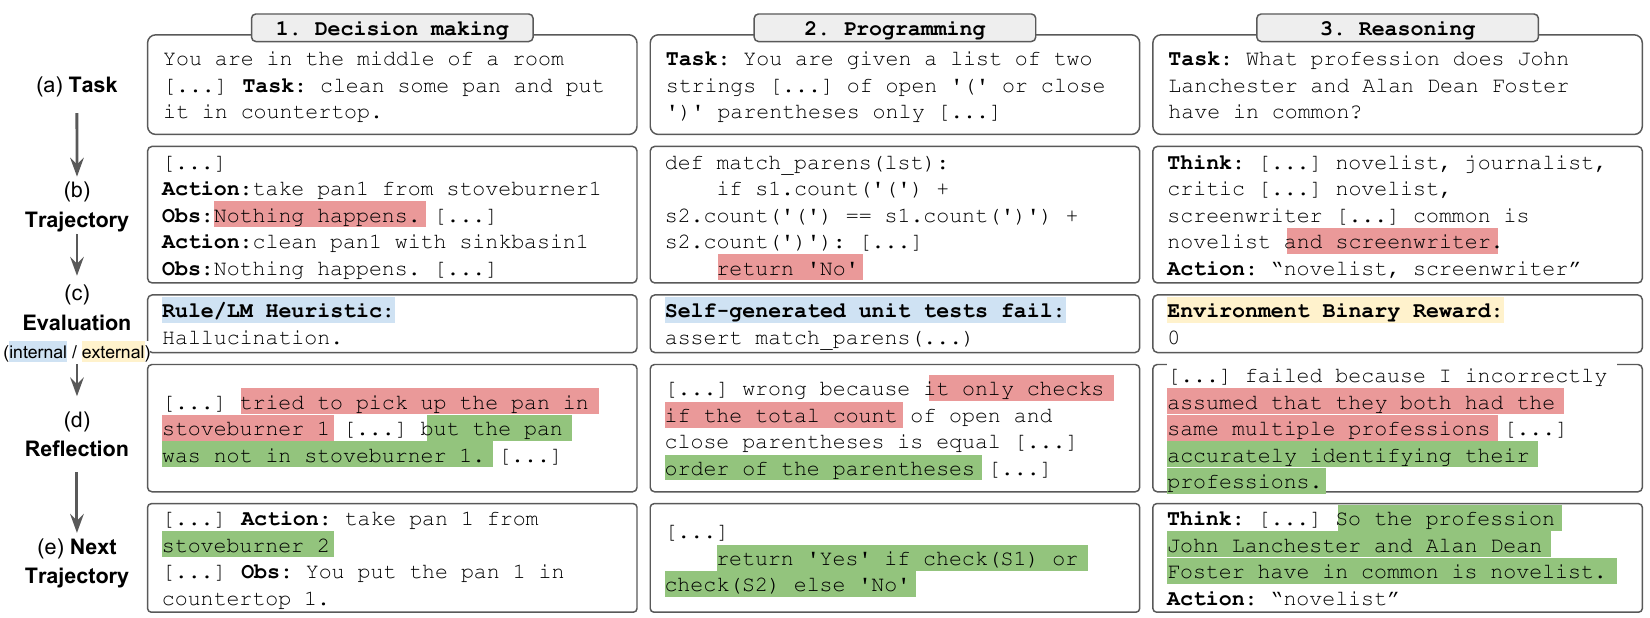
三个模型
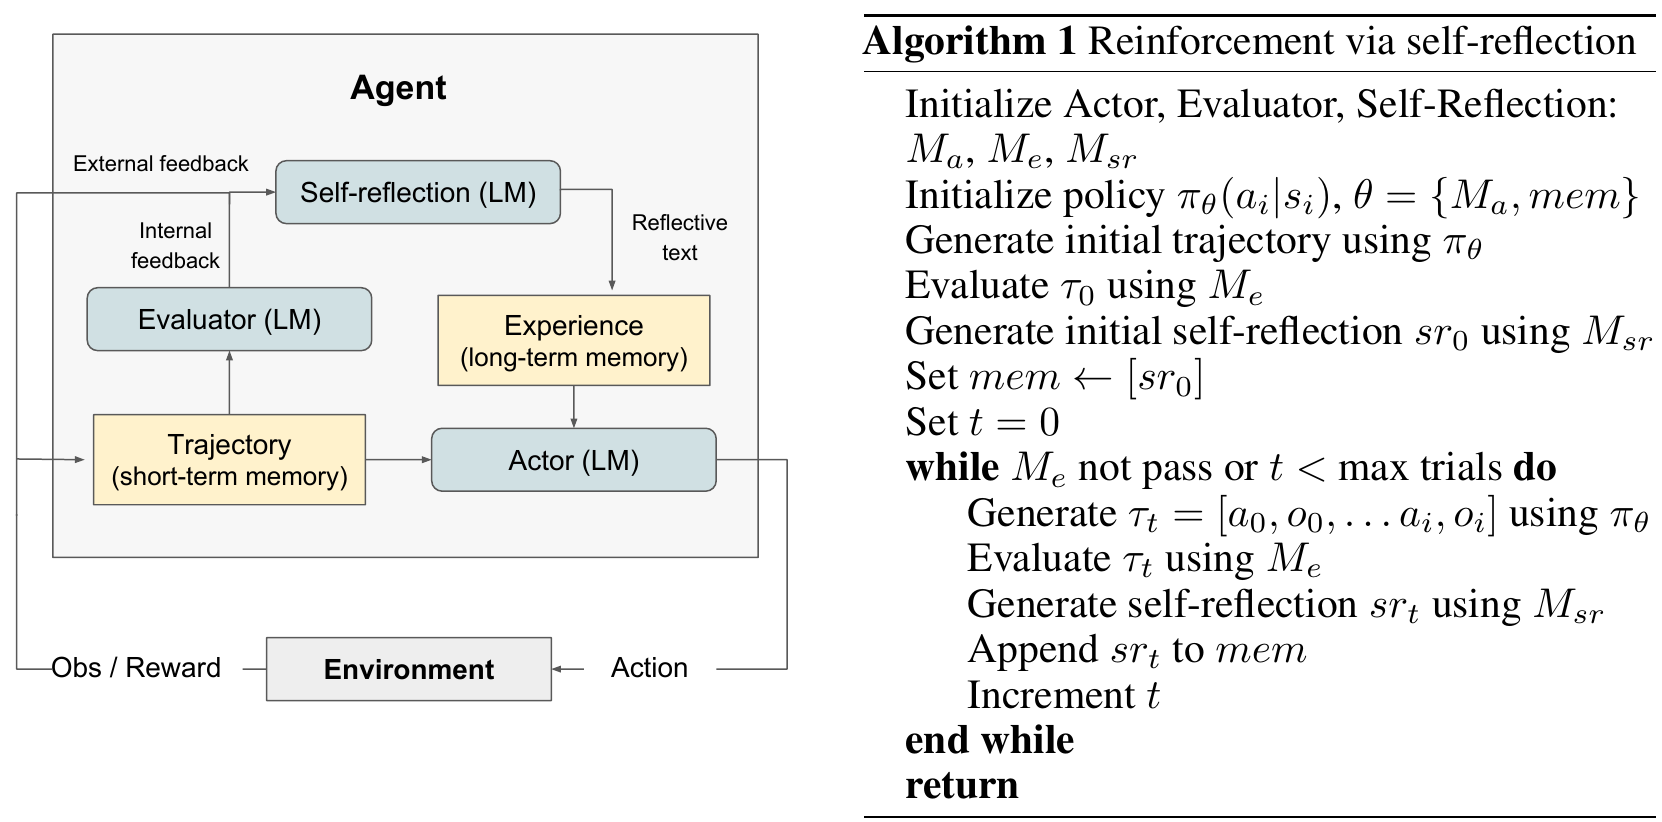
Reflexion 由三个角色组成,三者都可以是同一个语言模型,只是提示词不同:
- Actor:在环境里做事,生成文字和动作。作者试了思维链和 ReAct 两种写法,并在提示词里加入一段记忆。
- Evaluator:评估这次的表现。推理题看是否和标准答案完全相同(exact match);决策任务用事先写好的规则,或请另一个语言模型判断成败;编程题则跑模型自己写的单元测试。
- Self-reflection:拿到成败信号、这次的轨迹和过去的记忆,写出一段反思,说明哪里做错了、下次怎么做。
两种记忆
这次尝试的完整轨迹是短期记忆,细节很多;反思写成的文字是长期记忆,比较精简,存的是学到的教训。下一次尝试时,Actor 同时看到这两种记忆。
长期记忆不能无限累积,否则会超过提示词的长度上限。作者只保留最近的几段反思,决策和推理任务是 3 段,编程任务是 1 段。
流程
- Actor 做一次尝试,得到轨迹 。
- Evaluator 给出分数 。
- Self-reflection 根据 写出反思 ,放进记忆。
- 重复:Actor 带着记忆再试一次,评估,写新的反思,加入记忆,直到 Evaluator 判断成功,或尝试次数用完。
作者把它称为「言语的」强化学习。传统强化学习的策略由权重决定,这里的策略是「语言模型 + 记忆」,更新策略的方式是改写记忆里的文字。作者也直接承认,这个做法依赖语言模型自我评估的能力,没有任何保证一定会成功。
讨论
决策:AlfWorld
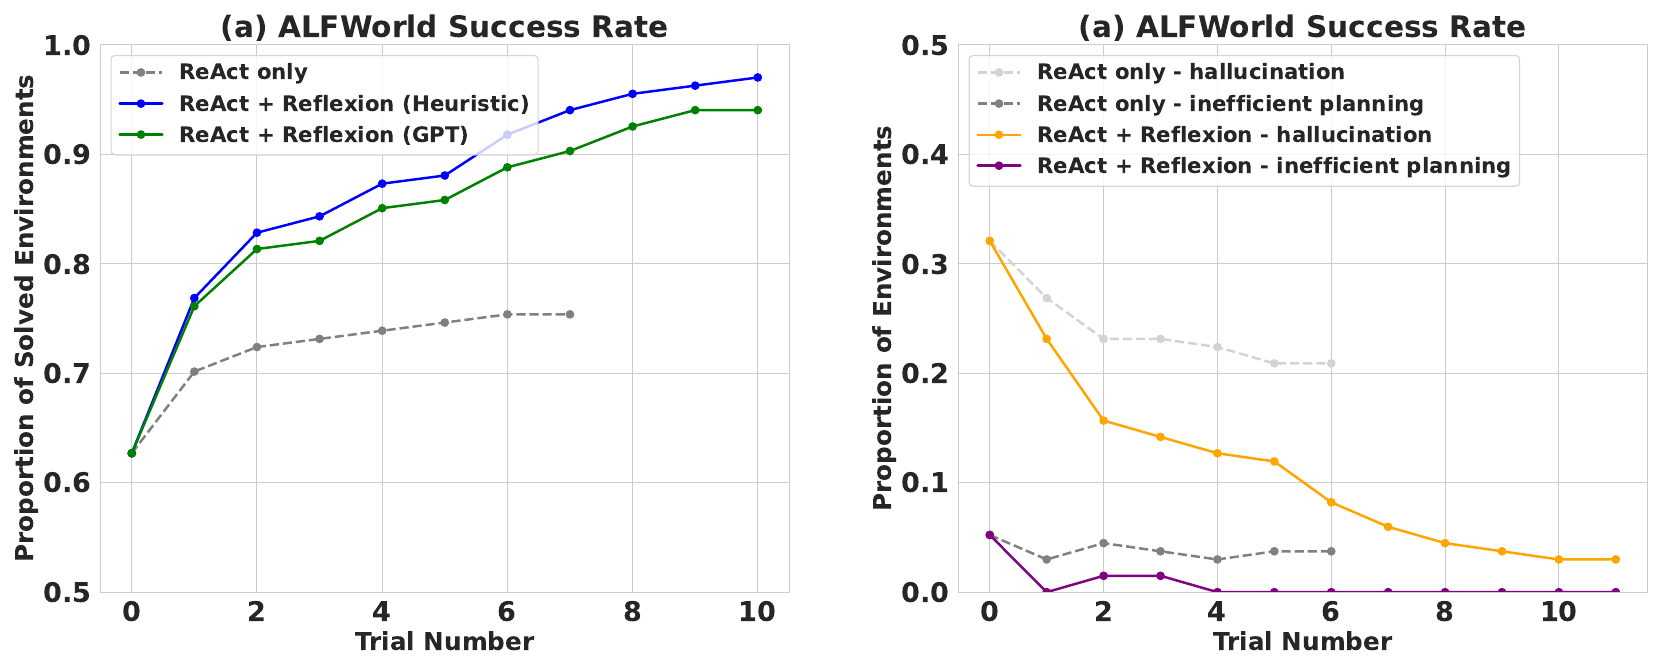
AlfWorld 是文字版的家居环境,智能体要用文字指令完成任务,例如找到藏在抽屉里的锅铲、把刀拿到砧板上、把番茄放进冰箱冷藏。作者沿用 ReAct 的设置,在 134 个环境上测试,Actor 是 ReAct。
这个环境只会告诉智能体任务完成了没有,所以 Evaluator 要自己判断什么时候算失败。作者用了两条简单的规则。同一个动作重复超过 3 次、得到同样的回应,就判定为幻觉;在这个环境里的动作超过 30 步,就判定为低效的规划。
结果 ReAct + Reflexion 解出了 134 个任务中的 130 个,ReAct 单独使用则在第 6、7 次尝试之后就不再进步。
右图把失败按原因分类。ReAct 最常见的失败,是以为自己已经拿到了某个东西,其实没有,接着做了一长串动作也找不回错误,这类幻觉一直停在 22% 左右。Reflexion 会把很长的失败轨迹浓缩成几句提醒,下一次就避开。
附录有一个具体的例子。任务是「用台灯检查杯子」,智能体先找到杯子拿起来,再去找台灯,结果用不了。反思写道:我的计划是先找杯子再找台灯,但任务要用台灯来检查杯子,应该先找台灯;我注意到台灯在书桌 1 上,下次直接去书桌 1。第二次尝试,智能体三个动作就完成了。
推理:HotPotQA
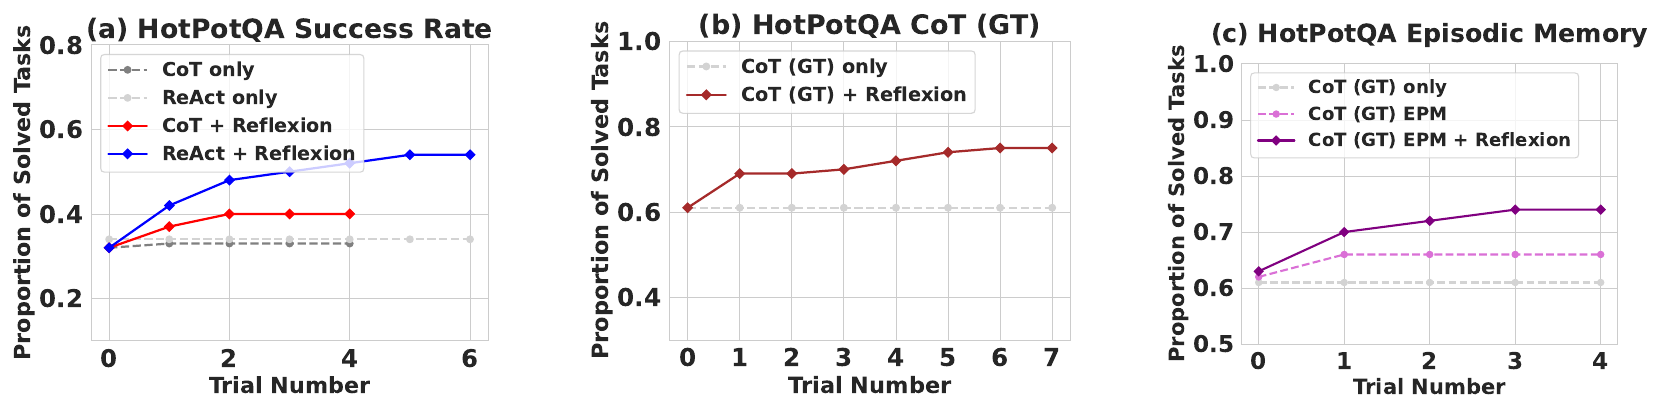
HotPotQA 是要跨好几篇维基百科文章才能回答的问题。作者测了三种智能体,都用 100 道题:
- ReAct:可以用维基百科 API 搜索,边想边查。
- 思维链:不查资料,只靠推理。
- 思维链加上正确的背景段落(CoT (GT)):直接把数据集附带的正确段落给模型,单独测推理能力。
单独使用时,三种智能体重试几次都没有新的题目答对,即使用温度 0.7 采样也一样。加上 Reflexion 之后,ReAct 多答对了约 20 个百分点。有正确段落的思维链本来就比较高,但仍有 39% 的题目答错,Reflexion 把准确率再拉高了 14 个百分点。
进步是来自反思,还是只是因为看到了上一次的尝试?右图的消融实验把两者分开比较。只把上一次的完整轨迹放进提示词,也有一些帮助;加上一段第一人称的反思,再多 8 个百分点。作者据此认为,光是让模型重写一次,效果不如先反思再重写。
这里要注意评分方式。HotPotQA 每次尝试之后,环境会用标准答案判断对错,告诉智能体这次是成功还是失败。换句话说,智能体每次都知道自己答错了,只是不知道正确答案是什么。这个设置后面还会谈到。
编程:HumanEval、MBPP 和 LeetCode
编程题是 Reflexion 最漂亮的战场,因为有一个不需要标准答案的评估方式:自己写测试。
作者先用思维链让模型写出各种单元测试,用语法树检查,只留下语法正确的,再从中抽最多 6 个组成测试集。代码写完后跑这些测试,没通过就反思、重写,全部通过才提交。因为整个过程没有碰到题目隐藏的测试,提交的那一份仍然算是 pass@1。
| 评测(语言) | 先前最佳 | GPT-4 | Reflexion |
|---|---|---|---|
| HumanEval(Python) | 65.8 | 80.1 | 91.0 |
| HumanEval(Rust) | - | 60.0 | 68.0 |
| MBPP(Python) | 67.7 | 80.1 | 77.1 |
| MBPP(Rust) | - | 70.9 | 75.4 |
| LeetCode Hard(Python) | - | 7.5 | 15.0 |
整理自原论文 Table 1;先前最佳是 CodeT 搭配 GPT-3.5 或 Codex,单位为 pass@1 %。
- Rust 的题目是用 MultiPL-E 把 Python 题目自动翻译过去的,HumanEval 只取最难的 50 道,用来展示方法和语言无关。
- LeetCode Hard 是作者新做的 40 道题,都在 2022 年 10 月 8 日(GPT-4 的预训练数据截止日期)之后才公开。
- 这里的 GPT-4 是作者自己测的,HumanEval 80.1%,比 GPT-4 技术报告写的 67.0% 高。
HumanEval Python 从 80.1% 升到 91.0%,但 MBPP Python 反而从 80.1% 掉到 77.1%。作者追查原因,发现问题出在模型自己写的测试上。
测试可能出两种错。一种是测试太松,错误的代码也全部通过,智能体就会提前交出错误的答案;另一种是测试本身写错了,正确的代码通不过,智能体会去反思一段其实没错的代码。作者认为后者比较能接受,智能体还有机会从反思中发现是测试错了。
在 MBPP Python 上,「测试全部通过、代码却是错的」的比例是 16.3%,在 HumanEval Python 上只有 1.4%。两者的基线准确率差不多,差别就在测试的质量。
拿掉一部分会怎样
作者在 HumanEval Rust 最难的 50 道题上做了消融,基底模型是 GPT-4:
| 做法 | 自己写测试 | 反思 | pass@1 |
|---|---|---|---|
| 基底模型 | 否 | 否 | 60% |
| 不写测试 | 否 | 是 | 52% |
| 不反思 | 是 | 否 | 60% |
| Reflexion | 是 | 是 | 68% |
整理自原论文 Table 3。
不写测试、只反思,反而比基底模型更差。智能体无法判断当前的代码对不对,只能把所有回合都用完,一路修改,把原本正确的代码也改坏了。
有测试、不反思,则完全没有进步。测试和编译器确实抓到了语法和逻辑错误,但模型直接重写时,修改的内容没有对应到这些错误。作者据此认为,没有反思、只靠盲目试错的调试方法,在 Rust 这种较难的任务上效果不大。
模型要够强
附录在不同模型上重做了一次。开源的 starchat-beta 在 HumanEval Python 上,用不用 Reflexion 都是 26%;HotPotQA 上,text-davinci-003、gpt-3.5-turbo、gpt-4 加上 Reflexion 都有进步。作者的结论是,能写出有用的自我修正,是比较强、比较大的模型才有的能力。
局限
- 局部最优:Reflexion 本质上是用文字做策略优化,仍可能卡在不够好的解上。附录的 WebShop 实验就是例子,智能体要在购物网站上找出符合需求的商品,跑了 4 次尝试都没有进步,写出来的反思也没有帮助。作者认为这类任务需要非常多样、很有创意的探索,例如换不同的搜索关键词,Reflexion 做不到。
- 记忆很简单:只是一个保留最近几段的滑动窗口,作者建议未来改用向量数据库或 SQL 数据库。
- 测试的限制:非确定性的函数、会调用外部 API 的函数、输出因硬件而异或涉及并行处理的函数,都很难写出准确的测试。
作者也提醒,自动写代码的实验要在隔离的环境里跑,因为生成的代码在执行前没有经过任何检查。
后来的事
2023 年 10 月,Google DeepMind 与 UIUC 的 Huang 等人在 Large Language Models Cannot Self-Correct Reasoning Yet 里,指出了这类自我修正研究的一个共同问题。包括 Reflexion 在内的做法,都用标准答案来决定什么时候停止修正:答对了就停,答错了才继续。在真实场景里,我们不会知道正确答案。
他们设计了一个很尖锐的对照组。同样用标准答案决定要不要再试,但「修正」的方式是从剩下的选项里随便换一个。CommonsenseQA 是五选一,每答错一次就排除一个选项,最多猜四轮一定能猜中。
GPT-3.5 和 GPT-4 在 CommonsenseQA 上的起点分别是 75.8% 和 82.0%。乱猜两轮,GPT-3.5 就到了 87.9%,和让模型自我修正两轮的 89.7% 差不多;GPT-4 乱猜是 91.0%,比自我修正的 85.5% 还高;猜四轮,两个都是 100%。只要有人告诉你「错了,再来」,就算完全不动脑也会越来越准。拿掉标准答案之后,他们发现模型自己修正推理题,成绩不升反降。
这个批评主要针对推理题。编程题的情况不同,测试和执行器本身就是不需要标准答案的检查,Reflexion 在 HumanEval 上的 91% 正是用这种方式拿到的。Huang 等人也提到,代码生成这类可以用执行器和单元测试验证的任务,是另一回事。
后来的编程智能体也走了这条路:写代码、跑测试、读错误信息、修改,反复进行。差别在于测试换成了项目原有的测试,反馈换成了真实的错误信息。
结论
Reflexion 不改权重,把每次失败的经验写成一段反思,放进下一次尝试的提示词里。AlfWorld 解出 134 个任务中的 130 个,HotPotQA 多答对约 20 个百分点,HumanEval Python 的 pass@1 从 80.1% 到 91.0%。
它最有说服力的地方在编程题。测试是模型自己写的,提交之前没有看过任何标准答案;消融也说明了测试和反思缺一不可,只反思不测试,成绩反而更差。
推理题那部分就要打个折扣,智能体每次都被告知「答错了」,而这正是真实世界最缺的那一项信息。反思写得再好,也得先有人说它错了。