原始论文
Evaluating Large Language Models Trained on Code
- 发表版本
- 正式发表信息尚未核实
- arXiv 首次提交
- arXiv:2107.03374
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modelevaluationcodex2021,
  title = {{Evaluating Large Language Models Trained on Code}},
  author = {Mark Chen and Jerry Tworek and Heewoo Jun and Qiming Yuan and Henrique Ponde de Oliveira Pinto and Jared Kaplan and Harri Edwards and Yuri Burda and Nicholas Joseph and Greg Brockman and Alex Ray and Raul Puri and Gretchen Krueger and Michael Petrov and Heidy Khlaaf and Girish Sastry and Pamela Mishkin and Brooke Chan and Scott Gray and Nick Ryder and Mikhail Pavlov and Alethea Power and Lukasz Kaiser and Mohammad Bavarian and Clemens Winter and Philippe Tillet and Felipe Petroski Such and Dave Cummings and Matthias Plappert and Fotios Chantzis and Elizabeth Barnes and Ariel Herbert-Voss and William Hebgen Guss and Alex Nichol and Alex Paino and Nikolas Tezak and Jie Tang and Igor Babuschkin and Suchir Balaji and Shantanu Jain and William Saunders and Christopher Hesse and Andrew N. Carr and Jan Leike and Josh Achiam and Vedant Misra and Evan Morikawa and Alec Radford and Matthew Knight and Miles Brundage and Mira Murati and Katie Mayer and Peter Welinder and Bob McGrew and Dario Amodei and Sam McCandlish and Ilya Sutskever and Wojciech Zaremba},
  year = {2021},
  eprint = {2107.03374},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2107.03374}
}
2021 年 6 月底,GitHub 推出了 Copilot 的技术预览版。在编辑器里写好函数名和注释,它就把函数体补全。一周后,OpenAI 发表了这篇论文,介绍背后的模型 Codex;论文第一段就写明,Copilot 用的是另一个生产版本的 Codex。
这个想法来自 GPT-3。作者早先发现,GPT-3 读了 Python 的 docstring 之后,能写出一些简单的程序。功能很简陋,但 GPT-3 从没专门针对代码训练过。于是他们拿 GPT 在 GitHub 的代码上继续训练,看它能写到什么程度。
不过这篇论文花力气最多的地方,是「怎么判断模型写得好不好」。它留下的 HumanEval 和 pass@k,后来成了代码模型的标准试卷和计分方式,比 Codex 本身活得还久。
定义问题
在这之前,代码生成模型大多靠比对来评分。把模型写的代码和参考答案比,完全一样或 BLEU 分数够高,就算写得好。
问题是代码有无数种写法。return [i + 1 for i in l] 和用 for 循环逐个 append,功能完全一样,字面上却差很多;反过来,只差一个字符的两段代码,可能一个对、一个错。作者后面也实际检查过,Codex 写错的代码,BLEU 分数常常比写对的还高。
作者主张改看功能正确性,代码跑通单元测试才算对。这也是工程师平时判断代码的方式,测试驱动开发就是先把需求写成测试,再写实现。
要这样评分,得先解决三件事:
- 考题不能出现在训练数据里。 Codex 读过大半个 GitHub,而 GitHub 上光是 Codeforces 题目的解答,就有十几个公开仓库。
- 一题采样很多个答案时,分数要怎么算才公平。
- 模型写的代码不可信,要有地方安全地执行。
第三件是工程问题。作者用 gVisor 容器运行时把主机和容器隔开,再用基于 eBPF 的防火墙挡掉实验控制以外的所有网络连接。前两件则是 HumanEval 和 pass@k。
HumanEval
作者手写了 164 道题,每题有函数签名、docstring、参考解答,平均 7.7 个单元测试。题目涵盖语言理解、推理、算法和简单数学,有些和简单的软件面试题差不多难。
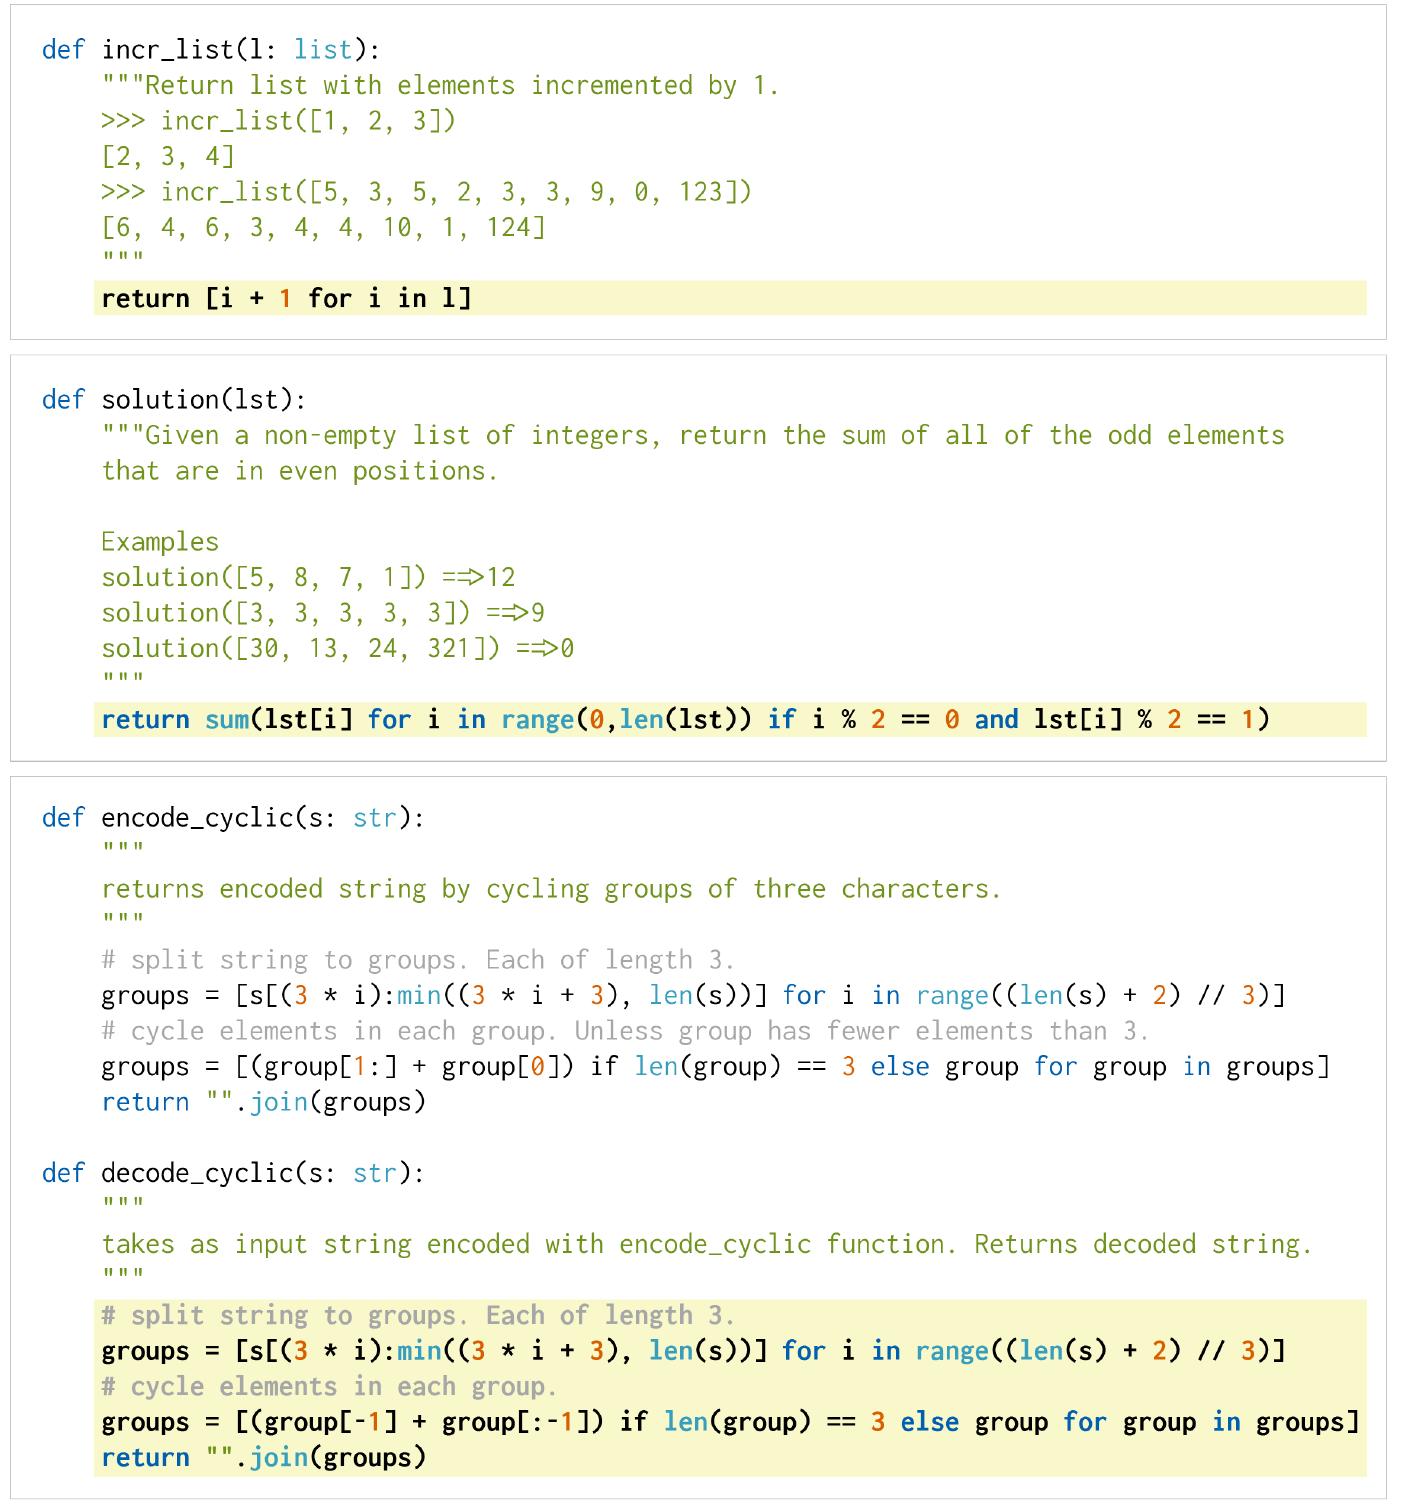
白底是给模型的提示词,黄底是模型写出的答案。三题由易到难,Codex-12B 抽一次就写对的概率分别是 0.9、0.17 和 0.005。最难的那题要先看懂 encode_cyclic 怎么把每三个字符轮转一次,再写出反过来的操作。
提示词只有文件头、函数签名和 docstring。模型会一直往下写,所以遇到 \nclass、\ndef、\n#、\nif、\nprint 就停,否则它会接着写下一个函数或测试代码。
pass@k
一题可以让模型抽很多次。pass@k 指的是抽 k 个答案,只要有一个通过测试,这题就算解出,再对所有题目取平均。
最直接的算法是每题真的抽 k 次,但这样方差很大。作者改成每题抽 个样本(论文用 、),数出其中有 个通过,再这样估计:
分数那一项是「从 个样本里随机拿 个,全都是错的」的概率;用一减去它,就是 个里至少有一个对的概率。
组合数直接算会非常大,所以论文附了一个数值稳定的写法,把连乘逐项展开。我们拿它算一题:
import numpy as np
from math import comb

def pass_at_k(n, c, k):
    """论文 Figure 3 的写法:n 个样本中有 c 个通过,估计 pass@k"""
    if n - c < k:
        return 1.0
    return 1.0 - np.prod(1.0 - k / np.arange(n - c + 1, n + 1))

n, c = 200, 10              # 一题抽 200 次,10 次通过测试
for k in (1, 10, 100):
    exact = 1 - comb(n - c, k) / comb(n, k)       # 直接用组合数算
    naive = 1 - (1 - c / n) ** k                  # 拿 pass@1 硬推
    print(f"k={k:3d}  unbiased={pass_at_k(n, c, k):.4f}  comb={exact:.4f}  naive={naive:.4f}")

# k=  1  unbiased=0.0500  comb=0.0500  naive=0.0500
# k= 10  unbiased=0.4085  comb=0.4085  naive=0.4013
# k=100  unbiased=0.9992  comb=0.9992  naive=0.9941
稳定的写法和直接算组合数的结果一样。直觉上的 则略微偏低,论文在附录里证明了它一定会低估。它相当于从 个样本里「有放回」地抽 次,而无偏估计是无放回地抽。
还有一个更容易踩的坑,pass@k 要每题各自估计再平均,不能拿整个数据集的 pass@1 去推。拿三道难度相差很大的题目当例子,单次通过概率分别是 0.9、0.17、0.005,也就是 HumanEval 示例里那三题。假设每题抽 200 次,分别有 180、34、1 次通过。
三题的 pass@1 平均是 0.358,拿它去推 pass@100 会得到 1.0。实际上最难那题 200 次只对 1 次,随机拿 100 个,只有一半的机会拿到那一个,所以三题平均是 0.833。题目难度相差很大的时候,简单题的成绩会把难题盖过去。
解决问题
Codex:在 GitHub 上继续训练 GPT
训练数据是 2020 年 5 月从 GitHub 上 5,400 万个公开仓库收集的 Python 文件,去重后、小于 1MB 的文件共 179GB。作者再过滤掉可能是自动生成的文件、平均行长超过 100、最长一行超过 1,000,或字母数字字符比例太低的文件,最后剩下 159GB。
模型从 GPT-3 家族的权重开始微调,最大 120 亿参数。作者原本以为 GPT 已经有很强的自然语言表示,从它开始会比较好;结果最后的表现和从头训练差不多,作者猜是因为微调数据量太大。不过从 GPT 开始收敛更快,所以后续实验都这么做。训练共 1,000 亿个 token,学习率沿用对应 GPT 模型的设置。
分词器也沿用 GPT-3 的,但代码里的词分布和自然语言差很多,最浪费的是缩进用的空格。作者另外加了一组 token,表示不同长度的连续空格,同样的代码大约少用 30% 的 token。
采样用 nucleus sampling,top p = 0.95,温度则要随 k 调整。以 679M 的模型来说,pass@1 的最佳温度是 0.2,pass@100 是 0.8。k 大的时候,样本彼此越不同越好,反正只要有一个对就算。
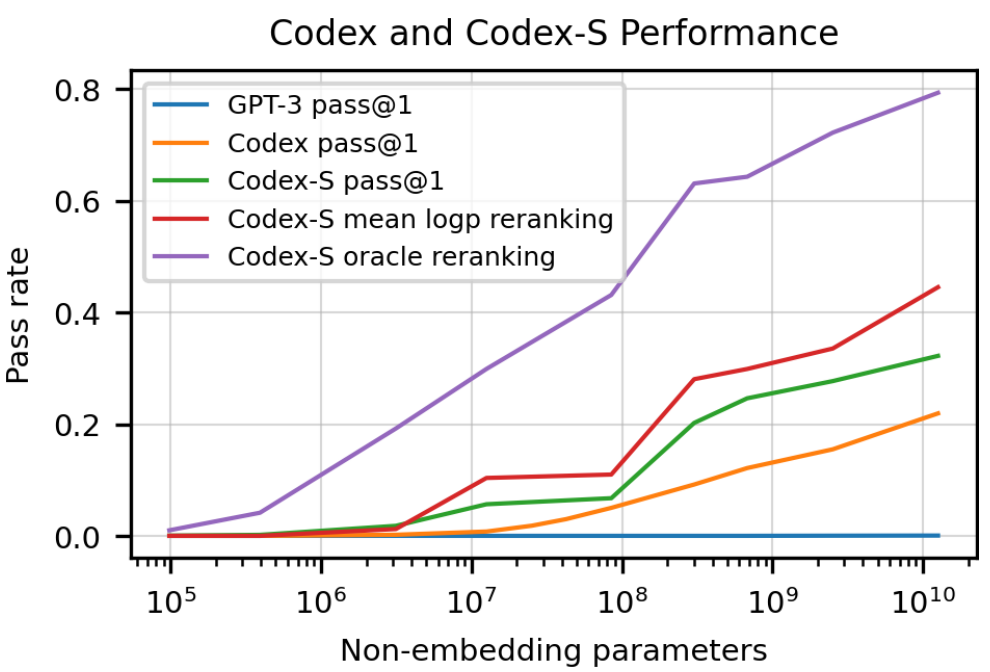
这张图把整篇的结果放在了一起。横轴是非嵌入参数量。蓝线是 GPT-3 的 pass@1,一路贴着 0;橙线是 Codex,绿线是下一节的 Codex-S。图里的样本一律用温度 0.8,所以这两条 pass@1 比论文报告的最佳成绩低;改用各自最合适的温度,12B 的 Codex 抽一次能解出 28.8%,Codex-S 是 37.7%。红线和紫线都是让 Codex-S 每题抽 100 个样本,区别在于怎么挑。红线挑平均对数概率最高的那个,44.5%;紫线由一个知道测试结果的 oracle 来挑,100 个里有一个通过就算,77.5%。
和其他模型比:
| 模型 | pass@1 | pass@10 | pass@100 |
|---|---|---|---|
| TabNine | 2.58% | 4.35% | 7.59% |
| GPT-Neo 2.7B | 6.41% | 11.27% | 21.37% |
| GPT-J 6B | 11.62% | 15.74% | 27.74% |
| Codex-300M | 13.17% | 20.37% | 36.27% |
| Codex-2.5B | 21.36% | 35.42% | 59.50% |
| Codex-12B | 28.81% | 46.81% | 72.31% |
整理自原论文 Table 1。
GPT-Neo 和 GPT-J 是 EleutherAI 用 The Pile 训练的开源模型,数据里约 8% 是 GitHub 代码,GPT 系列在同样大小下几乎是 0。GPT-J 6B 大约和 Codex-300M 相当,参数多了 20 倍。TabNine 是当时主流的代码自动补全工具,它最大的免费模型大约和 Codex-12M 相当。
Codex-S:让训练数据更像考题
GitHub 上的 Python 不只有独立函数,还有类、配置文件、脚本,甚至拿来存数据的文件,和「读 docstring 写函数」差得很远。作者另外收集了一批正确实现的独立函数,再做一次监督微调,称为 Codex-S。
数据有两个来源:
- 竞赛与面试练习网站:题目描述当作 docstring,加上函数签名与解答。完整测试通常不公开,作者就用题目描述里的示例构建测试,或者故意提交错误的解答,从反馈中挖出更多测试用例。共 10,000 题。
- 有持续集成(CI)的开源项目:用 Python 的
sys.setprofile追踪集成测试时每个函数的输入与输出,再把它们变成单元测试。作者按 travis 和 tox 的配置文件搭建环境、跑测试,也用了 PyPI 上的包。这类函数大多是命令行工具的零件,考的是照着 docstring 实现功能,而不是算法。共约 40,000 题。
自动收集的题目质量参差不齐,有的描述不完整,正确的答案也会被测试判错;有的带有状态,每次运行的结果都不同。作者让 Codex-12B 对每题抽 100 个答案,一个都过不了的,就当作题目有问题或太难,直接删掉;这个检查重跑了几次,把结果不稳定的题目也筛掉了。
训练时只对参考解答计算损失,提示词部分被屏蔽掉。学习率是 Codex 的十分之一,训练到验证损失不再下降为止,用了不到 100 亿个 token。
在各个模型大小上,Codex-S 的 pass@1 平均比 Codex 高 6.5 个百分点,pass@100 高 15.1 个百分点。
没有测试的时候怎么挑
pass@k 假设有人知道哪个答案是对的。实际当作自动补全来用的时候,用户只会看到一个建议,手边也没有单元测试。
作者比较了几种挑法。挑「平均每个 token 的对数概率」最高的样本,比随机挑好;改挑「总对数概率」最高的,反而可能比随机还差一点。
另一个想法是反过来写。作者训练了 Codex-D,读代码、写 docstring,再用它算「从这段代码写回原本 docstring」的概率,挑最高的那个。这个方法胜过随机,但输给平均对数概率,而且很快就过拟合。
Codex-D 本身也有点意思。作者人工给它写的 docstring 评分,能唯一且正确地描述代码才算对;它的 pass@1 是 20.3%,同样条件下 Codex-S 写代码是 32.2%。作者提到一个可能的原因,开发者写 docstring 本来就不太用心,模型甚至学会了写出「I just found this function online」和「This test is not correctly written and it's not my solution」。
讨论
说明越长,越写不对
作者用 13 个简单的字符串操作当零件,例如「把字符串转成小写」「删掉每第三个字符」,串成越来越长的 docstring,再看 Codex-12B 写不写得出来。
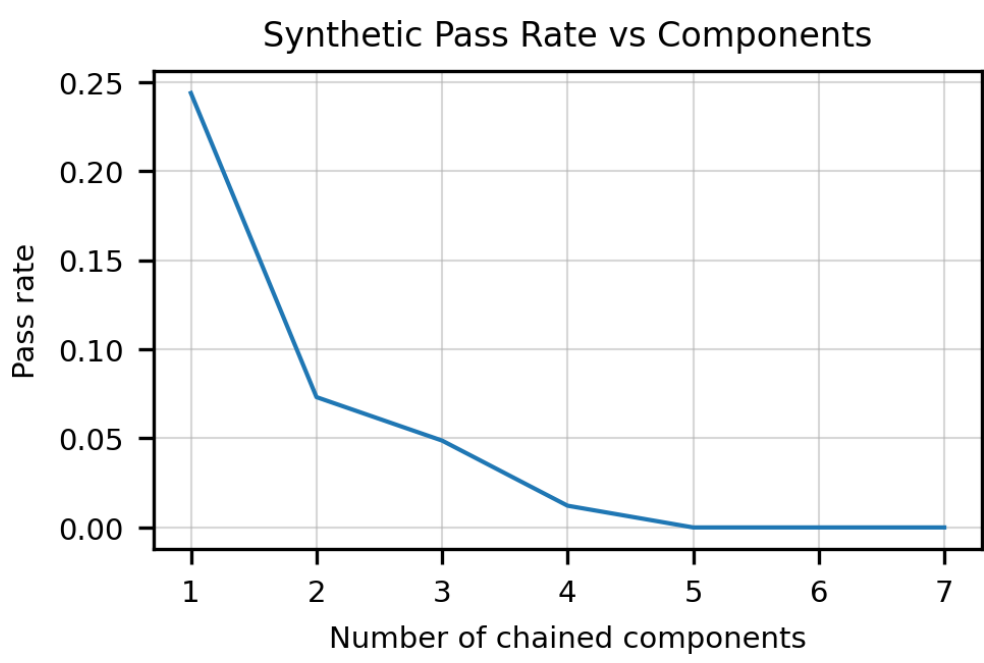
每多串一个零件,通过率大约降到原来的二分之一到三分之一,串到五个以上就是 0。人类工程师不会这样,会写两步的人,写七步只是比较花时间。
另一个问题是把操作绑定到正确的变量上。论文举了这个例子,要求「y 加 3,x 和 w 都减 4,返回四个数的乘积」:
def do_work(x, y, z, w):
    """ Add 3 to y, then subtract 4
    from both x and w. Return the
    product of the four numbers. """
    t = y + 3
    u = x - 4
    v = z * w
    return v
Codex-12B 没有把 w 减 4,最后也只返回了两个数的乘积。
明明会,却跟着写错
这是论文里最有远见的一个实验。作者在提示词里先放几个示例,一组是正确的代码,另一组带着细微的错误,例如差一错误或打错一个字符,再让模型写下一题。
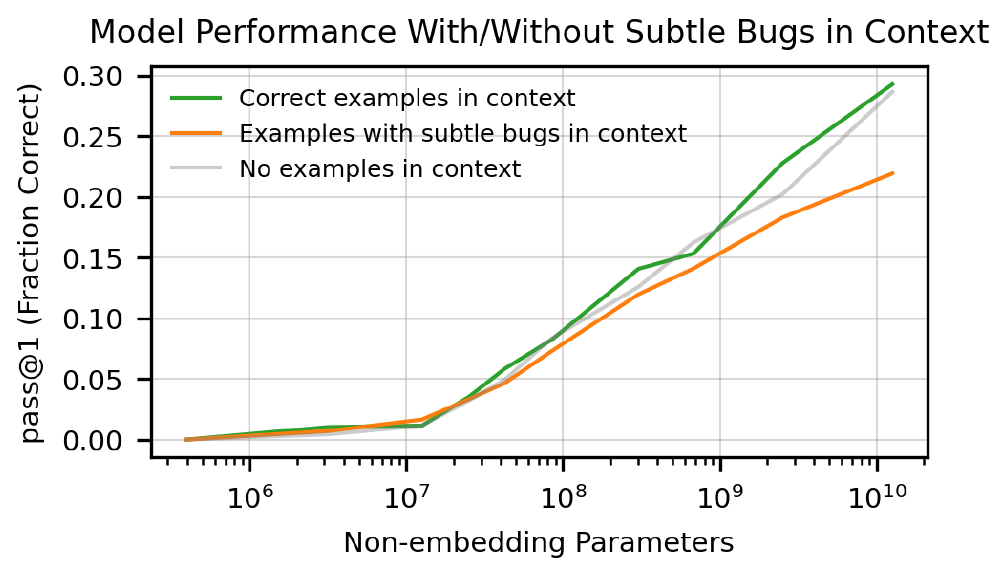
绿线是看了正确示例,橙线是看了有错的示例,灰线是没有示例。模型小的时候三条线差不多;模型越大,橙线落后越多,12B 时大约是 0.22 对 0.29。作者也试过在提示词里明确要求「写正确的代码」,只有一点帮助。
Codex 的训练目标是模仿训练数据,上下文里有 bug,它就跟着写有 bug 的代码。它有能力写对,却没按用户真正想要的去做。论文把这叫做未对齐(misalignment),并和「能力不足」区分开:做不到是能力问题,做得到却不做才是未对齐。麻烦的是,这个差距随模型变大而扩大。论文在附录列出的改进方向里,就包括用人类反馈做强化学习。
危害分析
论文第 7 节是一份危害分析,篇幅不输前面的实验。
- 过度依赖:Codex 可能给出看起来对、其实没做到用户要求的代码,新手特别容易中招。能力越强,人越容易放松警惕。
- 安全性:模型可能写出有漏洞的代码。作者测试后认为,以当时的能力,Codex 并没有明显降低编写恶意软件的门槛。
- 经济:工程师一天不只是在写代码,短期影响有限;但 Codex 引用各个软件包的频率不同,被推荐的软件包作者可能因此获益。
- 法律:生成的代码和训练数据完全相同的情况少于 0.1%,而且大多是语言里反复出现的惯用写法。
后来的事
HumanEval 很快成了代码模型的标准试卷,几乎每份 LLM 技术报告都会列出它的 pass@1。只是 164 题、平均 7.7 个测试,用久了就看得出漏洞。2023 年的 EvalPlus 给每题自动补了大量测试,总数约为原来的 80 倍,各模型的 pass@k 最多降了 19.3% 到 28.9%,排名也随之变动。原本「通过」的代码,有不少只是刚好没被测到。
分数也很快被推到了顶。2023 年的 GPT-4 是 67%,到了 2024 年,前沿模型的 pass@1 已经超过九成。大家只好改用更接近真实工作的评测,例如让模型修复 GitHub issue 的 SWE-bench。
至于 Codex 这个模型,OpenAI 在 2023 年 3 月就停用了 API 上的 Codex 系列。名字倒是没浪费。2025 年 4 月,OpenAI 推出在终端里写代码的 Codex CLI,5 月又推出云端的编程智能体,两个都叫 Codex。
结论
Codex 证明了,GPT 在大量代码上继续训练之后,就能根据 docstring 写出能跑的函数。12B 抽一次可以解出 28.8% 的 HumanEval;每题抽 100 次,七成以上的题目至少会写对一次。
这篇留得最久的是评分的规矩。代码的对错交给测试判断,不和参考答案比字面;pass@k 每题各自估计,再取平均。后来几年的代码模型,几乎都照这套规矩来比。
所以 docstring 写得随便,模型写出来的东西也认真不到哪里去。它在 GitHub 上读过的 docstring,连「I just found this function online」都有。