原始论文
Toolformer: Language Models Can Teach Themselves to Use Tools
- 发表版本
- NeurIPS 2023会议
- arXiv 首次提交
- arXiv:2302.04761
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{modeltuningtoolformer2023,
  title = {{Toolformer: Language Models Can Teach Themselves to Use Tools}},
  author = {Timo Schick and Jane Dwivedi-Yu and Roberto Dessì and Roberta Raileanu and Maria Lomeli and Luke Zettlemoyer and Nicola Cancedda and Thomas Scialom},
  year = {2023},
  eprint = {2302.04761},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.04761}
}
大语言模型有一个很矛盾的地方。它看几个示例就能做新任务,写文章、翻译、回答问题都像模像样,却常常算错简单的除法,记错某个人的出生地,也不知道今天是几月几号。这些事情,一个计算器、一个搜索引擎、一个日历就能解决。
让模型使用工具,在 2023 年初已经有人做了。只是做法大致有两种:一种要大量人工标注,例如 LaMDA 让标注者示范什么时候该查资料;另一种是给特定任务写少样本提示词,事先告诉模型这道题要用计算器、那道题要用搜索。前者很贵,后者换一个任务就得重写。
Meta 的 Schick 等人想让模型自己学。只给每种工具几个示范,让模型在大量的普通文本里自己插入工具调用,再由模型自己判断,哪些调用真的有帮助。
定义问题
作者希望学到的工具使用能力满足两个条件:
- 自监督:不需要大量人工标注。这不只是因为标注很贵,也因为人觉得有用的信息,不一定是模型需要的。
- 不失去通用性:模型自己决定要不要用工具、用哪一个、怎么用,而不是绑定在特定任务上。
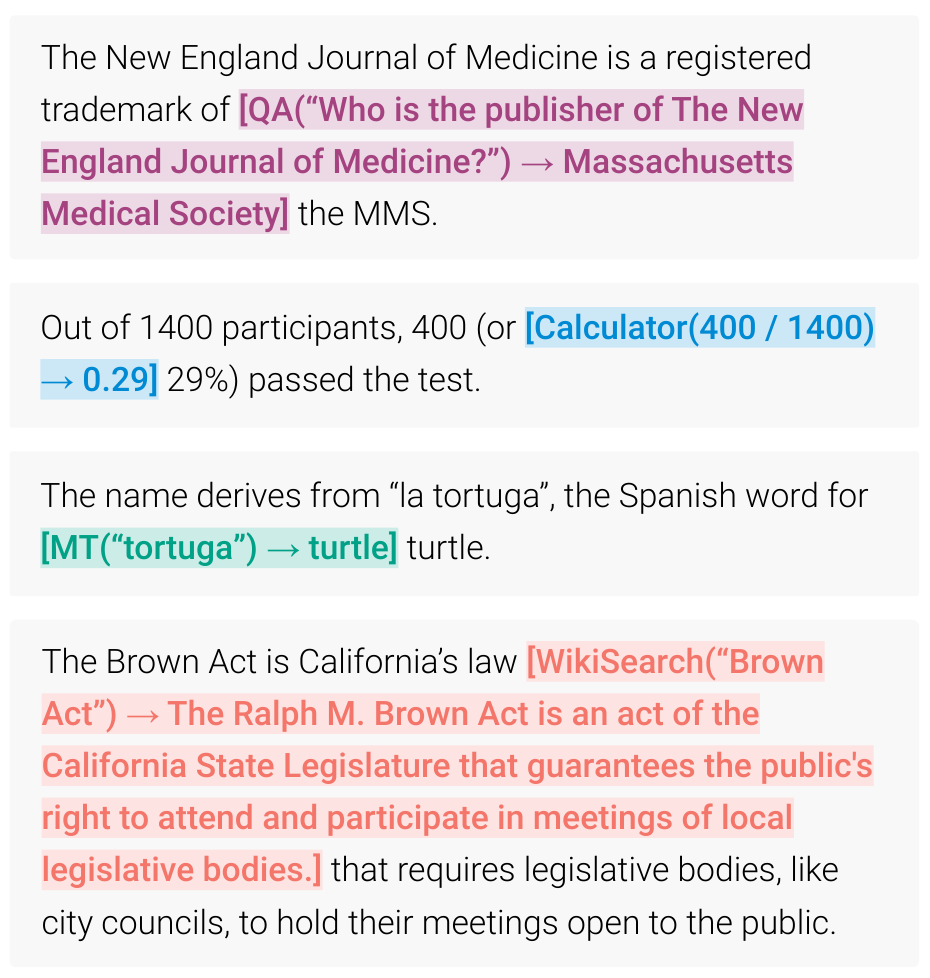
为了让工具调用能直接写进文本里,作者把每个 API 调用写成一段文本。调用 由 API 名称 和输入 组成,得到的结果是 :
实现上用「[」、「]」、「->」这几个现成的字符代替特殊符号,不用改动模型的词表。
解决问题
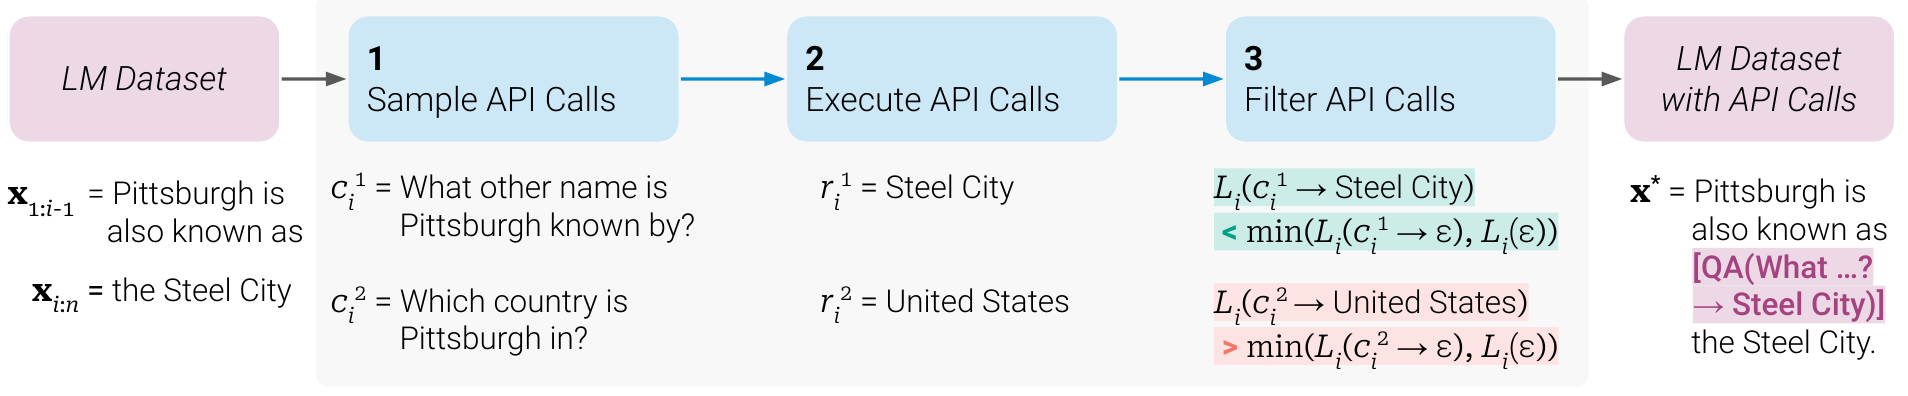
整个流程是在一份普通的语言模型训练数据上做文章。原来的数据集 是一堆纯文本,作者让模型给它插入工具调用,得到新的数据集 ,再用它微调模型自己。
一、采样调用
每种工具各写一个提示词,里面有几个示范。问答工具的提示词是这样的:
Your task is to add calls to a Question Answering API to a piece of text.
The questions should help you get information required to complete the text.
You can call the API by writing "[QA(question)]" where "question" is the
question you want to ask. Here are some examples of API calls:
Input: Joe Biden was born in Scranton, Pennsylvania.
Output: Joe Biden was born in [QA("Where was Joe Biden born?")] Scranton,
[QA("In which state is Scranton?")] Pennsylvania.
Input: Coca-Cola, or Coke, is a carbonated soft drink manufactured by
the Coca-Cola Company.
Output: Coca-Cola, or [QA("What other name is Coca-Cola known by?")] Coke,
is a carbonated soft drink manufactured by [QA("Who manufactures Coca-Cola?")]
the Coca-Cola Company.
Input: x
Output:
原论文 Figure 3 的提示词。
把一段文本 放进提示词,对每个位置 算出模型在这里开始写 <API> 的概率 。概率超过阈值 的位置留下,最多 个;每个位置再采样最多 个调用内容。
二、执行调用
作者准备了五种工具,输入和输出都是文本:
| 工具 | 输入示例 | 输出示例 |
|---|---|---|
| 问答 | Where was the Knights of Columbus founded? | New Haven, Connecticut |
| 维基百科搜索 | Fishing Reel Types | 一段关于鱼竿与渔线轮种类的维基百科摘录 |
| 计算器 | 27 + 4 * 2 | 35 |
| 日历 | (不需输入) | Today is Monday, January 30, 2023. |
| 翻译 | sûreté nucléaire | nuclear safety |
整理自原论文 Table 1。
- 问答:Atlas,一个在 Natural Questions 上微调过、会先检索再回答的语言模型。
- 维基百科搜索:用 BM25 在 KILT 的维基百科数据上检索,返回短的文本片段。
- 计算器:只有加减乘除,结果四舍五入到小数点后两位。
- 日历:不需要输入,返回今天的日期。
- 翻译:600M 参数的 NLLB,用 fastText 自动判断源语言,一律翻成英文。
三、过滤:这次调用有没有帮上忙
这是整篇最关键的一步。作者用模型自己的损失来判断调用有没有用。
令 为在前面加上 之后,模型预测位置 之后各个 token 的加权交叉熵:
接着比较两种情况:
是调用并拿到结果; 是不调用,或调用了但没拿到结果,两者取较好的那个。只有 的调用会留下来。
和「调用了但没拿到结果」比,是为了排除一种情况。有时候光是写出问题本身,就提示了后面的内容;这种调用的功劳不在工具,不该留下。
权重 用 再归一化,调用之后第 1 到第 5 个 token 的原始权重依次是 1、0.8、0.6、0.4、0.2,再往后就是 0。越近权重越大,让调用出现在信息真正派上用场的地方。以「Pittsburgh is also known as the Steel City」这句为例,在 the 之前插入问答调用,拿到「Steel City」之后,模型几乎能确定下一个词是 Steel,损失大幅下降,这个调用会留下;问 Pittsburgh 在哪个国家、拿到「United States」,对预测「the Steel City」毫无帮助,就会被丢掉。
过滤时还有一个细节。这时候的模型还没见过任何工具调用,如果把调用硬插在句子中间,会打断文本的流畅度,反而拉高困惑度。所以在算 时,作者把调用和结果放在整段文本的最前面作为前缀。
四、微调
把各种工具留下的调用合并,插回原来的文本,得到 。 除了多出来的调用,文本内容和 一模一样,所以模型在上面微调,看到的知识和原来相同,语言能力也不至于受损。
文本数据是 CCNet 的一部分,模型是 GPT-J 6B。为了省下标注的计算量,作者先用规则挑出比较可能用到工具的文本,例如计算器只处理至少含有三个数字的段落。微调的 batch 大小是 128,学习率 ,前 10% 的步数线性预热。
最后能留下多少调用,因工具而异。过滤阈值 时,维基百科搜索有 60,974 条,日历 20,587 条,问答 18,526 条,翻译 1,034 条,计算器只有 994 条。
推理阶段
微调之后正常解码。模型写出「→」,表示它在等工具的结果;这时暂停解码,真的去调用工具,把结果和「]」接上去,再让模型继续写。例如模型写到「[Calculator(400 / 1400) →」时暂停,计算器算出 0.29,接上「0.29]」之后,模型再往下写「29%」。
解码也做了两处调整。只要 <API> 是概率最高的前 10 个 token 之一,就让模型开始调用,而不是一定要排第一,鼓励它多用工具;每个输入最多调用一次,避免模型陷入一直调用、不写答案的循环。
讨论
实验设置
主要比较四个模型:原来的 GPT-J;在同一批 CCNet 文本上微调、但不加工具调用的 GPT-J + CC;Toolformer;以及把 <API> 的概率设成 0、不准用工具的 Toolformer。另外也和 OPT 66B、GPT-3 175B(没有指令微调的 davinci)比较。
全部是零样本,只用文字说明任务,不给示例,而且不告诉模型该用哪个工具。评分比较宽松,例如答案出现在模型输出的前几个词里就算对。
结果
| 任务 | GPT-J | 停用工具 | Toolformer | GPT-3 175B |
|---|---|---|---|---|
| LAMA SQuAD | 17.8 | 22.1 | 33.8 | 26.8 |
| LAMA Google-RE | 4.9 | 6.3 | 11.5 | 7.0 |
| LAMA T-REx | 31.9 | 34.9 | 53.5 | 39.8 |
| ASDiv | 7.5 | 14.8 | 40.4 | 14.0 |
| SVAMP | 5.2 | 6.3 | 29.4 | 10.0 |
| MAWPS | 9.9 | 15.0 | 44.0 | 19.8 |
| WebQS | 18.5 | 18.9 | 26.3 | 29.0 |
| Natural Questions | 12.8 | 12.6 | 17.7 | 22.6 |
| TriviaQA | 43.9 | 46.7 | 48.8 | 65.9 |
| TempLAMA | 13.7 | 12.7 | 16.3 | 15.5 |
| Dateset | 3.9 | 5.9 | 27.3 | 0.8 |
整理自原论文 Table 3、4、5、7;「停用工具」是不准调用 API 的 Toolformer,单位为 %。
填空式的知识题(LAMA):98.1% 的题目模型都自己去问了问答工具,三个子集都赢过 GPT-3。LAMA 的句子取自维基百科,所以这里禁用了维基百科搜索,免得太容易。
数学应用题:97.9% 的题目都调用了计算器,分数是停用工具时的两倍以上,也远远超过 GPT-3。有趣的是,停用工具的 Toolformer 本身也比 GPT-J 好,作者推测是看了大量算式和结果之后,模型自己的计算能力也变好了。
开放问答:问答工具是在 Natural Questions 上微调的,用了就等于作弊,所以这里禁用。模型 99.3% 的时候改用维基百科搜索,赢过其他 GPT-J,但仍然输给 GPT-3。作者认为原因有两个:BM25 搜索引擎很简陋,常常返回不相关的结果;Toolformer 也不会换个关键词重查,或往下多看几条结果。
时间相关的题目:Dateset 要先知道今天的日期才能回答,例如「30 天前是星期几?」,54.8% 的题目用了日历,分数从 5.9% 升到 27.3%。TempLAMA 问的是会随时间改变的事实,例如某位球员效力于哪支球队,Toolformer 也有进步,但只有 0.2% 的题目用了日历,靠的主要是搜索和问答。最好的做法是先查日期、再拿日期去问,但每道题只准调用一次,而且训练数据里的调用都是各工具分开采样的,模型没见过这种接力。
多语言问答(MLQA):问题用阿拉伯语、德语、西班牙语、印地语、越南语或简体中文,背景段落是英文。视语言不同,模型在 63.8% 到 94.9% 的题目上会先把问题翻成英文,比停用工具时好;印地语是例外,只有 7.3% 用了翻译。不过 Toolformer 没有稳定地胜过原来的 GPT-J,因为在 CCNet 上微调本身就让某些语言退步了。
语言能力没有变差
| 模型 | WikiText | CCNet |
|---|---|---|
| GPT-J | 9.9 | 10.6 |
| GPT-J + CC | 10.3 | 10.5 |
| Toolformer(停用工具) | 10.3 | 10.5 |
整理自原论文 Table 8;数字是困惑度,越低越好。
在 CCNet 上微调,会让 WikiText 的困惑度稍微变差,但加不加工具调用没有差别。开着工具时的困惑度则没办法算,因为每个位置都可能调用各种工具,要把所有可能性都加总起来才能得到概率。
模型要多大才学得会
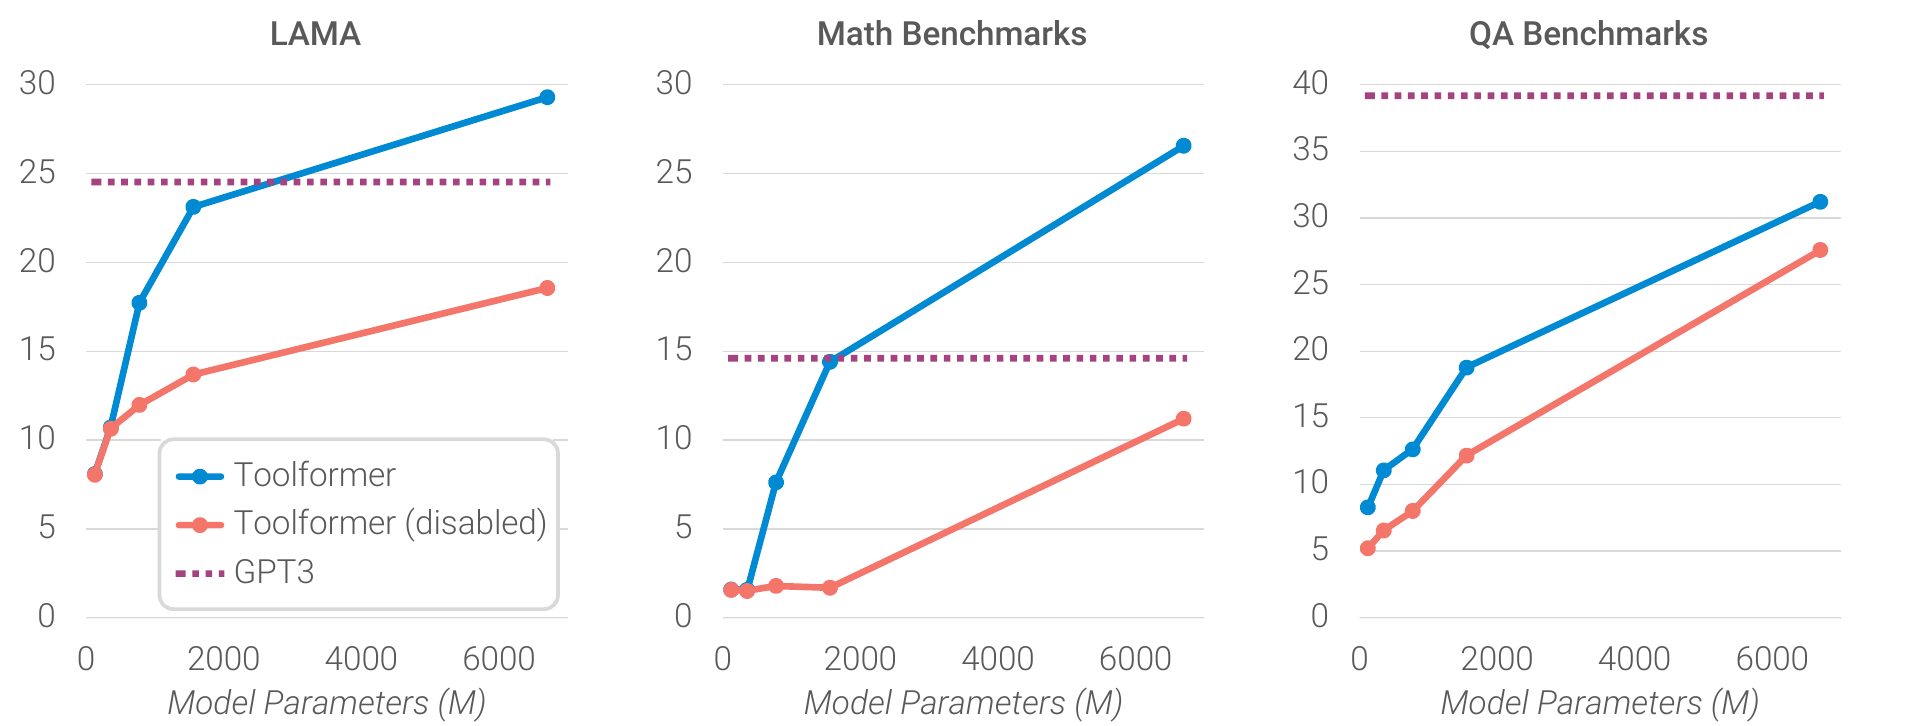
作者用 GPT-2 的四种规模重做了一次,只给问答、计算器、维基百科搜索三种工具。使用工具的能力大约在 775M 参数时才出现,更小的模型有没有工具都差不多。维基百科搜索是例外,小模型也用得上,作者推测是因为这个 API 比较简单。模型变大,不用工具时的能力变强,用工具的能力也同时变强,所以两者的差距一直存在。
解码的阈值
| T-REx | 调用比例 | WebQS | 调用比例 | |
|---|---|---|---|---|
| 0 | 34.9 | 0.0% | 18.9 | 0.0% |
| 1 | 47.8 | 40.3% | 19.3 | 8.5% |
| 3 | 52.9 | 82.8% | 26.3 | 99.3% |
| 10 | 53.5 | 98.1% | 26.3 | 100% |
整理自原论文 Table 9,节选部分列;T-REx 与 WebQS 列是准确率(%)。
是 <API> 要排进前几名才开始调用, 等于停用工具, 就是普通的贪婪解码。普通的贪婪解码下,模型在 WebQS 上只有 8.5% 的题目会调用工具,分数几乎没变;把阈值放宽到前 3 名,才开始大量使用。
时,模型决定不调用的那些题目,分数(T-REx 44.3%、WebQS 19.9%)反而比完全不准用工具时的平均(34.9%、18.9%)还高。说明模型多少知道自己哪些题目不会,会把工具留给那些题目。放宽阈值之后,这种判断就不见了。
留下来的调用长什么样
作者把过滤分数 从高到低列出了一些例子。分数高的大多很合理,例如提到英国最古老的战争纪念窗时去搜索 Flodden,分数 5.49;写到「The Nile has an approximate length of」时去问尼罗河有多长,分数 2.08。
分数低的大多没有用,例如写到「85 patients (23%)」时算了 85 / 23,分数 −0.02。但「Catch this fast train to success!」去搜索「Fast train success」,搜到一首 1971 年的歌,内容毫不相关,却还是降低了困惑度,分数 0.92。作者认为少量这种噪声不一定是坏事,模型因此不会盲目相信每个工具的结果。
局限
作者自己列了这几点:
- 不能串联工具:例如先查日期再拿日期去问,因为各工具的调用是分开采样的,训练数据里没有这种例子。
- 不能交互:搜索引擎可能返回几百条结果,模型不会浏览,也不会修改查询。
- 对措辞敏感:要不要调用工具,很容易受输入的写法影响。
- 效率很低:处理超过一百万份文档,只能得到几千个有用的计算器调用。作者建议可以像其他自举方法一样迭代进行。
- 不考虑成本:调用不同工具的计算成本差很多,模型做决定时没有考虑这一点。
后来的事
Toolformer 发表四个月后,工具使用成了商业模型的标准功能,但走的是另一条路。2023 年 6 月 13 日,OpenAI 在 API 中加入了 function calling:开发者用 JSON 描述自己的函数,模型判断需要时,输出一个带参数的 JSON 对象,由应用程序去执行,再把结果交回模型。工具由开发者定义,模型在训练时就学会照着描述调用,不再需要自己从普通文本里摸索。
Toolformer 列为局限的串联和交互,在智能体(agent)的循环里都成了基本能力:模型调用工具、看结果、决定下一步,一个任务可以来回几十次。2024 年 11 月,Anthropic 提出 Model Context Protocol,作为把 AI 助手连接到各种数据源和工具的开放标准,工具的接入方式也开始统一。
结论
Toolformer 只给每种工具几个示范,让 GPT-J 在普通文本里自己插入工具调用,再用「有没有让后面的文本更好预测」来筛选。微调之后,这个 6B 的模型在知识填空、数学应用题和日期题上都赢过了 GPT-3 175B,语言能力也没有变差。
这篇最有意思的设计,是让模型自己判断工具有没有用。哪里该插一个问题、哪个答案有帮助,都由模型的损失决定,没有人告诉它;连那条搜到 1971 年老歌的调用,也是模型自己觉得有帮助才留下的。
后来的工具使用没有沿用这套自监督,改由开发者写好工具说明、模型照着调用,简单又可控。不过「调用写在文本里、结果接回文本里、模型接着往下写」这个格式倒是留了下来,今天的智能体每一步都是这样运作的。