原始論文
SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
- 發表版本
- ICLR 2024會議
- arXiv 首次提交
- arXiv:2310.06770
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelevaluationswebench2023,
  title = {{SWE-bench: Can Language Models Resolve Real-World GitHub Issues?}},
  author = {Carlos E. Jimenez and John Yang and Alexander Wettig and Shunyu Yao and Kexin Pei and Ofir Press and Karthik Narasimhan},
  year = {2023},
  eprint = {2310.06770},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2310.06770}
}
2023 年,語言模型寫程式的能力,大多用 HumanEval 這類評測衡量:給一個函式簽名和說明,寫出函式本體,跑幾個單元測試。題目都是獨立的,幾行程式就能解決。
真實的軟體工作不是這樣。修一個 bug,可能要在幾千個檔案的專案裡找到相關的程式碼,搞懂不同檔案之間的函式怎麼互相呼叫,從一團複雜的邏輯裡找出那一行寫錯的地方,再改得不弄壞其他功能。
當時的評測一個接一個被做到接近滿分,已經量不出最強的模型到底能做到什麼。Princeton 的 Jimenez、Yang 等人把目光轉向 GitHub:開源專案裡有大量真實的問題回報(issue),以及實際修好它們的合併請求(pull request),還附帶專案自己的測試。
定義問題
好的評測要夠難,難倒現有的模型;答案又要容易驗證。程式題的好處在於能跑測試,但現有的程式評測太簡單、太乾淨。
作者想要的評測要符合幾個條件:題目來自真實的工作,輸入很長、很雜,要改的地方可能分散在好幾個檔案,用專案原本的測試來判斷對錯,而且能持續加入新題目,避免模型在訓練時已經看過答案。
解決問題
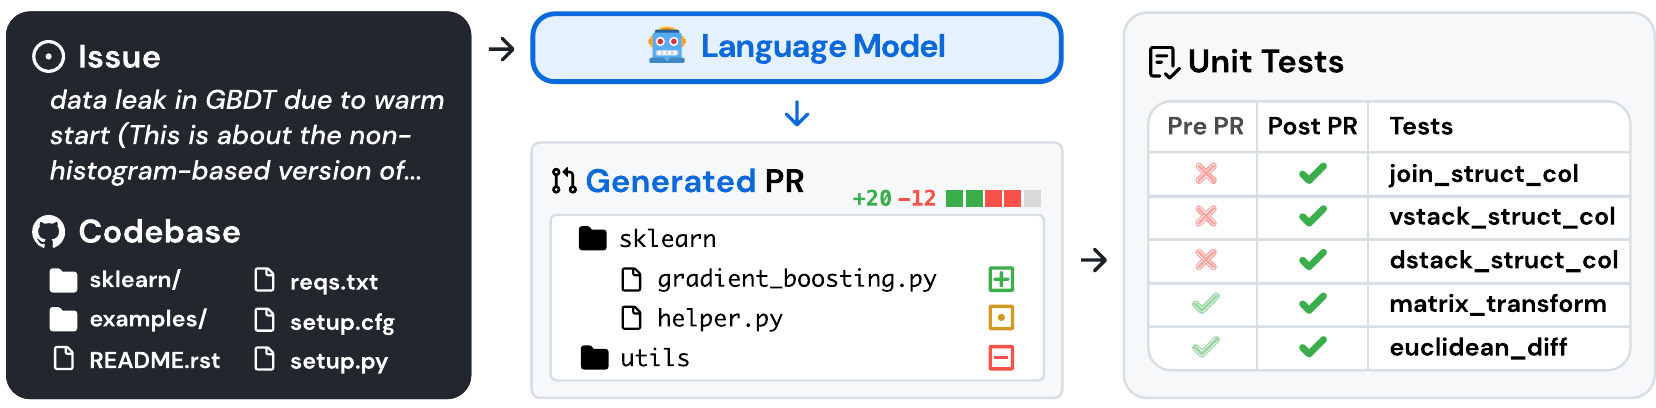
任務很直接。給模型一則 issue 的文字和整個程式庫,要它產生一個修改,用 patch 檔的格式表示要改哪幾行。評估時用 Unix 的 patch 程式把修改套上去,再執行這一題相關的測試;修改能成功套用、而且測試全部通過,才算解決。整份評測的成績,就是解決的題目比例。
從九萬個合併請求篩到 2,294 題
作者分三個階段篩選:
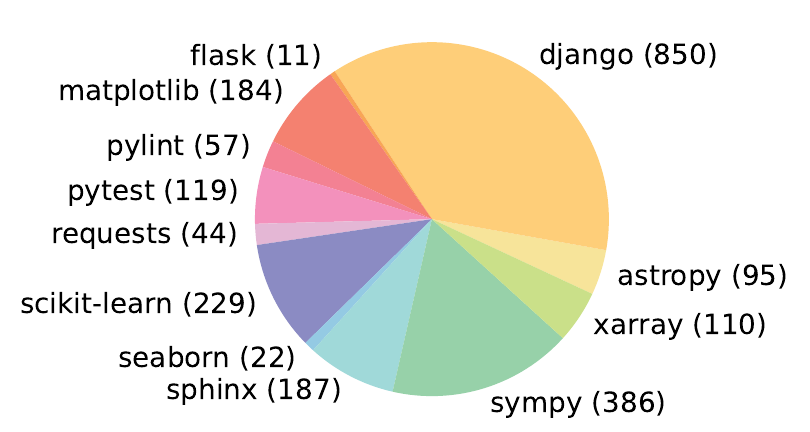
- 挑專案、抓資料:選 12 個熱門的 Python 開源專案,總共抓到約 9 萬個合併請求。熱門專案通常維護得比較好,貢獻規範清楚,測試也比較完整。每個合併請求對應的程式庫版本,就是它的 base commit。
- 用屬性篩選:只留下已經合併、解決了某個 issue,而且有修改測試檔的合併請求。修改了測試檔,表示作者很可能加了測試來確認問題已經修好。
- 用執行結果篩選:先只套用合併請求裡的測試修改,記錄測試結果;再套用其餘的程式修改,記錄一次。至少要有一個測試從失敗變成通過,才留下來;安裝失敗或執行出錯的也刪掉。
最後剩下 2,294 題。
題目長什麼樣
| 項目 | 平均 | 最大 |
|---|---|---|
| issue 文字長度(字) | 195.1 | 4,477 |
| 程式庫的檔案數(不含測試) | 3,010 | 5,890 |
| 程式庫的行數(不含測試) | 438K | 886K |
| 標準修改改動的行數 | 32.8 | 5,888 |
| 標準修改改動的檔案數 | 1.7 | 31 |
| 標準修改改動的函式數 | 3 | 36 |
| 修改前失敗、修改後通過的測試數 | 9.1 | 1,633 |
| 測試總數 | 120.8 | 9,459 |
整理自原論文 Table 1;「標準修改」是實際合併的那份修改(gold patch)。
平均每題的程式庫有 3,000 個檔案、43.8 萬行程式,要改的卻只有 1.7 個檔案、30 多行。模型得在一大片程式碼裡,找到真正要改的那幾行。
測試分成兩種。修改前失敗、修改後通過(fail-to-pass,F2P)的測試,檢查 issue 回報的問題有沒有修好,每題至少一個,40% 的題目有兩個以上。修改前後都要通過(pass-to-pass,P2P)的測試,檢查原本的功能有沒有被改壞,每題的中位數是 51 個。
兩種測試都要通過才算解決。舉個簡單的例子,issue 回報 1900 年被誤判成閏年,F2P 測試就檢查 1900 年;如果修補只加上「不能被 100 整除」,1900 年修好了,2000 年卻也變成平年,原本通過的 P2P 測試會抓到這個錯。
這樣設計的好處
- 真實:題目和解答都是使用者實際提交的,要的是資深工程師的技能。
- 能持續更新:收集流程幾乎不需要人工,可以套用到任何 Python 專案。只要拿模型訓練截止之後才出現的 issue 來考,就能確定答案不在訓練資料裡。
- 輸入又長又雜:issue 平均 195 字,程式庫動輒上千個檔案。
- 跨檔案修改:不像 HumanEval 只改一個函式,或是填空式的題目,這裡沒有任何提示告訴你該改哪裡。
- 解法開放:模型的修改不必和標準修改一樣,只要通過測試就算數;檢索、長上下文、代理(agent)等各種做法都能在同一個標準上比較。
全部 2,294 題跑一次很花時間和 API 費用,作者另外挑了 300 題組成 SWE-bench Lite,偏向比較獨立的功能性 bug,涵蓋 12 個專案中的 11 個。
SWE-Llama
開源模型裡,當時只有 CodeLlama 能處理這麼長的上下文,但現成的版本不太會照指示產生整個程式庫的修改,常常只輸出佔位文字或不相關的程式。作者用同樣的流程,從另外 37 個 Python 專案收集了 1.9 萬組 issue 和合併請求,這次不要求一定要有測試修改,專案也和評測完全不重疊。
用這份資料微調 CodeLlama-Python 7B 和 13B,得到 SWE-Llama。為了省記憶體,只用 LoRA 微調注意力層,並排除超過 3 萬 token 的訓練序列,實際用到約 1 萬筆。輸入是指示、issue 和相關的程式檔案,目標是產生標準修改。
怎麼把程式庫塞進上下文
平均 43.8 萬行的程式庫,不可能整個塞進當時的上下文。作者用兩種方式挑檔案:
- BM25 檢索:用 issue 的文字當查詢,檢索相關的檔案,塞到 1.3 萬、2.7 萬或 5 萬個 token 的上限為止。程式碼配上自然語言查詢,而且查詢和文件都很長,作者認為不適合用稠密檢索。
- Oracle 檢索:直接給標準修改動到的那幾個檔案。這不切實際,工程師一開始也不知道要改哪些檔案,但可以拿來分析。
上限 2.7 萬 token 時,BM25 大約四成的題目能把 oracle 的檔案全部找到,但也有將近一半的題目,一個都沒找到。
評測的模型有 ChatGPT-3.5(16K 上下文)、GPT-4(32K)、Claude 2(100K)和 SWE-Llama。上下文越短,能把 oracle 檔案完整放進去的題目就越少,GPT-4 是 84.1%,ChatGPT-3.5 只有 58.1%。
討論
幾乎都解不出來
| 模型 | 解決 | 修改能套用 | Lite 解決 |
|---|---|---|---|
| Claude 3 Opus | 3.79 | 46.56 | 4.33 |
| Claude 2 | 1.97 | 43.07 | 3.00 |
| ChatGPT-3.5 | 0.17 | 26.33 | 0.33 |
| GPT-4-turbo | 1.31 | 26.90 | 2.67 |
| SWE-Llama 7b | 0.70 | 51.74 | 1.33 |
| SWE-Llama 13b | 0.70 | 53.62 | 1.00 |
整理自原論文 Table 5;BM25 檢索,單位為 %。
最好的模型解決不到 4%,論文發表時最好的 Claude 2 不到 2%。有一半以上的修改,連格式都不對,根本套不上去。
給 oracle 檔案會好一些。Claude 2 從不到 2% 升到 4.80%,SWE-Llama 13b 是 3.97%,GPT-4(只測了隨機四分之一的題目)是 1.74%。
各專案的難度差很多
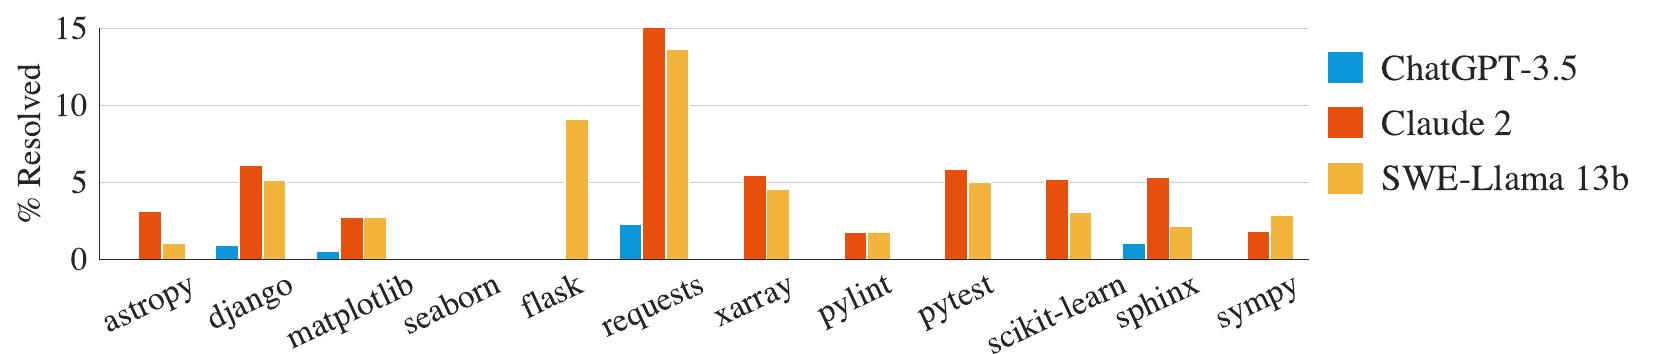
三個模型在各專案的高低趨勢相似,但解出來的題目重疊不多。oracle 設定下,Claude 2 解出 110 題,SWE-Llama 13b 解出 91 題,而 SWE-Llama 解出的題目,Claude 2 只解出其中 42%。
有些專案的 issue 帶圖片,以 Markdown 的圖片連結嵌在文字裡。matplotlib 有 32% 的題目帶圖,seaborn 有 10%,整體只有 2%。這類題目可能需要多模態模型,或是能處理圖片的工具。
上下文越長,表現越差
Claude 2 的表現隨著輸入的總長度增加而明顯下降,其他模型也一樣。BM25 的上限從 1.3 萬放寬到 5 萬 token,找到 oracle 檔案的比例變高了,Claude 2 的解決率反而從 1.96% 降到 1.22%。模型看到太多和問題無關的程式碼,就找不到真正要改的地方。
作者另外做了一個「oracle 摺疊」的實驗:一樣給 oracle 檔案,但只保留標準修改動到的行,上下各留 15 行,其餘全部摺起來。Claude 2 從 4.8% 升到 5.9%,GPT-4 升到 3.40%。
其他觀察
- 和 issue 的日期無關:把題目分成 2023 年以前和以後,大部分模型的表現差不多(GPT-4 只測了四分之一的題目,以後的那組是 0)。作者認為這表示模型就算看過舊版的程式庫,也很難靠背答案來作弊。
- 微調的模型怕換上下文:SWE-Llama 是用 oracle 檔案訓練的,學到的是「給我的每個檔案都要改」;換成 BM25 給的一堆不相關檔案,表現就很差。
- 寫 patch 比重寫整個檔案容易:模型平常看的多半是完整的程式檔,很少看到 patch,作者試過讓模型直接輸出修改後的整個檔案。結果反而更差,Claude 2 在 oracle 檢索下從 4.8% 掉到 2.2%。
- 模型改得比較少:以整個修改檔的總行數(含上下文)來算,成功套用的修改平均只有 17 到 30 行,同一批題目的標準修改是 34 到 44 行,全部標準修改則是 74.5 行。模型幾乎都只改一個檔案。
一個沒修好的例子
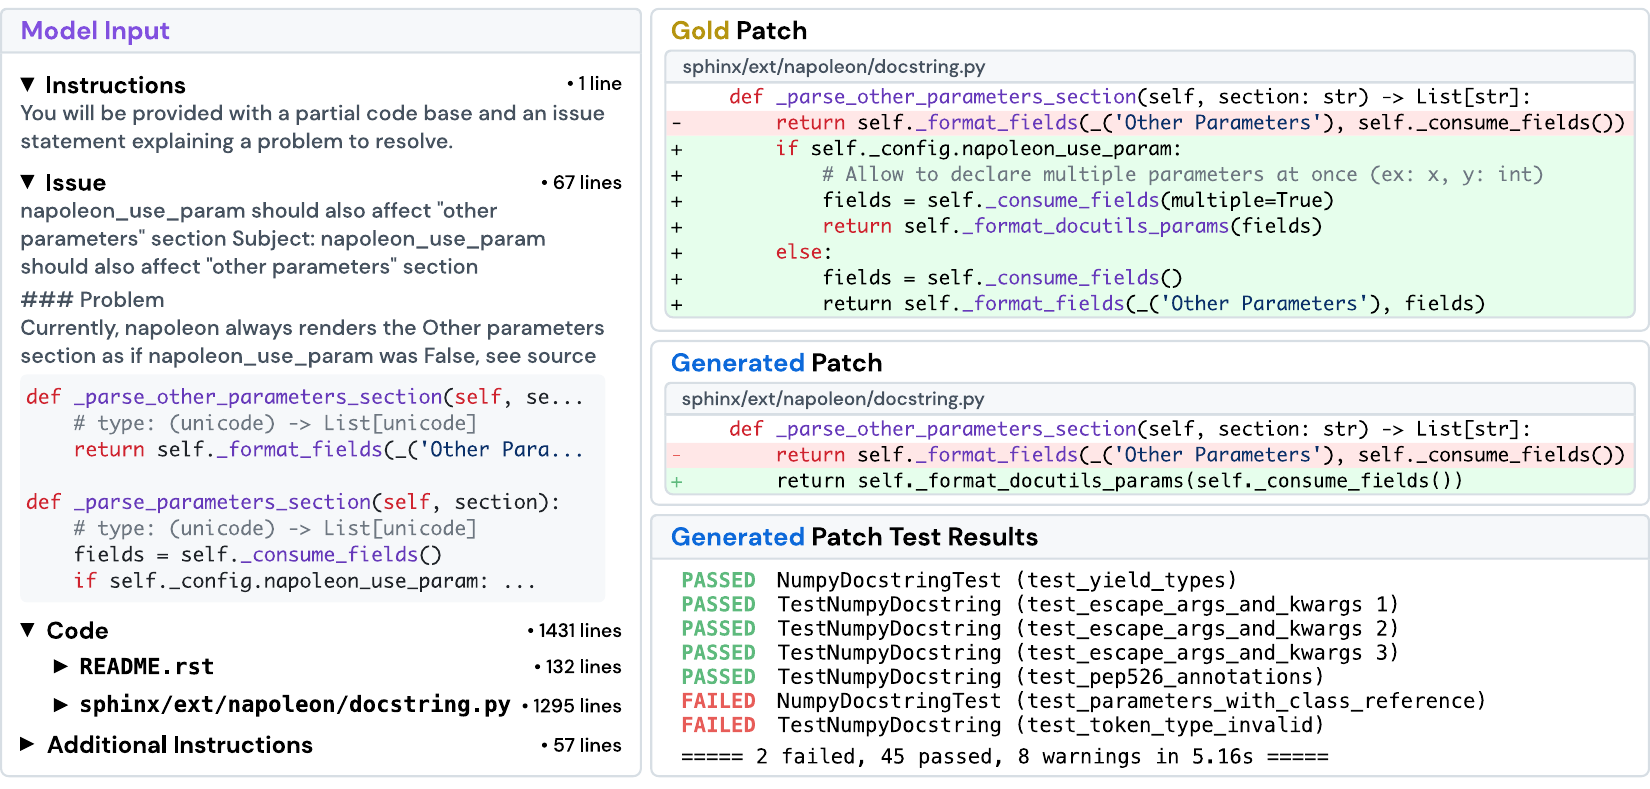
這則 issue 說,Sphinx 的 napoleon 擴充套件在設定 napoleon_use_param 為 True 時,「Other Parameters」區段的格式不對。issue 寫得很詳細,還附上了可能有問題的程式碼片段。
oracle 設定下,輸入共 1,558 行、20,882 個 token。SWE-Llama 改對了函式,卻讓它不管設定是什麼,都當成 napoleon_use_param 為 True 來處理;標準修改則是先檢查設定,照著隔壁 _parse_parameters_section 的寫法。有一個測試正好在設定為 False 的情況下比對輸出,馬上抓到了這個錯。
作者看了 11 份 SWE-Llama 和 Claude 2 的輸出,歸納出幾個傾向。模型寫的程式很原始,不太會用現成的函式庫或程式庫裡已有的工具;解法很「貪心」,只針對 issue 描述的情況修,不太在意程式風格或專案的慣例,例如該用相對匯入還是絕對匯入。人寫的標準修改,常常順手做結構上的改進,連可能發生的相關問題也一起處理掉。
限制
- 只有 Python:作者希望未來把同樣的收集流程用在其他語言。
- 只建立基準線:論文用的是最簡單的做法,檢索幾個檔案、一次產生修改。作者鼓勵之後嘗試代理、搭配工具等其他做法。
- 測試抓不到的地方:通過測試的程式,還是可能寫得不完整、沒效率或難讀;模型寫的修改常常在這些方面不如人寫的。
後來的事
作者在限制裡建議的代理做法,很快由同一個團隊做出來了。2024 年 5 月的 SWE-agent 替語言模型設計了一套專用的操作介面,讓它能瀏覽整個程式庫、開檔案、編輯、跑測試,在完整的 SWE-bench 上解決了 12.5% 的題目。
2024 年 8 月 13 日,OpenAI 發布了 SWE-bench Verified。他們請 93 位有經驗的 Python 開發者檢查了隨機抽出的 1,699 題,排除描述不清楚、或測試對正確解法不公平的題目,留下 500 題。在當時最好的開源框架下,GPT-4o 解決了 33.2%。
之後 SWE-bench Verified 成了各家發布新模型時,最常列出的程式能力指標。2024 年 10 月,升級版的 Claude 3.5 Sonnet 從 33.4% 提高到 49.0%;2025 年 5 月,Claude Opus 4 是 72.5%。這些都是在人工篩選過的 Verified 上,不能直接和原始 2,294 題的數字相比,但從不到 2% 走到七成,只花了一年半。
結論
SWE-bench 從 12 個熱門 Python 專案的 9 萬個合併請求裡,篩出 2,294 個真實的 issue,用專案自己的測試判斷有沒有修好。論文發表時,最好的 Claude 2 只解出不到 2%,給它正確的檔案也只有 4.8%。
難的地方不只是寫程式。模型得在 43.8 萬行的程式庫裡找到要改的那 30 行,給它的程式碼越多,反而越找不到;改了還要不弄壞其他功能,每題的 P2P 測試中位數有 51 個在旁邊看著。
這份評測設計得夠真實,所以沒有很快被做到滿分。一年半後,排行榜上的數字從個位數爬到七成,靠的不只是模型變強,還有模型學會了像工程師一樣,在程式庫裡四處翻找、跑測試、看錯誤訊息再改。