原論文
Large Language Models are Zero-Shot Reasoners
- 発表先
- NeurIPS 2022国際会議
- arXiv への初回投稿
- arXiv:2205.11916
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{transformerszeroshotcot2022,
  title = {{Large Language Models are Zero-Shot Reasoners}},
  author = {Takeshi Kojima and Shixiang Shane Gu and Machel Reid and Yutaka Matsuo and Yusuke Iwasawa},
  year = {2022},
  eprint = {2205.11916},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2205.11916}
}
GPT-3 の論文タイトルは「Language Models are Few-Shot Learners」だった。それ以来、大規模言語モデルのすごさといえば、まず思い浮かぶのは少数ショット学習だ。プロンプトに例をいくつか入れておけば、モデルは新しいタスクを覚える。
2022 年 1 月の思考の連鎖プロンプトも、この路線にある。例の答えに推論のステップを書いておけば、モデルもそれにならって書き、数学の問題の成績が大きく伸びる。あの論文はゼロショットの成績を報告すらしておらず、例を与えないなら比べるまでもない、と言わんばかりだった。
四か月後、東京大学の Kojima と Google の Shane Gu らは、例を全部取り払ってもよいことに気づいた。答えの前に「Let's think step by step」の一文を加えるだけで、text-davinci-002 は MultiArith で 17.7% から 78.7% に、GSM8K で 10.4% から 40.7% に上がった。
問題の定義
少数ショットの思考の連鎖には面倒が二つある。例はタスクごとに人が手で書かなければならず、推論のステップはうまく書く必要があるし、答えの形式もそろえなければならない。しかも例と問題が合っていないと、効果がはっきり落ちる。その数字は後で見る。
ゼロショットのプロンプトを試した研究もあったが、ほとんどはタスクごとにテンプレートを設計するもので、タスクが変わるたびに考え直す必要があった。
この論文が問うのは、タスクに依存しない一文があれば、例を一つも与えずに、モデルに多段階の推論を書かせられるか、ということだ。
問題を解く
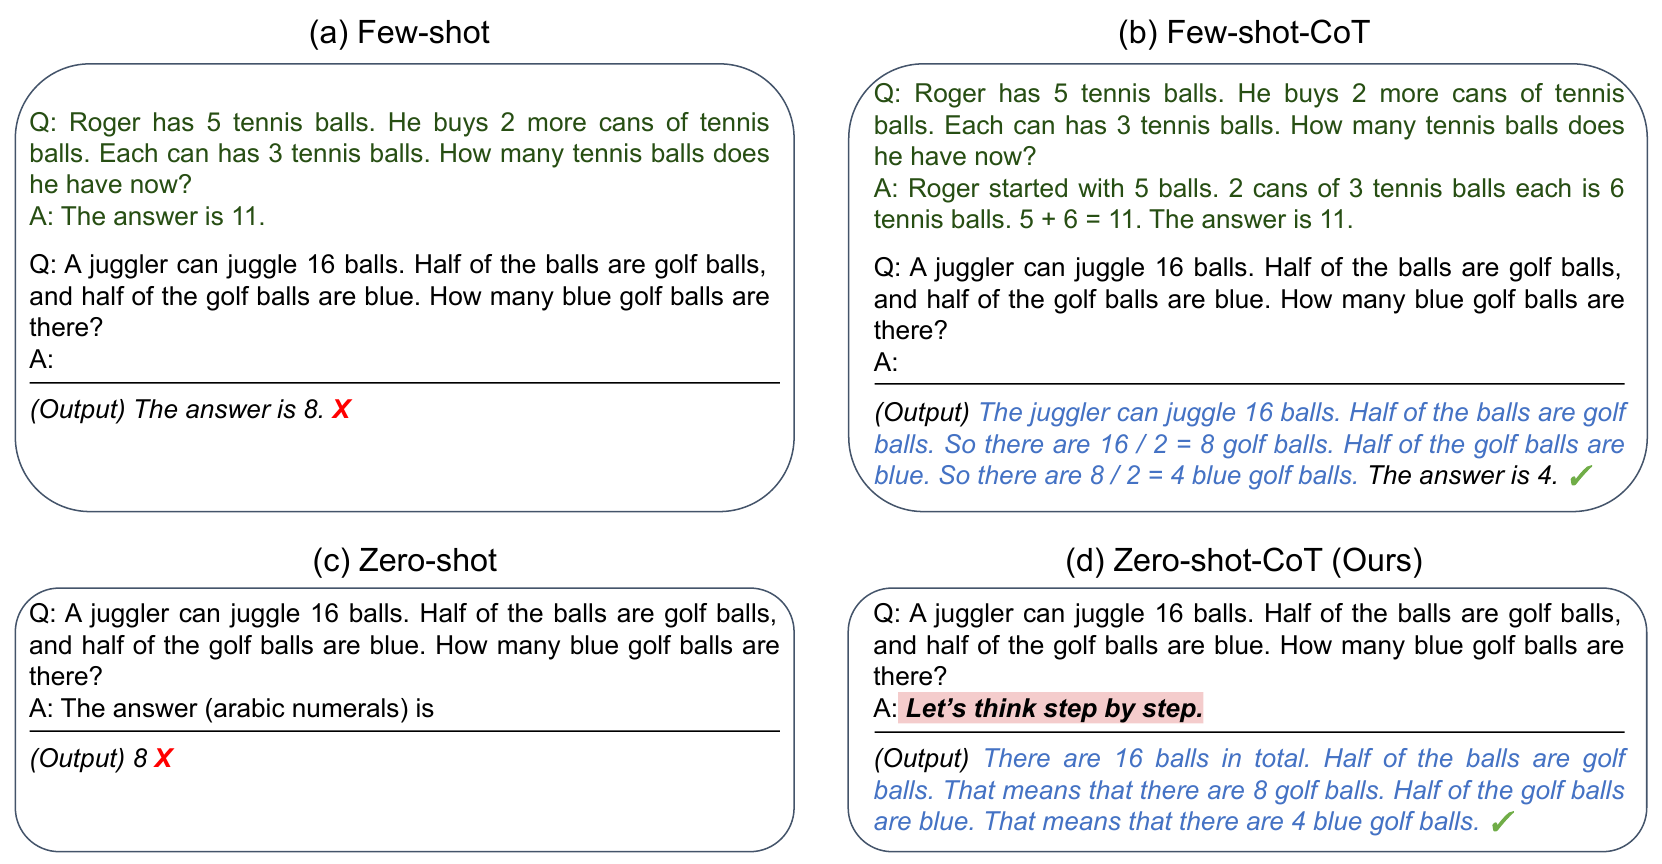
上の段が少数ショット、下の段がゼロショット。左は直接答え、右は先に推論を書く。右下がこの論文の手法で、例は一切要らず、どのタスクにも同じ一文を使う。
二段階のプロンプト
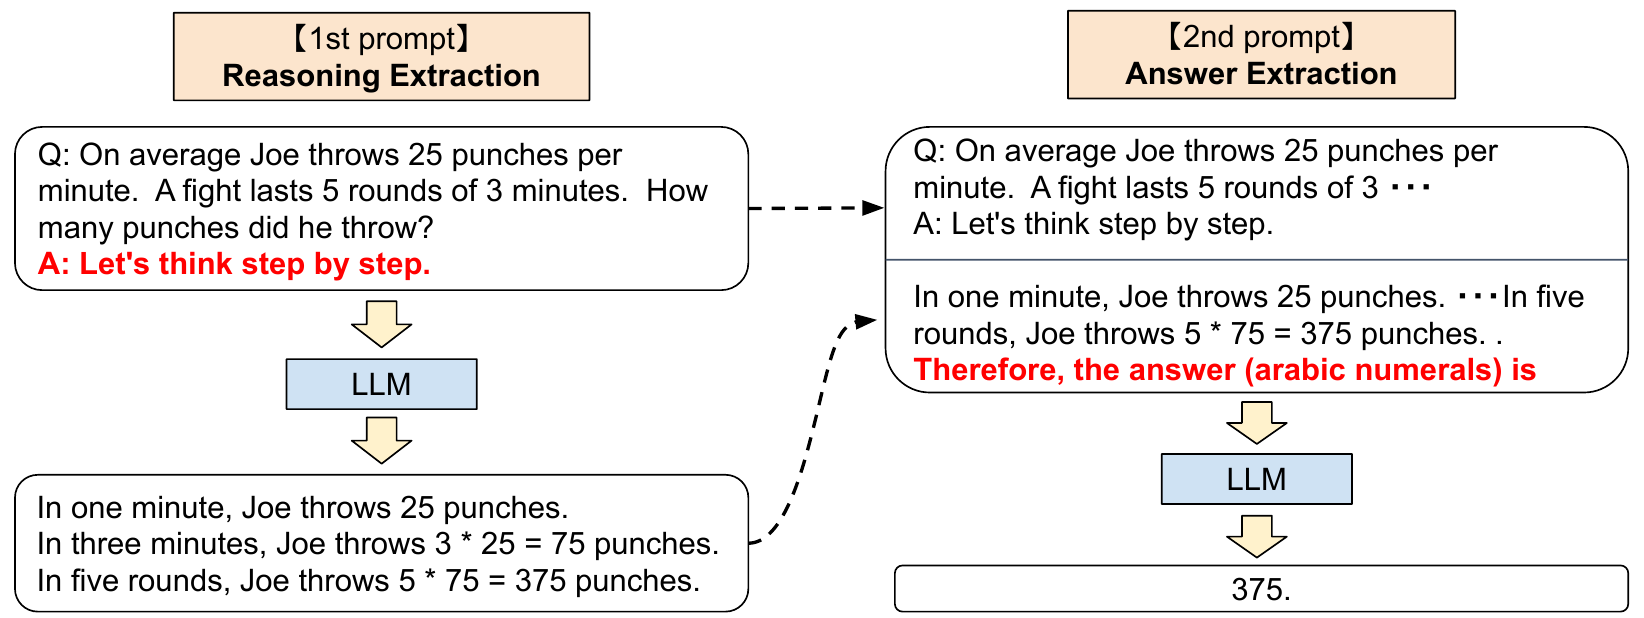
手法の説明は一文で済むが、実装ではモデルに二回問いかける。
- 推論を引き出す:問題を「Q: [問題]. A: Let's think step by step.」にはめ込み、モデルに続きを書かせて推論 を得る。全編を通して貪欲デコーディングを使う。
- 答えを引き出す:一段目のプロンプトと推論 に、答えのトリガー文を一つつなげて、同じモデルに戻す。数値の問題では「Therefore, the answer (arabic numerals) is」、選択問題では「Therefore, among A through E, the answer is」を使う。
二段目が必要なのは、「最後に The answer is X と書く」ことを示す例がないので、モデルが推論を書き終えても、素直に解析できる答えを出すとは限らないからだ。少数ショットのプロンプトではこのステップは要らない。例の答えの形式がすでにそれを教えているからだ。
モデルが答えを書いた後も、もう一度後処理が要る。数値の問題では最初に出てくる数字を、選択問題では最初に出てくる大文字を、はい・いいえで答える問題では最初の yes か no を取る。上の図のボクシングの問題では、モデルは二段目で「375.」と書き、後処理すると 375 になる。このルールはかなり大雑把で、モデルが一度に「B, C, and D」と書けば B しか取れない。文が Among で始まると、最初に拾われる大文字は Among の A だ。とはいえ、どの手法も同じルールを使うので、比較としてはまあ公平だ。
実験設定
- タスク:四種類、計 12 のデータセット。算術は SingleEq、AddSub、MultiArith、AQUA-RAT、GSM8K、SVAMP で、最初の二つはたいてい一ステップで計算が終わる。常識は CommonsenseQA と StrategyQA。記号推論は、四つの名前の末尾の文字の連結と、四回裏返すコイン。その他の論理推論は、BIG-bench の日付理解と、三つの物体の入れ替えの追跡。
- モデル:計 17 個で、0.3B から 540B まで。主に InstructGPT(text-ada/babbage/curie/davinci-001 と text-davinci-002)、オリジナルの GPT-3 の四つのサイズ、PaLM 8B/62B/540B を使い、規模の実験では GPT-2、GPT-Neo、GPT-J、T0、OPT も加えた。特に断りがなければ text-davinci-002 だ。
- 比較対象:ゼロショットのベースラインも、似たような答えのトリガー文を使う。少数ショットと少数ショットの思考の連鎖は Wei らの例を使い、算術問題では同じ 8 個の組だ。
議論
ゼロショットとの比較
| データセット | ゼロショット | ゼロショットの思考の連鎖 |
|---|---|---|
| SingleEq | 74.6 | 78.0 |
| AddSub | 72.2 | 69.6 |
| MultiArith | 17.7 | 78.7 |
| GSM8K | 10.4 | 40.7 |
| AQUA-RAT | 22.4 | 33.5 |
| SVAMP | 58.8 | 62.1 |
| CommonsenseQA | 68.8 | 64.6 |
| StrategyQA | 12.7 | 54.8 |
| 日付理解 | 49.3 | 67.5 |
| 物体の入れ替えの追跡 | 31.3 | 52.4 |
| 末尾の文字の連結 | 0.2 | 57.6 |
| コインの裏返し | 12.8 | 91.4 |
原論文 Table 1 をもとに整理。答えの形式に合わせて設計したトリガー文を使った結果で、単位は %。
多段階の推論が必要な問題では、どれも大きく伸びた。MultiArith は 61 ポイント増え、末尾の文字の連結はほぼ 0 から 57.6% に、コインの裏返しは 12.8% から 91.4% になった。SingleEq と AddSub はもともと多段の計算をあまり必要としないので、ほぼ変わらない。
CommonsenseQA はむしろ後退し、68.8% から 64.6% に下がった。著者らによると、思考の連鎖の論文でも似た現象があり、少数ショットの思考の連鎖は LaMDA 137B では常識問題に効かず、PaLM 540B になってようやく StrategyQA に効いた。
表には、もう一度よく見ておきたい数字が二つある。StrategyQA とコインの裏返しはどちらもはい・いいえで答える問題で、当てずっぽうでも 50% は取れるのに、ゼロショットのベースラインは 12% 前後しかない。元の表には「The answer is」で答えを取り出した結果も載っていて、こちらだと二つのゼロショットのベースラインは 54.3% と 53.8% に戻る。どうやら、ゼロショットのベースラインの低いスコアは、一部は答えが正しく取り出されなかったせいらしい。ゼロショットの思考の連鎖のほうは、二つの取り出し方の差がずっと小さい。
少数ショットとの比較
| 手法 | MultiArith | GSM8K |
|---|---|---|
| ゼロショット | 17.7 | 10.4 |
| 少数ショット(例 8 個) | 33.8 | 15.6 |
| ゼロショットの思考の連鎖 | 78.7 | 40.7 |
| 少数ショットの思考の連鎖(例 2 個) | 84.8 | 41.3 |
| 少数ショットの思考の連鎖(例 8 個) | 93.0 | 48.7 |
| 例 8 個の思考の連鎖で、答えの前にさらに「Let's think step by step.」を加える | 92.8 | 51.5 |
| 微調整した GPT-3 175B | - | 33 |
| 微調整した GPT-3 175B + 検証器 | - | 55 |
| PaLM 540B:ゼロショット | 25.5 | 12.5 |
| PaLM 540B:ゼロショットの思考の連鎖 | 66.1 | 43.0 |
| PaLM 540B:ゼロショットの思考の連鎖 + Self-Consistency | 89.0 | 70.1 |
| PaLM 540B:少数ショットの思考の連鎖 | - | 56.9 |
原論文 Table 2 をもとに整理し、一部の行を抜粋。モデルの記載がないものはすべて text-davinci-002 で、単位は %。
ゼロショットの思考の連鎖は、丁寧に書いた例を使う少数ショットの思考の連鎖にはもちろん及ばない。それでも例を 8 個入れた標準の少数ショットのプロンプトには勝ち、GSM8K では微調整した GPT-3 175B にも勝っている。言い換えると、少数ショットのプロンプトの 8 個の例がもたらす改善は、「まず一歩ずつ考えよう」の一文にはるかに及ばない。
この一文を少数ショットの思考の連鎖の例に加えると、GSM8K はさらに 48.7% から 51.5% に上がる。PaLM 540B に Self-Consistency のサンプリングと投票を加えれば、ゼロショットでも 70.1% に届く。
モデルは十分に大きくなければならない
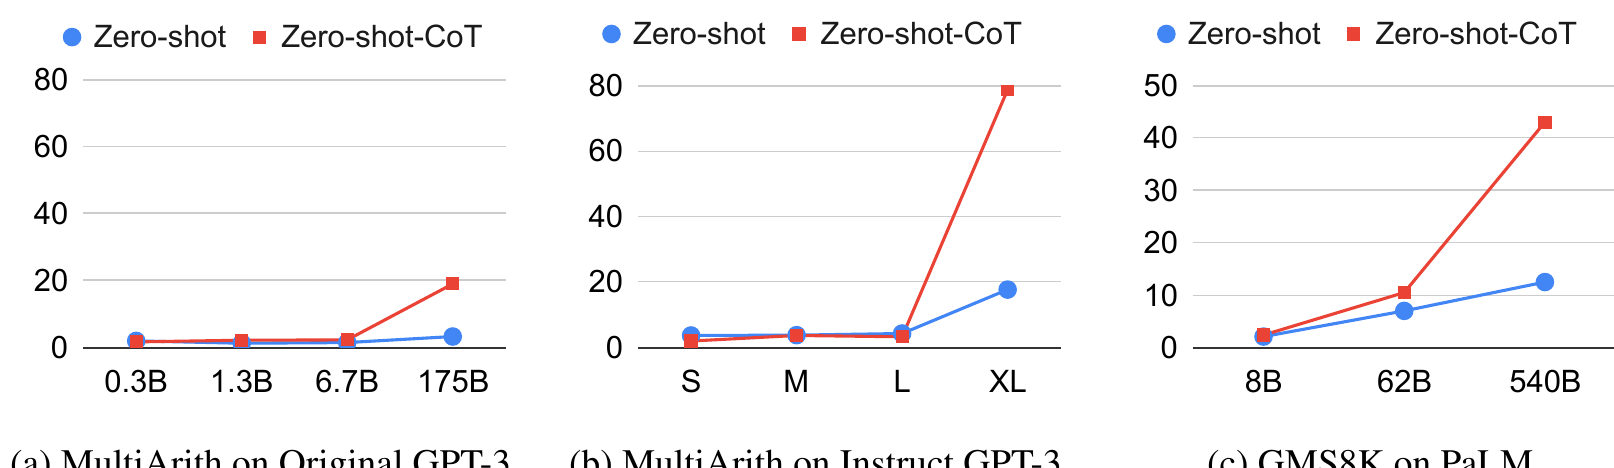
推論を書かないときは、モデルを大きくしてもスコアはほとんど動かない。この一文を加えると、スコアはモデルが大きくなるにつれて急に上がる。小さいモデルには効かず、書かれた推論の質も悪い。これは少数ショットの思考の連鎖の結果と一致していて、推論能力はある規模に達してはじめて現れ、この一文はそれを呼び出しているだけだ。
オリジナルの GPT-3 175B の改善は、指示チューニングを経た text-davinci-002 よりずっと小さい。著者らも議論の中で、各社のモデルの訓練データの詳細が公開されていないので、差がどこから来るのかは確かめられないと認めている。
別の一文ではだめか
| 種類 | トリガー文 | MultiArith |
|---|---|---|
| 推論を促す | Let's think step by step. | 78.7 |
| 推論を促す | First, | 77.3 |
| 推論を促す | Let's think about this logically. | 74.5 |
| 推論を促す | Let's solve this problem by splitting it into steps. | 72.2 |
| 推論を促す | Let's think like a detective step by step. | 70.3 |
| 推論を促す | Let's think | 57.5 |
| 推論を促す | The answer is after the proof. | 45.7 |
| ミスリード | Don't think. Just feel. | 18.8 |
| ミスリード | Let's think step by step but reach an incorrect answer. | 18.7 |
| ミスリード | By using the fact that the earth is round, | 9.3 |
| 無関係 | By the way, I found a good restaurant nearby. | 17.5 |
| 無関係 | Abrakadabra! | 15.5 |
| なし | (ゼロショット) | 17.7 |
原論文 Table 4 をもとに整理し、16 種類のトリガー文のうち 12 種類を抜粋。text-davinci-002、単位は %。
推論を促す文ならどれも効果があるが、差は小さくない。「Let's think」は「step by step」が欠けるだけで 78.7% から 57.5% に落ちる。ミスリードする文や無関係な文はどれもゼロショットの水準のあたりで、「By using the fact that the earth is round」に至っては 9.3% まで引き下げた。著者らは、トリガー文によってモデルが推論を書くやり方が大きく変わることも観察している。より良いトリガー文をどうやって自動で見つけるかは、著者らが未解決の問題として残した。
例と問題が合わない
| 手法 | AQUA-RAT | MultiArith |
|---|---|---|
| ゼロショット | 22.4 | 17.7 |
| 少数ショットの思考の連鎖、例は CommonsenseQA から | 31.9 | 27.0 |
| ゼロショットの思考の連鎖 | 33.5 | 78.7 |
| 少数ショットの思考の連鎖、例は同じタスクから | 39.0 | 88.2 |
原論文 Table 5 をもとに整理。単位は %。
常識問題の例を使って数学の問題を解かせてみる。AQUA-RAT と CommonsenseQA はどちらも選択問題で形式が同じなので、例にもいくらか効果がある。MultiArith は数値で答える必要があり、形式が違うので、例はほとんど役に立たない。これは Min らの観察と一致していて、モデルが例から学ぶのは、タスクそのものより、主に答えの形式だ。どちらの場合も、ゼロショットの思考の連鎖に負けている。
どこで間違えるか
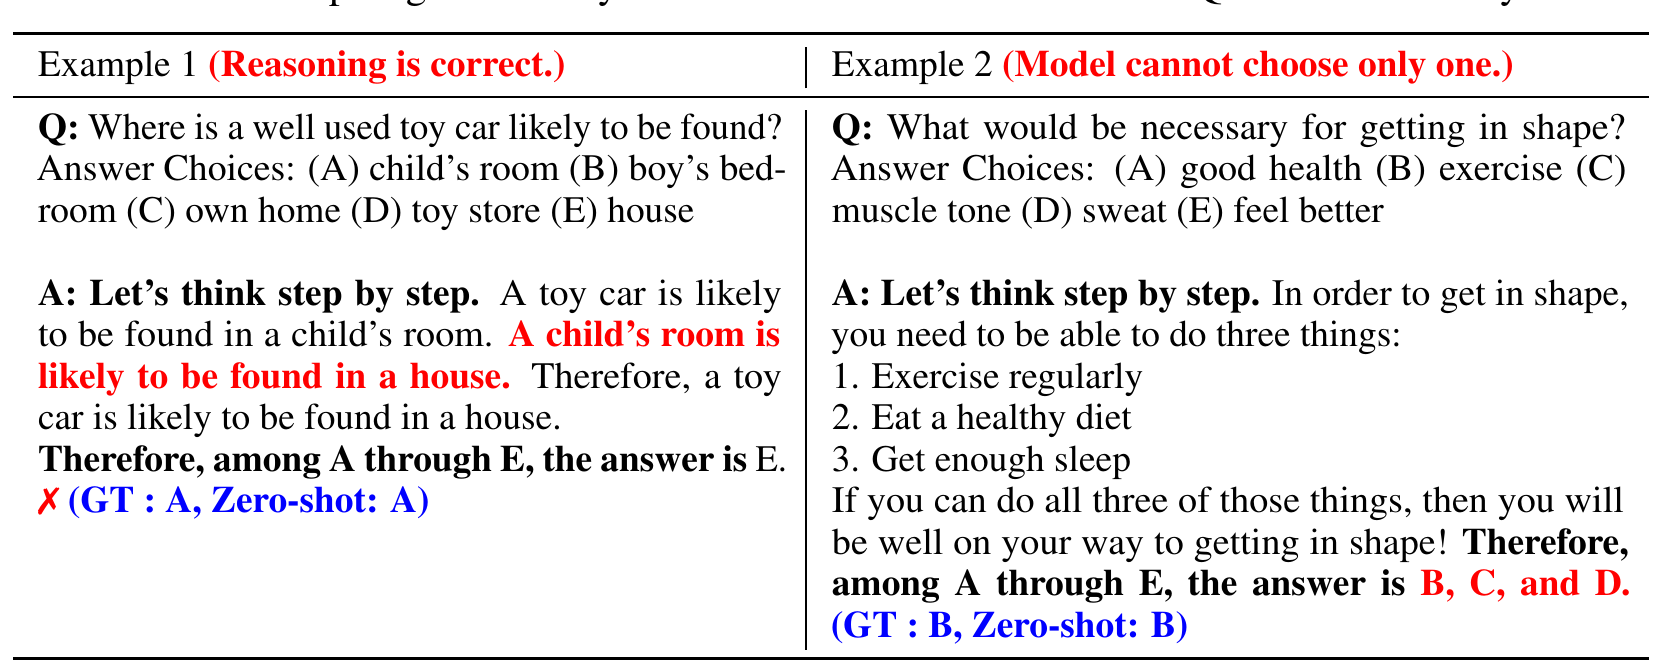
著者らは text-davinci-002 の出力を人手で確認した。
- 常識問題:推論はたいてい筋が通っていて、答えが正解と違うだけだ。たとえば例一の「おもちゃの車は家の中にある」は間違っていない。選択肢のどれかに絞りきれないときは、一度にいくつも選ぶこともある。
- 算術問題:ゼロショットの思考の連鎖は、正しい答えをすでに出しているのにさらに数ステップ書き足し、答えを間違ったものに変えてしまうことがよくある。推論を実際には始めず、問題を言い換えるだけのこともある。少数ショットの思考の連鎖は間違え方が違い、(3 + 2) * 4 のように一度に二つの演算をする式でよく間違える。
限界
著者らは二点を挙げている。
- 訓練データが不透明:GPT-3 系列の 001 と 002 の違いも、PaLM がどんなデータを使ったかも公開されていない。著者らの主張は、さまざまなモデルで、算術でも算術以外のタスクでも一貫して改善しているので、答えを丸暗記しているというより、一般的な推論能力だろう、というものだ。
- 偏り:プロンプトが利用するのはモデルがウェブのデータから学んだパターンなので、データの中の偏りもいっしょに引き出される。
また、結果の大部分は text-davinci-002 で貪欲デコーディングだけを使ったもので、主要な結果は PaLM でも再現されている。
その後
「Let's think step by step」はすぐに最もよく使われるゼロショットのプロンプトになり、著者らが残した未解決の問題も、すぐに引き継がれた。
2022 年 11 月、トロント大学の APE は、言語モデル自身に指示の候補を出させ、それを採点した。まず「Let's think step by step」で推論をひとそろい作り、間違えたものを捨て(このステップは STaR を参考にしている)、それから正しい推論を最もよく生み出す書き出しの一文を探して、「Let's work this out in a step by step way to be sure we have the right answer.」を見つけた。text-davinci-002 で、MultiArith は 78.7% から 82.0% に、GSM8K は 40.7% から 43.0% に上がった。
2023 年 9 月、Google DeepMind の OPRO は言語モデルを最適化器として使い、新しい文を出し、スコアを見て、書き直すことを繰り返した。PaLM 2-L に解かせたとき、最も良かった文は「Take a deep breath and work on this problem step-by-step.」で、GSM8K は 80.2%。「Let's think step by step」は 71.8%、APE が見つけた文は 58.8% にとどまった。最良の一文はモデルによって変わり、text-davinci-002 で見つけた最良の文も、PaLM 2-L に移すと後ろのほうに落ちる。
推論モデルの時代になると、話はまた一周した。モデルは答える前に、もともと長い推論を書く。OpenAI の推論モデル向けのプロンプトガイドには、思考の連鎖プロンプトは避けるようにとはっきり書かれている。これらのモデルは内部で推論するので、「think step by step」や「explain your reasoning」と頼むのは余計だ、というのがその理由だ。
結論
答えの前に「Let's think step by step」の一文を加えると、text-davinci-002 の MultiArith は 17.7% から 78.7% に、GSM8K は 10.4% から 40.7% になり、例を 8 個入れた標準の少数ショットのプロンプトにも勝った。この論文の最も重みのある点はここにある。推論能力はもともとモデルの中にあり、少数ショットの例が提供していたもののかなりの部分は、形式にすぎなかった。
ただ、かなりえり好みもする。モデルは十分に大きくなければならず、常識問題には効かない。トリガー文が数語違うだけでスコアが 20 ポイントも変わり、モデルを替えれば最良の一文も変わる。
その後の展開は少し皮肉だ。みんな一年以上かけて、アルゴリズムでこの一文のより良い言い方を探した。そこへ推論モデルが「先に考えてから答える」を重みに直接叩き込み、プロンプトガイドは逆に、もう念を押さないでくれと頼むようになった。