原始論文
Large Language Models are Zero-Shot Reasoners
- 發表版本
- NeurIPS 2022會議
- arXiv 首次提交
- arXiv:2205.11916
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{transformerszeroshotcot2022,
  title = {{Large Language Models are Zero-Shot Reasoners}},
  author = {Takeshi Kojima and Shixiang Shane Gu and Machel Reid and Yutaka Matsuo and Yusuke Iwasawa},
  year = {2022},
  eprint = {2205.11916},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2205.11916}
}
GPT-3 的論文標題是「Language Models are Few-Shot Learners」。從那之後,大家講到大型語言模型的厲害之處,第一個想到的就是少樣本學習:在提示裡放幾個範例,模型就學會新任務。
2022 年 1 月的思維鏈提示也是這個路線。在範例的答案裡寫出推理步驟,模型照樣寫,數學題就大幅進步。那篇論文甚至沒有報告零樣本的成績,彷彿不給範例根本不用比。
四個月後,東京大學的 Kojima 和 Google 的 Shane Gu 等人發現,範例可以全部拿掉。只要在答案前面加一句「Let's think step by step」,text-davinci-002 在 MultiArith 上就從 17.7% 升到 78.7%,GSM8K 從 10.4% 升到 40.7%。
定義問題
少樣本思維鏈有兩個麻煩。範例要人一個任務一個任務手寫,推理步驟要寫得好,答案的格式也要統一;而且範例和題目不搭的時候,效果會明顯變差,後面會看到數字。
零樣本的提示也不是沒有人做,但大多是替每個任務各自設計模板,換一個任務就要重新想。
這篇想問的是,有沒有一句和任務無關的話,不給任何範例,就能讓模型寫出多步驟的推理?
解決問題
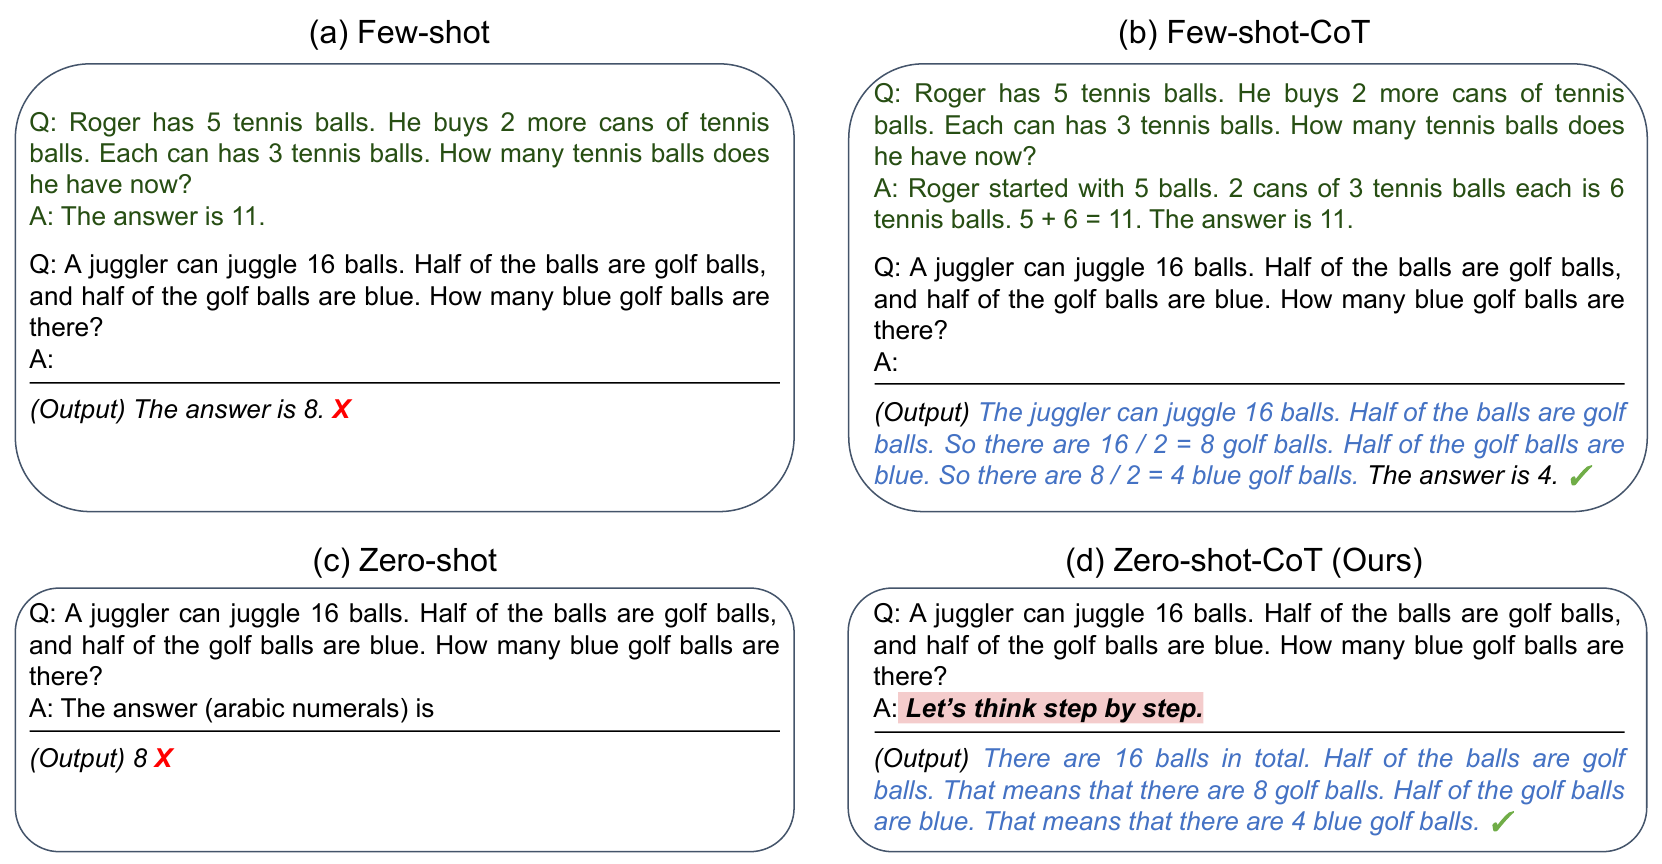
上排是少樣本,下排是零樣本;左邊直接回答,右邊先寫推理。右下角就是這篇的方法,不需要任何範例,每個任務都用同一句話。
兩段式提示
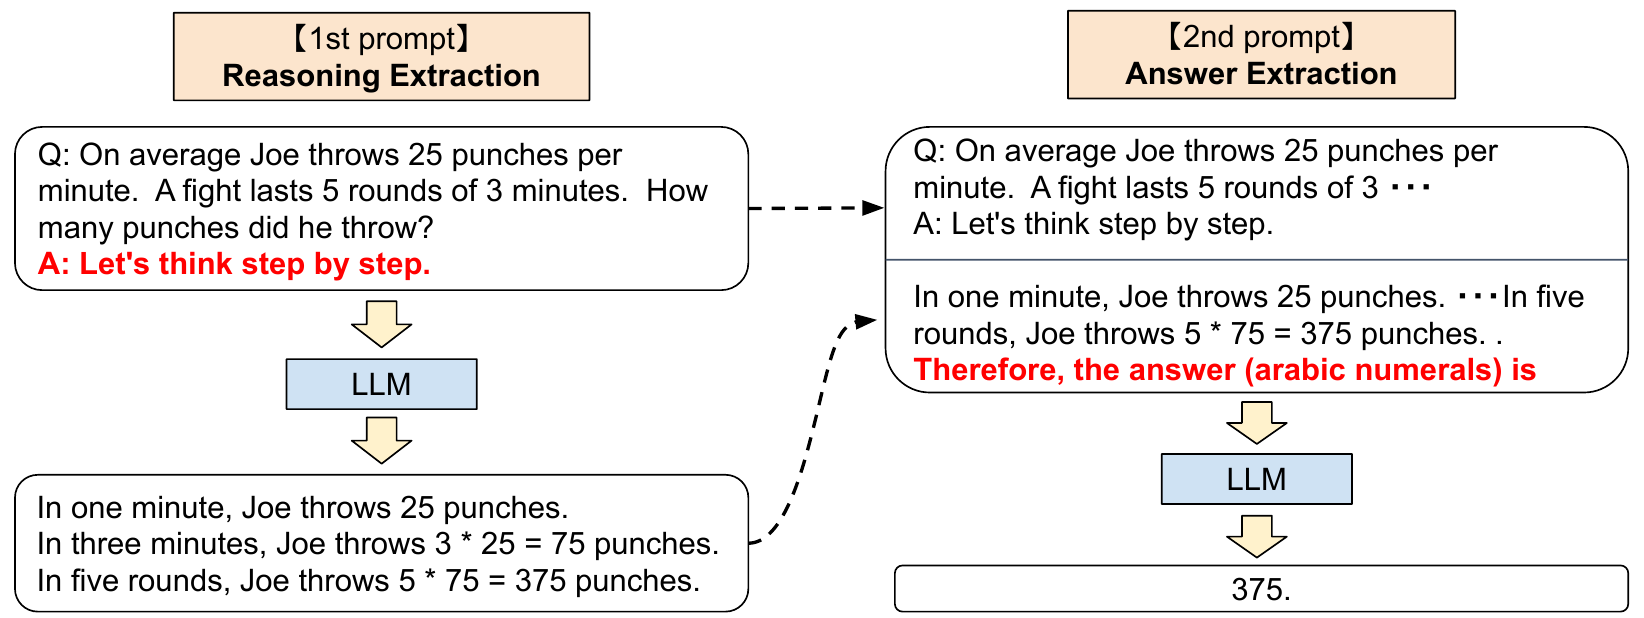
方法說起來只有一句話,實作上要問模型兩次:
- 抽出推理:把題目套進「Q: [題目]. A: Let's think step by step.」,讓模型接著寫,得到推理 。全篇都用貪婪解碼。
- 抽出答案:把第一段的提示、推理 ,再接上一句答案觸發語,送回同一個模型。數字題用「Therefore, the answer (arabic numerals) is」,選擇題用「Therefore, among A through E, the answer is」。
需要第二段,是因為沒有範例示範「最後要寫 The answer is X」,模型寫完推理不一定會乖乖給出可解析的答案。少樣本提示不用這一步,範例的答案格式已經教過了。
模型講完答案,還要再清理一次。數字題取第一個出現的數字,選擇題取第一個出現的大寫字母,是非題取第一個 yes 或 no。上圖的拳擊題,模型在第二段寫出「375.」,清理後得到 375。這套規則很粗糙,模型若一次寫出「B, C, and D」,只會取到 B;句子以 Among 開頭時,抓到的第一個大寫字母是 Among 的 A。不過所有方法都用同一套規則,比較起來還算公平。
實驗設定
- 任務:四類共 12 個資料集。算術有 SingleEq、AddSub、MultiArith、AQUA-RAT、GSM8K、SVAMP,前兩個多半一步就能算完;常識有 CommonsenseQA、StrategyQA;符號推理有四個名字的末字母串接、翻四次的硬幣;其他邏輯推理有 BIG-bench 的日期理解和三個物件的交換追蹤。
- 模型:共 17 個,從 0.3B 到 540B。主要用 InstructGPT(text-ada/babbage/curie/davinci-001 和 text-davinci-002)、原始 GPT-3 四種大小、PaLM 8B/62B/540B;規模實驗另外加了 GPT-2、GPT-Neo、GPT-J、T0、OPT。沒有特別說明時都是 text-davinci-002。
- 對照:零樣本基準也用類似的答案觸發語;少樣本和少樣本思維鏈用 Wei 等人的範例,算術題是同一組 8 個。
討論
和零樣本比
| 資料集 | 零樣本 | 零樣本思維鏈 |
|---|---|---|
| SingleEq | 74.6 | 78.0 |
| AddSub | 72.2 | 69.6 |
| MultiArith | 17.7 | 78.7 |
| GSM8K | 10.4 | 40.7 |
| AQUA-RAT | 22.4 | 33.5 |
| SVAMP | 58.8 | 62.1 |
| CommonsenseQA | 68.8 | 64.6 |
| StrategyQA | 12.7 | 54.8 |
| 日期理解 | 49.3 | 67.5 |
| 物件交換追蹤 | 31.3 | 52.4 |
| 末字母串接 | 0.2 | 57.6 |
| 翻硬幣 | 12.8 | 91.4 |
整理自原論文 Table 1,使用依答案格式設計的觸發語;單位為 %。
需要多步驟推理的題目,進步都很大:MultiArith 多了 61 個百分點,末字母串接從幾乎是 0 到 57.6%,翻硬幣從 12.8% 到 91.4%。SingleEq 和 AddSub 本來就不太需要多步計算,差不多。
CommonsenseQA 反而退步,從 68.8% 降到 64.6%。作者提到思維鏈論文也有類似的現象,少樣本思維鏈在 LaMDA 137B 上對常識題沒有幫助,要到 PaLM 540B 才對 StrategyQA 有效。
表裡有兩個數字值得多看一眼。StrategyQA 和翻硬幣都是是非題,亂猜也有 50%,零樣本基準卻只有 12% 左右。原表另外報告了改用「The answer is」抽答案的結果,這兩個零樣本基準就回到 54.3% 和 53.8%。看起來,零樣本基準的低分有一部分出在答案沒被正確抽出來;零樣本思維鏈兩種抽法的差距則小得多。
和少樣本比
| 方法 | MultiArith | GSM8K |
|---|---|---|
| 零樣本 | 17.7 | 10.4 |
| 少樣本(8 個範例) | 33.8 | 15.6 |
| 零樣本思維鏈 | 78.7 | 40.7 |
| 少樣本思維鏈(2 個範例) | 84.8 | 41.3 |
| 少樣本思維鏈(8 個範例) | 93.0 | 48.7 |
| 8 個範例的思維鏈,答案前再加「Let's think step by step.」 | 92.8 | 51.5 |
| 微調 GPT-3 175B | - | 33 |
| 微調 GPT-3 175B + 驗證器 | - | 55 |
| PaLM 540B:零樣本 | 25.5 | 12.5 |
| PaLM 540B:零樣本思維鏈 | 66.1 | 43.0 |
| PaLM 540B:零樣本思維鏈 + Self-Consistency | 89.0 | 70.1 |
| PaLM 540B:少樣本思維鏈 | - | 56.9 |
整理自原論文 Table 2,節錄部分列;沒有標明模型的都是 text-davinci-002,單位為 %。
零樣本思維鏈當然比不上精心寫好範例的少樣本思維鏈,但它贏過放了 8 個範例的標準少樣本提示,而且在 GSM8K 上贏過微調的 GPT-3 175B。換句話說,少樣本提示那 8 個範例帶來的提升,遠不如一句「先一步一步想」。
把這句話加進少樣本思維鏈的範例裡,GSM8K 還能從 48.7% 再升到 51.5%。PaLM 540B 加上 Self-Consistency 取樣投票,零樣本也能到 70.1%。
模型要夠大
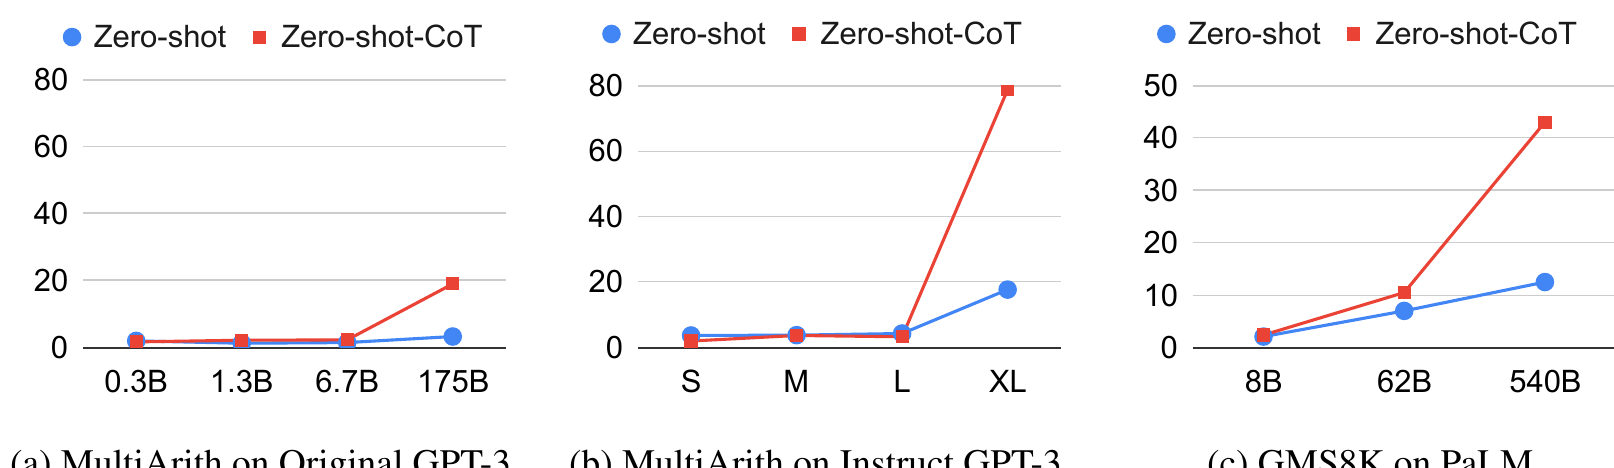
不寫推理時,模型變大,分數幾乎不動;加上這句話之後,分數隨模型變大急速上升。小模型則沒有用,寫出來的推理品質也差。這和少樣本思維鏈的結果一致,推理能力要到一定規模才出現,這句話只是把它叫出來。
原始 GPT-3 175B 的提升遠小於做過指令微調的 text-davinci-002,作者在討論裡也承認,各家模型的訓練資料細節都不公開,無法確定差異從哪裡來。
換一句話行不行
| 類型 | 觸發語 | MultiArith |
|---|---|---|
| 引導推理 | Let's think step by step. | 78.7 |
| 引導推理 | First, | 77.3 |
| 引導推理 | Let's think about this logically. | 74.5 |
| 引導推理 | Let's solve this problem by splitting it into steps. | 72.2 |
| 引導推理 | Let's think like a detective step by step. | 70.3 |
| 引導推理 | Let's think | 57.5 |
| 引導推理 | The answer is after the proof. | 45.7 |
| 誤導 | Don't think. Just feel. | 18.8 |
| 誤導 | Let's think step by step but reach an incorrect answer. | 18.7 |
| 誤導 | By using the fact that the earth is round, | 9.3 |
| 無關 | By the way, I found a good restaurant nearby. | 17.5 |
| 無關 | Abrakadabra! | 15.5 |
| 不加 | (零樣本) | 17.7 |
整理自原論文 Table 4,節錄 16 種觸發語中的 12 種;text-davinci-002,單位為 %。
只要是引導模型推理的句子都有用,但差距不小。「Let's think」少了「step by step」就從 78.7% 掉到 57.5%。誤導和無關的句子都在零樣本的水準附近,「By using the fact that the earth is round」甚至拉低到 9.3%。作者也觀察到,不同的觸發語會讓模型用很不一樣的方式寫推理。至於怎麼自動找出更好的觸發語,作者留成了開放問題。
範例和題目不搭
| 方法 | AQUA-RAT | MultiArith |
|---|---|---|
| 零樣本 | 22.4 | 17.7 |
| 少樣本思維鏈,範例取自 CommonsenseQA | 31.9 | 27.0 |
| 零樣本思維鏈 | 33.5 | 78.7 |
| 少樣本思維鏈,範例取自同一個任務 | 39.0 | 88.2 |
整理自原論文 Table 5;單位為 %。
拿常識題的範例去做數學題。AQUA-RAT 和 CommonsenseQA 都是選擇題,格式相同,範例還有一點幫助;MultiArith 要的是數字答案,格式不同,範例幾乎沒用。這和 Min 等人的觀察一致,模型從範例裡學到的多半是答案的格式,而不是任務本身。兩種情況都輸給零樣本思維鏈。
錯在哪裡
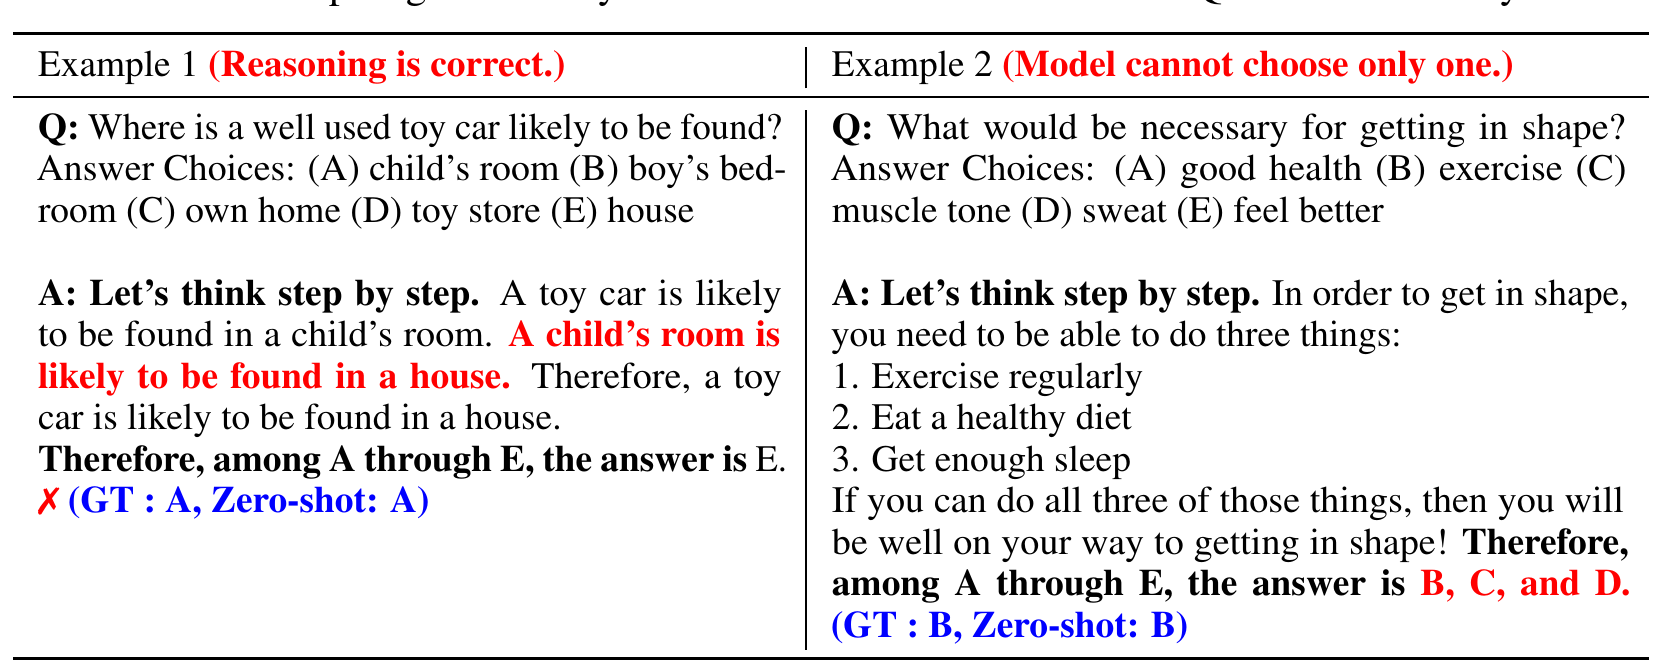
作者人工檢查了 text-davinci-002 的輸出:
- 常識題:推理常常合理,只是答案和標準答案不同,例如例一的「玩具車在房子裡」並沒有錯。模型無法在幾個選項中取捨時,也會一次選好幾個。
- 算術題:零樣本思維鏈常常已經算出正確答案,又繼續多寫幾步,把答案改錯;有時則沒有真的開始推理,只是把題目換句話說一遍。少樣本思維鏈的錯法不同,常在 (3 + 2) * 4 這種一次做兩步運算的式子出錯。
限制
作者提了兩點:
- 訓練資料不透明:GPT-3 系列 001 和 002 的差別、PaLM 用了什麼資料,都沒有公開。作者的論點是,各種模型、算術和非算術任務都一致進步,比較不像是背答案,而是一般性的推理能力。
- 偏誤:提示利用的是模型從網路資料學到的模式,資料裡的偏誤也會一起帶出來。
另外,大部分的結果都在 text-davinci-002 上,只用貪婪解碼;關鍵結果在 PaLM 上重現過。
後來的事
「Let's think step by step」很快變成最常見的零樣本提示,作者留下的開放問題,也很快有人接手。
2022 年 11 月,多倫多大學的 APE 讓語言模型自己提出候選指令再評分。他們先用「Let's think step by step」產生一批推理,丟掉答錯的(這一步參考了 STaR),再搜尋最能產生這些正確推理的開頭句,找到「Let's work this out in a step by step way to be sure we have the right answer.」。在 text-davinci-002 上,MultiArith 從 78.7% 升到 82.0%,GSM8K 從 40.7% 升到 43.0%。
2023 年 9 月,Google DeepMind 的 OPRO 把語言模型當成最佳化器,反覆提出新句子、看分數、再改寫。以 PaLM 2-L 作答時,最好的句子是「Take a deep breath and work on this problem step-by-step.」,GSM8K 80.2%;「Let's think step by step」是 71.8%,APE 找到的那句只剩 58.8%。最好的那句話會隨模型改變,在 text-davinci-002 上找到的最佳句子,換到 PaLM 2-L 就落到後面。
到了推理模型,事情又繞了一圈。模型在回答前本來就會寫很長的推理,OpenAI 給推理模型的提示指南直接寫著,避免使用思維鏈提示,因為這些模型會在內部推理,請它「think step by step」或「explain your reasoning」是多餘的。
結論
在答案前加一句「Let's think step by step」,text-davinci-002 的 MultiArith 從 17.7% 到 78.7%,GSM8K 從 10.4% 到 40.7%,還贏過放了 8 個範例的標準少樣本提示。這篇最有分量的地方在這裡,推理能力原本就在模型裡,少樣本範例提供的有很大一部分只是格式。
但它也很挑。模型要夠大,常識題沒有幫助;觸發語差幾個字,分數就差 20 個百分點,換一個模型,最好的句子也跟著換。
後來的發展有點諷刺。大家花了一年多,用演算法替這句話找更好的說法;接著推理模型把「先想再答」直接練進權重,提示指南反過來請你別再提醒它了。