原始論文
Tree of Thoughts: Deliberate Problem Solving with Large Language Models
- 發表版本
- NeurIPS 2023會議
- arXiv 首次提交
- arXiv:2305.10601
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{transformerstreeofthoughts2023,
  title = {{Tree of Thoughts: Deliberate Problem Solving with Large Language Models}},
  author = {Shunyu Yao and Dian Yu and Jeffrey Zhao and Izhak Shafran and Thomas L. Griffiths and Yuan Cao and Karthik Narasimhan},
  year = {2023},
  eprint = {2305.10601},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.10601}
}
語言模型產生文字的方式,從 GPT 到 GPT-4 都沒變過:從左到右,一個 token 接一個 token,寫下去就不能回頭。
思維鏈讓模型先寫推理步驟,但仍然是一條路走到底;Self-Consistency 多走幾條,最後投票,可是每一條也都是一口氣寫完,中途不會停下來比較「這一步這樣走好,還是那樣走好」。如果第一步就走錯,後面寫得再漂亮也沒用。
Princeton 的 Yao 等人和 Google DeepMind 合作,從人工智慧最早的研究裡找靈感。1950 年代,Newell 和 Simon 把人解決問題描述成在一棵樹上搜尋:每個節點是一個部分的解,每條分支是一種可能的下一步,靠經驗法則決定往哪裡走,走不通就退回來。這篇讓語言模型也這樣做。
定義問題
作者把當時的做法統一寫成幾種形式。輸入 ,輸出 ,語言模型是 :
- 輸入輸出提示(IO):直接產生答案,。
- 思維鏈(CoT):在輸入和輸出之間插入一串想法 ,每個想法是一段有意義的文字,例如一行算式。實際上整串是一口氣寫出來的。
- 思維鏈加 Self-Consistency(CoT-SC):獨立取樣 條思維鏈,選出現最多次的答案。
從「在樹上搜尋」的角度看,這些做法缺了兩樣東西。局部上,不會在同一步探索不同的寫法;全域上,沒有任何規劃、往前看或回溯。
解決問題
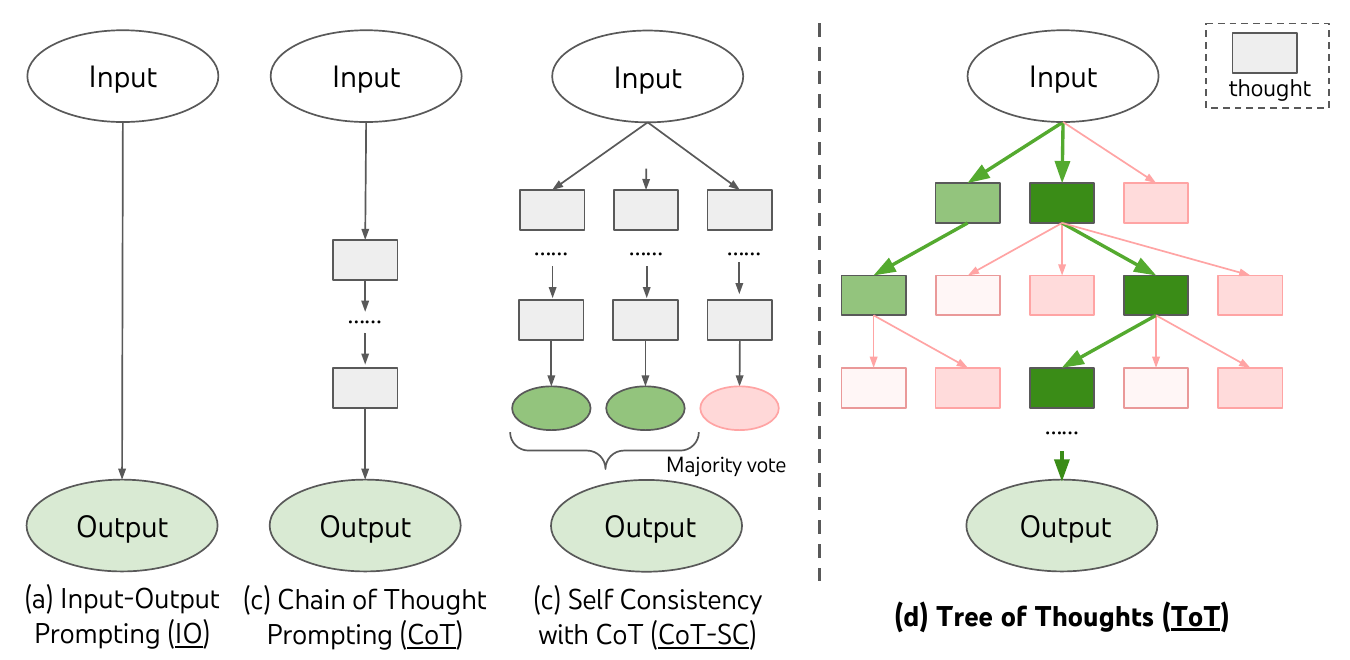
Tree of Thoughts(ToT)把問題看成在一棵樹上搜尋。每個節點是一個狀態 ,也就是輸入加上到目前為止的想法。要把它用在某個問題上,得回答四個問題。
一、想法要切多大
想法要夠小,模型才能產生多樣、有希望的候選;也要夠大,模型才能判斷它有沒有前途。一個 token 太小,無從評估;一整本書太大,寫不出連貫的東西。
依問題不同,作者的切法也不同:24 點遊戲裡,一個想法是一行算式;創意寫作裡,是一段寫作大綱;填字遊戲裡,是填進某個提示的一個單字。
二、怎麼產生下一個想法
- 獨立取樣:用思維鏈的提示,獨立取樣 次。適合想法空間很大的情況,例如一整段大綱,各自取樣自然就有多樣性。
- 一次提出:用一個「提議提示」,讓模型在同一次輸出裡列出 個候選。適合想法空間很受限的情況,例如一行算式或一個單字,放在同一段裡列出來可以避免重複。
三、怎麼評估狀態
這是 ToT 和一般搜尋演算法最不同的地方。傳統搜尋的經驗法則不是寫死的規則(例如 Deep Blue),就是訓練出來的模型(例如 AlphaGo)。ToT 用第三種方式,讓語言模型自己用文字推理,判斷一個狀態有沒有前途。
- 個別打分:對每個狀態,請模型給一個分數,或分成「一定可以 / 可能 / 不可能」。判斷的依據可以是往前試幾步,例如 5、5、14 很快就能湊出 5 + 5 + 14 = 24;也可以是常識,例如 1、2、3 太小,怎麼算都到不了 24。
- 互相比較:當成敗很難直接打分,例如一段文字是否連貫,就把幾個候選放在一起,請模型投票選出最有希望的那個。這有點像在每一步做一次 Self-Consistency。
評估不必完美,只要大致上能幫助決策就好。也可以多問幾次取平均,用成本換取更可靠的判斷。
四、用什麼搜尋
- 廣度優先(BFS):每一步只保留最有希望的 個狀態。用在樹不深(最多 3 步)的 24 點和創意寫作。
- 深度優先(DFS):先往最有希望的方向一路走到底;如果評估認為從這個狀態不可能解出來,就剪掉整棵子樹,退回上一層換下一個候選。用在要填 10 個字的填字遊戲。
從這個角度看,IO、CoT、CoT-SC 都是 ToT 的特例,只是樹的深度和寬度受到限制。整個框架不需要任何訓練,現成的語言模型就能用。
討論
三個實驗都用 GPT-4 的對話模式,溫度 0.7,在 2023 年 5 月 5 日到 16 日之間跑完。三個任務都是作者特地挑的,即使是 GPT-4 用 IO 或 CoT 也做不好。
24 點
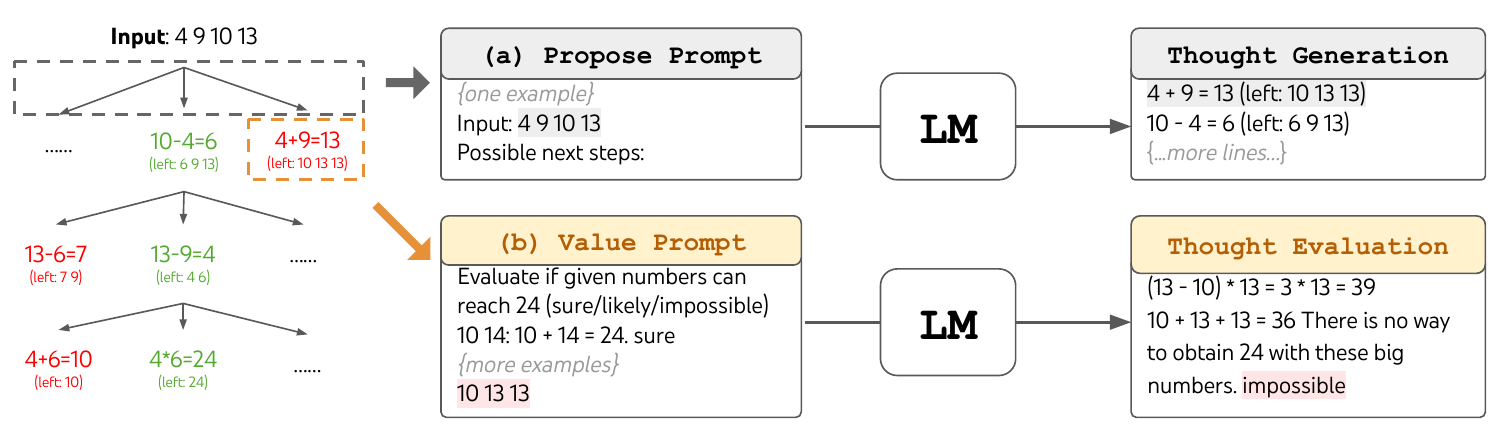
24 點是用四個數字和加減乘除湊出 24。作者從 4nums.com 抓了 1,362 題,網站依照人類解題時間由易到難排序,測試用第 901 到 1,000 題這 100 題比較難的。
用 ToT 解,很自然地分成 3 步,每步一行算式。每個節點把剩下的數字交給提議提示,列出可能的下一步;每個候選再交給評估提示,判斷 sure、maybe 或 impossible,各問 3 次。廣度優先搜尋,每步保留最好的 5 個。
| 方法 | 成功率 |
|---|---|
| IO 提示 | 7.3% |
| CoT 提示 | 4.0% |
| CoT-SC(100 次多數決) | 9.0% |
| ToT() | 45% |
| ToT() | 74% |
| IO + 反覆修正(最多 10 輪) | 27% |
| IO(100 次取最好) | 33% |
| CoT(100 次取最好) | 49% |
整理自原論文 Table 2。
CoT 只有 4.0%,比直接作答還低;投票也只到 9.0%。ToT 只保留 1 個候選就到 45%,保留 5 個到 74%。
表格下半部是幾種比較寬鬆的對照。「反覆修正」每次答錯就請模型反省再試,但用了算式對不對的標準答案當回饋。「100 次取最好」只要 100 次裡有一次對就算成功,實際用的時候不可能知道哪一次對,算是上限。即使是這樣的上限,CoT 也只有 49%,仍然低於 ToT。
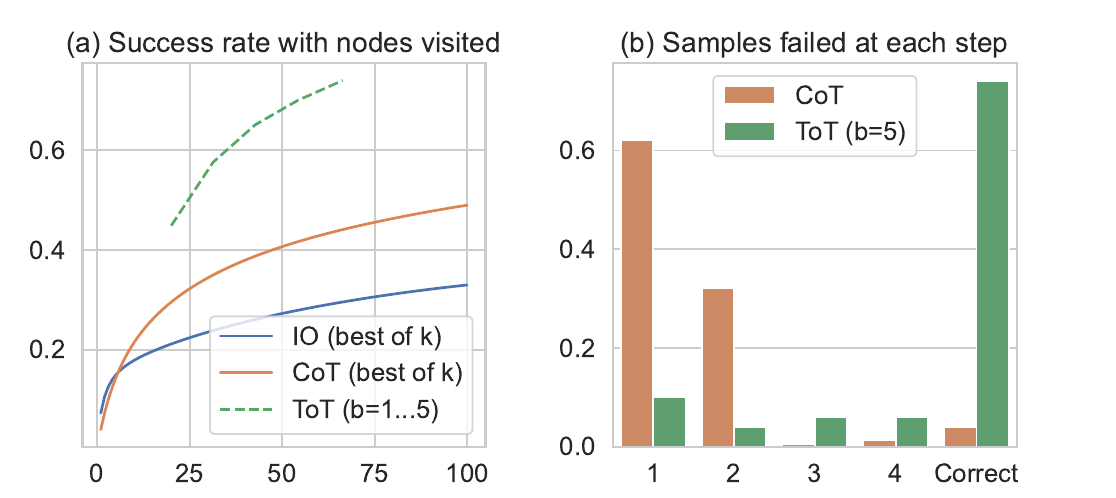
右圖最值得看。大約六成的 CoT 樣本在寫完第一步,也就是前三個字(例如「4 + 9」)的時候,就已經注定湊不出 24 了。
第一步為什麼這麼關鍵?以 4 9 10 13 為例,挑兩個數做一次四則運算,第一步共有 36 種走法,其中只有 7 種還湊得出 24,例如 10 − 4、9 + 10 和 13 − 9。隨便選一步,八成就走進了死路。從左到右寫下去的 CoT 沒辦法回頭,第一步錯了就全盤皆輸。
不做任何判斷、單純深度優先地一路試下去,走到底湊不出來就退回上一層,也找得到答案,例如 4 − 10 = −6、9 − 13 = −4、(−6) × (−4) = 24,只是要走過上千個狀態。程式可以暴力窮舉,語言模型每走一步都要花一次 API 呼叫,走不起。ToT 的評估提示扮演的就是剪枝的角色,先把「10 13 13 怎麼算都太大」這種狀態剪掉,只在少數有希望的分支上展開。
代價還是很可觀。ToT 解一題 24 點平均要產生 5,500 個 token,接近取樣 100 次 CoT 的 6,700 個,每題成本約 0.74 美元,CoT 取樣 100 次約 0.47 美元。花差不多的 token,ToT 的成功率是 74%,CoT 取 100 次最好的是 49%。
作者也用 GPT-3.5 試過,ToT 只有 19%。交叉測試裡,GPT-4 產生想法、GPT-3.5 評估,是 64%;GPT-3.5 產生、GPT-4 評估,只有 31%。這個遊戲的瓶頸在產生好的候選,而不是評估。
創意寫作
給 4 個隨機句子,要寫出 4 段文字,每段分別以這 4 句結尾。這個任務沒有標準答案,作者用兩種方式評估連貫性:請 GPT-4 打 1 到 10 分,取 5 次平均;以及由部分作者在不知道哪篇是誰寫的情況下,兩兩比較 CoT 和 ToT 的文章。
ToT 只有兩層:先產生 5 份寫作大綱,投票 5 次選出最好的一份;再依這份大綱寫 5 篇文章,同樣投票選出一篇。
| 方法 | GPT-4 評分 |
|---|---|
| IO | 6.19 |
| CoT(先寫大綱再寫文章) | 6.93 |
| ToT | 7.56 |
| IO + 反覆修正 | 7.67 |
| ToT + 反覆修正 | 7.91 |
整理自原論文 4.2 節;分數是 100 題的平均。
人工比較的結果一致,100 組裡有 41 組認為 ToT 比較連貫,21 組認為 CoT 比較好,其餘 38 組差不多。在這個任務上,反覆修正很有效,作者把它看成產生想法的第三種方式:從舊的想法修改出新的想法。
迷你填字遊戲
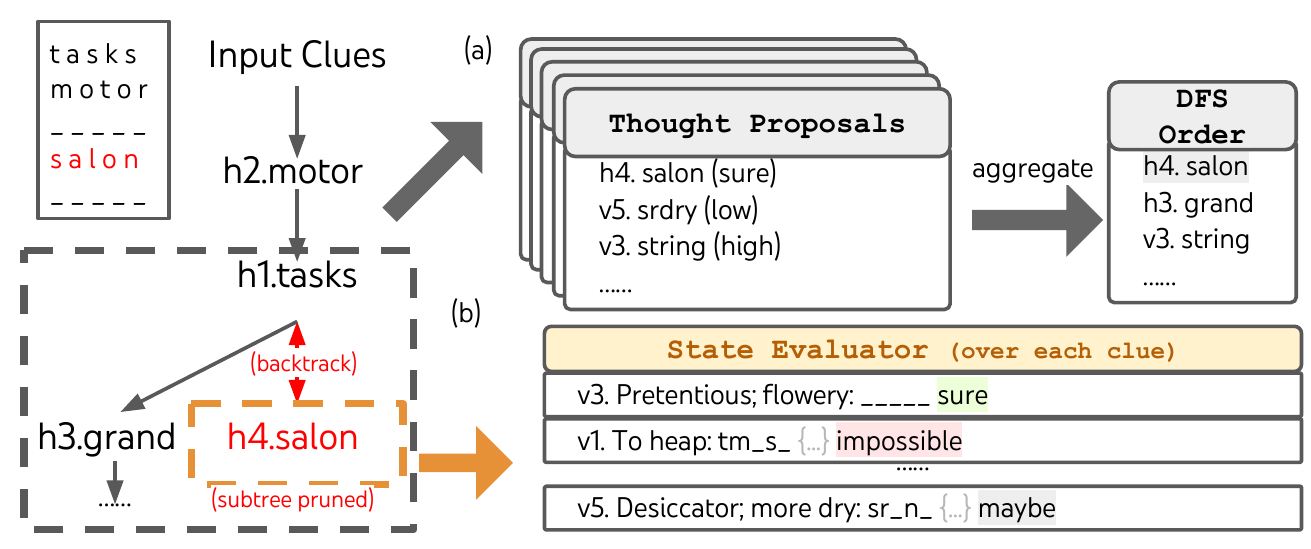
前兩個任務的樹都很淺,最多 3 步。填字遊戲要填 10 個字(5 橫 5 直),而且互相牽制,是比較難的搜尋問題。作者從 GooBix 抓了 156 題,取 20 題測試。
這裡用深度優先搜尋。每個狀態把已經填好的字轉成剩下提示的字母限制,請模型提出 5 次候選,並為每個候選給出信心,彙整成優先順序。評估時逐一檢查剩下的每個提示,只要有一個被判為不可能填,就剪掉整棵子樹、退回上一層。最多走 100 步,最後輸出走得最深的那個狀態。
| 方法 | 字母 | 單字 | 整題 |
|---|---|---|---|
| IO | 38.7 | 14 | 0 |
| CoT | 40.6 | 15.6 | 1 |
| ToT | 78 | 60 | 20 |
| ToT,輸出最好的狀態 | 82.4 | 67.5 | 35 |
| ToT,不剪枝 | 65.4 | 41.5 | 5 |
| ToT,不回溯 | 54.6 | 20 | 5 |
整理自原論文 Table 3;單位為 %,整題是 20 題裡完全解出的比例。
IO 和 CoT 的單字正確率都不到 16%,ToT 到 60%,20 題裡完全解出 4 題。
後面三列是消融。如果每題直接輸出搜尋過程中最好的狀態(這需要知道答案,算是上限),可以解出 7 題,表示「輸出最深的狀態」這個規則還有改進空間。
剪枝也會出錯。5 × 5 的填字遊戲為了湊格子,會用到一些罕見或過時的字,例如「agend」是「agendum」的舊寫法,GPT-4 卻認為那是「agenda」的拼錯,把正確的盤面剪掉了。拿掉剪枝之後整體分數下降,但有 4 題在搜尋過程中找到過正確的盤面,其中 3 題是有剪枝的 ToT 在 100 步內解不出來的。評估器的好壞,直接決定了搜尋能走多遠。
拿掉回溯,改成每次都填最有希望的那個字、最多 20 步、可以覆寫,單字正確率只剩 20%。
簡單的題目用不上
附錄把零樣本的 ToT 用在一般的題目上:先產生 5 種解題策略投票選一種,再依策略寫 5 個解答投票選一個。
| 方法 | GSM8K | StrategyQA |
|---|---|---|
| IO | 51 | 73 |
| CoT | 86 | 82 |
| ToT | 90 | 83 |
整理自原論文 Table 4;GPT-4,各 100 題,單位為 %。
ToT 還是比 CoT 好,但幅度很小。GPT-4 加 CoT 在這些題目上已經很強;StrategyQA 的瓶頸是外部知識,而不是推理。作者的建議是,傳統的 NLP 任務可以試試小模型加 ToT,GPT-4 加 ToT 留給連 GPT-4 加 CoT 都做不好的難題。
限制
作者在討論裡提了幾點:
- 很多任務不需要:GPT-4 已經擅長的任務,用不著這麼費力的搜尋;這篇也只探索了三個相對簡單、但 GPT-4 做不好的任務。
- 成本:依提示和搜尋方式不同,ToT 產生的 token 是 CoT 的 5 到 100 倍。三個任務的主要實驗,24 點和創意寫作合計約 106 美元,填字遊戲估計也在 100 美元以內。
- 只用現成的模型:作者提到,未來可以用類似 ToT 的方式微調模型,讓它學會在「下一段該怎麼寫」這種層級上做決策,而不只是預測下一個 token。
另外值得一提的是,ToT 的每個任務都要人自己設計:想法怎麼切、提議和評估的提示怎麼寫、用哪一種搜尋。換一個問題,這些都要重新想一遍。
後來的事
作者在結尾提的方向,後來由推理模型實現了,只是走的不是 ToT 這條路。
DeepSeek-R1 的論文裡,有一段「失敗的嘗試」。團隊試過用蒙地卡羅樹搜尋(MCTS)在推論時探索,把答案切成小段,用一個價值模型引導搜尋,但遇到兩個問題:token 生成的搜尋空間比棋類大太多,就算限制每個節點的展開數,也容易卡在局部最佳;訓練一個夠精細的價值模型本身就很難。最後成功的,是用答案對錯當獎勵的強化學習,讓模型在同一條很長的思維鏈裡,自己學會檢查、懷疑、回頭重想。
推論時的搜尋並沒有消失。在什麼情況下該用搜尋、什麼情況下該讓模型自己修改答案、算力怎麼分配最划算,後來有人做了系統性的比較。
結論
ToT 把古典人工智慧的樹狀搜尋接到語言模型上,讓模型同時負責提出候選和評估好壞。GPT-4 玩 24 點,CoT 只有 4%,ToT 到 74%;填字遊戲的單字正確率從 15.6% 到 60%。
它也把這類方法的代價講得很清楚。每個問題要人設計想法的切法、提議和評估的提示、搜尋的方式;token 是 CoT 的好幾倍到上百倍;評估器一旦看錯,像那個被當成拼錯的「agend」,正確的答案就被剪掉了。
一年多後,推理模型把這棵樹壓平了。模型在一條長長的思維鏈裡自己停下來說「等一下,這樣不對」,然後回到前面重想;分支、評估、回溯都還在,只是不再需要外面那套搜尋程式來管。