原論文
Unifying Short and Long-Term Tracking with Graph Hierarchies
- 発表先
- CVPR 2023国際会議
- arXiv への初回投稿
- arXiv:2212.03038
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingsushi2022,
  title = {{Unifying Short and Long-Term Tracking with Graph Hierarchies}},
  author = {Orcun Cetintas and Guillem Brasó and Laura Leal-Taixé},
  year = {2022},
  eprint = {2212.03038},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2212.03038}
}
長い動画を追跡するのは、実は時間のスケールが違う問題をひと続きで解くことだ。
隣り合う二フレームの間では、人はほとんど動かないので、位置を見ればマッチングできる。半秒隠れてから再び現れたなら、運動モデルで少し先を推し量る必要がある。十数秒も隠れてからまた歩き出してきたら、位置はとっくに合わなくなっていて、外観を頼りにその人だと見分けるしかない。
当時最も成績の良かったトラッカーは、たいてい何種類もの手法をつなぎ合わせていた。短期はカルマンフィルタか Tracktor に任せ、長期にはさらに ReID モジュールをぶら下げる。グラフニューラルネットワークの手法も事情は同じで、MPNTrack は一度に 15 フレームしか処理せず、公開検出もまず Tracktor で処理しておく必要があった。
ミュンヘン工科大学の Guillem Brasó と Laura Leal-Taixé は、まさに MPNTrack の著者だ。今回は Orcun Cetintas とともに、一つのモデルで、隣り合う二フレームから 500 フレーム離れたところまで通して処理できないかを確かめようとした。
問題の定義
著者らは四枚の模式図で、当時よく見られたトラッカーを比べた。
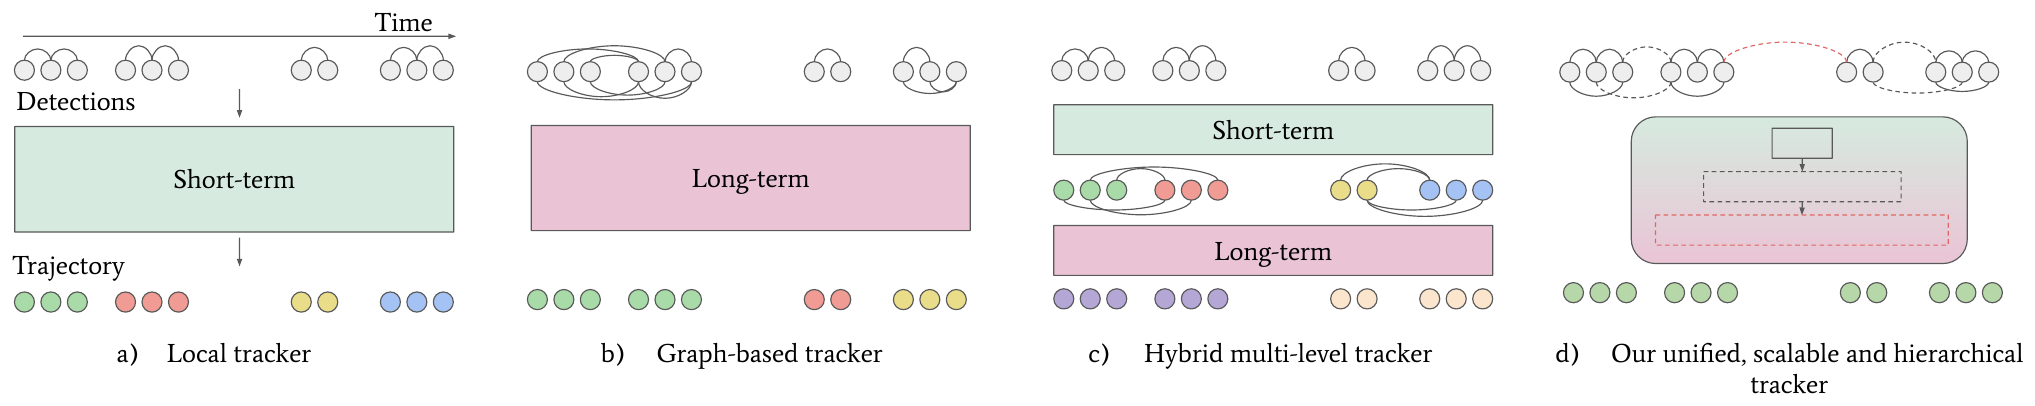
著者らは、(c) のようなハイブリッドのやり方には二つの問題があると考えた。
一つ目は規模だ。 グラフで関連付けを扱うとき、辺は「二つの検出が同じ人に属する」という仮説を表す。 フレーム離れた検出どうしもつなげるようにするには、すべてのフレームの間に辺を張る必要があり、辺の数は検出数の二乗で増える。
さらに厄介なのがラベルだ。各検出には正しい辺が多くても二本しかない。一本は過去へ、一本は未来へつながる辺だ。 個の検出に対して、正しい辺はせいぜい 本なのに、辺の総数は 本にもなりうる。検出が多くなると、正しい辺の割合はゼロに近づき、ネットワークにはほとんど負例しか見えなくなる。
二つ目は汎用性だ。 どの時間スケールでどの手がかりを使うかは、エンジニアがあらかじめ決めている。ところが、データセットによって必要な手がかりは違う。DanceTrack ではみんながまったく同じ服を着ていて、フレームレートも高いので、外観より位置や運動を見るほうが当てになる。BDD は車載の視点で、カメラが激しく揺れるので、逆に外観しか頼れない。場面が変わるたびに、組み合わせを調整し直さなければならない。
問題を解く
一層ずつ積み上げる
SUSHI のやり方は、長いクリップを再帰的に小さな時間窓に分け、各層では窓の中でだけ辺を張るというものだ。
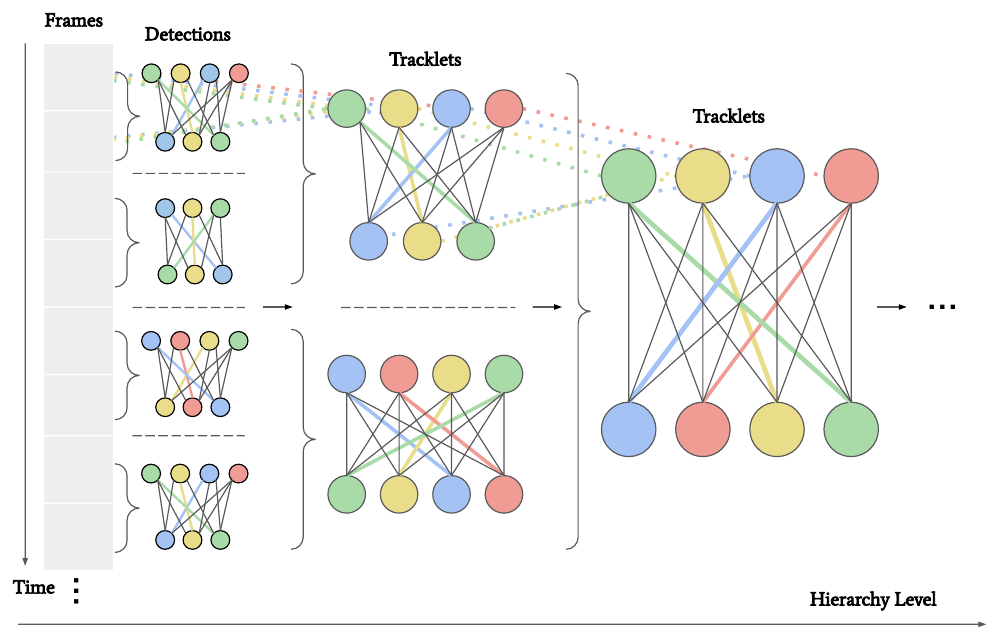
第一層では、各窓は二フレームだけで、隣り合う二フレームの検出をつないで長さ 2 の tracklet を得る。第二層の窓は四フレームで、ノードは前の層の tracklet になり、それらをさらに長いものに併合する。第 層の窓は フレームをカバーし、九層まで来ると、一つの窓は 512 フレームになる。MOT17 では、およそ 17 秒から 36 秒だ。
一層上がるごとにノードは少しずつ減るが、辺はより長い時間をまたげるようになる。
例で辺を数える
理想化した例で、階層によってどれだけ辺が節約できるかを見てみよう。
512 フレームのクリップで、どのフレームにも 20 人がいて、全員が検出され、どの層でも併合が正しく行われるとする。枝刈りはまだ一切しない。
- 単一の大きなグラフ。 二フレームの間ごとに 本の辺がある。512 フレームから任意に二フレームを選ぶ組み合わせは 130,816 通りで、全部で 52,326,400 本の辺になる。
- 九層の階層。 各窓は二つの子窓からなり、それぞれに 20 本の tracklet があって、両者の間の候補の辺は 400 本しかない。九層の窓の数は で、全部で 204,400 本の辺になる。
二つのやり方で最終的に選び出すべき正しい辺の数は同じで、どちらも 本だ。一人あたり 512 個の検出を一本の経路につなぐには、511 本の辺が要る。
| 方式 | 辺の数 | 正しい辺の割合 |
|---|---|---|
| 単一の大きなグラフ | 52,326,400 | 0.02% |
| 九層の階層 | 204,400 | 5% |
本稿で整理した計算例。
辺は 256 分の 1 に減り、正しい辺の割合は 1 万分の 2 から 5 パーセントへと引き上げられる。前者は GPU に載るかどうかを決め、後者はネットワークが学習できるかどうかを決める。
実際のモデルではさらにもう一度辺を刈り込み、各ノードは最も近い 10 個の近傍とだけつなぐ。単一の大きなグラフでは、正しい辺を刈り落とさないために近傍の数をかなり大きくしなければならないが、小さなグラフなら 10 個で足りる。
どの層も同じブロック
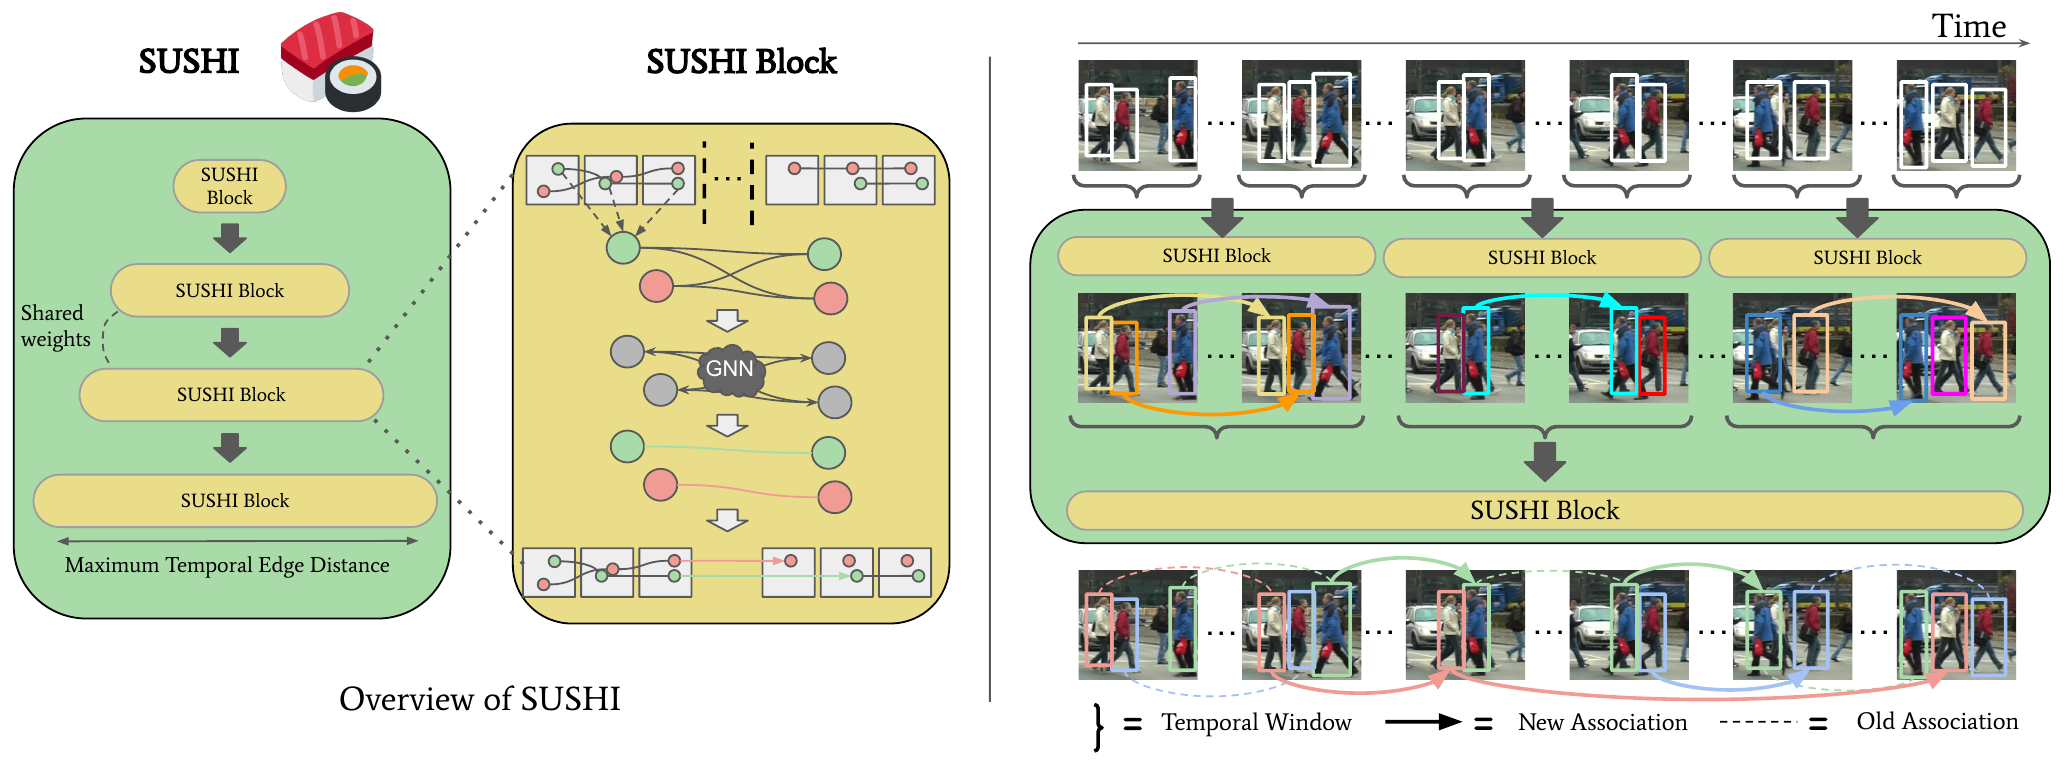
各層は SUSHI block と呼ばれ、中でしていることは MPNTrack と同じだ。
- 前の層の tracklet をノードとし、窓の中の異なる時刻の tracklet の間に辺を張る。
- MPNTrack の時間を意識したメッセージパッシングで、ノードと辺に何ラウンドか情報を交換させる。ノードは過去から来る辺と未来から来る辺を別々にまとめる。
- 小さな MLP で、各辺が同じ人かどうかを判定する。
- 線形計画でスコアを丸め、各ノードには前向きの辺と後ろ向きの辺が多くても一本ずつしかないようにしてから、つながった tracklet を併合する。
辺の初期特徴は四種類ある。位置、大きさ、時間の距離は、二本の tracklet のうち時間的に最も近い二つの検出から計算する。外観は tracklet の中のすべての検出の ReID 特徴の平均を使い、単一の検出より安定している。
四つ目は運動で、これは MPNTrack にはなかったものだ。単一の検出には速度がないが、tracklet にはある。前の tracklet の最後の位置を先へ、後ろの tracklet の最初の位置を手前へと推し進め、両者の中間の時刻まで持っていってから、二つの推定ボックスの GIoU を計算する。両端から中間へ推し進めるので、それぞれの側で予測する時間は半分で済む。
九層で一組の重みを共有する
この論文の最も重要な設計は、九つの SUSHI block が構造だけでなく、重みまで共有していることだ。
層によって見えるデータはまったく違う。第一層の二つのノードは一フレームしか離れていないが、第九層では何百フレームも離れていることがある。自分がどの層にいるのかをモデルにわからせるため、著者らは層ごとに level embedding を一つ学習し、辺の初期埋め込みに加える。
重みを共有すると、九層分のデータをすべて同じネットワークの訓練に使えるので、サンプルが何倍にも増える。収束も速く、パラメータも少ない。ReID ネットワークを除くと、モデル全体のパラメータはおよそ 22K しかない。
さらに重要なのは、どの時間スケールでどの手がかりを見るべきかを、もう人が決めなくていいことだ。同じネットワークが、位置が大きく違い、時間も遠く離れた辺を見て、外観を見るように自分で学ぶ。
訓練では、上の層の入力は下の層の出力だ。下の層がまだ十分に学習できていないうちは、上の層が受け取る tracklet は間違っている。そこで著者らは第一層から始めて、500 イテレーションごとに一層ずつ凍結を解き、九層すべての凍結を解いてからまとめて訓練する。各層でそれぞれ focal loss を計算し、それらを足し合わせる。
推論では、512 フレームのスライディングウィンドウを毎回 256 フレーム重ねて使い、重なった区間で共有する検出が多い軌跡ほど同じものとみなして、二部マッチングでつなぐ。検出が与えられていれば、MOT17 で 21 fps で動く。
議論
一層ずつ同じネットワークに置き換える
アブレーションは MOT17 訓練セットで三分割の交差検証を行う。著者らは四つの時間範囲を比べ、IDF1 を主な指標とした。
| 範囲 | ハイブリッド | IDF1 | SUSHI | IDF1 |
|---|---|---|---|---|
| 25 フレーム | Tracktor | 65.6 | — | — |
| 75 フレーム | MPNTrack++ | 73.2 | 2 層 | 73.5 |
| 150 フレーム | MPNTrack++ | 73.4 | 3 層 | 74.8 |
| 512 フレーム | MPNTrack++ | 73.7 | 9 層 | 77.6 |
原論文 Table 1 をもとに整理。MOT17 訓練セット、三分割交差検証。
MPNTrack++ は MPNTrack に SUSHI の運動特徴を加えたもので、短期は相変わらず Tracktor に任せる。ハイブリッドのやり方は 75 フレームから 512 フレームまで延ばしても IDF1 が 0.5 増えるだけだが、SUSHI は 73.5 から 77.6 までずっと上がり続ける。
ハイブリッドのやり方では、長期の部分はいつまでも一枚のグラフのままだ。時間を延ばせばグラフは大きくなり、先に述べたラベルの不均衡もそれにつれてひどくなる。
クリップの長さと層の数
| クリップ長 | 1 層 | 3 層 | 5 層 | 7 層 | 9 層 |
|---|---|---|---|---|---|
| 8 フレーム | 64.1 | 65.9 | — | — | — |
| 32 フレーム | 64.2 | 70.0 | 71.3 | — | — |
| 128 フレーム | 61.9 | 75.1 | 75.6 | 75.8 | — |
| 512 フレーム | — | 76.2 | 76.8 | 77.1 | 77.6 |
原論文 Figure 4(b) をもとに整理。MOT17 訓練セット、IDF1。
一層だけのときは、クリップが 32 フレームを超えるとかえって悪くなり、128 フレームでは 61.9 まで下がる。グラフが大きすぎ、負例が多すぎて、ネットワークが学習しきれないのだ。層を増やしさえすれば、クリップは長いほど良くなる。九層、512 フレームの 77.6 は、一層での最高の 64.2 より 13.4 高い。
各層は何を見ているか
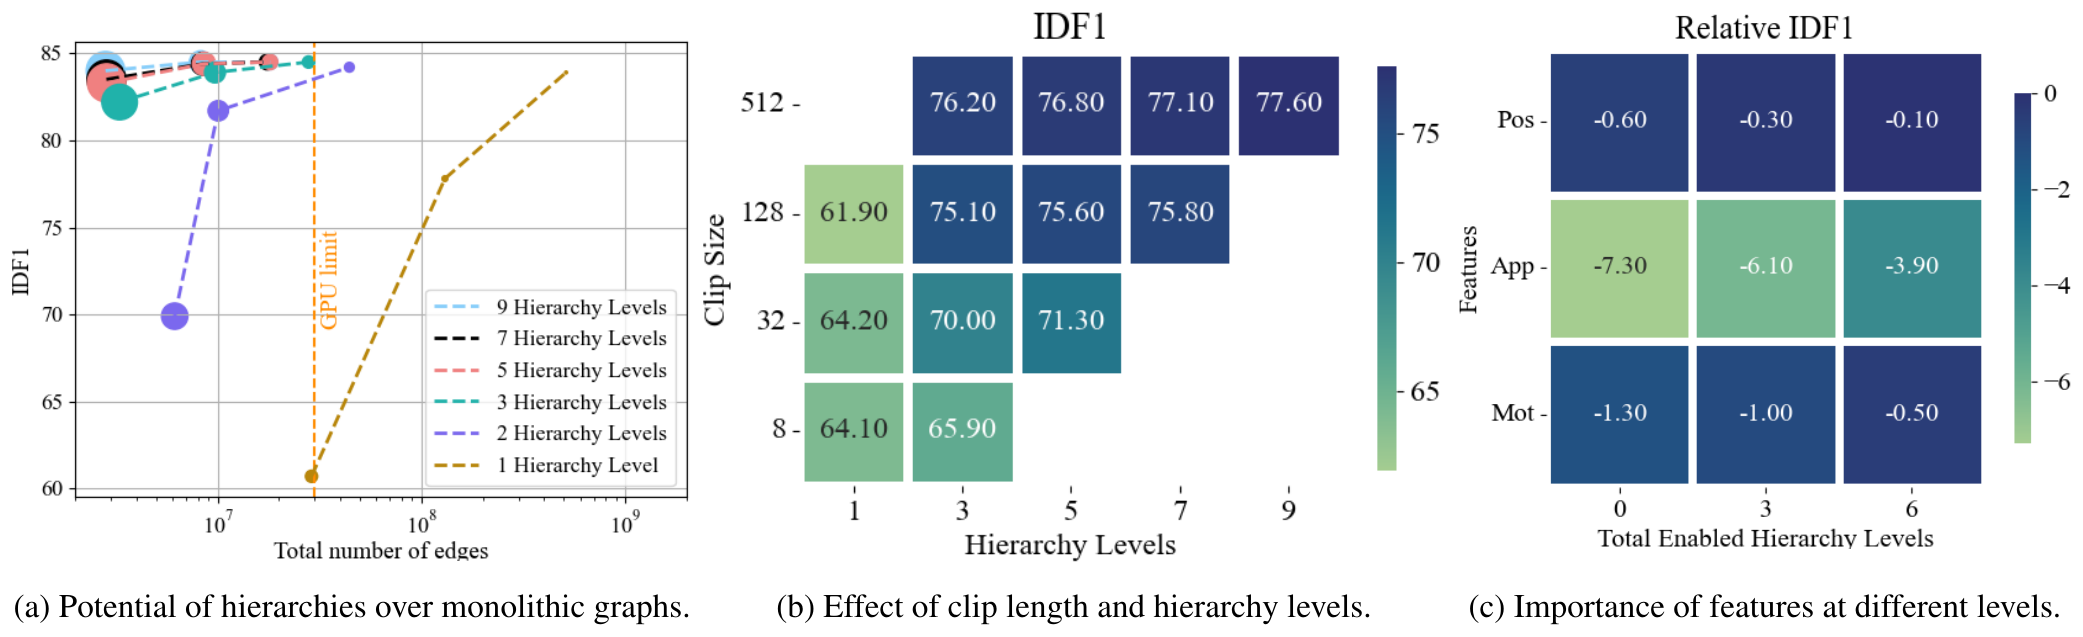
(c) が確かめているのは、同じネットワークが層によって違う手がかりに頼るかどうかだ。
- 外観が最も重要で、主に上の層で使われる。 すべてオフにすると IDF1 は 7.3 下がる。第 7 から 9 層でだけオフにすると 3.9 下がる。第 1 から 3 層でだけ残しても、すべてオフにしたときより 1.2 しか取り戻せない。
- 運動の影響はどの層でもあまり変わらない。 すべてオフにすると 1.3 下がり、影響は穏やかだ。
- 位置は下の層でしか役に立たない。 すべてオフにしても 0.6 しか下がらず、しかも最初の三層で残せば半分を取り戻せる。
隣り合うフレームでは位置を見て、遠く離れたら見た目を見る。これは直感とも合う。違うのは、これをネットワークが自分でデータから学んだことで、誰もルールを書いてやっていない。
四つのデータセット
| データセット | 比較相手 | IDF1 | HOTA | SUSHI IDF1 | HOTA |
|---|---|---|---|---|---|
| MOT17 公開 | MPNTrack | 61.7 | 49.0 | 71.5 | 54.6 |
| MOT17 独自 | ByteTrack | 77.3 | 63.1 | 83.1 | 66.5 |
| MOT20 独自 | ByteTrack | 75.2 | 61.3 | 79.8 | 64.3 |
| DanceTrack | ByteTrack | 53.9 | 47.7 | 63.4 | 63.3 |
原論文 Table 2–4 をもとに整理。テストセット。
MOT17 の公開検出の設定では、SUSHI が使っているのはまさに MPNTrack のネットワークなのに、IDF1 は 9.8 高い。違いは階層だけだ。ByteTrack の YOLOX の検出を使うと、IDF1 は 5.8 高く、ID スイッチは 2,196 から 1,149 へと半分近くまで減る。
DanceTrack の伸びが最も大きく、HOTA は ByteTrack の 47.7 から 63.3 へ跳ね上がり、原論文の表で HOTA が最も高い MOTR と QDTrack(どちらも 54.2)も上回る。ByteTrack は MOT17 でも MOT20 でも強いが、DanceTrack になると後れを取る。SUSHI は三つのデータセットのすべてでトップだ。車載視点の BDD では、SUSHI は同じ GNN をそのまま八つのクラスに適用し、テストセットの mIDF1 を 55.8 から 60.0 に引き上げた。
MOTA は事情が違う。MOT20 では、SUSHI の MOTA は 74.3 で、ByteTrack の 77.8 より低い。SUSHI が改善するのは関連付けで、検出の取りこぼしや誤検出までは手が回らない。
限界
SUSHI はオフラインの手法で、512 フレームのクリップを丸ごと受け取らないと処理を始められないので、リアルタイムの出力が必要なシステムには使えない。21 fps というのも、検出が計算済みになったあとの速度だ。
ReID ネットワークは既製のもので、追跡のデータでファインチューニングしていないので、SUSHI の改善はすべて関連付けの側から来ている。公開検出の設定では、ほかのグラフ手法と同じく、まず Tracktor で検出ボックスを精緻化しており、この段階そのものが一つの短期のトラッカーになっている。
結論
SUSHI は新しいグラフネットワークを発明したわけではなく、どの層も MPNTrack だ。大きくて疎な一枚のグラフを、九枚の小さなグラフを積み重ねたものに置き換えたのだ。辺は二桁減り、正しい辺の割合も 1 万分の 2 から 5 パーセントへと引き戻されて、ネットワークはようやく学習できるようになった。
重みの共有は、「どの時間スケールでどの手がかりを見るか」をデータに委ね直した。同じネットワークが下の層では位置を見て、上の層では外観を見る。誰もそう決めてはいない。
九層、512 フレームは、MOT17 ではおよそ三十秒だ。それより長い遮蔽は、スライディングウィンドウどうしの継ぎ目がうまくつながるかどうかにかかっている。