原論文
Learning a Neural Solver for Multiple Object Tracking
- 発表先
- CVPR 2020国際会議
- arXiv への初回投稿
- arXiv:1912.07515
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingmpntrack2019,
  title = {{Learning a Neural Solver for Multiple Object Tracking}},
  author = {Guillem Brasó and Laura Leal-Taixé},
  year = {2019},
  eprint = {1912.07515},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1912.07515}
}
オフライン追跡には、とてもきれいな古いアイデアがある。動画全体の検出結果を一枚のグラフに描くのだ。
各検出を一つのノードとし、異なるフレームの二つの検出のあいだにエッジを一本張る。二つの検出が同じ軌跡に属し、しかも時間的に前後して隣り合っていれば、そのエッジは「有効」になる。こうして追跡は、どのエッジを有効にすべきかを見つけるグラフ分割の問題になる。
この枠組みの標準的なやり方は、二つのステップに分かれる。まず各エッジにコストを計算し、二つの検出が同じ人である可能性を表す。次にそのコストを最適化ソルバーに投げ込み、全体として最も良い分割を見つける。
2019 年になると、この方向の研究はおおむね二派に分かれていた。一派はグラフの定式化に力を注ぎ、高次の関係を取り込んだ、ますます複雑な最適化を設計したが、コストはたいてい手作りのままだった。もう一派はシャムネットワークのような深層モデルでより良いエッジのコストを学び、それを単純なソルバーに渡したが、コストは二つ一組の対応しか見ておらず、場面全体は見えていなかった。
ミュンヘン工科大学の Guillem Brasó と Laura Leal-Taixé は、どちらの道も半分しか進んでいないと感じた。Leal-Taixé は MOT16 と Tracktor の著者の一人でもある。今回二人は、「解く」ステップまでネットワークに一緒に学ばせられないか試してみようとした。
問題の定義
追跡をネットワークフローとして書く
著者らは古典的な最小費用流(min-cost flow)から出発し、少し簡略化した。
ある動画のすべての検出 が与えられ、各検出 はボックス内の画像、ボックスの座標、タイムスタンプからなる。無向グラフを作り、各検出を一つのノードとし、異なるフレームにある任意の二つの検出のあいだにエッジを一本ずつ張る。フレームをまたいだ接続を許すことで、途中で検出漏れのあった軌跡もつなぎ直せる。
各エッジ には二値の変数 がある。二つのノードが同じ軌跡に属し、しかも軌跡上で隣り合う二つの検出なら 、そうでなければ 0 だ。
軌跡同士はノードを共有できないので、 は二つの条件を満たさなければならない。各ノードから過去へ向かう有効なエッジは最大で一本。
未来へ向かうエッジも最大で一本。
これはネットワークフローの保存条件を簡略化したものだ。
従来のやり方では、各エッジにコスト を与えて、次を解く。
上の二組の条件のもとで、この問題は多項式時間で最適解を求められる。
答えを直接予測する
最後に欲しいのが なのだから、著者らはいっそコストを学ぶのをやめ、 を直接学ぶことにした。
各エッジは一つの二値分類問題で、ラベルはまさに だ。これで追跡問題全体がエンドツーエンドで訓練できるタスクになり、特徴も「解き方」も同じネットワークの中で学べる。
残る問題は、二つのノードしか見ない分類器には、「この人はもう別の誰かとつながっている」というような全体の情報が学べないことだ。各エッジの判断にグラフ全体を考慮させるため、著者らはメッセージパッシングネットワーク(Message Passing Network, MPN)を使った。
問題を解く
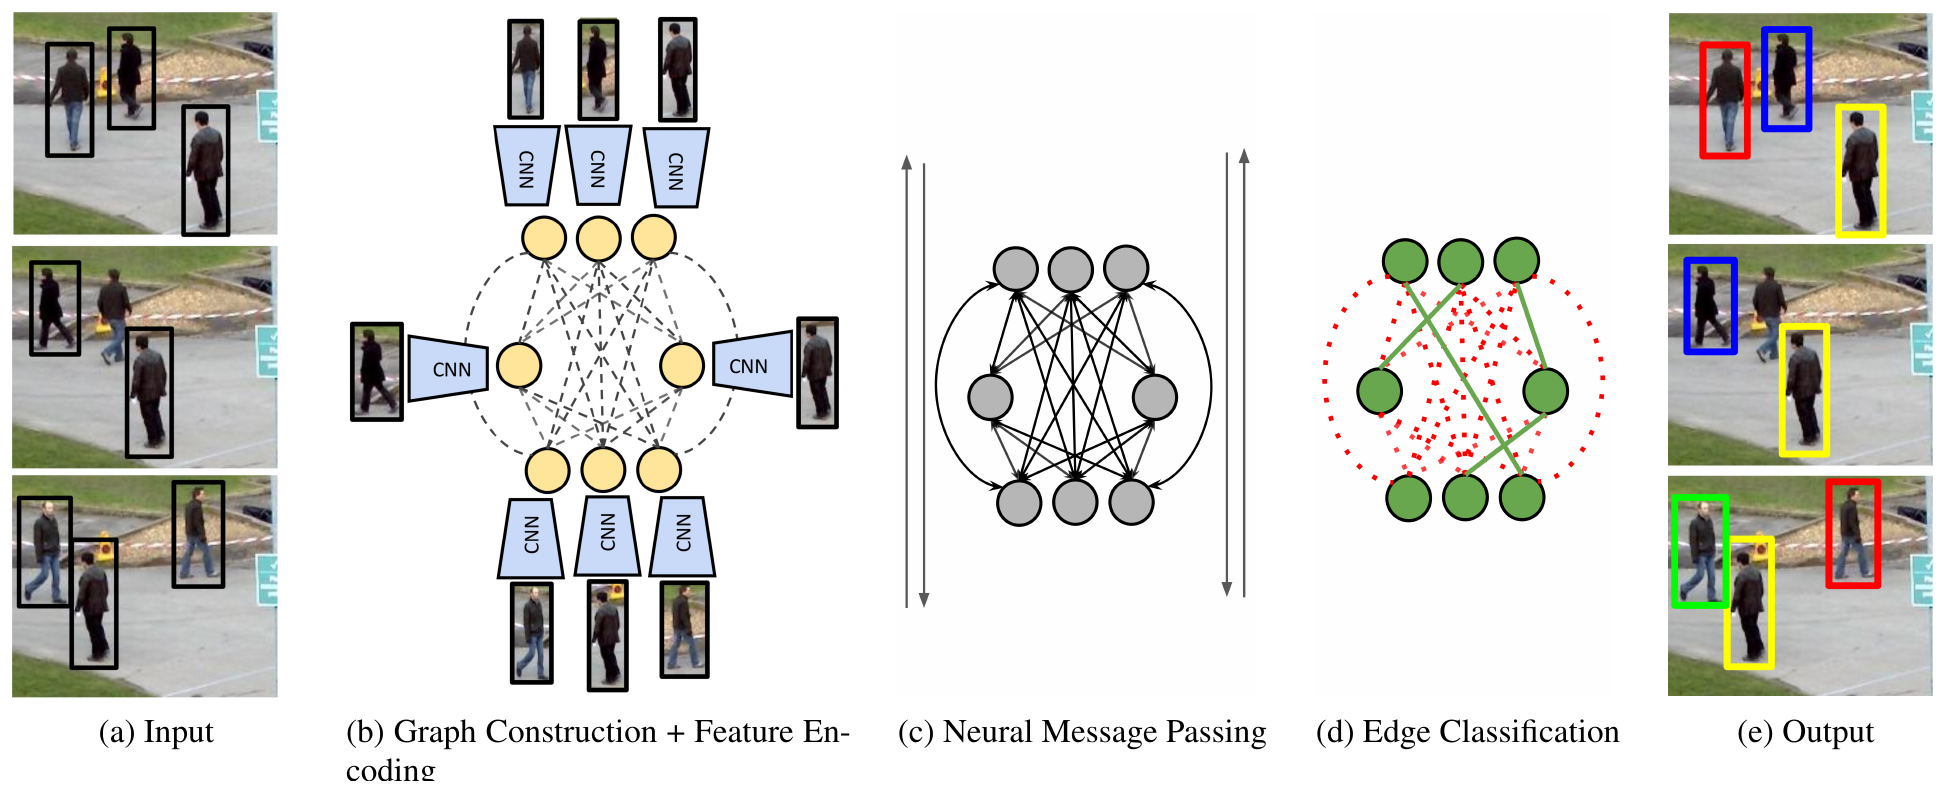
流れ全体は、グラフの構築、特徴のエンコード、メッセージパッシング、エッジの分類の四つのステップに分かれる。
初期の特徴
ノードの初期の埋め込みは外観から作る。著者らは ImageNet で事前学習した ResNet-50 を、Market-1501、CUHK03、DukeMTMC の三つの人物再識別データセットで訓練し、256 次元の re-ID 特徴を得た。その後ろに全結合層を三つつなぎ、ノードの埋め込みを 32 次元まで圧縮する。
エッジの初期の埋め込みは幾何的な関係から作る。異なるフレームの二つの検出ボックス と について、まず相対的な位置と相対的な大きさを計算する。
変位を二つのボックスの平均の高さで割るので、遠近の違う人を同じスケールで比べられる。これに両者の時間差 と、二つの re-ID 特徴のユークリッド距離を加え、まとめて MLP に送って、エッジの初期の埋め込みを得る。
メッセージパッシング
一般的なメッセージパッシングネットワークでは、各ステップに二つの更新がある。まず両端のノードでエッジを更新する。
次に、つながっているエッジでノードを更新する。各エッジがメッセージを一つずつ作り、すべてのメッセージを合計して(あるいは平均や最大値を取って)、新しいノードの埋め込みを得る。
これを 回繰り返すと、各ノードと各エッジは距離 以内の情報を持つようになる。働きとしては CNN の受容野に似ている。もともと二つのボックスしか見ていなかったエッジの分類が、今では「この二つのノードの周りに他にどんな候補があるか」まで見られる。
時間を考慮したノード更新
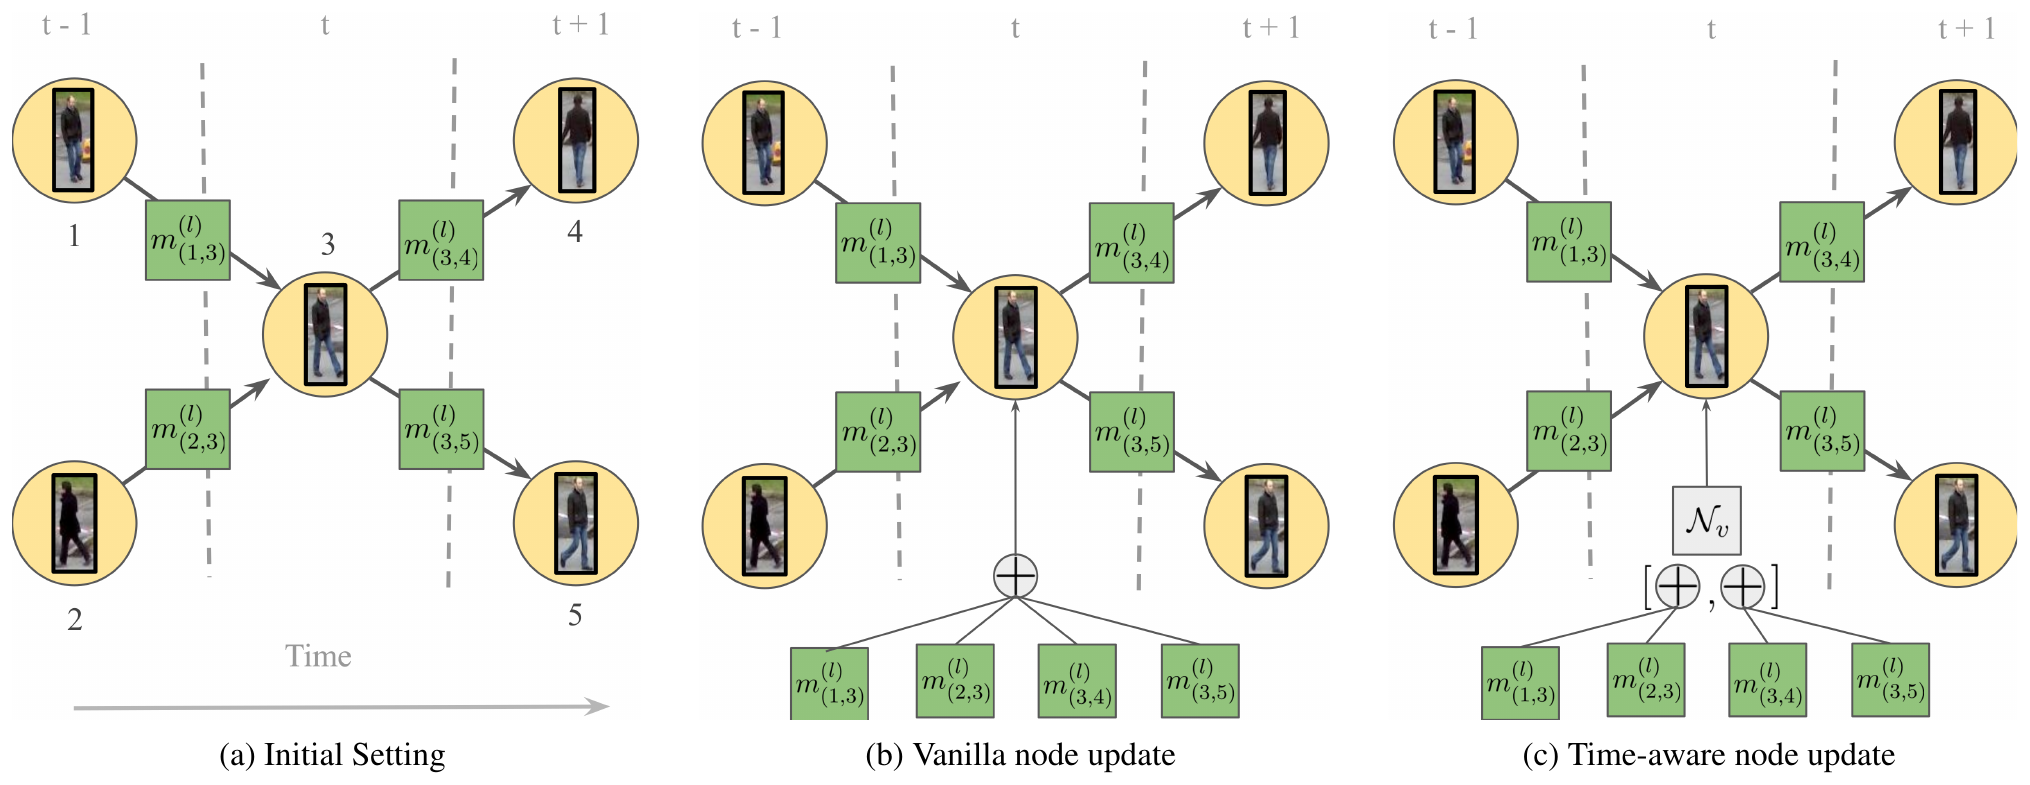
この論文の構成上の主な変更は、ノードの更新にある。
ネットワークフローの条件を思い出そう。各ノードは過去へ最大一本、未来へ最大一本しかつながれない。ところが一般的なノード更新は、すべての隣接ノードからのメッセージを混ぜて合計してしまう。合計したあとでは、どのメッセージが過去から来て、どれが未来から来たのか、ノードにはまったく区別がつかず、条件が破られているかどうかも判断しにくい。
著者らは MOT のグラフの時間構造を、更新規則に直接書き込んだ。ノード について、過去と未来の隣接ノードでは、異なる二つの MLP でメッセージを計算する。過去の隣接ノード には次を使う。
未来の隣接ノードには を使う。それぞれを合計して と にし、連結して最後の MLP に送る。
式の中の は初期の埋め込みで、各ステップにずっとつないでおくことで、何度も伝えたあとでもネットワークが元の特徴を忘れないようにしている。エッジの更新にも、同じように初期のエッジ特徴をつないでいる。
訓練と推論
エッジの分類器は、sigmoid の値を一つ出力する MLP だ。第 ステップから最後のステップ まで、各ステップのエッジの埋め込みを予測に使い、まとめて重み付きの二値交差エントロピーを計算する。
ここで、各エッジの第 ステップでの損失は次のとおりだ。
有効なエッジは無効なエッジよりはるかに少ないので、正例には別に重み を掛ける。
推論では、最後のステップの予測値をそのまま の答えとし、0.5 をしきい値にして二値化する。ネットワークはネットワークフローの条件を満たすよう強制されていないので、しきい値をかけたあと、一つのノードから二本のエッジが出ることもありうる。著者らは二通りの修正方法を用意した。一つは貪欲にスコアが最も高い一本だけを残す方法、もう一つは線形計画法で正確な最適の丸めを求める方法だ。実際には条件に違反するエッジはごく少なく、二つの方法の差はほとんどない。貪欲法の IDF1 が 0.2 低いだけだ。
実装の詳細
実際に動かすうえで重要な設定がいくつかある。
- CNN は凍結する。 著者らは、ResNet まで一緒に訓練しても効果ははっきりとは上がらず、計算量だけがずっと増えることに気づいた。そこで畳み込み層はすべて凍結し、後ろの MLP だけを訓練する。
- スライディングウィンドウ。 動画を 15 フレームずつのグラフに切り分け、隣り合う二つの区間は 14 フレーム重なる。重なったエッジは、各区間の予測の平均を取る。静止カメラは毎秒 6 フレーム、移動カメラは毎秒 9 フレームでサンプリングするので、一枚のグラフがカバーするのは動画のおよそ 1.5 秒から 2 秒あまりぶんだけだ。
- 枝刈り。 異なるフレームのノードをすべてつなぐとエッジの数が爆発するので、二つのノードが互いに re-ID 特徴の最近傍上位 50 に入っているときだけエッジを張る。
- Tracktor で前処理する。 公開検出にまず Tracktor を一度かけ、それがつけた ID は捨てて、補正後のボックスだけを入力にする。Tracktor のボックスはより正確で、隣のフレームで漏れていた検出もいくらか補ってくれる。出力の軌跡の途中で欠けたフレームは、まず Tracktor の軌跡で補い、残りを補間で埋める。
最後の点には注意が要る。MPNTrack 自身のネットワークは毎秒 35 フレームで動くが、前段の Tracktor は毎秒 8 フレームしか出ず、システム全体では平均毎秒 6.5 フレームになる。
議論
アブレーションの実験はどれも MOT17 の訓練セットで、3 分割の交差検証で行っている。
時間を考慮した更新
| ノード更新 | MOTA ↑ | IDF1 ↑ | ID スイッチ ↓ | 制約充足率 ↑ |
|---|---|---|---|---|
| 一般 | 63.0 | 67.3 | 1,022 | 82.1% |
| 時間考慮 | 64.0 | 70.0 | 602 | 98.8% |
原論文 Table 1 をもとに整理。制約充足率は、しきい値 0.5 のもとでネットワークフローの保存条件が満たされた平均の割合。
過去と未来を分けると、IDF1 は 3 ポイント近く増え、ID スイッチは 1,022 から 602 に減った。
もっと面白いのは最後の列だ。一般的な MPN をそのまま二値化すると、満たされる条件は 82.1% しかない。時間を考慮した版では 98.8% になる。ネットワークは「各人は前と後ろにそれぞれ一つずつしかつながれない」という規則を、ほとんど自分で学んでいて、外付けのソルバーで強制する必要がない。
何ステップ伝えるか
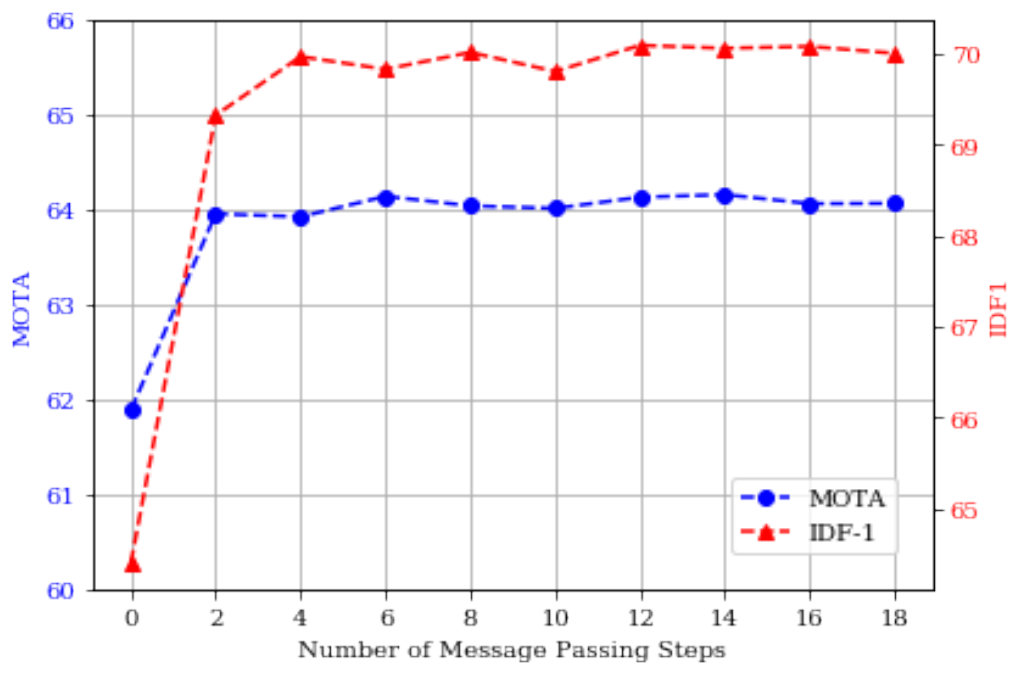
0 ステップとはメッセージを伝えないことで、初期のエッジの埋め込みだけで二値分類をする。これは従来の「二つ一組のコストを学ぶ」やり方と同じだ。
0 ステップから 2 ステップで、MOTA も IDF1 も大きく跳ね上がる。二つ一組の関係から高次の関係へ進む一歩だ。その後、上昇傾向はおよそ 6 ステップで止まり、12 ステップ以降はもう改善しない。最終的な設定は だ。
特徴の出どころ
| エッジ特徴 | MOTA ↑ | IDF1 ↑ | FP ↓ | ID スイッチ ↓ |
|---|---|---|---|---|
| 時間差のみ | 58.8 | 52.6 | 13,127 | 2,962 |
| 時間差 + 位置 | 63.6 | 68.7 | 6,308 | 895 |
| 時間差 + 位置 + 外観 | 64.0 | 70.0 | 6,169 | 602 |
原論文 Table 2 をもとに整理。
この表は少し意外だ。相対位置を加えると IDF1 は 52.6 から 68.7 に跳ね上がり、これが最も大きな一歩になる。外観特徴をさらに加えても、IDF1 は 1.3 しか増えない。それでも外観は ID スイッチを 895 から 602 までさらに押し下げるので、残しておく価値はある。
この枠組みでは、位置のほうが外観よりずっと重要だ。論文はその理由をそれ以上分析していない。一つ考えられる説明は、ノード自体がすでに外観の埋め込みを持っていて、メッセージパッシングのときにエッジもそれを受け取れるので、エッジにさらに外観の距離を置いても、情報の一部は重複している、というものだ。
他の手法と比べる
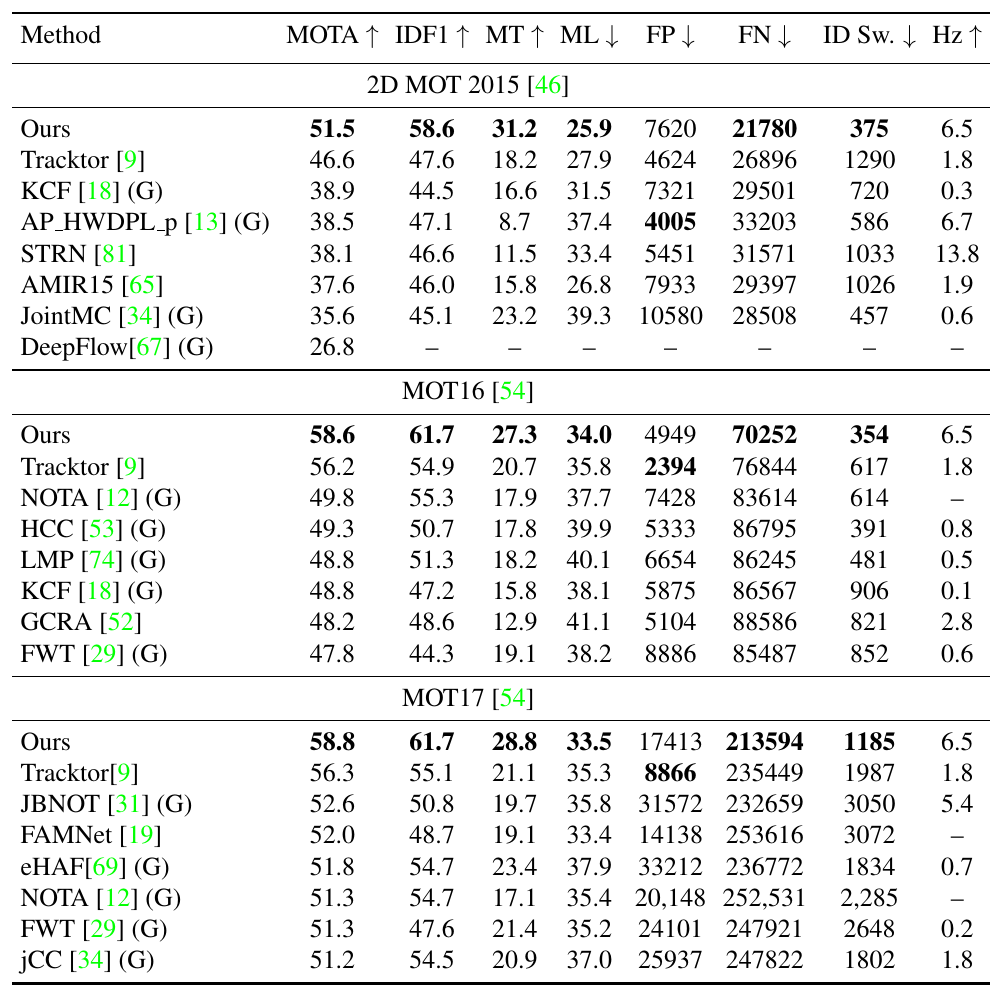
三つのベンチマークはどれも公開検出を使っている。MPNTrack は三つのデータセットすべてで一位で、IDF1 はそれまでの最高の結果をそれぞれ 11、6.4、6.6 ポイント上回った。他のグラフ分割の手法と比べると、はるかに正確なうえ、その一部より一桁速い。たとえば JointMC は 0.6 Hz しか出ない。
ただ、ここでは Tracktor の前処理がかなり助けになっている。付録で著者らは、Tracktor を使わず、Faster R-CNN の回帰ヘッドで公開検出を補正した版も別に報告している。
| データセット | MOTA(Tracktor あり) | MOTA(なし) | IDF1(Tracktor あり) | IDF1(なし) |
|---|---|---|---|---|
| MOT15 | 51.5 | 46.6 | 58.6 | 53.8 |
| MOT16 | 58.6 | 54.3 | 61.7 | 56.8 |
| MOT17 | 58.8 | 56.0 | 61.7 | 58.4 |
原論文の付録 Table 7 をもとに整理。
Tracktor を外すと、MOTA は 2.8~4.9 ポイント、IDF1 は 3.3~4.9 ポイント落ちる。それでも表にある他のグラフ手法には勝っている。しかもそれらの手法の多くは、非最大値抑制をかけていない生の検出、低レベルの画像特徴、あるいは階層的な設計を使っていて、得ている情報はこちらより多い。
限界
MPNTrack はオフラインの手法で、各グラフは未来のフレームを見てはじめて判断を下せるので、リアルタイムのシステムにそのまま移すことはできない。
時間のウィンドウも短い。一枚のグラフがカバーするのは 2 秒前後だ。長いあいだ隠れていた人は、画面に戻ってきても同じグラフの中にいないため、つなぎ直せない。エッジの数はノード数の二乗で増えるので、ウィンドウを延ばすなら、枝刈りをもっと厳しくしなければならない。
同じ研究室はのちに 2023 年の SUSHI でグラフを多層に積み重ね、下の層で短時間のつながりを扱い、上の層で短い軌跡をさらに長い軌跡につないだ。扱ったのは、まさにこのウィンドウが短すぎるという問題だ。
結論
この論文以前、複数物体追跡での学習は主に特徴とコストを学ぶためのもので、実際に軌跡を決めていたのは従来の最適化ソルバーだった。MPNTrack はネットワークフローの二値変数をそのまま分類のラベルにし、メッセージパッシングで各エッジにグラフ全体を見せて、実行可能に近い解をネットワーク自身に学ばせた。
時間を考慮した更新は目立たない小さな変更で、過去と未来を分けて合計しただけなのに、ネットワークは保存条件をほとんど自分で学んでしまった。
論文のタイトルはソルバーを学ぶと言っていて、ネットワークは実際に 98.8% まで学んだ。残りの 1.2% は、結局、丸めの規則に後始末を任せるしかない。それも貪欲なループ一つで足りる。