原論文
Learnable Graph Matching: Incorporating Graph Partitioning with Deep Feature Learning for Multiple Object Tracking
- 発表先
- CVPR 2021国際会議
- arXiv への初回投稿
- arXiv:2103.16178
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackinggmtracker2021,
  title = {{Learnable Graph Matching: Incorporating Graph Partitioning with Deep Feature Learning for Multiple Object Tracking}},
  author = {Jiawei He and Zehao Huang and Naiyan Wang and Zhaoxiang Zhang},
  year = {2021},
  eprint = {2103.16178},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2103.16178}
}
SORT から DeepSORT まで、ほとんどのオンラインのトラッカーは、前のフレームの軌跡とこのフレームの検出を一枚の二部グラフに並べ、各ペアの類似度を計算して、ハンガリアン法にマッチングを任せている。
この二部グラフには一種類の辺しかない。「軌跡 と検出 はどれくらい似ているか」だ。同じフレームの二つの検出が互いにどういう関係にあるか、二本の軌跡のどちらがもともと左にいたか、といったことは一切考慮されない。
中国科学院自動化研究所の Jiawei He、Zhaoxiang Zhang と、図森(TuSimple)の Zehao Huang、Naiyan Wang は、こうした関係こそが遮蔽のときに最も頼れる手がかりだと考えた。歩行者はよく連れ立って歩く。ある人が隠れて外観がよく見えなくなっても、「その人がもともと誰の隣を歩いていたか」を手がかりに、もう一度その人だと見分けられる。
問題の定義
著者らは、当時のデータ関連付けの問題を三つにまとめた。
- 同じフレームの中の文脈を無視している。 二フレーム間の二部マッチングでも、複数フレームにまたがる最小費用流でも、気にしているのは「フレームをまたぐ」マッチングだけで、同じフレームの中の物体どうしの関係は使っていない。
- エンドツーエンドの手法はネットワークのフィッティングだけに頼っている。 ネットワークに直接マッチングの結果を出力させる手法もあるが、組合せ最適化が数十年かけて積み上げてきた道具は使っていない。
- 最適化の手法の特徴は別に訓練されている。 グラフ最適化で関連付けを行う手法では、特徴はふつう独立に訓練したネットワークから来ていて、訓練時の目標と推論時のマッチングのやり方が一致していない。
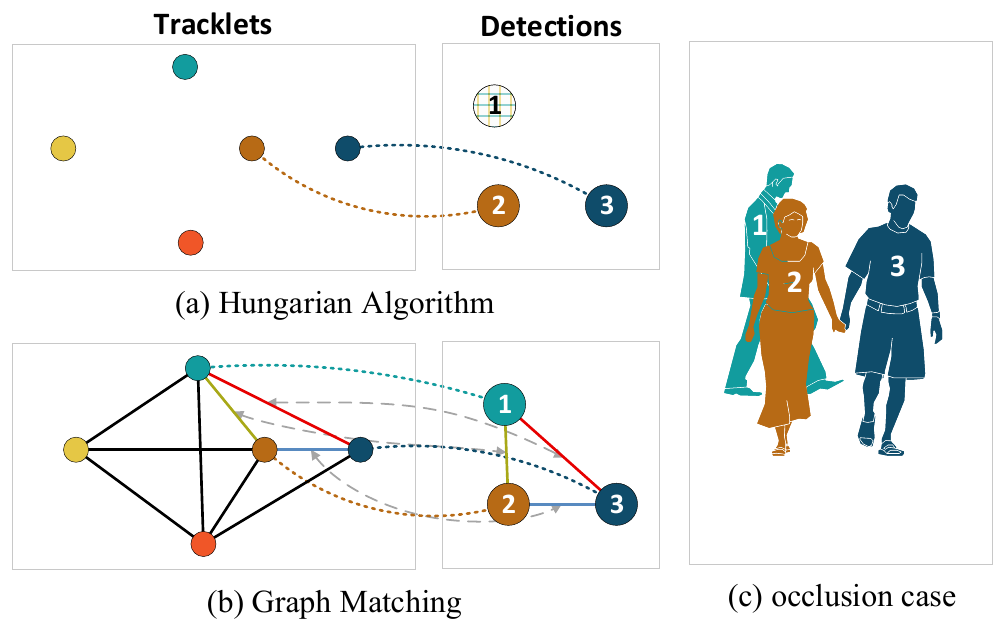
右の (c) を見てほしい。1 番は 2 番に大部分を隠されていて、抽出した外観特徴はたいてい当てにならない。(a) のハンガリアン法は「この検出はどの軌跡に似ているか」しか見ないので、1 番はマッチしなくなる。(b) はさらに検出 1、2、3 の間の相対的な位置も見る。それが軌跡どうしの相対的な位置と合うので、1 番は再び見分けられる。
著者らはこうした「辺と辺」の関係を二次の類似度と呼ぶ。これを関連付けに使うなら、マッチングの問題はもう二部マッチングではなく、一般のグラフマッチングになる。
問題を解く
二部マッチングからグラフマッチングへ
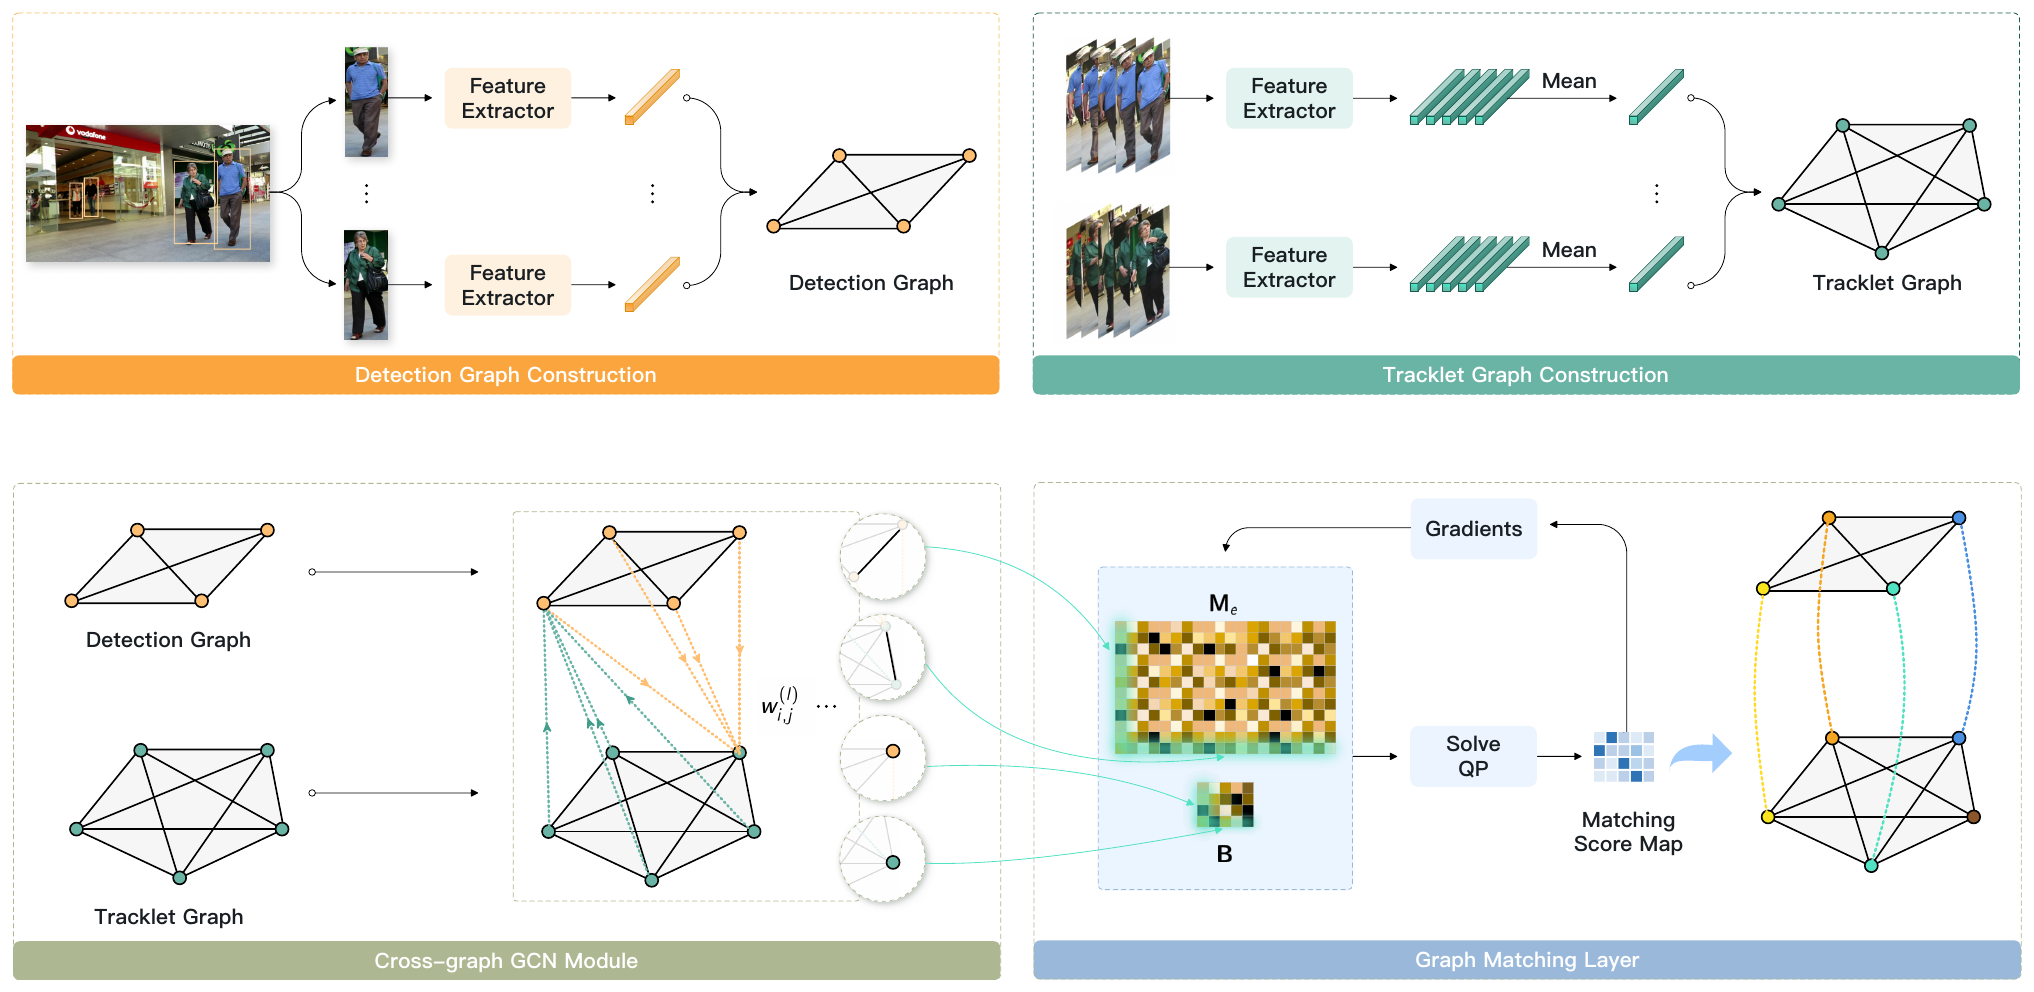
著者らはフレームごとにグラフを二つ作る。検出グラフ の頂点はこのフレームの検出、軌跡グラフ の頂点は現在の軌跡で、どちらも完全グラフ、つまりどの二つの頂点の間にも辺がある。
グラフマッチングは、マッチした頂点どうしが似ていて、マッチした辺どうしも似ているようなマッチング を探す。数式で書けば、二次割当問題になる。
、 は二つのグラフの辺の重み、 は頂点どうしの類似度だ。第一項はマッチした辺の重みが近いことを、第二項はマッチした頂点が似ていることを求める。
第二項だけを見れば、ふつうのハンガリアン法になる。第一項が新しく加わった部分だ。
双子の例
極端な例で、第一項が何の役に立つのかを見てみよう。
二本の軌跡 、 があり、 はずっと の左を歩いている。このフレームに二つの検出 、 が現れたが、二人は双子でまったく同じ服を着ていて、外観の類似度はすべて 0.5 だ。
頂点だけを見ると、二通りのマッチングのスコアは同じになる。
| マッチング | 頂点スコア |
|---|---|
| –、– | 0.5 + 0.5 = 1.0 |
| –、– | 0.5 + 0.5 = 1.0 |
ハンガリアン法は適当にどちらかを選ぶしかない。
ここで辺を加える。GMTracker の辺の特徴は両端の頂点の特徴を連結したものなので、辺には向きがあり、 と は別々の辺になる。検出 が の左にいるとすると、辺 と の類似度は 0.9、 とはわずか 0.2 だ。逆向きも同様だ。
| マッチング | 頂点スコア | 辺スコア | 合計 |
|---|---|---|---|
| –、– | 1.0 | 0.9 + 0.9 | 2.8 |
| –、– | 1.0 | 0.2 + 0.2 | 1.4 |
本稿で整理した計算例。
見た目だけでは見分けられない二人も、周りの人に対してどこに立っているかを見れば見分けられる。
微分可能な二次計画に緩和する
問題は、二次割当問題が NP 困難で、ハンガリアン法のような多項式時間の解法がなく、ましてニューラルネットワークに組み込んで逆伝播させることなどできないことだ。
著者らは二つの手を打った。
- 緩和。 0 か 1 しかとれない置換行列を、各行、各列の和が 1 になる「二重確率行列」に緩める。これは置換行列の最もきつい凸緩和で、問題は凸の二次計画になる。
- 辺の重みを辺の特徴に置き換える。 もとは各辺に重みが一つあるだけだったが、ここでは各辺が一本のベクトルになる。辺と辺の類似度は二つの辺の特徴のコサイン類似度で表し、辺対辺の類似度行列 を作って、さらに二次項の行列 に展開する。
最後に解くのは次の問題だ。
はマッチング行列を一列に並べ直したベクトル、 は頂点の類似度だ。制約条件は、各検出のマッチングスコアの和が 1 に等しく、各軌跡の和は 1 を超えないことだ。このフレームで消えた軌跡もあるからだ。
二次計画の最適解は、KKT 条件と陰関数定理を使えば、入力に対する勾配を求められる。著者らは OptNet のやり方を参考に、グラフマッチング全体を微分可能なネットワークの一層にした。訓練では勾配にこの層を通過させて特徴まで戻し、推論では順方向に解くだけでいい。
これで先ほどの三つ目の問題が解決する。特徴はグラフマッチングが正しくマッチングできるように訓練され、訓練と推論で同じマッチングのやり方を使う。
グラフをまたぐグラフ畳み込み
頂点の特徴は事前学習した ReID ネットワークから得て、その後ろに訓練可能な全結合層を二層つなげる。軌跡の特徴は、その軌跡のすべての検出の特徴の平均だ。
グラフマッチングに送る前に、著者らはまず一層のグラフをまたぐグラフ畳み込みで特徴を強化する。検出グラフの各頂点は、軌跡グラフのすべての頂点からメッセージを集める。重みは外観と位置の類似度だ。
軌跡のボックス は等速のカルマンフィルタで予測する。カメラが動いている動画では予測した位置が当てにならないので、外観の類似度だけを使う。
集めたメッセージ は、正規化してからもとの特徴に足し戻し、さらに MLP を通す。
軌跡グラフの頂点も同じやり方で更新する。MPNTrack と同じく、メッセージは二つのグラフの間でだけ受け渡し、同じグラフの内部では受け渡さない。最後に、各辺の特徴は両端の頂点の特徴を連結して l2 正規化したものになる。
訓練と推論
訓練には重み付きの二値交差エントロピーを使い、正例の重みは にする。一つの検出に正しい軌跡は一本しかないのに、誤った軌跡は何本もあるという不均衡を釣り合わせるためだ。二次計画の解はなだらかなので、損失を計算する前に、温度がごく低い()softmax でスコアの差を広げる。
推論では、緩和した解は 0 か 1 になるとは限らないので、著者らは貪欲なやり方で丸め、各検出をスコアが最も高い軌跡に割り当てる。軌跡の生成と削除は DeepSORT をそのまま使う。外観があまりに似ていない検出、すべての軌跡から遠すぎる検出(カルマンフィルタのマハラノビス距離がしきい値を超える)、すべての軌跡と重ならない検出は、最初のマッチングには加えない。こうした検出は、あとで IoU とハンガリアン法を使って、マッチしなかった軌跡ともう一度マッチングし直す。さらに ECC でカメラ運動補償を行う。軌跡は 100 フレーム更新されなかったときに初めて削除する。
議論
各部品の貢献
アブレーションは MOT17 訓練セットで三分割の交差検証を行い、DeepSORT のハンガリアン法によるマッチングを基準とする。
| 設定 | IDF1 | MOTA | ID スイッチ |
|---|---|---|---|
| DeepSORT 基準 | 68.1 | 62.1 | 1,135 |
| +グラフマッチング | 70.0 | 62.3 | 1,128 |
| 完全な GMTracker | 71.5 | 62.3 | 1,017 |
| 完璧な関連付け | 77.2 | 62.6 | 14 |
原論文 Table 1 と付録 Table A をもとに整理。MOT17 検証セット、補間なし。
- 最も貢献したのはグラフマッチングそのものだ。 ハンガリアン法をグラフマッチングに置き換えただけで、IDF1 は 1.9 上がった。訓練した外観特徴とグラフ畳み込みでさらに約 0.6、位置の情報を加えてさらに約 1.0 上がる。
- MOTA はほとんど動かない。 62.1 から 62.3 だ。GMTracker が扱うのは関連付けで、検出は変わっていないからだ。これは著者らが IDF1 を主な指標にした理由でもある。
- 完璧まではまだ距離がある。 付録では、著者らは正解データで完璧な関連付けを行い、IDF1 は 77.2 だった。GMTracker は、基準と完璧の間の差のおよそ三分の一を埋めた。
グラフマッチング層は、一緒に訓練しなければ役に立たない。訓練でも推論でも使わなければ IDF1 は 69.5、推論でだけ加えると 70.2、訓練でも推論でも使って初めて 71.5 になる。
どれくらい長く追えるか
| 軌跡の保持フレーム数 | 30 | 50 | 80 | 100 | 150 |
|---|---|---|---|---|---|
| ハンガリアン法 | 67.2 | 67.9 | 68.1 | 68.1 | 67.3 |
| グラフマッチング | 68.0 | 69.3 | 69.7 | 70.0 | 70.0 |
原論文 Table 4 をもとに整理。MOT17 検証セット、IDF1。
保持する期間が長いほど、候補の軌跡は多くなる。ハンガリアン法は 150 フレームでかえって 0.8 下がる。候補が増えると取り違えやすくなるからだ。グラフマッチングはずっと横ばいか上昇していて、著者らはこれをもとに、GMTracker はおよそ 5 秒間消えていた軌跡をマッチし直せると考えている。
候補が多いとき、外観を比べるだけでは人を取り違えやすい。相対的な関係も入れれば、誤った組み合わせはつじつまが合いにくくなる。
ほかの手法との比較
MOT17 テストセットで、Tracktor で精緻化した公開検出を使うと、オンラインの GMTracker の IDF1 は 63.8、MOTA は 56.2 で、当時のほかのオンラインの手法より高い。CenterTrack の検出に替えると、IDF1 は 66.9 になる。線形補間を加えてオフラインの手法と比べると、IDF1 は 65.9 で、MPNTrack の 61.7 や LifT の 65.6 より高い。CenterTrack の検出にさらに補間を加えると、IDF1 は 68.7、MOTA は 65.0 だ。
ここでの比較では、検出の条件に注意が要る。MOTA は主に検出に左右されるので、同じ GMTracker でも、検出を替えるだけで MOTA は 56.2 から 61.5 に跳ね上がる。
コスト
この論文は速度を報告していない。二次計画の変数の数は検出数と軌跡数の積で、辺対辺の類似度行列はそれよりはるかに大きい。著者らは推論では CVXPY に切り替えて、順方向に解くだけにしている。混雑した場面ではフレームごとに二次計画を一回解かなければならず、計算コストは使う前にまず見積もるべきところだ。
のちのジャーナルの拡張版では、同じ学習可能なグラフマッチングを、画像の特徴点マッチングや点群の位置合わせにも使い、タイトルも「データ関連付けの実用的なパラダイム」に変わった。
結論
GMTracker は、オンライン追跡のマッチングを、頂点だけを見る二部マッチングから、頂点と辺を同時に見るグラフマッチングに置き換えた。ある人が隠れて外観が当てにならないときでも、周りのほかの人に対する相対的な関係から、その人を再び見分けられる。これをニューラルネットワークに組み込めるように、著者らは二次割当問題を凸の二次計画に緩和し、KKT 条件で勾配を求めて、特徴がマッチングのために学習されるようにした。
この論文も MPNTrack も、ペアごとの比較だけでなく、物体どうしの関係を関連付けの手がかりにしている。MPNTrack はグラフネットワークにどの辺をつなぐべきかを直接予測させ、GMTracker は最適化による求解を残して、ネットワークには特徴だけを学ばせた。
同じく MPNTrack のチームによる SUSHI は、のちにグラフネットワークのやり方を長時間の追跡にまで押し広げた。
参考
- Learnable Graph Matching: A Practical Paradigm for Data Association(TPAMI 2024 の拡張版)