原論文
Object-Centric Multiple Object Tracking
- 発表先
- ICCV 2023国際会議
- arXiv への初回投稿
- arXiv:2309.00233
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingocmot2023,
  title = {{Object-Centric Multiple Object Tracking}},
  author = {Zixu Zhao and Jiaze Wang and Max Horn and Yizhuo Ding and Tong He and Zechen Bai and Dominik Zietlow and Carl-Johann Simon-Gabriel and Bing Shuai and Zhuowen Tu and Thomas Brox and Bernt Schiele and Yanwei Fu and Francesco Locatello and Zheng Zhang and Tianjun Xiao},
  year = {2023},
  eprint = {2309.00233},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2309.00233}
}
1989 年、認知科学者の Zenon Pylyshyn は、視覚的な空間知覚についての理論を唱えた。人の視覚系には少数の「インデックス」があり、一つひとつのインデックスが一つの物体に貼りつく。物体が動いても、ほかの物体とすれ違っても、一部が隠れても、インデックスは貼りついたままだという。
これは複数物体追跡がやっていることによく似ているし、Slot Attention のスロットにもよく似ている。
Amazon AWS の Zixu Zhao、Tianjun Xiao らと、Slot Attention の共同筆頭著者 Francesco Locatello は、物体中心学習をそのまま追跡に使えないか試してみた。もし使えるなら、追跡のためにそれほど多くのボックスをアノテーションしなくて済むし、各ボックスが誰のものかをアノテーションする必要はなおさらなくなる。
問題の定義
追跡のアノテーションは高くつく
主流のトラッカーは、検出してから関連付ける。検出器の訓練には大量のボックスが要る。関連付けモジュールが外観特徴を学ぶなら、どのボックスが同じ人なのか、つまり ID アノテーションも必要になる。
ID アノテーションはボックスより高くつく。アノテーターは動画を通して見て、第 37 フレームのこの人と第 512 フレームのあの人が同一人物だと確かめなければならない。
物体中心学習は別の道を行く。Slot Attention のような手法はアノテーションを一切必要とせず、画面を再構成するだけで、シーンを一つひとつのスロットに分解でき、各スロットはおおむね一つの物体に対応する。SAVi はこれをさらに動画に広げ、スロットがフレームをまたいで続くようにした。
スロットは分身もするし、入れ替わりもする
ところが SAVi をそのまま追跡に使うと、二つの問題にぶつかる。
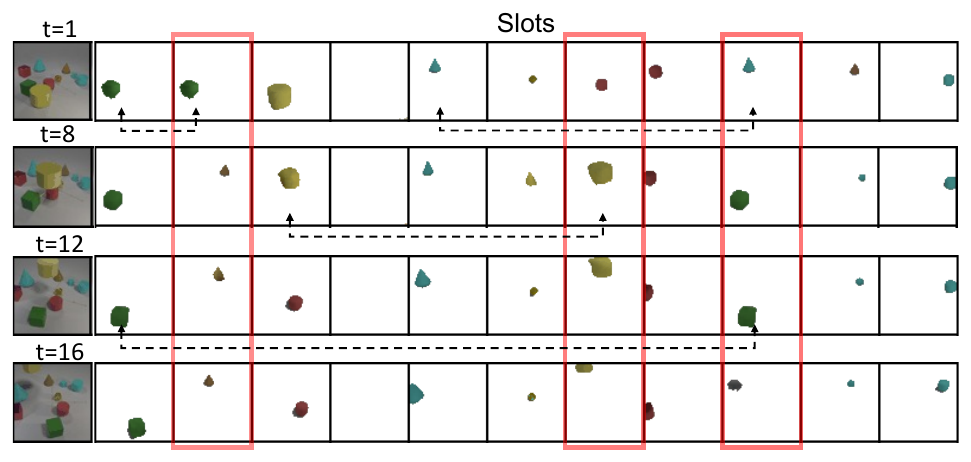
- 分身。 同じ物体を複数のスロットが分け合って捉えたり、一つのスロットが物体の一部しか捉えなかったりする。これを part-whole 問題と呼ぶ。
- 入れ替わり。 同じスロットが、第 1 フレームでは緑の立方体を捉えていたのに、第 12 フレームでは別のものになっている。追跡から見れば、これは ID スイッチだ。
物体中心学習ではよく FG-ARI で評価する。この指標は各フレームのグルーピングの良し悪しだけを見るので、スロット同士が「所有権」を交換しても大きなペナルティにはならない。そのため、この二つの問題は長いあいだまともに取り上げられてこなかった。
問題を解く
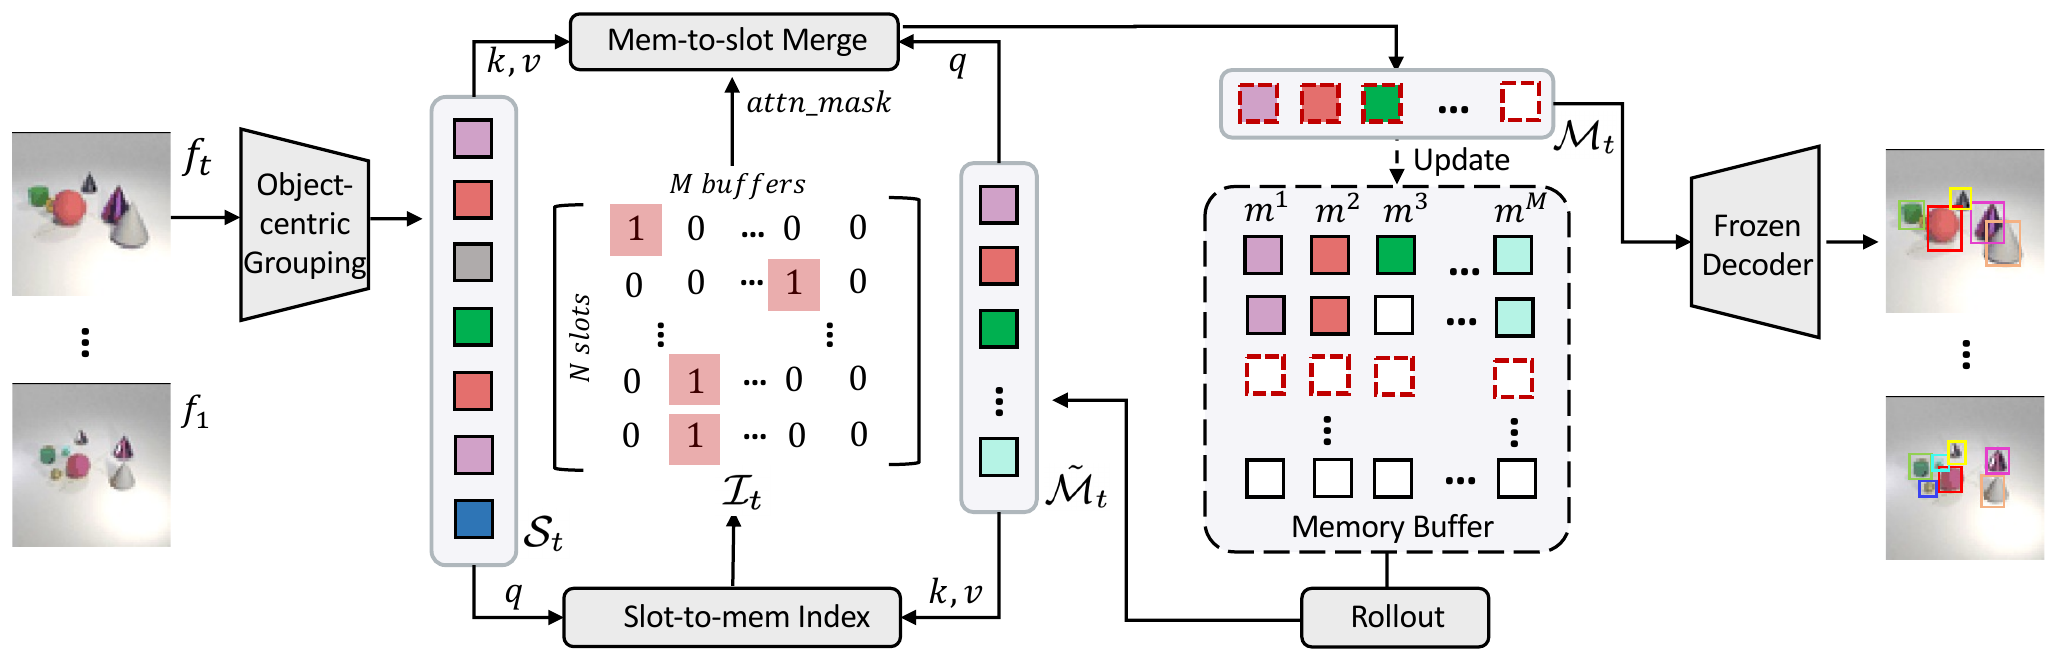
OC-MOT は物体中心モデルを検出器として扱って凍結し、その後ろにメモリモジュールをつなぐ。訓練するのはメモリモジュールだけだ。
メモリ:各バッファが一本の軌跡
メモリは 個のバッファからなり、各バッファは一つの物体の過去数フレームの表現を保存する。先入れ先出しで、最大 フレームまで保持する。見方を変えれば、各バッファは一本の軌跡そのものだ。
各フレームの処理の前に、パラメータが 160 万しかない小型の GPT-2 がすべてのバッファの履歴を読み込み、このフレームで各物体がどんな見た目になるはずかを予測する。このステップを rollout と呼ぶ。
rollout は物体の過去数フレームの姿を総合している。ある物体がこのフレームで半分隠れていても、rollout が予測するのは完全な姿のままだ。
インデックス:各スロットが自分の席を探す
次に、各スロットは自分がどのバッファに属するのかを探しに行く。
著者らはマルチヘッドアテンションを一つ使い、スロットをクエリ、rollout をキーとバリューにして、そのアテンションの重みを取り出し、 のインデックス行列 を得る。 行目は、 番目のスロットが各バッファに割り当てられる確率を表す。
重複したスロットも、一部しか捉えていないスロットも、同じバッファを指すことがあるが、同じ物体に属する断片はもともと同じ席に戻るべきものだ。
マージ:断片を組み立て直す
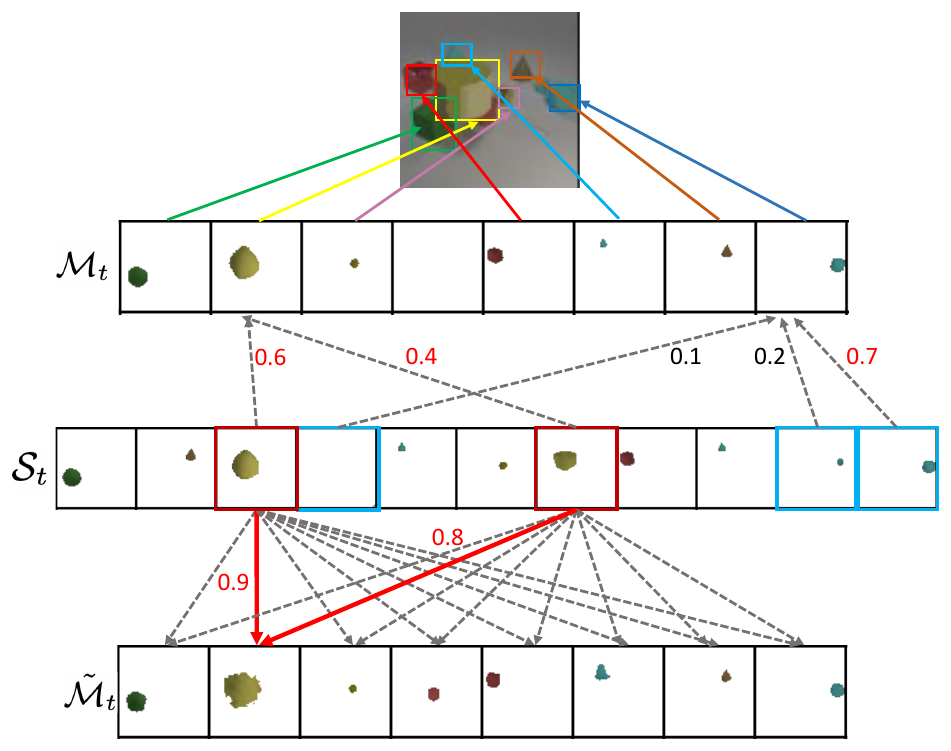
二つ目のマルチヘッドアテンションは向きが逆で、rollout をクエリ、スロットをキーとバリューにし、インデックス行列をマスクとして使う。各バッファは、自分に割り当てられたスロットしか見られない。
マスクをかけたあとに正規化し直した重みが、そのままマージの比率になる。論文が挙げる例では、三つのスロットのうち二つが同じバッファを指したとき、マージの重みは になりうる。二番目のスロットは割り当てられはしたものの、実際にはこの物体に属していないので重みが低く、取り除かれたも同然だ。
マージの結果はメモリに書き戻され、このフレームの追跡出力になる。
ID ラベルなしでどう訓練するか
訓練の目標は、各スロットを「自分に最も似ている」バッファに割り当てることだ。似ているかどうかは、凍結したデコーダで両者をマスクと画像にデコードして比べる。マスクの交差エントロピーで形を、物体再構成の二乗誤差で色を、表現ベクトルの距離で特徴を比べる。
難しいのはインデックスだ。各スロットは最終的に一つのバッファにしか割り当てられないので、素直に考えれば argmax を取ることになるが、argmax は微分できない。無理に straight-through のテクニックを使うと、今度はモデルが自分の選んだ一つしか見えなくなり、間違った割り当てにはまり込みやすい。
著者らは EM アルゴリズムの考え方を借りて、インデックス行列を確率とみなし、期待コストを最小化する。
例で違いを見てみよう。スロット一つ、バッファ二つで、それぞれとの照合コストは 0.2 と 1.0。現在のインデックスは で、割り当てを間違えている。
| やり方 | 損失 | 見える情報 |
|---|---|---|
| argmax を取る | 1.0 | バッファ 2 だけ |
| 期待コスト | 0.4 × 0.2 + 0.6 × 1.0 = 0.68 | 両方 |
本稿で整理した計算例。
期待コストのもとで、確率 0.1 をバッファ 2 からバッファ 1 に移すと、損失は 0.60 になり、0.08 減る。これはちょうど だ。勾配は自然に、確率をコストの低いほうへ押しやる。この過程全体で比べているのはスロットとメモリが似ているかどうかだけで、ID ラベルは一切使っていない。
推論のときになってはじめてインデックス行列を二値化し、各スロットを一つのバッファだけに割り当てる。最初のフレームではスロットでバッファを初期化し、互いのマスクが重なりすぎる重複スロットは先に取り除く。その後は、どの rollout とも重ならないスロットに新しいバッファを開く。物体が 5 フレームを超えて消えていたら、そこではじめてバッファを閉じる。
議論
二つのデータセット
実験には二つの合成データセットを使う。CATER は 3D の幾何物体がテーブルの上を動き回り、互いに遮蔽し合うもの。FISHBOWL は WebGL の水槽から収録したもので、訓練用の動画が 2 万本、検証・テスト用が 1,000 本あり、各本 128 フレーム。魚の群れによる遮蔽はもっとひどく、背景も複雑だ。
CATER での物体中心モデルは、アノテーションを一切使わない SAVi だ。FISHBOWL はもっと難しいので、著者らは DINOSAUR に少しだけ教師信号を加えた。128 フレームの動画ごとに、ランダムに 8 フレームのマスクをアノテーションする。つまり 6.25% だ。どちらにも ID アノテーションはない。
| 手法 | 検出ラベル | ID ラベル | IDF1 | MOTA | ID スイッチ |
|---|---|---|---|---|---|
| SAVi | 6.25% | — | 46.9 | 32.3 | 12,504 |
| SORT | 6.25% | — | 68.4 | 64.3 | 15,278 |
| IOU | 6.25% | — | 71.3 | 66.6 | 10,306 |
| Visual-Spatial | 6.25% | — | 74.6 | 68.1 | 8,754 |
| OC-MOT | 6.25% | — | 77.9 | 70.3 | 5,898 |
| MOTR | 100% | 100% | 81.6 | 79.8 | 4,185 |
原論文 Table 1 をもとに整理。FISHBOWL。
公平を期すため、SORT、IOU、Visual-Spatial は同じ物体中心モデルの出力を検出として使っている。OC-MOT の ID スイッチは教師なし手法の中で最も少なく、SORT より六割少ない。魚の動きは直線ではないので、カルマンフィルタも IoU もうまく追いきれない。
完全なアノテーションを使う MOTR と比べると、IDF1 はまだ 3.7、MOTA は 9.5 劣る。著者らは、差はおもに検出から来ていると考えている。DINOSAUR はごく低い解像度でマスクを予測するので、ボックスが十分に正確でない。
CATER での差はもっと小さい。アノテーションを一切使わない OC-MOT が IDF1 88.6、MOTA 82.4 で、MOTR は 89.3 と 83.3 だ。
FG-ARI では見えないこと
| 手法 | FG-ARI | IDF1 | Track mAP |
|---|---|---|---|
| SAVi | 90.2 | 72.3 | 42.8 |
| OC-MOT | 93.8 | 88.6 | 66.2 |
原論文 Table 2 をもとに整理。CATER。
SAVi の FG-ARI は 90.2 と高く、グルーピングはうまくいっているように見える。ところが動画全体でマッチングする Track mAP は 42.8 しかない。フレームごとにうまく分けられることと、動画全体をうまく追跡できることは、別の話だ。
メモリと二回のアテンション
| インデックスとマージ | メモリ | IDF1 | ID スイッチ |
|---|---|---|---|
| 内積類似度 | rollout | 72.0 | 22,050 |
| アテンション一つを共用 | rollout | 86.2 | 7,655 |
| アテンション二つ | 直前フレームのみ | 77.2 | 16,582 |
| アテンション二つ | rollout | 88.6 | 5,658 |
原論文 Table 3 をもとに整理。CATER。
rollout を外して直前フレームの結果だけをクエリにすると、ID スイッチは 5,658 から 16,582 へと、三倍近くに増える。遮蔽されているとき、直前フレームで見えているのは物体の半分だけだが、rollout なら完全な姿を組み立てられる。
メモリの長さも効いてくる。連続でサンプリングする場合、メモリは長いほどよく、6 フレームの IDF1 82.9 から 32 フレームの 88.4 まで上がる。ただメモリが長いほどハードウェアを食うので、著者らは速いサンプリングと遅いサンプリングを交互に織り交ぜるやり方に切り替え、6 フレームのメモリでも訓練中に長距離の動きや遮蔽の状況を見られるようにした。IDF1 は 88.6 に達し、32 フレームの連続サンプリングより高い。
限界
二つのデータセットはどちらも合成だ。著者らは同じグルーピングモジュールを実際の KITTI の街の映像に使ってみた。車は検出できるものの、マスクは粗く、遠くの車はとくに不正確だ。DINOSAUR の特徴解像度は元画像の 1/16 しかなく、これはアーキテクチャ上の制約だ。
論文は MOT17 での評価もしていない。著者らは付録で、MOT17 のスコアはおもに検出を反映するが、いまの物体中心モデルの検出能力は教師ありの検出器にまだ及ばないと説明している。検出器を SEEM に替え、TAO で同じ自己教師ありのやり方で関連付けを訓練してもみたが、載せているのは可視化した結果だけで、数字はない。
また、システム全体はエンドツーエンドで訓練されていない。物体中心モデルを先に訓練して凍結し、それからメモリモジュールを訓練する。
結論
OC-MOT が扱うのは、物体中心学習を追跡に使うときの二つの古い問題だ。分身したスロットはインデックスとマージで同じ物体に組み立て直す。入れ替わるスロットにはメモリと rollout で対処し、各物体の履歴を引き継いでいく。
最も注目すべき点は、関連付けの学習に ID ラベルがまったく要らないことだ。スロットとメモリが似ているかどうかを比べ、割り当てを期待コストとして書きさえすれば、勾配が各スロットを自分の席へと押し戻してくれる。
本当のボトルネックは前段の物体中心モデルにある。CATER では、OC-MOT はすでに完全なアノテーションを使う MOTR とほとんど差がなく、FISHBOWL ではまだ数ポイント及ばない。実際の街の映像になると、マスクの精度がまだ足りない。関連付けの部分は検出器を選ばないので、前段をもっと強いモデルに替えれば、そのままつなげられる。著者らが付録で SEEM に替えてみたのも、この方向を向いている。