原論文
Object-Centric Learning with Slot Attention
- 発表先
- NeurIPS 2020国際会議
- arXiv への初回投稿
- arXiv:2006.15055
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingslotattention2020,
  title = {{Object-Centric Learning with Slot Attention}},
  author = {Francesco Locatello and Dirk Weissenborn and Thomas Unterthiner and Aravindh Mahendran and Georg Heigold and Jakob Uszkoreit and Alexey Dosovitskiy and Thomas Kipf},
  year = {2020},
  eprint = {2006.15055},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2006.15055}
}
これは追跡の論文ではない。
このシリーズに出てくるのは、のちにこれを使って複数物体追跡をした人たちがいるからだ。その前に、これが何をしているのかを理解しておく必要がある。
2020 年、Google Brain のあるチームが Slot Attention を提案した。著者リストのうち、責任著者の Thomas Kipf は GCN の著者で、指導者の一人の Alexey Dosovitskiy は数か月後に ViT を発表した。同じ年、DETR は一組の物体クエリで検出を集合予測として書き直し、のちに TrackFormer と MOTR が物体クエリをトラッククエリに変えた。Slot Attention がやっていることは DETR といくらか似ているが、出発点はまったく違う。アノテーションを一切与えず、モデル自身に画面を一つひとつの物体に分けさせるのだ。
問題の定義
畳み込みネットワークが抽出する特徴マップは、「分散的」な表現だ。特徴マップ上の各位置には、その位置の近くにあるあらゆるものの情報が混ざっている。画像全体にいくつの物体があり、それぞれどこにあるのかは、はっきりとは分けられていない。
ところが推論を必要とする多くのタスクは、入力が一つひとつの物体の組であることを望む。たとえばここに赤い立方体が一つ、あそこに緑の円柱が一つ、というふうに。物理シミュレーション、マルチエージェント、視覚的推論は、どれも物体を単位として動いている。著者らはこうした表現を物体中心(object-centric)の表現と呼ぶ。
問題は、それを生の画像から得るのが難しいことだ。ふつうは教師あり学習か、特定のタスク向けに設計したアーキテクチャに頼ることになる。だから多くの研究は、この段階をいっそ飛ばして、シミュレータやゲームエンジンの中の物体の状態をそのまま使っている。
既存のやり方には、それぞれ難点がある。
- IODINE、MONet のような教師なしのシーン分解モデルは、「デコードし、元画像と比べ、またエンコードする」を何回も繰り返す必要があり、訓練がとても遅い。
- カプセルネットワークでは、各カプセルがある種類の物体に特化してしまい、見たことのない組み合わせになると汎化できない。
- DETR、Set Transformer のような集合予測の手法では、どのクエリにもそれ専用の学習可能なパラメータがある。訓練で 100 個のクエリを使ったら、テストでも 100 個にしかできない。
著者らが欲しかったのは、畳み込みネットワークの後ろにそのままつなげられるモジュールだ。 個の特徴ベクトルを入力し、 個の「slot」を出力して、各 slot が一つの物体を記述する。しかもどの slot も同じ形をしていて、どれでも任意の物体に結びつけられ、数もテスト時に変えられる。
問題を解く
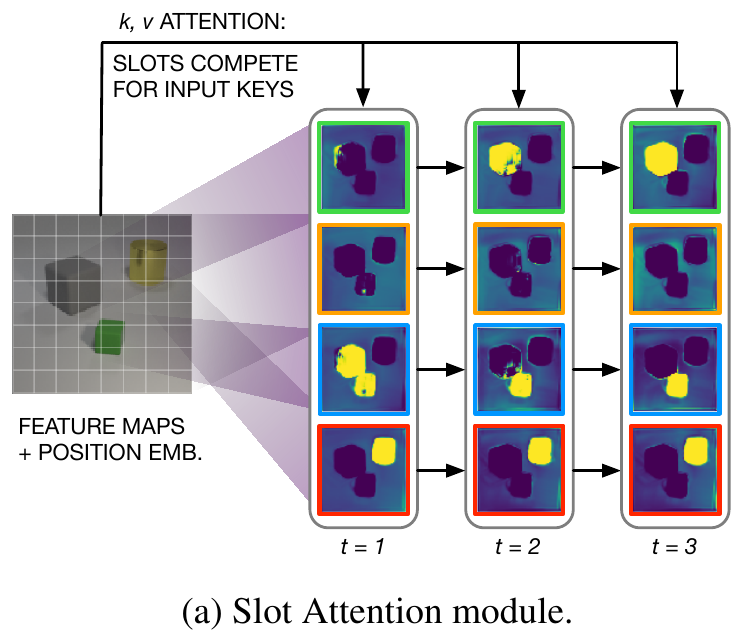
この図は左から右へ見る。左の特徴マップが入力で、右は四つの slot が三回の反復の中でそれぞれどこを見ているかだ。最初はどれもぼんやりと見ているが、後になるほど、各 slot は一つの物体に集中していく。
一回の反復
最初に、 個の slot を同じガウス分布からランダムにサンプリングする。
と はすべての slot が共有する学習可能なパラメータだ。slot の数をテスト時に変えられる理由はここにある。欲しい数だけサンプリングすればいい。
続いてこれを 回繰り返す(論文では )。各回ではまず三つの線形射影で、入力をキー とバリュー に、slot をクエリ に変え、ドット積アテンションのスコアを計算する。
ふつうのアテンションは、各クエリについて入力の方向に softmax をとる。Slot Attention は逆に、各入力について slot の方向に softmax をとる。
つまり、どの入力特徴も、自分の持ち分の 1 を 個の slot に分け与えなければならない。
次に、各 slot は割り当てられた入力の加重平均をとって、更新の内容にする。
最後に GRU で、前の回の slot を状態、この回の更新を入力として新しい slot を計算し、さらにオプションで残差 MLP をつなげる。入力と slot には、各回の最初にまず LayerNorm をかける。
実際に計算してみる
入力 4 個、slot 2 個でひと通りたどってみよう。計算したスコア が次のようだったとする。
| slot 1 | slot 2 | |
|---|---|---|
| 入力 1 | 2.0 | 0.0 |
| 入力 2 | 1.5 | 0.5 |
| 入力 3 | 0.0 | 1.8 |
| 入力 4 | 0.2 | 2.2 |
各行に softmax をかけると、各入力が自分を二つの slot に分け与える。
| slot 1 | slot 2 | |
|---|---|---|
| 入力 1 | 0.881 | 0.119 |
| 入力 2 | 0.731 | 0.269 |
| 入力 3 | 0.142 | 0.858 |
| 入力 4 | 0.119 | 0.881 |
slot 1 は主に入力 1、2 を、slot 2 は主に入力 3、4 を受け取る。さらに各列を正規化すると、slot 1 の加重平均の重みは 0.470、0.390、0.076、0.064、slot 2 は 0.056、0.126、0.403、0.414 になる。二つの slot は二つのクラスタ中心のように、それぞれ一群の入力を分け取った。
なぜ softmax を逆向きにとるのか。二つの slot がたまたま同じ形をしていて、クエリが同じで、スコアの二つの列がどちらも 2.0、1.5、0.0、0.2 だったとしよう。
- ふつうのアテンションで入力について softmax をとると、二つの slot はまったく同じ重み 0.524、0.318、0.071、0.087 を受け取り、どちらも入力 1、2 ばかり見つめて、入力 3、4 には誰も構わない。
- Slot Attention のやり方では、各入力は二つの slot の間で半分ずつに分かれ、それぞれ 0.5 を受け取る。どちらも相手の分を奪えず、入力 3、4 も必ず誰かに割り当てられる。
どの入力もいずれかの slot に割り当てられなければならないので、slot の間には競争が生まれる。ある slot が少し多く取ろうとすれば、ほかの slot は少し少なく取るしかない。GRU で更新して次の回に入ると、もとはごくわずかだった差が増幅され、最後にはそれぞれが一つの物体に狙いを定める。著者らは付録のアブレーションでもこれを確かめていて、softmax を入力についてとるように戻すと、二つのタスクのどちらでも成績がはっきり悪くなる。
では、なぜ加重和ではなく加重平均を使うのか。スコアは slot について正規化されているので、各 slot が受け取る総量は一定ではない。上の例では 1.873 と 2.127 で、物体を割り当てられなかった slot なら 0 に近づくこともある。加重和を使うと更新の大きさが大きくなったり小さくなったりし、平均を使ってこそ訓練が安定する。
モジュール全体の計算量は だ。
対称性
著者らは、Slot Attention に二つの性質があることを証明した。入力の順序に対して不変で、slot の順序に対して同変だ。入力を並べ替えても出力は変わらず、初期の slot の順序を並べ替えても、出力はそれに合わせて並べ替わるだけだ。
これによって、どの slot も同じ形式で物体を表すことが保証され、「1 番の slot は立方体の担当」といったことは起こらない。DETR の物体クエリは違っていて、どのクエリにもそれ専用のパラメータがあり、長く訓練するとそれぞれが特定の位置や大きさを好むようになりがちだ。
二通りの使い方
教師なしの物体発見。 Slot Attention をオートエンコーダに組み込む。エンコーダは畳み込みネットワークに位置埋め込みを加え、その後ろに Slot Attention をつなげたものだ。デコーダは各 slot をそれぞれ一枚の画像に展開し、RGB と一枚のマスクを出力する。すべての slot のマスクに slot の間で softmax をかけて混合の重みとし、それぞれの画像を一枚に合成して、元の画像との再構成誤差を比べる。この過程全体で、アノテーションは一切要らない。
教師ありの集合予測。 エンコーダは同じで、各 slot に共有の MLP をつなげて、物体の属性を予測する。予測とラベルの順序はどちらも任意なので、ハンガリアン法でマッチングする。DETR のやり方と同じだ。
議論
物体発見
著者らは三つの合成データセットで評価した。CLEVR6(物体が最大 6 個の CLEVR の立体シーン)、Multi-dSprites(色付きの 2D 図形)、Tetrominoes(テトリスのブロック)だ。指標は ARI で、セグメンテーションの結果が本当の物体とどれだけ一致しているかを、背景を除いて測る。100 が完璧だ。
| 手法 | CLEVR6 | Multi-dSprites | Tetrominoes |
|---|---|---|---|
| Slot Attention | 98.8 | 91.3 | 99.5 |
| IODINE | 98.8 | 76.7 | 99.2 |
| MONet | 96.2 | 90.4 | — |
| Slot MLP | 60.4 | 60.3 | 25.1 |
原論文 Table 1 をもとに整理。ARI(%)、五つの乱数シードの平均。Tetrominoes では失敗した訓練を一回除外。
Slot MLP は Slot Attention を MLP に置き換えたベースラインで、出力される slot には決まった順序がある。そのスコアはずっと低く、「どの slot も同じ形式で、任意の物体に結びつけられる」という設計が必要なことを示している。
Slot Attention は IODINE と並ぶか上回るが、本当の差は効率にある。CLEVR6 では、16 GB の V100 一枚でバッチサイズ 64 を使えるが、IODINE は 4 しか使えない。V100 8 枚で訓練するとおよそ 24 時間で、IODINE はおよそ 7 日かかる。
著者らは一つの失敗パターンも正直に打ち明けている。Tetrominoes では、ときどき訓練が画面を横縞に切り分ける解にはまり込むことがあり、五回に一回の割合だった。この場合は再構成誤差がはっきり高めになるので、訓練中に見分けられる。表のスコアはこの一回を除いている。
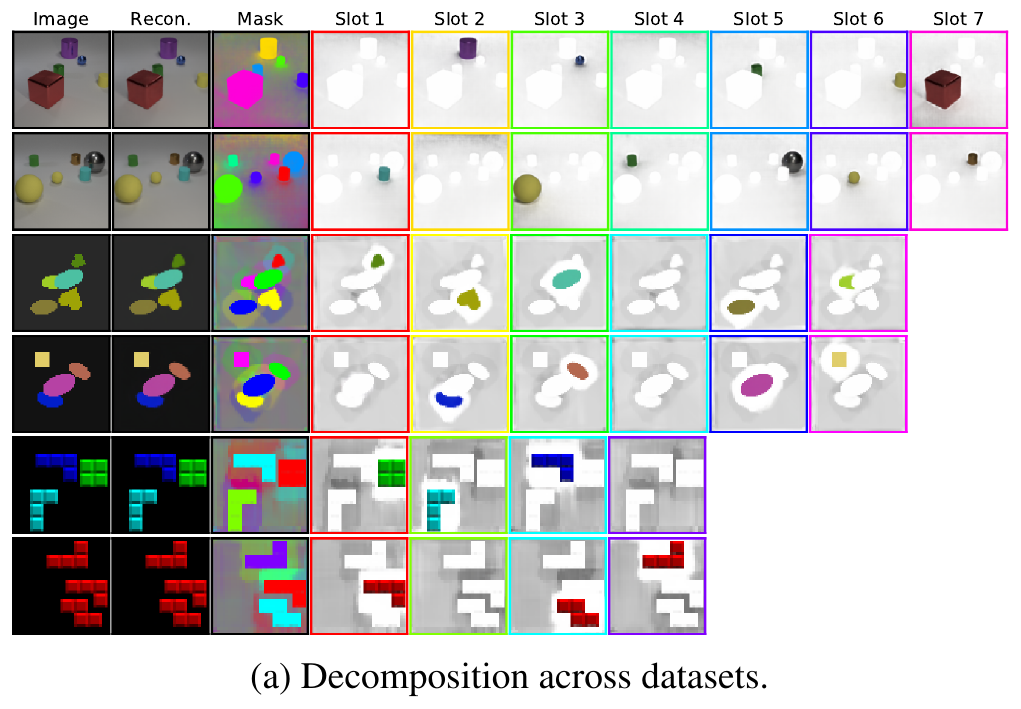
この図からわかるように、slot が物体より多いとき、余った slot は空白のままで、背景を少し受け取るだけだ。著者らはまた、一様な背景はしばしば一つの slot に集まらず、すべての slot に散らばることも観察している。これは物体の分離と再構成には影響しない。
各回の反復のアテンションを描いてみると、二回目にはもう各 slot が単一の物体に集中し始めていて、一回目ではまだいくつかの物体を同じ slot に混ぜている。
訓練より多い反復、多い物体
訓練では 3 回の反復を使い、テストで 7 回に増やすと、スコアはさらに上がり続ける。CLEVR6 で訓練し、物体が最大 10 個の CLEVR10 でテストするとき、slot を 7 個から 11 個に増やしても、セグメンテーションの成績は依然として良い。これこそ共有の初期分布がもたらす利点で、DETR のようにクエリごとにパラメータを持つ設計ではできない。
色だけでクラスタリングしているのではないことを確かめるため、著者らは形だけを見るバージョンも試した。黒地に白の二値化した Multi-dSprites では ARI が 69.4 で、IODINE は 64.8 だった。グレースケールの CLEVR6 では 98.5 だった。
集合予測
CLEVR10 で各物体の形、材質、色、大きさ、位置を予測し、AP で測る。Slot Attention は以前の DSPN と同等かそれ以上で、しかも DSPN が使っているのはより深い ResNet-34 のエンコーダだ。テスト時の反復回数を増やすことはここでも効果がある。物体 6 個のシーンで訓練し、物体がもっと多いシーンでテストしても、AP はゆっくりとしか下がらない。
このタスクではモデルに属性の予測しか訓練させておらず、セグメンテーションのアノテーションは一度も与えていないのに、slot のアテンションマップは自然に物体を分けていて、ARI は 78.0 に達した。
アブレーションと限界
付録のアブレーションでは、いくつもの設計が有用だと示された。加重平均は加重和より安定する。位置埋め込みは物体の位置の予測に欠かせない。すべての slot が初期分布を共有するほうが、slot ごとに一組のパラメータを持たせるより教師なしのタスクで良く、テスト時に slot を増やせるのもそのおかげだ。反復は少なくとも二回以上必要だ。slot の数はおおまかな上限を与えるだけでよく、物体の数とぴったり同じにする必要はない。
著者らは限界も説明している。すべての実験は管理された合成データで行われている。物体発見に使うデコーダと再構成損失は IODINE と同じで、複雑な背景やテクスチャに出会えば同じように苦労すると予想され、知覚損失や対照損失に替える必要があるかもしれない。
結論
Slot Attention は、アテンションの softmax を入力の側から slot の側へ移すというごく小さな変更で、同じ形をした一組の slot を互いに競わせ、最後にはそれぞれに画面の中の一つの物体を引き受けさせる。共有の初期分布と GRU による更新を加えると、アノテーションなしで合成シーンを物体に分解でき、訓練は IODINE より何倍も速く、slot の数と反復回数はどちらもテスト時に調整できる。
著者らが結論で今後の課題の筆頭に挙げたのは、これを動画に使うことだった。一年あまりのち、同じく Kipf らによる SAVi が slot を動画に拡張し、前のフレームの slot を次のフレームの初期値にして、同じ物体をフレームをまたいで同じ slot でつかめるようにした。こうなると、もうかなり追跡に近く聞こえる。
さらに一年あまりのち、この物体中心のやり方を、正式に複数物体追跡へ持ち込んだ人たちが現れた。