原始論文
Object-Centric Multiple Object Tracking
- 發表版本
- ICCV 2023會議
- arXiv 首次提交
- arXiv:2309.00233
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingocmot2023,
  title = {{Object-Centric Multiple Object Tracking}},
  author = {Zixu Zhao and Jiaze Wang and Max Horn and Yizhuo Ding and Tong He and Zechen Bai and Dominik Zietlow and Carl-Johann Simon-Gabriel and Bing Shuai and Zhuowen Tu and Thomas Brox and Bernt Schiele and Yanwei Fu and Francesco Locatello and Zheng Zhang and Tianjun Xiao},
  year = {2023},
  eprint = {2309.00233},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2309.00233}
}
1989 年,認知科學家 Zenon Pylyshyn 提出一個關於視覺空間感知的理論。他認為人的視覺系統裡有一小組「索引」,每個索引會黏在一個物體上;物體移動、和別的物體擦身而過、甚至被擋住一部分,索引都還黏著。
這聽起來很像多目標追蹤在做的事,也很像 Slot Attention 的 slot。
亞馬遜 AWS 的 Zixu Zhao、Tianjun Xiao 等人,加上 Slot Attention 的共同一作 Francesco Locatello,想試試看物件中心學習能不能直接拿來追蹤。如果可以,追蹤就不必再標那麼多框,更不必標每個框屬於誰。
定義問題
追蹤的標註很貴
主流的追蹤器先偵測、再關聯。偵測器要大量的框來訓練;關聯模組如果要學外觀特徵,還要知道哪些框是同一個人,也就是 ID 標註。
ID 標註比框更貴。標註員要看完整段影片,確認第 37 幀的這個人和第 512 幀的那個人是同一個。
物件中心學習走的是另一條路。Slot Attention 這類方法不需要任何標註,只靠重建畫面,就能把場景拆成一個一個的 slot,每個 slot 大致對應一個物體。SAVi 進一步把它延伸到影片,讓 slot 跨幀延續。
slot 會分身,也會換人
可是直接拿 SAVi 來追蹤,會遇到兩個問題。
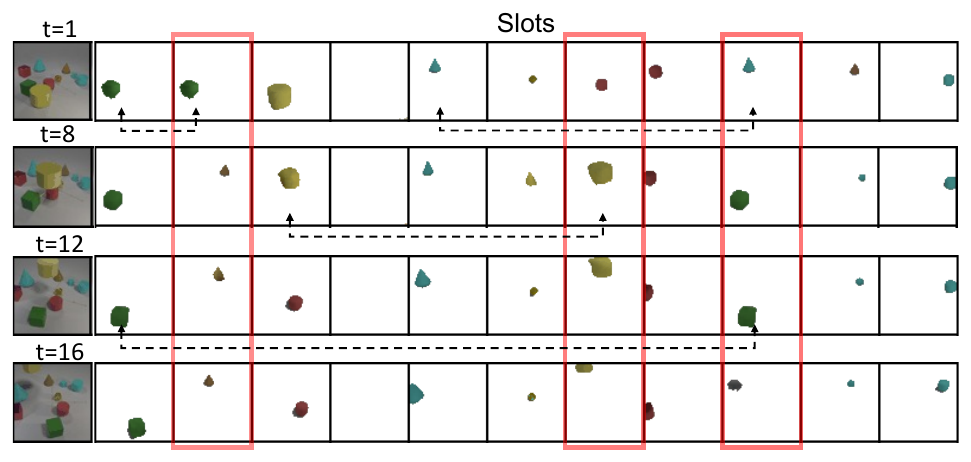
- 分身。 同一個物體被好幾個 slot 分著抓,或一個 slot 只抓到物體的一部分。這叫 part-whole 問題。
- 換人。 同一個 slot 在第 1 幀抓的是綠色方塊,到第 12 幀變成別的東西。對追蹤來說,這就是 ID 切換。
物件中心學習常用 FG-ARI 來評估,這個指標只看每一幀的分群好不好,slot 之間交換「所有權」並不會被嚴重懲罰。所以這兩個問題長期沒有被正視。
解決問題
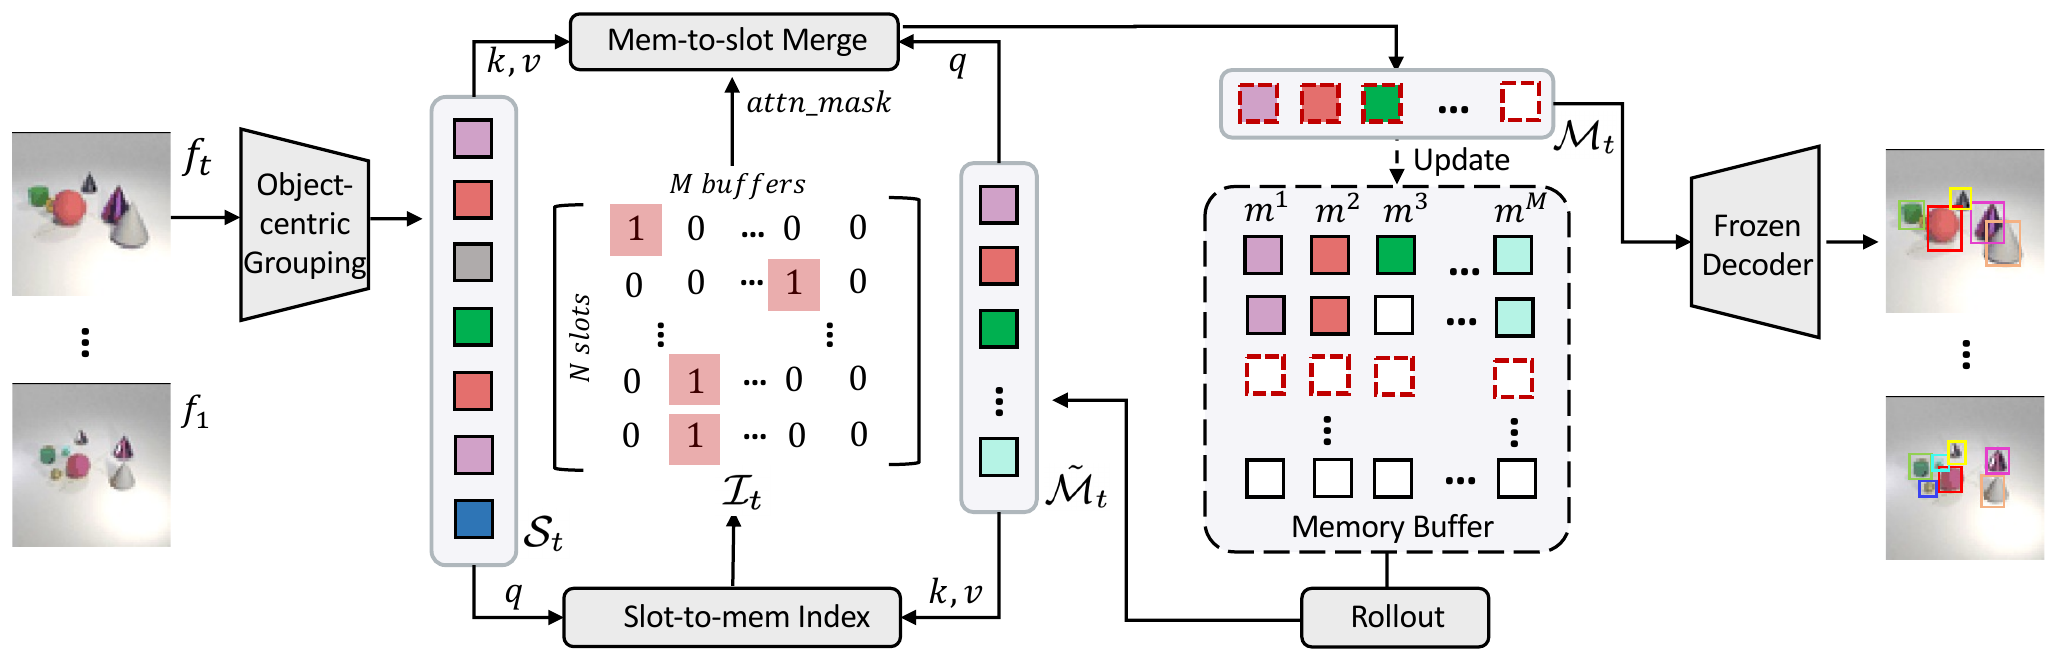
OC-MOT 把物件中心模型當作偵測器,凍結不動,在後面接一個記憶模組。要訓練的只有記憶模組。
記憶:每個緩衝區是一條軌跡
記憶由 個緩衝區組成,每個緩衝區存一個物體過去幾幀的表示,先進先出,最多保留 幀。換個角度看,每個緩衝區就是一條軌跡。
每一幀開始前,一個只有 160 萬參數的小型 GPT-2 讀入所有緩衝區的歷史,預測每個物體在這一幀應該長什麼樣子。這一步叫 rollout。
rollout 綜合了物體過去多幀的樣子。某個物體這一幀被擋住一半,rollout 預測出來的仍然是完整的它。
索引:每個 slot 找自己的座位
接著,每個 slot 要去找它屬於哪個緩衝區。
作者用一個多頭注意力,slot 當查詢、rollout 當鍵值,取出注意力權重,得到一個 的索引矩陣 。第 列表示第 個 slot 分到各個緩衝區的機率。
重複的 slot、只抓到一部分的 slot,都可能指到同一個緩衝區,屬於同一個物體的碎片本來就該回到同一個座位。
合併:把碎片拼回去
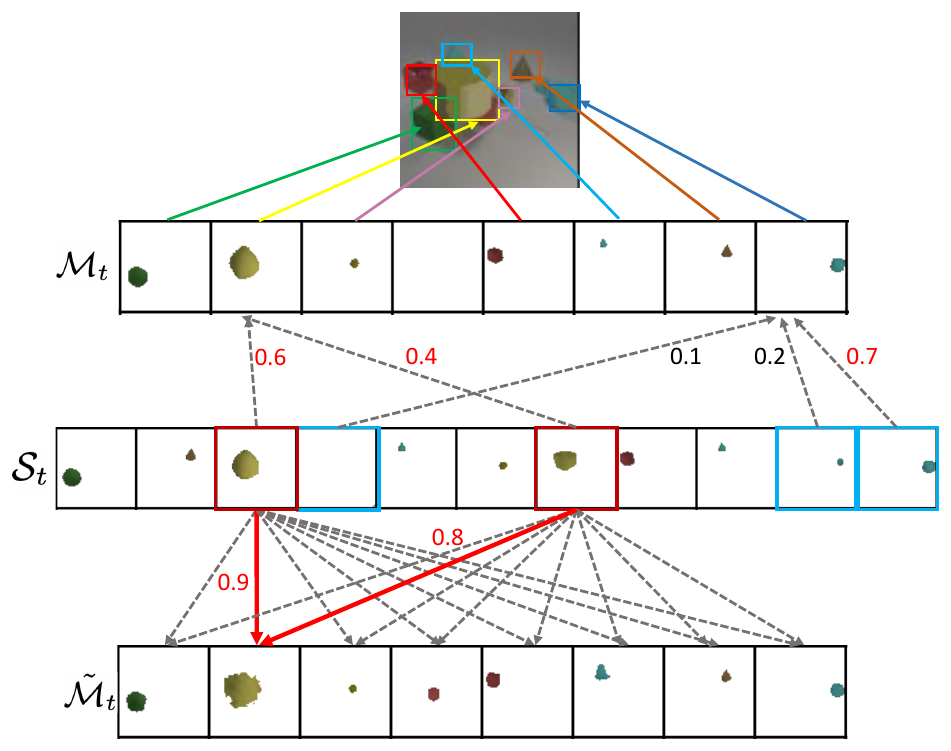
第二個多頭注意力反過來,rollout 當查詢、slot 當鍵值,並且用索引矩陣當遮罩:每個緩衝區只能看到分給它的那幾個 slot。
遮罩之後重新正規化的權重,就是合併的比例。論文舉的例子是,三個 slot 裡有兩個指到同一個緩衝區,合併權重可能是 。第二個 slot 雖然被分過來了,但它其實不屬於這個物體,權重很低,等於被濾掉。
合併的結果寫回記憶,成為這一幀的追蹤輸出。
不用 ID 標籤怎麼訓練
訓練的目標,是讓每個 slot 分到「最像它」的緩衝區。像不像,用凍結的解碼器把兩者解成遮罩和影像來比較:遮罩的交叉熵比形狀,物體重建的平方誤差比顏色,表示向量的距離比特徵。
難處在索引。每個 slot 最後只能分到一個緩衝區,直覺的做法是取 argmax,但 argmax 不能微分;硬用 straight-through 技巧,模型又只看得到它選的那一個,很容易卡在錯誤的指派上。
作者借用 EM 演算法的想法,把索引矩陣當成機率,最小化的是期望成本:
用一個例子看差別。一個 slot、兩個緩衝區,和兩者的比對成本分別是 0.2 和 1.0。目前的索引是 ,分錯了。
| 做法 | 損失 | 看得到的資訊 |
|---|---|---|
| 取 argmax | 1.0 | 只有緩衝區 2 |
| 期望成本 | 0.4 × 0.2 + 0.6 × 1.0 = 0.68 | 兩個都有 |
本文整理的算例。
在期望成本下,把 0.1 的機率從緩衝區 2 移到緩衝區 1,損失就變成 0.60,少了 0.08,正好是 。梯度自然會把機率往成本低的那邊推。整個過程只比較 slot 和記憶像不像,沒有用到任何 ID 標籤。
推論時才把索引矩陣二值化,每個 slot 只分到一個緩衝區。第一幀用 slot 初始化緩衝區,彼此遮罩重疊太多的重複 slot 先去掉;之後和所有 rollout 都不重疊的 slot,開一個新的緩衝區。物體消失超過 5 幀,緩衝區才關閉。
討論
兩個資料集
實驗用兩個合成資料集。CATER 是一堆 3D 幾何物體在桌上移動、互相遮擋;FISHBOWL 錄自 WebGL 水族箱,有 2 萬段訓練影片和 1,000 段驗證與測試影片,每段 128 幀,魚群遮擋得更嚴重,背景也更複雜。
CATER 上的物件中心模型是完全沒有標註的 SAVi。FISHBOWL 比較難,作者在 DINOSAUR 上加了一點監督:每段 128 幀的影片,隨機標 8 幀的遮罩,也就是 6.25%。兩邊都沒有 ID 標註。
| 方法 | 偵測標註 | ID 標註 | IDF1 | MOTA | ID 切換 |
|---|---|---|---|---|---|
| SAVi | 6.25% | — | 46.9 | 32.3 | 12,504 |
| SORT | 6.25% | — | 68.4 | 64.3 | 15,278 |
| IOU | 6.25% | — | 71.3 | 66.6 | 10,306 |
| Visual-Spatial | 6.25% | — | 74.6 | 68.1 | 8,754 |
| OC-MOT | 6.25% | — | 77.9 | 70.3 | 5,898 |
| MOTR | 100% | 100% | 81.6 | 79.8 | 4,185 |
整理自原論文 Table 1,FISHBOWL。
為了公平,SORT、IOU 和 Visual-Spatial 用的是同一個物件中心模型的輸出當偵測。OC-MOT 的 ID 切換是無監督方法裡最少的,比 SORT 少了六成。魚的運動不是直線,卡爾曼濾波和 IoU 都追不太上。
和完整標註的 MOTR 比,IDF1 還差 3.7,MOTA 差 9.5。作者認為差距主要來自偵測:DINOSAUR 在很低的解析度上預測遮罩,框不夠準。
CATER 上的差距更小。完全不用標註的 OC-MOT,IDF1 88.6、MOTA 82.4,MOTR 是 89.3 和 83.3。
FG-ARI 看不出來的事
| 方法 | FG-ARI | IDF1 | Track mAP |
|---|---|---|---|
| SAVi | 90.2 | 72.3 | 42.8 |
| OC-MOT | 93.8 | 88.6 | 66.2 |
整理自原論文 Table 2,CATER。
SAVi 的 FG-ARI 高達 90.2,看起來分群分得很好;可是用整段影片來匹配的 Track mAP 只有 42.8。每一幀分得好,和整段影片追得好,是兩件事。
記憶和兩次注意力
| 索引與合併 | 記憶 | IDF1 | ID 切換 |
|---|---|---|---|
| 內積相似度 | rollout | 72.0 | 22,050 |
| 共用一個注意力 | rollout | 86.2 | 7,655 |
| 兩個注意力 | 只用上一幀 | 77.2 | 16,582 |
| 兩個注意力 | rollout | 88.6 | 5,658 |
整理自原論文 Table 3,CATER。
拿掉 rollout、只用上一幀的結果當查詢,ID 切換從 5,658 增加到 16,582,將近三倍。遮擋的時候,上一幀看到的只是半個物體,rollout 則能拼出完整的它。
記憶的長度也有影響。連續取樣時,記憶越長越好,從 6 幀的 IDF1 82.9 到 32 幀的 88.4。但記憶越長越吃硬體,作者改用快慢交錯的取樣,讓 6 幀的記憶在訓練時也能看到長距離和遮擋的情況,IDF1 達到 88.6,比 32 幀的連續取樣還高。
限制
兩個資料集都是合成的。作者把同一套分群模組用在真實的 KITTI 街景上,車子偵測得到,遮罩卻很粗糙,遠處的車尤其不準。DINOSAUR 的特徵解析度只有原圖的 1/16,這是架構上的限制。
論文也沒有在 MOT17 上評估。作者在附錄解釋,MOT17 的分數主要反映偵測,目前的物件中心模型偵測能力還比不上有監督的偵測器。他們試著把偵測器換成 SEEM,在 TAO 上用同樣的自監督方式訓練關聯,但只放了視覺化的結果,沒有數字。
另外,整個系統不是端到端訓練的。物件中心模型先訓練好、凍結,再訓練記憶模組。
結論
OC-MOT 處理的是物件中心學習在追蹤上的兩個老問題。分身的 slot 透過索引和合併拼回同一個物體;換人的 slot 則靠記憶和 rollout,把每個物體的歷史延續下去。
它最值得注意的地方,是關聯的學習完全不需要 ID 標籤。只要比較 slot 和記憶像不像,把指派寫成期望成本,梯度就會把每個 slot 推回自己的座位。
真正的瓶頸在前端的物件中心模型。在 CATER 上,OC-MOT 已經和完整標註的 MOTR 相差無幾,FISHBOWL 還差幾分;到了真實街景,遮罩的精度還不夠。關聯的部分不挑偵測器,前端換成更強的模型就能直接接上,作者在附錄換上 SEEM 的嘗試也是朝這個方向。