原論文
MOTR: End-to-End Multiple-Object Tracking with Transformer
- 発表先
- ECCV 2022国際会議
- arXiv への初回投稿
- arXiv:2105.03247
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingmotr2021,
  title = {{MOTR: End-to-End Multiple-Object Tracking with Transformer}},
  author = {Fangao Zeng and Bin Dong and Yuang Zhang and Tiancai Wang and Xiangyu Zhang and Yichen Wei},
  year = {2021},
  eprint = {2105.03247},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2105.03247}
}
これまで読んできたトラッカーは、どれだけ深層学習を使っていても、最後には手書きの関連付けの段階がある。
SORT は IoU とハンガリアン法を使い、DeepSORT は外観距離とマッチングカスケードを加え、FairMOT は二段階のマッチングを引き継ぎ、CenterTrack は変位から逆算してから貪欲マッチングを行う。運動はカルマンフィルタか学習した変位に頼り、外観は re-ID 特徴に頼る。両者をどう組み合わせるか、しきい値をいくつにするかは、すべて人が決めている。この後処理が間に立ちはだかっているので、時間方向の情報はエンドツーエンドで流れていけない。
2020 年、DETR は物体検出を集合予測として書き直した。学習可能な物体クエリ(object query)の組が画像特徴とやり取りし、各クエリがボックスを一つ出力する。それを二部グラフマッチングで正解ボックスと一対一に対応させる。非最大値抑制すら要らない。
検出が後処理なしで済むなら、追跡はどうだろうか?
曠視(MEGVII)と上海交通大学の Fangao Zeng、Bin Dong、Yuang Zhang、Tiancai Wang らは MOTR を提案し、最初から最後まで手書きのマッチングを一切必要としないトラッカーを目指した。
問題の定義
著者らは機械翻訳から着想を得た。翻訳モデルは一つの隠れ状態で現在の文脈を表し、デコーダはこの状態と入力特徴を繰り返しやり取りさせて、訳語を一つずつ出力する。
複数物体追跡も似た問題として見ることができる。出力は系列の組で、各系列が一つの物体の軌跡だ。各軌跡にも隠れ状態があり、一フレームずつ画像特徴とやり取りして一フレームずつボックスを出力するなら、ID は自然とこの隠れ状態についていき、改めてマッチングする必要がない。
MOTR は DETR の物体クエリをトラッククエリ(track query)に拡張し、軌跡の隠れ状態として使う。そのためには、先に二つの問題を解かなければならない。
- 一つのクエリが同じ物体を追い続けるにはどうするか? DETR の物体クエリは、フレームごとに画面内のどの物体に割り当てられてもおかしくなく、身元という概念がない。
- 新しく現れた物体や去っていく物体はどうするか? 画面内の物体の数は絶えず変わるので、トラッククエリの数もそれに合わせて変わらなければならない。
問題を解く
二種類のクエリ
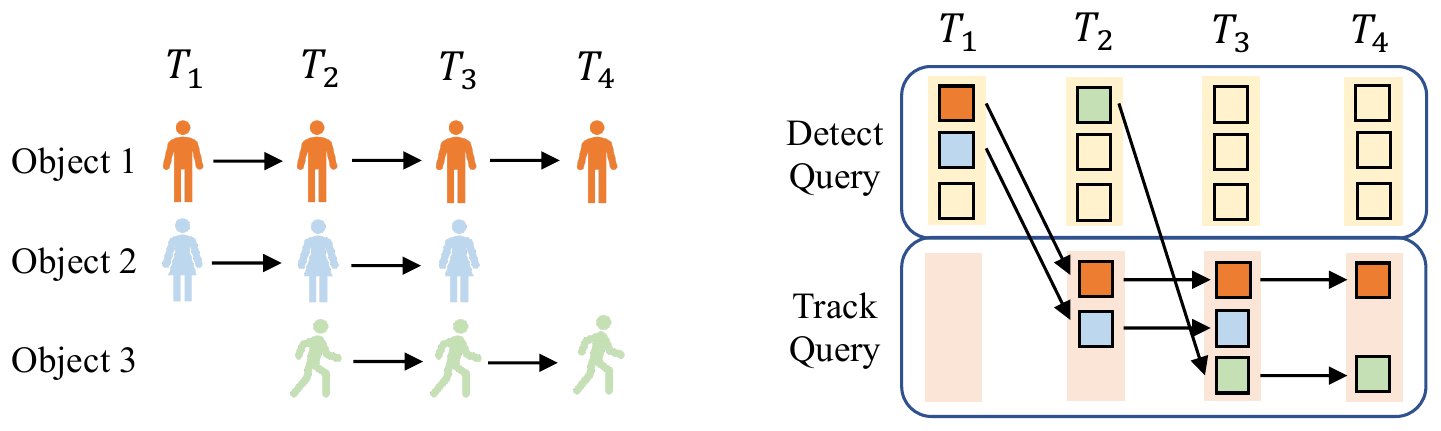
MOTR はクエリを二種類に分ける。この図に沿って一通りたどってみよう。
- 検出クエリ(detect query): DETR にもともとある、数が固定された学習可能な物体クエリの組で、どのフレームでも同じだ。これらは新しく現れた物体を見つけることだけを担う。
- トラッククエリ(track query): 数が可変のクエリの組で、一つひとつが、すでに追跡している軌跡を一本ずつ表す。
T1: 最初はまだ軌跡がなく、トラッククエリは空だ。デコーダに送られるのは検出クエリだけで、そのうち二つが物体 1 と物体 2 を見つけた。
T2: 物体 1、2 を見つけた二つのクエリの、デコーダを通った後の隠れ状態が、次のフレームのトラッククエリになる。T2 でのデコーダの入力は「二つのトラッククエリ + 検出クエリの組」だ。二つのトラッククエリはそれぞれ物体 1、2 の新しいボックスを出力し、ID は変わらない。検出クエリのうち一つが、新しく現れた物体 3 を見つけた。
T3: 物体 3 の隠れ状態もトラッククエリに加わり、トラッククエリは三つになった。
T4: 物体 2 が去り、そのトラッククエリは集合から削除される。
この過程全体を通じて、各トラッククエリは生まれてから削除されるまで、ただ一つの物体だけを表す。追跡の結果は、同じトラッククエリが各フレームで出力したボックスをつなげたものだ。
ラベルをどう割り当てるか
訓練時、DETR は二部グラフマッチングで、各クエリがどの正解物体を担当するかを決める。MOTR はこれを「軌跡を考慮したラベル割り当て」(Tracklet-Aware Label Assignment, TALA)に改め、二種類のクエリを別々に扱う。
- 検出クエリ: そのフレームで新しく現れた物体とだけ二部グラフマッチングを行う。
- トラッククエリ: マッチングに参加せず、前のフレームの割り当てをそのまま引き継ぐ。前のフレームで物体 1 を担当していたクエリは、このフレームでも物体 1 を担当する。
式で書くと、第 フレームのトラッククエリの割り当て は、前のフレームのトラッククエリの割り当てに、前のフレームの新しい物体の割り当てを加えたものになる。
推論時にはラベルがない。検出クエリは、すでに追跡している物体を探しに行かないよう、どうやって知るのか? 二種類のクエリは一緒にデコーダに送られ、自己注意が、追跡済みの物体を見つけた検出クエリのスコアを押し下げる。DETR が NMS なしでも重複したボックスを出力しないのと同じ理屈だ。
全体のアーキテクチャ
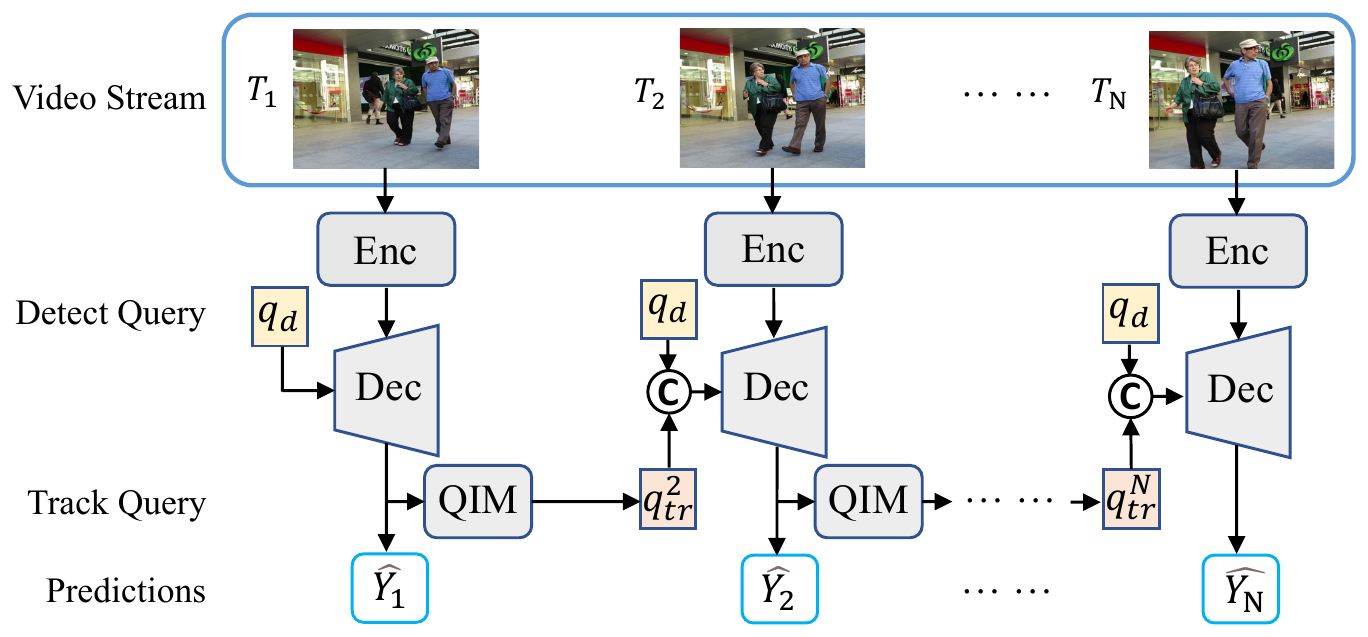
バックボーンは ResNet-50、検出の枠組みは Deformable DETR だ。各フレームはバックボーンと Transformer エンコーダを通って特徴になる。デコーダの入力は前のフレームのトラッククエリと検出クエリを連結したもので、出力された隠れ状態は、一方でボックスとクラスの予測に使われ、もう一方でクエリ相互作用モジュール(Query Interaction Module, QIM)に送られて、次のフレームのトラッククエリを生成する。
QIM は二つのことを担う。
物体の出入り。 訓練時は、ある物体が正解アノテーションから消えるか、予測ボックスと正解ボックスの IoU が 0.5 を下回ると、その隠れ状態は捨てられる。新しい物体は、検出クエリのマッチング結果に従って残される。推論時は代わりに分類スコアを使う。検出クエリのスコアが入場しきい値 を上回ってはじめて新しい軌跡になり、トラッククエリのスコアが フレーム連続で退場しきい値 を下回ってはじめて削除される。
時間集約ネットワーク(Temporal Aggregation Network, TAN)。Transformer のデコーダ層を一層だけ改造したものだ。追跡中の各物体について、前のフレームのトラッククエリとこのフレームの隠れ状態を足し合わせたものをマルチヘッド自己注意の query と key にし、このフレームの隠れ状態を value にして、さらにフィードフォワードネットワークに通す。これでトラッククエリには、過去の情報を持ち込む近道ができる。TAN の出力は新しい物体の隠れ状態と連結され、次のフレームのトラッククエリになる。
動画クリップ全体で損失を計算する
カルマンフィルタの等速度の仮定は人が書いたものだ。MOTR の運動モデルはデータから学ぶ。しかし隣り合う二フレームだけで訓練すると、ネットワークにはごく短い運動しか見えず、遮蔽の後に再び現れるといった長い時間にわたる変化を学べない。
著者らは集団平均損失(Collective Average Loss, CAL)を提案した。訓練時には一度に動画のクリップを一つ入力し、各フレームの予測を集めてクリップ全体の損失を計算したあと、クリップ全体の正解物体の総数で割る。
は第 フレームの正解物体の数だ。フレーム単位の損失 は DETR と同じく、focal loss、L1 損失、GIoU 損失の重み付き和である。
クリップの長さは 2 フレームから始め、訓練の途中で 3、4、5 フレームへと段階的に増やす。著者らによると、この段階的な増加は訓練の効率と安定性を高める。
いくつかの訓練の工夫
実際の動画では、新しい物体が現れたり古い物体が去ったりする場面はあまり多くない。著者らは二つのランダムな操作で、より多くのサンプルを作った。
- 確率 で一部のトラッククエリをランダムに消し、検出クエリに「新しい物体を見つける」練習の機会を与える。
- 確率 で誤検出のクエリをトラッククエリに差し込み、モデルに「存在しない物体を退場させる」練習をさせる。
さらに、訓練クリップのフレームは連続して取るのではなく、ランダムな間隔でサンプリングし、さまざまなフレームレートや大きな運動を模擬する。
同時期の TransTrack や TrackFormer と比べて、著者らは MOTR が後処理をまったく必要としない点を強調している。TransTrack は隣り合う二フレームで対になった短い軌跡を検出し、それを IoU マッチングでつないで長い軌跡にする。TrackFormer にもトラッククエリの発想はあるが、隣り合う二フレームの間でしか学習せず、重複した軌跡を除くために軌跡の NMS と re-ID 特徴がまだ必要だ。著者らはさらに、この研究は TrackFormer と TransTrack が arXiv に投稿される前から独自に始めていたと、わざわざ断っている。
議論
MOTR は 8 枚の V100 で訓練し、各バッチは 5 フレームのクリップ一つだ。MOT17 では 200 epoch 訓練し、データは MOT17 訓練セットに CrowdHuman 検証セットの静止画約 5000 枚を加えたもの(CenterTrack のランダムシフトを流用して疑似クリップを作る)。入力画像は短辺を 800 に縮小し、推論速度は V100 で約 7.5 FPS だ。
MOT17:気まずい結果
MOT17 テストセットで、MOTR の HOTA は 57.8、IDF1 は 68.6、MOTA は 73.4、ID スイッチは 2439 だった。
同じ Transformer 系の手法と比べると、IDF1 は TransTrack と TrackFormer のどちらよりも 4.7 高い。HOTA は TransTrack より 3.7 高く、MOTA は TrackFormer の 65.0 よりずっと高い。ただし TransTrack の MOTA(74.5)は MOTR より高い。著者らは、TransTrack は検出と追跡を二つのブランチに分けているので検出の性能が良く、MOTR の検出クエリはトラッククエリに抑え込まれて新しい物体の検出が制限されると推測している。
CNN 系の手法と比べると、さらに気まずい。ByteTrack は HOTA 63.1、MOTA 80.3、IDF1 77.3 で、MOTR はすべての項目で負けている。著者らは論文の中で、そのものずばり「frustratingly inferior」と表現した。彼らの説明では、MOT17 の成績はおもに検出の質で決まり、各手法が使う検出器も違うので、運動のモデル化の能力を公平に比べるのは難しい。だから MOT17 だけでは MOTR を十分に評価できないという。
DanceTrack:ホームグラウンド
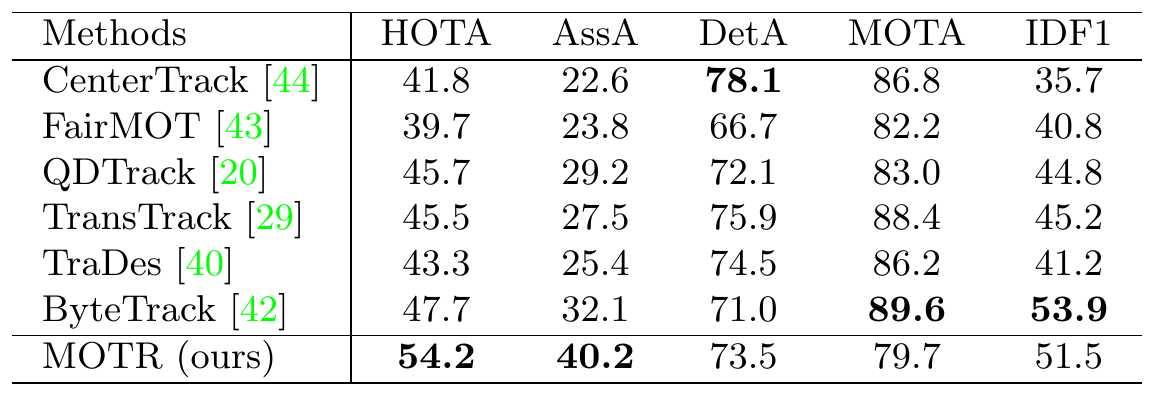
DanceTrack はダンスの場面のデータセットで、ダンサーは似た服を着て、複雑な動きをし、互いに頻繁に交差する。検出は難しくなく、難しいのは関連付けだ。
ここでの MOTR の HOTA は 54.2 で、ByteTrack の 47.7 より 6.5 高い。AssA は 40.2 対 32.1 で、8.1 高い。ただし DetA の 73.5 は CenterTrack の 78.1 や TransTrack の 75.9 より低く、MOTA の 79.7 にいたっては表全体で最も低い。
この表は MOTR の強みと弱みをはっきり並べて見せている。AssA が高いのは、トラッククエリがフレームをまたいで身元を保つことを確かに学んだからだ。DetA と MOTA が低いのは、物体を見つける能力がほかの手法に及ばないからだ。これは前の HOTA のノートで話した、HOTA を見るときはついでに DetA と AssA も見るべきだという点にちょうど重なる。
複数クラスの BDD100K 検証セットでは、MOTR の mMOTA は 32.0、ID スイッチは 3493 で、ベースライン手法の 8315 よりずっと少ない。著者らは、re-ID 中心の手法はクラスや物体の数が多い状況を扱いにくいが、MOTR なら分類ヘッドのクラス数を変えるだけで複数クラスの追跡を扱えると考えている。
アブレーション:各設計はどれだけ効くか
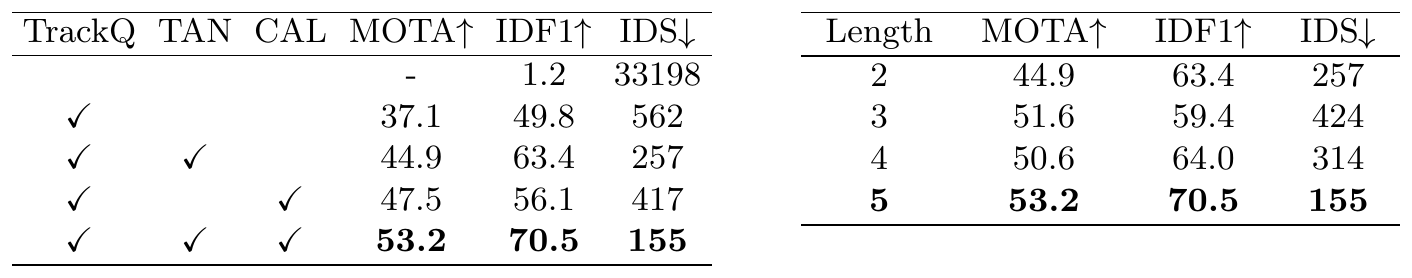
アブレーション実験は MOT17 訓練セットで訓練し、MOT15 訓練セットで検証している。
左の表はいちばん素朴な版から始まる。物体クエリだけでトラッククエリがないと、各フレームの物体はすべて新しい物体として扱われ、ID スイッチは 33198 回にのぼり、IDF1 はわずか 1.2 だ。トラッククエリを加えると、IDF1 は 49.8 に上がり、ID スイッチは 562 に下がる。トラッククエリそれ自体で、追跡が成り立つようになった。
TAN と CAL はそれぞれ単独でも効く。TAN だけを加えると MOTA が 7.8、IDF1 が 13.6 上がり、CAL だけを加えると MOTA が 10.4 上がる。両方を加えると、MOTA 53.2、IDF1 70.5、ID スイッチ 155 になる。
右の表は CAL のクリップ長だ。2 フレームから 5 フレームに増やすと、MOTA は 44.9 から 53.2 に、IDF1 は 63.4 から 70.5 に上がり、ID スイッチは 257 から 155 に下がる。途中の推移は滑らかではなく、長さ 3 では IDF1 がいったん 59.4 に下がり、ID スイッチも 424 に増えるが、最も長い 5 フレームが三つの指標すべてで最良だ。著者らの観察では、複数フレームの CAL によって、遮蔽場面での重複ボックス、ID スイッチ、検出漏れがはっきり減った。
訓練の工夫についてのアブレーションもいくつかある。トラッククエリをランダムに消す確率 は 0.1 のときが最良だ。誤検出のクエリを差し込む確率 は 0.3 のとき MOTA が最も高いが、IDF1 は 0.1 からずっと下がり続ける。訓練時のランダムなサンプリング間隔は 10 が最良で、ID スイッチは 155。間隔 3 と 5 ではそれぞれ 218 と 324 で、間隔 12 ではまたやや悪くなる。著者らは、間隔が小さすぎると局所最適に陥りやすく、大きすぎるとそこまで長い距離の変化を学べないと考えている。
著者ら自身が認める限界
著者らは論文の最後に限界を二つ挙げている。一つ目は、新しい物体を検出する能力が理想にはほど遠く、MOTA が十分でないこと。検出クエリが抑え込まれて追跡済みの物体を探しに行かないことは、物体クエリの本来の性質に反しているかもしれず、新しい物体の検出も制限している。二つ目は、クエリがフレームからフレームへ順に受け渡されるので、訓練の効率が制限されること。VisTR のような並列デコードも試したが、複数物体追跡の複雑な状況には対処できなかった。
その後
一つ目の限界には、すぐに答えが出た。一年あまり後、同じチームが MOTRv2 を発表し、事前学習済みの YOLOX の検出結果をアンカー型のクエリとして MOTR に送り込んだ。検出は専用の検出器に任せ、MOTR は関連付けに専念する。エンドツーエンドの追跡と検出の衝突は、その後この路線で繰り返し議論されるテーマにもなり、MeMOTR や MOTIP などの後続手法はどれも MOTR 系列を比較対象にしている。
ByteTrack は別の方向から、MOT17 での MOTR の立場を裏づけた。同じ MOT17 で、良い検出器に丁寧に設計したマッチングのルールを組み合わせるだけで、MOTR には出せないスコアが出せる。
結論
DETR の物体クエリを、物体についていくトラッククエリに拡張し、TALA でラベルを割り当て、QIM で出入りと時間方向の集約を扱い、動画クリップ全体の集団平均損失で訓練する。MOTR は最初から最後まで手書きのマッチングのルールを一切必要とせず、関連付けの難しい DanceTrack では HOTA で ByteTrack を 6.5 上回った。
その代償は DetA と MOTA の二つの列に出ている。トラッククエリと検出クエリが同じデコーダにひしめいているので、新しい物体が見つかりにくい。検出がスコアを左右する MOT17 では、ずっと単純な ByteTrack に負けた。
論文に出てくるあの「frustratingly inferior」は、たぶんこのシリーズの論文の中でいちばん正直な一言だ。