原論文
Towards Real-Time Multi-Object Tracking
- 発表先
- ECCV 2020国際会議
- arXiv への初回投稿
- arXiv:1909.12605
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingjde2019,
  title = {{Towards Real-Time Multi-Object Tracking}},
  author = {Zhongdao Wang and Liang Zheng and Yixuan Liu and Yali Li and Shengjin Wang},
  year = {2019},
  eprint = {1909.12605},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1909.12605}
}
DeepSORT、POI、MOTDT の世代のトラッカーは、どれもやり方がよく似ている。まず検出器を走らせ、次に各検出ボックスを切り出して、別の re-ID ネットワークに送って外観特徴を取り出す。
ネットワークを二つそれぞれ走らせるので、時間は両者の合計になる。画面に人が多いほど走らせる re-ID も増え、システム全体が遅くなる。
多くの論文が「リアルタイム追跡」をうたっているが、よく見ると、計時しているのは関連付けのステップだけで、検出器と re-ID の時間が入っていないことが多い。関連付けはリアルタイムでも、追跡システム全体はそうではない。
清華大学の Zhongdao Wang とオーストラリア国立大学の Liang Zheng らは、本当にリアルタイムで動くシステムを作ろうとした。検出器についでに人も見分けさせる。同じネットワークの一回の順伝播で、検出ボックスと各ボックスの外観特徴を同時に出力する。彼らはこのやり方を JDE(Joint Detection and Embedding)と呼んだ。
問題の定義
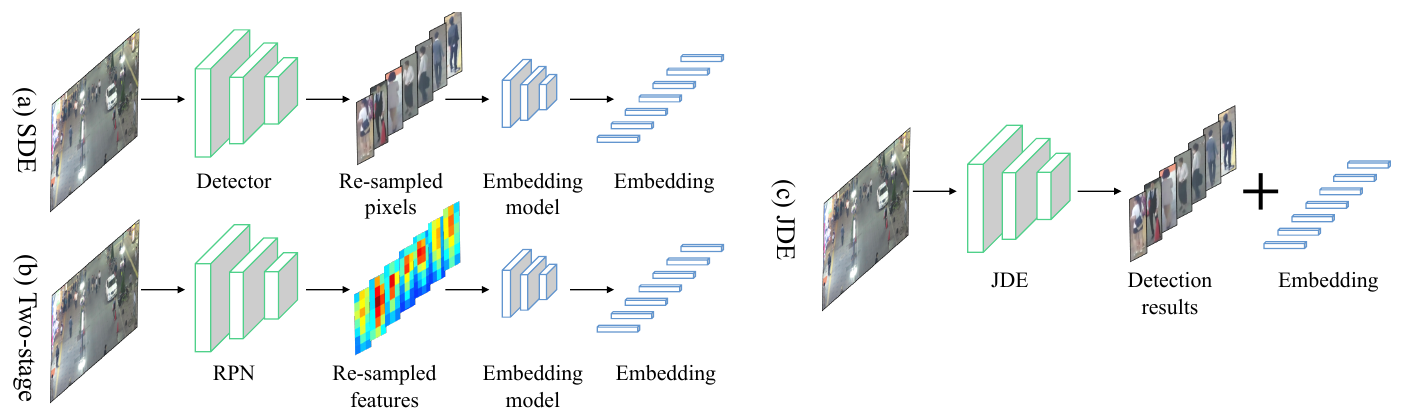
著者らは当時のやり方を三つに分類している。
- (a) 検出と埋め込みを分ける方式(Separate Detection and Embedding, SDE): DeepSORT も POI もこれにあたる。検出器と re-ID モデルが完全に独立していて、re-ID の計算量は人数に比例する。
- (b) 二段階モデル: Faster R-CNN の第二段階を、外観特徴を学ぶように変えたもの。第一段階の RPN はそのままボックスを出力し、第二段階は特徴マップから各ボックスの特徴を取り出して、距離学習で訓練する。計算の一部を共有できるが、二段階の設計そのものが遅く、たいてい毎秒 10 フレームに届かない。しかも第二段階の時間は、やはり人数とともに増える。
- (c) JDE: 一段階の検出器に出力を一つ追加するだけで、一回の順伝播でボックスと特徴が得られる。
(c) を実現するには、目的が大きく異なる二つのタスクを、同じネットワークの中で一緒にうまく学ばせなければならない。著者らは、訓練データ、ネットワーク構成、損失関数、マルチタスクの重み、評価方法の五つの面から一つずつ取り組んだ。
問題を解く
ネットワーク構成
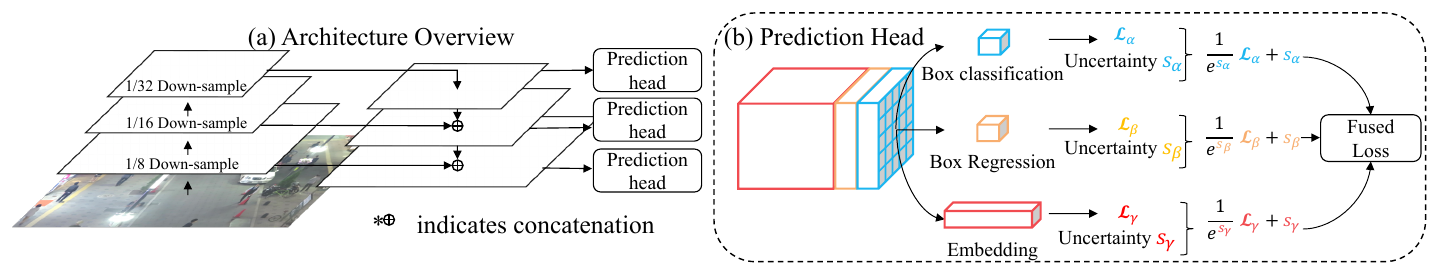
バックボーンは YOLOv3 が使う DarkNet-53 で、特徴ピラミッドネットワーク(FPN)をつなぎ、入力の 1/32、1/16、1/8 の三つのスケールで予測する。歩行者は遠近によって大きさがかなり違うので、マルチスケールの予測は検出に役立つ。
各スケールには予測ヘッドが一つつき、大きさ の密な予測マップを出力する。 はそのスケールのアンカーボックスの数、 は埋め込み特徴の次元だ。このマップは三つに分かれる。
- ボックス分類: 。各アンカーボックスが前景か背景か。
- ボックス回帰: 。各アンカーボックスの四つの補正量。
- 埋め込みマップ: 。位置ごとに 次元の外観特徴が一つ。
デフォルトの入力 で形を計算してみよう。三つのスケールの特徴マップは、それぞれ 、、 になる。論文には の値が書かれていないが、FairMOT の実験では JDE は 512 次元を使っている。各スケールで なので、各予測ヘッドの出力チャネル数は になり、最も細かい層は のテンソルになる。
あるアンカーボックスが前景と判定されたら、埋め込みマップの同じ位置にある 512 次元のベクトルを取り出し、そのボックスの外観特徴とする。検出と外観特徴は一緒に計算されるので、画面に人が一人増えても、計算量はほとんど変わらない。
検出の分岐:歩行者向けにアンカーボックスを調整する
検出の分岐はおおむね RPN と同じだが、二つの変更が加えられている。
- アンカーボックスは歩行者専用に設計されている。 すべてのアンカーボックスのアスペクト比は 1:3 で、大きさは全部で 12 種類、各スケールに 4 種類ずつ割り振られ、幅は から ピクセルまである。
- 前景と背景のしきい値。 真のボックスとの IoU が 0.5 を超えれば前景で、これは一般の物体検出と同じだ。ただし IoU が 0.4 未満(一般的な 0.3 ではなく)なら背景とする。著者らは、こうすると激しい遮蔽のときの誤検出を効果的に抑えられることを見つけた。
分類には交差エントロピー、ボックス回帰には smooth-L1 を使う。
埋め込みの分岐:三つ組を分類で置き換える
埋め込みで学ぶのは、同じ人の特徴同士は近づき、違う人の特徴同士は離れるような空間だ。いちばん素直なやり方は三つ組損失(triplet loss)で、MOTDT もそうやって訓練していた。だが三つ組は組み合わせが多すぎてサンプリングが難しく、訓練もあまり安定せず、収束が遅い。
著者らは三種類の損失を比べた。
- 三つ組損失: ミニバッチの中で、すべての負例と最も難しい正例を掘り出す。
- 三つ組損失の滑らかな上界: より安定し、収束も速い変形。
- 交差エントロピー: 訓練セットの身元を一人ずつ一つのクラスとみなし、取り出した埋め込み特徴を全結合層一つに通して、身元の分類を行う。
著者らはまず、後の二つを式の上で比べた。滑らかな上界は次のように書ける。
交差エントロピーは次のとおりだ。
二つはほとんど同じ形をしていて、違いは二つある。一つ目に、交差エントロピーは各身元を、他のサンプルの特徴 をそのまま使うのではなく、学習可能な「クラスの重み」 で表す。二つ目に、交差エントロピーの分母には他のすべての身元が含まれるが、三つ組系の損失に含まれるのは、そのミニバッチで抽出された負例だけだ。交差エントロピーは、ある人が他のどの身元よりも自分のクラスに似ていることを求めるので、制約は三つ組よりずっと厳しい。
実験結果の差も歴然としている。同じ重みの設定で、検索タスクでの埋め込みの TPR@FAR=0.1 は、三つ組がわずか 42.2、滑らかな上界が 44.3、交差エントロピーが 88.2 と、ちょうど倍になった。
ボックスはあっても身元のアノテーションがない前景のアンカーボックスは、埋め込みの損失を計算するときに無視される。三つのスケールの埋め込み特徴は同じ全結合層を通り、同じ特徴空間を共有するので、異なるスケールで検出された同じ人も互いに比べられる。
三つの損失をどう釣り合わせるか
予測ヘッドごとに損失が三つあり、三つのスケールを合わせると九つになる。いちばん単純なのはすべて同じ重みで足すことだが、これではほとんど訓練にならない。
著者らはいくつかの重みづけの戦略を比べた。
- 均等な重み(Uniform): 検出の AP はわずか 6.8 に落ちる。埋め込みの損失は他の二つよりずっと大きく、訓練全体がそれに支配されて、検出はまったく学べず、MOTA は 36.9 しかない。
- MGDA-UB: 理論的には最も整ったマルチタスク最適化の手法だが、埋め込みの損失に大きすぎる重みを与えてしまい、結果は均等な重みとあまり変わらず、AP は 8.3。
- 損失の正規化(Loss.Norm): 各損失の移動平均の逆数を重みにする。MOTA は 57.9。
- 近似的な最適重み(App.Opt): 独立な変数二つに制限して、人手で重みの組を探す。MOTA は 64.3。
- 不確かさによる重みづけ(Uncertainty): 各損失に学習可能なパラメータ を一つずつ持たせ、ネットワーク自身に重みを決めさせる。
人手の探索を上回ったのは、この最後の方法だけだった。AP 83.0、TPR 90.4、MOTA 65.8 で、ID スイッチ 207 も最も少ない。翌年の FairMOT も、同じ重みづけのやり方を踏襲している。
訓練データ
JDE にはボックスと身元のアノテーションが両方そろったデータが必要だが、追跡のデータセットは小さすぎる。著者らは六つの公開データセットをつなぎ合わせて、大きな訓練セットを作った。ETH と CityPersons にはボックスしかないので検出だけを訓練し、CalTech、MOT16、CUHK-SYSU、PRW には身元のアノテーションがあるので、二つの分岐を一緒に訓練する。合計で約 5.4 万枚の画像、27 万個のボックス、8,700 の身元だ。ETH のうち、MOT16 のテストセットと重なる動画は取り除いてある。
この組み合わせはのちに FairMOT で MIX と呼ばれ、one-shot トラッカーの標準的な訓練データになった。
関連付け
関連付けはこの論文の主眼ではなく、著者らは単純で速いオンラインの関連付けを設計した。各軌跡は外観の状態 と、カルマンフィルタの運動の状態を一つずつ持つ。毎フレーム、すべての検出と軌跡のあいだの外観の類似度 (コサイン類似度)と運動の距離 (マハラノビス距離)を計算し、重みをつけてコストにする。
ハンガリアン法でマッチングしたあと、軌跡の外観の状態を指数移動平均で更新する。
2 フレーム続けて現れた検出だけが新しい軌跡を始め、30 フレーム更新されなかった軌跡だけが削除される。そのあいだの軌跡は一時的なプールに残り、戻ってきたときにはまだつなぎ直せる。
この EMA の更新は、のちに StrongSORT と BoT-SORT がそのまま借りている。著者らはまた、カルマンフィルタをベクトル化(すべての軌跡を一度に処理)することが速度にとって決定的だとも述べている。ネットワークがすでに十分速いと、かえって関連付けがボトルネックになりやすい。
議論
JDE は SGD で 30 エポック訓練し、入力解像度のデフォルトは だ。検証では、検出は CalTech 検証セットの AP、埋め込みは三つのデータセットでの検索の TPR、追跡は MOT15 訓練セットの MOTA を見る。最後に MOT16 テストセットで比較する。
関連付けの手法
著者らはまず、同じ JDE のモデルに SORT と自分たちの関連付けの手法をそれぞれつないだ。人の少ない MOT15 では、自分たちの手法が MOTA 67.5、IDF1 67.6、SORT は 66.9 と 55.8 で、速度も 44.1 から 46.2 FPS に上がった。人の多い CVPR19-01 シーケンス(1 フレームあたり平均 61 人)では、速度が 26.4 から 33.9 FPS に上がり、MOTA と IDF1 はわずかに改善しただけだった。IDF1 の大きな改善は、主に外観特徴から来ている。
分離型のシステムと比べる
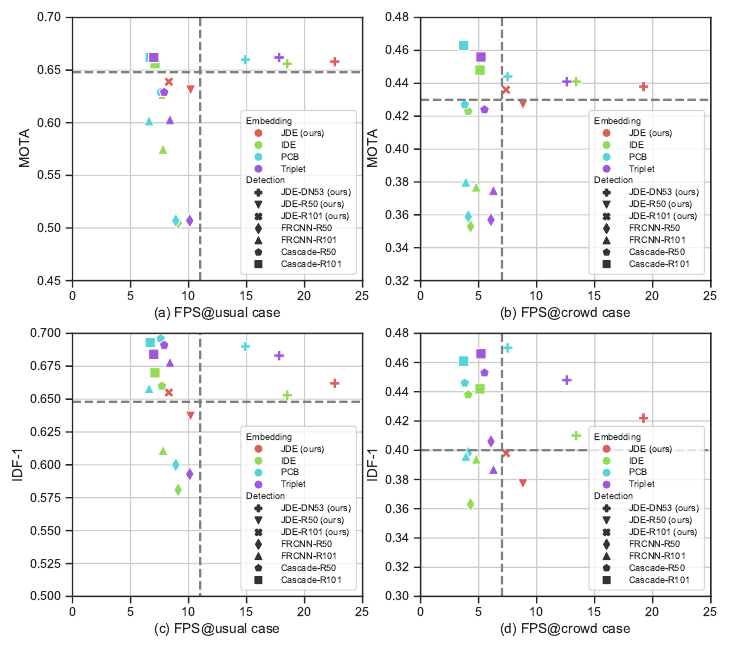
公平を期すため、著者らはまったく同じ訓練データを使い、いくつかの検出器(JDE、Faster R-CNN、Cascade R-CNN)といくつかの re-ID モデル(IDE、Triplet、PCB)を総当たりで組み合わせ、同じ関連付けをつないだ。
- 速度と精度のトレードオフが最も良い。 人が少ない場合、JDE は毎秒 22 フレームで MOTA 65.8。最も強い組み合わせである Cascade R-CNN(ResNet-101)と PCB は MOTA 66.2 だが、毎秒約 6 フレームしか出ない。
- 人が多いと差はもっとはっきりする。 SDE の組み合わせはどれも、混雑した場面で大きく遅くなる。re-ID の時間が人数に比例するからだ。JDE の埋め込みは検出と一緒に計算されるので、速度はほとんど影響を受けず、遅くなるぶんは主に関連付けから来ている。
- 一緒に学んだ埋め込みは、別々に学んだものに劣らない。 JDE の検出器を固定して、独立に訓練した IDE、Triplet、PCB の埋め込みに替えても、追跡精度はどれも近く、JDE は IDE をわずかに上回りさえする。
だが IDF1 の側は、それほど見栄えがよくない。混雑した場面では、JDE の IDF1 は強い SDE の組み合わせより大きく落ちる。
MOT16 テストセット
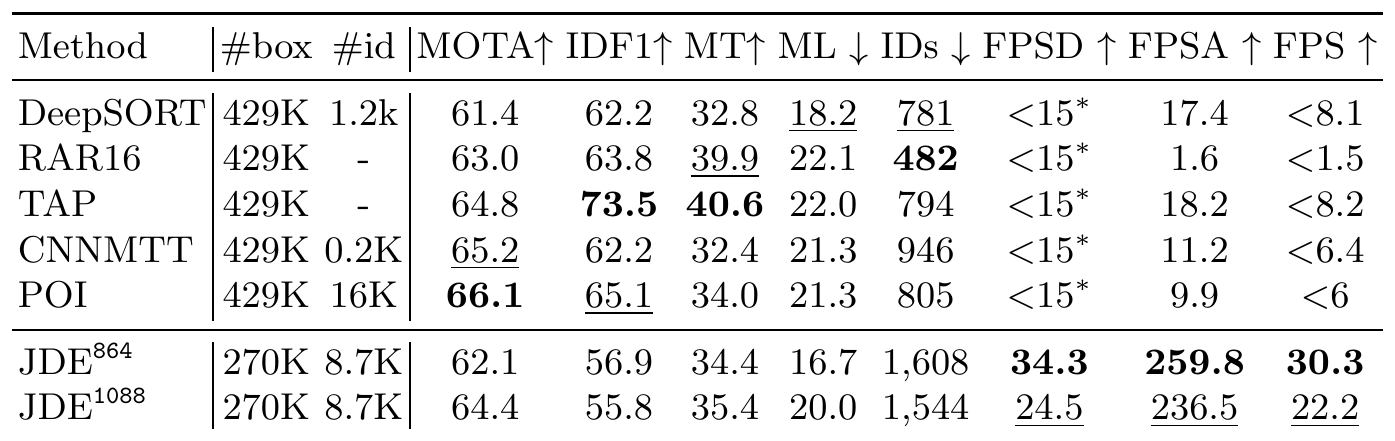
JDE は追加の訓練データを使っているので、MOT16 の private ルールで比べる。相手はみな、大規模な非公開の歩行者データで訓練した同じ Faster R-CNN を使っていて、違いは re-ID モデルと関連付けのやり方にある。
MOTA では、JDE の 64.4 は DeepSORT より 3 ポイント高く、POI より 1.7 ポイント低い。しかも訓練に使ったボックスは相手の六割あまり(27 万対 42.9 万個)しかない。速度については、完全な時間を報告していない手法が多いので、著者らはそれらが共通に使う検出器を実装し直して上限を見積もった。これほど甘い上限と比べても、JDE は毎秒 22.2 フレームで、少なくとも二、三倍速い。入力の幅を 864 に縮めると、速度は 30.3 FPS まで上がり、MOTA は 62.1 に下がるだけだ。
だが IDF1 と ID スイッチは、JDE のはっきりした弱点だ。IDF1 55.8 は DeepSORT の 62.2 にも POI の 65.1 にも及ばず、ID スイッチ 1,544 は他の手法の二倍近い。
問題はボックスにある
著者らは最初、一緒に学んだ埋め込みが弱いのではないかと疑った。しかし埋め込みを独立に訓練したモデルに替えても、IDF1 と ID スイッチはほとんど変わらなかった。
本当の原因は検出にあった。歩行者が大きく重なり合うと、一段階の検出器のボックスはずれやすく、位置が合わなくなる。位置の合わないボックスで特徴を取ると、特徴に他人が混じり、ID もそれにつられて入れ替わる。こうした ID スイッチは軌跡の途中で起こることが多いので、IDF1 が特に大きく下がる。著者らは「歩行者が激しく重なり合うときに、どうやってボックスをより正確にするか」を今後の研究に残した。
その後
この問題は、半年後には引き継ぐ人が現れた。FairMOT は、問題はアンカーボックスにあると考えた。一つのアンカーボックスが何人もの人を囲むことがあり、何個ものアンカーボックスが同じ一人に対応することもあるので、re-ID 特徴があいまいに学ばれてしまう。FairMOT はアンカーフリーの中心点表現に切り替え、埋め込みを 64 か 128 次元に減らした。FairMOT の実験では、JDE の埋め込みを 512 次元から 64 次元に減らすだけで、MOTA、IDF1、ID スイッチがすべて良くなった。
結論
JDE は外観特徴を一段階の検出器に詰め込み、一回の順伝播でボックスと特徴を同時に出力した。リアルタイムに近い完全な複数物体追跡システムとしては、これが最初だ。MOT16 での MOTA は別々に訓練した強力なシステムに近く、速度は二、三倍速い。しかも人が多いほど、その強みははっきりする。
この論文でいちばん持ち帰る価値があるのは、二つの訓練の細部だ。埋め込みには身元分類の交差エントロピーを使うと、三つ組損失より倍も良い。マルチタスクの重みは不確かさのパラメータに学ばせると、人手で探すより良い。この二つの手は、その後の one-shot トラッカーでほぼ定番になった。
論文のタイトルは「Towards」だ。ボックスの位置が合わないという区間は、次の論文に歩いてもらうしかないと、著者ら自身もよくわかっていた。