原論文
FairMOT: On the Fairness of Detection and Re-Identification in Multiple Object Tracking
- arXiv への初回投稿
- arXiv:2004.01888
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingfairmot2020,
  title = {{FairMOT: On the Fairness of Detection and Re-Identification in Multiple Object Tracking}},
  author = {Yifu Zhang and Chunyu Wang and Xinggang Wang and Wenjun Zeng and Wenyu Liu},
  year = {2020},
  eprint = {2004.01888},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2004.01888}
}
DeepSORT はトラッカーに人を見分けることを覚えさせたが、その代わりに検出ボックスを一つずつ re-ID ネットワークにもう一度通さなければならなくなった。画面に十人いれば十枚切り出して特徴を十回計算し、百人いれば百回計算する。検出器と re-ID ネットワークはそれぞれ元の画像から特徴を取り出し、何も共有していない。
人が増えると、このシステムは遅くなる。
自然な発想は、二つの仕事を同じネットワークに入れることだ。2019 年前後、Track R-CNN は Mask R-CNN に re-ID のヘッドを一つ追加し、JDE(Joint Detection and Embedding)は YOLOv3 に re-ID のヘッドを一つ追加して、一回の順伝播でボックスと特徴を同時に出力した。こうした手法は one-shot トラッカーと呼ばれ、速度は確かに上がり、検出もそれなりに良かった。
だが ID スイッチが激増した。
華中科技大学とマイクロソフトリサーチアジアの張一夫、王春雨らは、問題がどこにあるのかを知りたかった。彼らの答えは、この二つのタスクが同じネットワークの中で公平に扱われていない、というものだった。検出はいつも主役で、re-ID はおまけにすぎない。この論文の arXiv の初版はもともと「A Simple Baseline for Multi-Object Tracking」という題で、あとから「公平さ」を強調する今の名前に変わった。
問題の定義
著者らは、one-shot トラッカーが re-ID をうまく学べない原因を、三つの「不公平」にまとめた。
アンカーボックスによる不公平
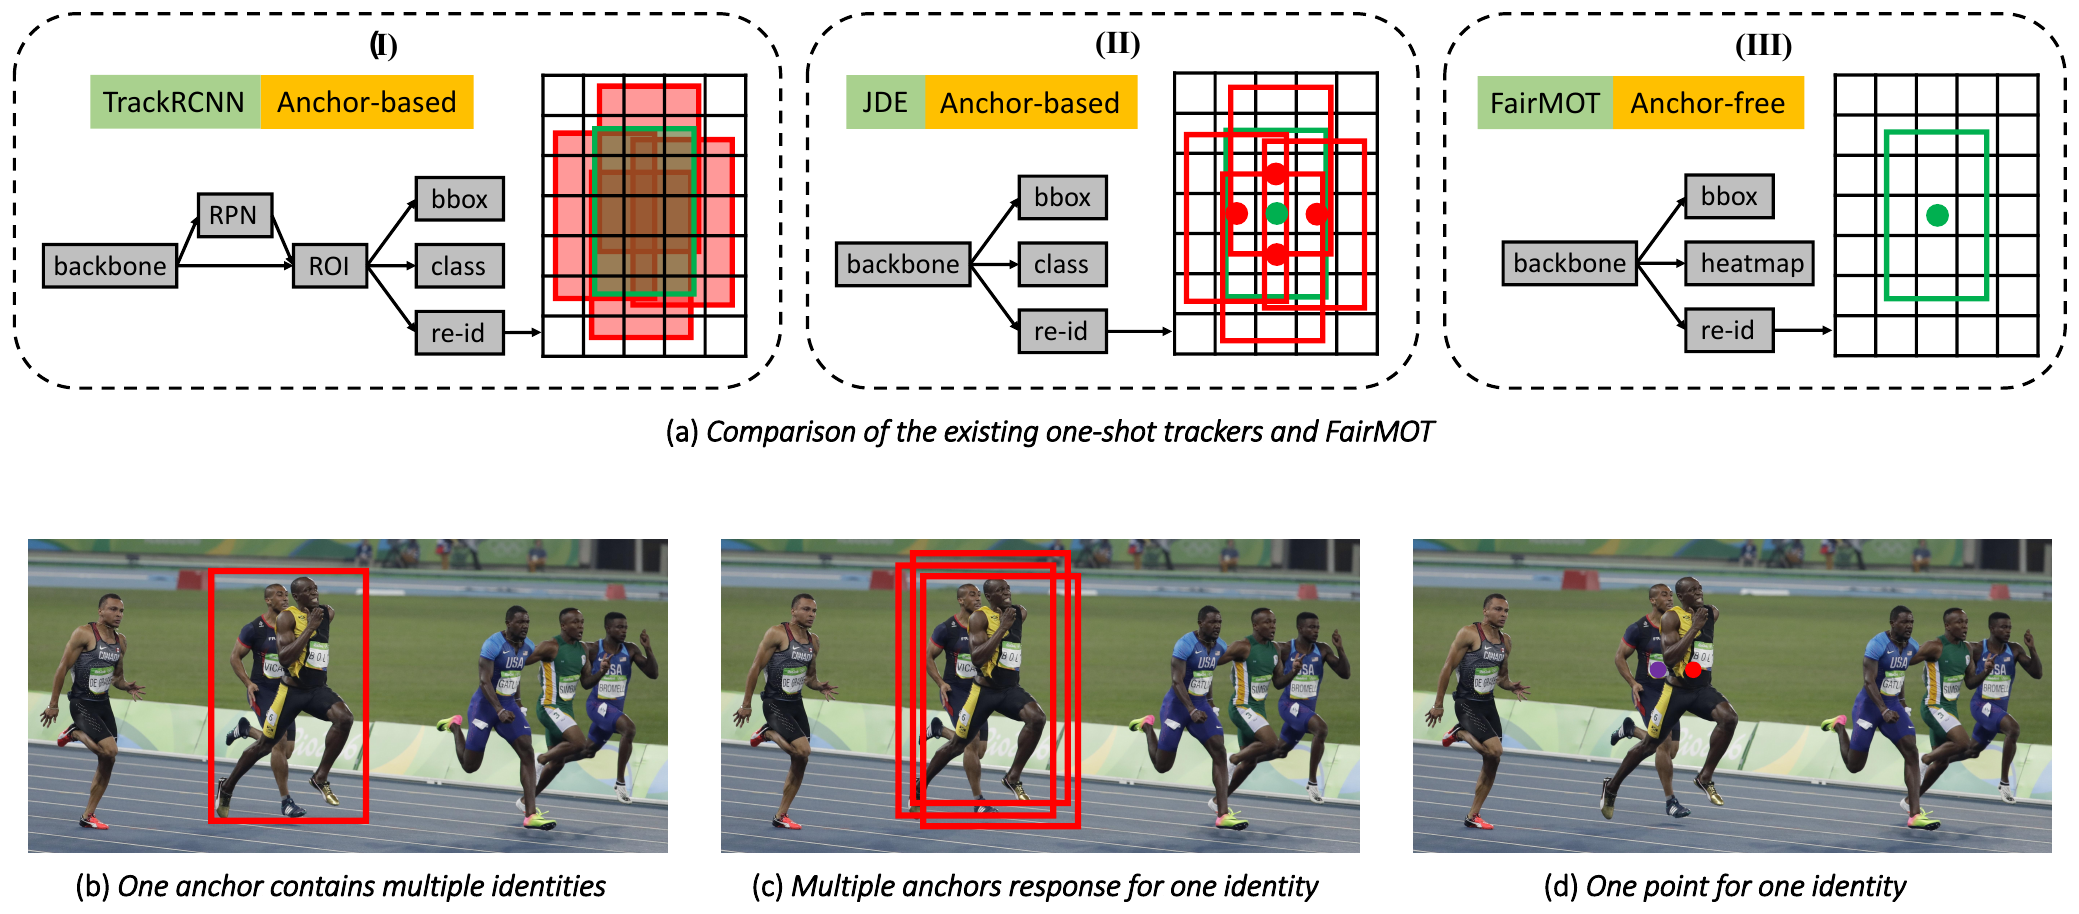
Track R-CNN も JDE も、アンカーボックス(anchor)に基づく検出器を改造したもので、re-ID 特徴もアンカーボックスにひもづいている。これが三つの厄介ごとを生む。
- re-ID が二の次のタスクとして扱われる。 Track R-CNN はまず RPN で候補ボックスを作り、それから候補ボックスから re-ID 特徴を取り出す。候補ボックスが不正確なら特徴は役に立たないので、訓練ではネットワークはまず候補ボックスをうまく学ぶことを優先し、re-ID は後回しになる。
- 一つのアンカーボックスが複数の人に対応する。 図 (b) の赤いボックスは、二人の選手を同時に囲んでいる。RoI-Align でボックス内をサンプリングすると、多くのサンプル点が他人や背景の上に落ち、取り出した特徴には何人もの人が混じってしまう。
- 複数のアンカーボックスが同じ一人に対応する。 図 (c) では、位置の違う三つのアンカーボックスが、同じ選手との IoU がどれも十分大きいので、三つとも同じ身元を出力するよう求められている。三つのアンカーボックスが見ている画像の領域は実際には違うのに、同じ特徴を学ばなければならない。データ拡張で画像を少しずらすだけで、同じアンカーボックスが別の人に割り当てられることもある。
さらに、検出器の特徴マップはたいてい 8、16、32 分の 1 に縮小されていて、検出にはまだ許容できても、re-ID には粗すぎる。アンカーボックスの位置が物体の中心に合っていないことも十分ありうる。
特徴による不公平
検出と re-ID が求める特徴は、かなり違う。検出は同じクラスの物体の特徴ができるだけ似ていることを望み、その人がどんな服を着ていても「これは人だ」とわかればいい。ところが re-ID は、同じクラスの別々の個体を区別しなければならず、低レベルの外観の細部をもっと必要とする。
二つのタスクが同じ特徴を共有すると、互いに引っ張り合うことになる。
次元による不公平
re-ID の分野では 512 次元や 1024 次元の特徴を使うのが習慣だが、検出ヘッドの出力はクラス数とボックスの座標数個にすぎない。著者らは、両者の次元がこれほど違うと、re-ID の損失が検出を圧倒してしまうと考えた。
もっと重要なのは、複数物体追跡の re-ID が一般的な re-ID とは違うことだ。一般的な re-ID はクエリ画像一枚を数万枚の候補と照合するので、高い識別力が必要になる。追跡では、隣り合う二フレームのあいだで、少数の一対一のマッチングをするだけでいい。追跡にはそれほど高い次元は要らない。
問題を解く
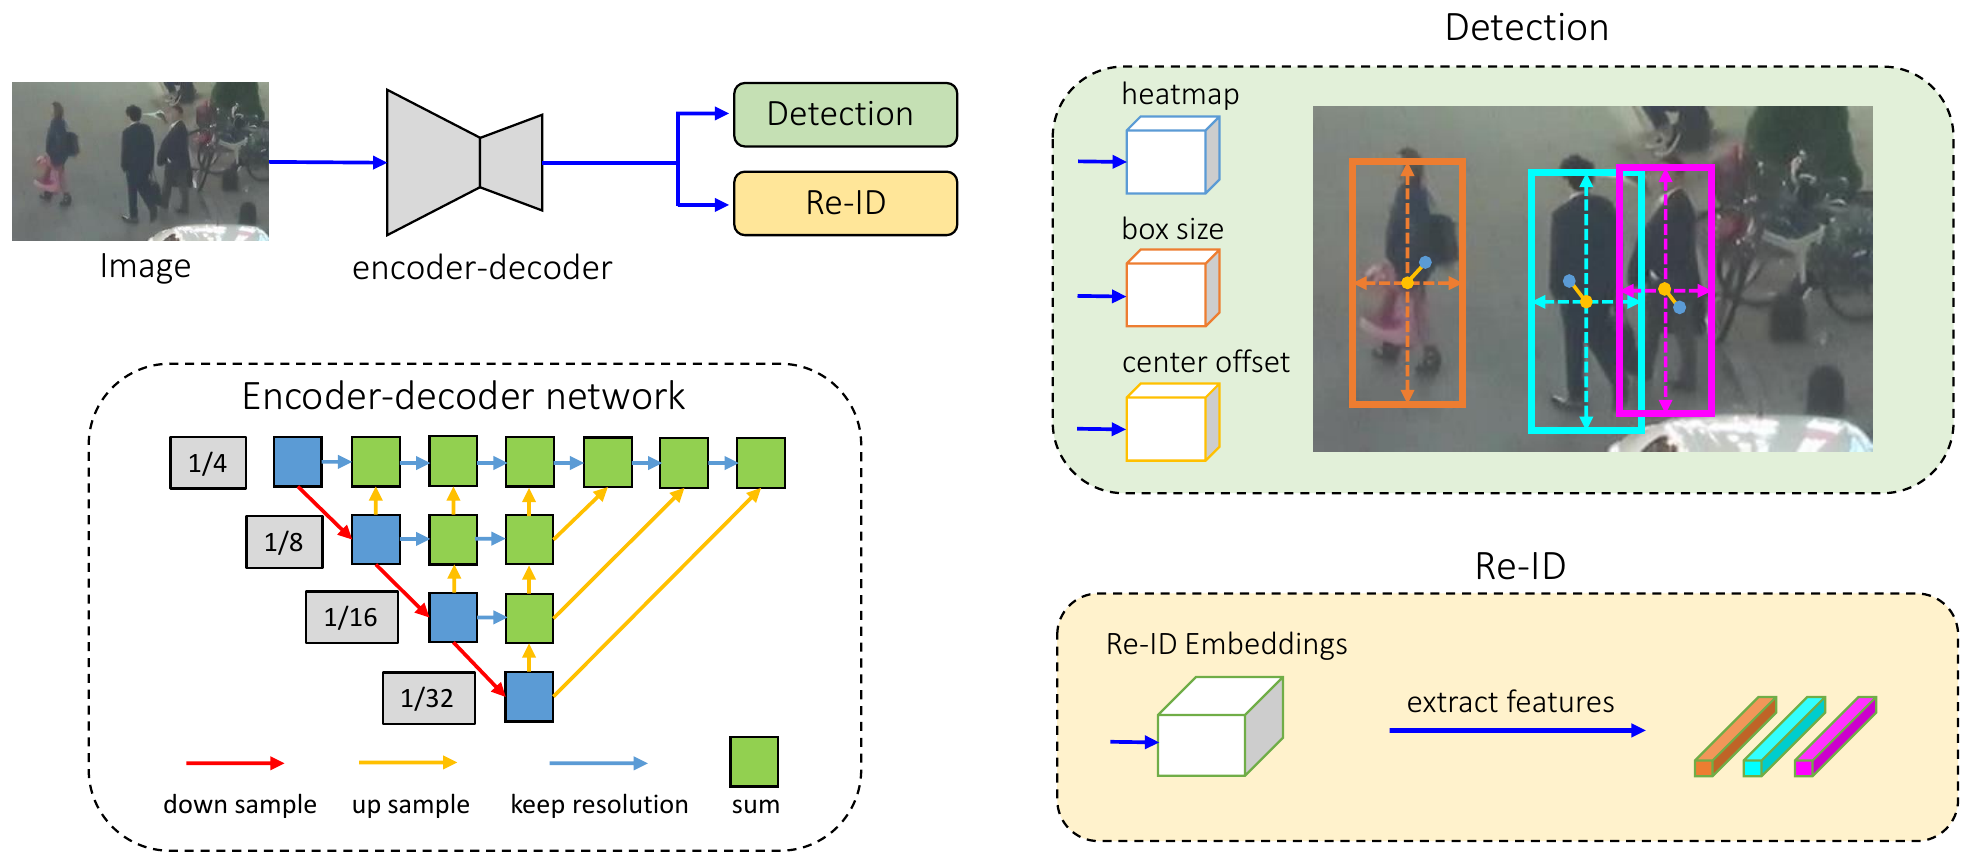
FairMOT は三つの不公平それぞれに手を打っている。アンカーボックスを使わず、CenterNet のように物体を中心点で表す検出方式に切り替える。多層の特徴を融合するバックボーンを使い、二つのタスクがそれぞれ必要なものを取れるようにする。re-ID 特徴の次元を下げる。
二つの分岐の構造はまったく同じで、どちらもバックボーンが出力する同じ特徴マップに直接つながっていて、どちらが先ということはない。
バックボーン
バックボーンは DLA-34 で、ResNet-34 に深層集約(Deep Layer Aggregation)の多層融合の構造を組み合わせたものだ。アップサンプリングのモジュールの畳み込みはすべて変形可能畳み込み(deformable convolution)に置き換えられていて、受容野を物体の大きさや姿勢に合わせて変えられる。
出力の特徴マップは入力の 1/4 だ。訓練でも推論でも入力画像は にそろえて縮小するので、特徴マップは になる。
一人を一通り追ってみる
一人の人を例に、二つの分岐が同じ特徴マップの上でどう役割を分けるのかを見てみよう。
の入力画像で、ある人の真のボックスが だとする。
第一のステップ、中心を見つける。 ボックスの中心は だ。特徴マップは 4 分の 1 に縮小されているので、中心は に落ち、整数に丸めると特徴マップ上のマス になる。
第二のステップ、ヒートマップ。 ヒートマップの分岐は のマップを出力する。訓練の目標は、 に値 1 のピークを置き、周りはガウス関数で外側へ減衰させることだ。 個の物体があれば、目標のヒートマップは次のようになる。
損失は CenterNet の focal loss の形を使う。ピークの位置では 1 に近い値を、他の位置では 0 に近い値を予測しなければならないが、ピークに近い位置ほど、予測を外したときの減点は小さい。
第三のステップ、オフセットと大きさ。 整数に丸めたときに が失われ、最大で 4 ピクセルの誤差が出る。オフセットの分岐は、マス で を予測し、中心を正確な位置に戻す。大きさの分岐は、同じマスでボックスの幅と高さ を予測する。どちらも L1 損失を使い、大きさの項の重みは で、CenterNet の設定をそのまま使っている。
第四のステップ、re-ID。 re-ID の分岐は 128 個のカーネルを持つ畳み込み層一つで を出力し、各マスが 128 次元の特徴を一つずつ持つ。この人の特徴は、 の にあるベクトル そのものだ。
FairMOT の鍵となる設計はここにある。一人の人は特徴マップ上の一点だけに対応し、ヒートマップ、オフセット、大きさ、re-ID がすべてこの一点から読み出される。アンカーボックスがないので、「一つのアンカーボックスに二人」や「三つのアンカーボックスに一人」という問題も起きない。
re-ID の訓練方法
re-ID の訓練は分類問題として扱われる。訓練セットの身元一人ひとりが一つのクラスで、全部で クラスある。物体の中心から取り出した特徴を、全結合層一つと softmax に通して、その物体が各身元に属する確率 を得て、交差エントロピーで損失を計算する。
訓練では、真の中心点の特徴だけを使う。推論では、物体の中心はヒートマップで決まり、取り出した特徴をそのまま照合に使うので、分類層は使わない。
二つのタスクの釣り合いをどう取るか
検出の損失はヒートマップとボックスの損失の和、 だ。二つのタスクの損失は単純に足すのではなく、Kendall らが提案した不確かさによる重みづけを使う。
と は学習可能なパラメータだ。あるタスクの損失が大きく不確かなほど、その重みは小さく調整されるが、 の二項が、重みが際限なく小さくなることを罰する。どちらにどれだけ配分するかは、ネットワーク自身が決める。
単一画像だけでも訓練できる
追跡のデータにはフレームをまたいだ身元のアノテーションが必要で、高くつく。著者らは別に「単一画像での訓練」を提案した。CrowdHuman のような、ボックスだけで身元のない歩行者検出データを使い、ボックスの一つひとつを独立した身元とみなして、画像全体に回転、拡大縮小、平行移動、色などの拡張をかける。
こうして訓練した re-ID が学ぶのは、「この人は画面にいる他の人と違う」ということだ。論文はこの方法を自己教師ありと呼び、公式のコードの説明では弱教師ありと書いている。どう呼ぶにせよ、使っているのはボックスのアノテーションで、省けるのは身元のアノテーションだ。
推論と関連付け
推論では、ヒートマップに の最大値プーリングを一度かけて非最大値抑制の代わりにし、スコアがしきい値を超えるピークを残す。それからオフセットと大きさの分岐からボックスを計算し、re-ID の分岐から特徴を取り出す。
関連付けは MOTDT の二段階のやり方を踏襲している。
- 第一段階:外観が主役。 カルマンフィルタで各軌跡の位置を予測し、マハラノビス距離 を計算する。さらに軌跡と検出のあいだの re-ID 特徴のコサイン距離 を計算する。両者に重みをつけて 、 とし、マハラノビス距離が大きすぎる対応はそのまま除外する。ハンガリアン法でマッチングし、しきい値は 0.4。
- 第二段階:IoU で漏れを拾う。 対応しなかった残りの検出ボックスと軌跡を、今度はボックスの IoU でもう一度マッチングする。しきい値は 0.5。
軌跡の外観特徴は、外観の変化に追従するため毎フレーム更新される。最後まで対応しなかった検出ボックスは新しい軌跡になり、対応しなかった軌跡は、戻ってくるかもしれないので 30 フレーム保持しておく。
議論
訓練データは JDE と同じで、MIX と呼ばれる。そのうち ETH と CityPersons にはボックスしかないので検出の分岐だけを訓練し、CalTech、MOT17、CUHK-SYSU、PRW には身元のアノテーションがあるので、二つの分岐を一緒に訓練する。アブレーションの実験はすべて MOT17 の検証セットで行っている。
re-ID の品質は TPR@FAR=0.1 で測る。真のボックスの位置の特徴で検索を行い、他人受入率 0.1 のときの真陽性率を見るものだ。この指標は検出結果の影響を受けず、特徴そのものの良し悪しだけを見る。
特徴はどこで取るべきか
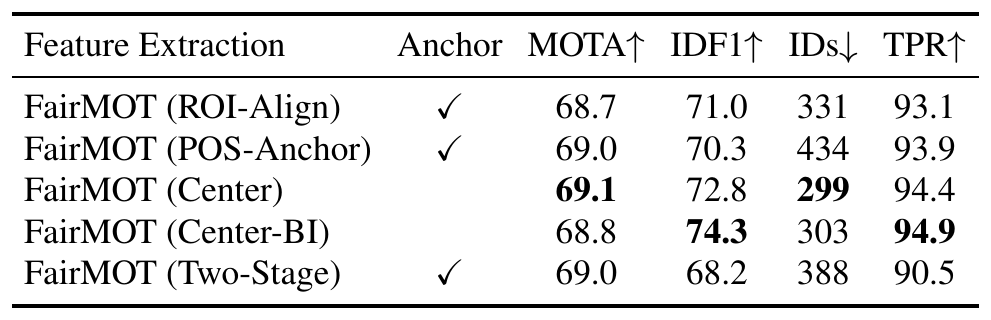
五つの方法はどれも FairMOT の上に作られていて、違いは re-ID 特徴をどこから取るかだけだ。ROI-Align は Track R-CNN のやり方、POS-Anchor は JDE のやり方、Center は FairMOT のやり方で、Center-BI は中心で双線形補間を使ってより正確な位置を取り、Two-Stage はまず検出してから検出ボックスで ROI-Align を行う。
MOTA はどれも 69 前後で、これは検出の分岐が同じだからだ。差が出るのは IDF1 と ID スイッチだ。Center の ID スイッチは 299 で、POS-Anchor の 434 より三割少ない。Center-BI の TPR が最も高い。最も悪いのは Two-Stage で、IDF1 は 68.2 しかなく、TPR は 90.5 まで下がる。訓練で re-ID を検出結果に依存させると、特徴の品質は確かに足を引っ張られる。
検出と re-ID は本当にぶつかり合うのか
著者らはとても直接的な実験をした。ResNet-34 をバックボーンにして、一方の組は二つの分岐を一緒に訓練し、もう一方の組は検出の分岐だけを訓練して、re-ID の分岐はランダムな初期値のままにする。
検出だけを訓練すると、AP は 75.1 から 76.1 に上がる。二つのタスクを一緒に訓練すると、検出は確かに足を引っ張られる。面白いことに、検出だけを訓練した組のほうが MOTA はわずかに高い(63.7 対 63.6)が、IDF1 は 67.2 から 60.4 に、TPR は 90.9 から 36.7 に落ちる。MOTA は主に検出を見ているので、re-ID の特徴がほとんど役に立たなくなっていても、それに気づかない。
多層融合を持つ DLA-34 に替えると、AP は 81.2、TPR は 94.4 になり、どちらも ResNet-34 より良い。著者らの解釈では、多層融合のおかげで二つのタスクがそれぞれ必要な特徴を別々の層から取れるので、衝突が小さくなる。
バックボーンの比較もこれを裏づけている。ResNet-50 は ResNet-34 より大きく、ImageNet の精度も高いが、MOTA は 63.6 から 63.7 にしかならず、ID スイッチはかえって 435 から 501 に増える。FPN を加えた ResNet-34 はパラメータが ResNet-50 より少ないのに、TPR は 90.9 から 94.2 に上がる。DLA-34 で変形可能畳み込みを普通の畳み込みに戻すと、MOTA は 69.1 から 65.0 に、AP は 81.2 から 78.1 に下がる。中心の一点だけから特徴を取る手法は、受容野が物体の大きさに合わせて変われることに大きく頼っている。
次元は低めのほうがいい
re-ID 特徴を 512 次元から 64 次元に減らすと、こうなる。
- JDE: MOTA 59.9 → 60.3、IDF1 64.1 → 65.0、ID スイッチ 536 → 474、TPR 76.8 → 82.0。すべての項目が良くなる。
- FairMOT: MOTA 68.5 → 69.2、AP 80.9 → 81.3、ID スイッチ 312 → 283。ただし IDF1 は 73.7 から 73.3 にわずかに下がり、TPR も 94.6 から 94.3 にわずかに下がる。
FairMOT のほうの結果は、もう少し込み入っている。高次元の特徴そのものの識別力は確かにやや強いが、検出の足を引っ張り、検出が悪くなると追跡全体も悪くなる。著者らは最終的に 128 次元を採用した。
損失にどう重みをつけるか
固定の重み(グリッドサーチで求めたもの)は MOTA と AP が最も高く、TPR は最も低く、モデルが検出に偏る。MGDA-UB は TPR が最も高く、MOTA と AP が最も低く、re-ID に偏る。GradNorm は IDF1 が最も高く、全体として最もバランスが良いが、訓練に時間がかかる。著者らは最終的に、少し劣るものの、ずっと単純な不確かさによる重みづけを選んだ。
関連付けの三つの部品
IoU だけで関連付けると、ID スイッチは 648 回ある。re-ID 特徴だけにすると 435 に減り、re-ID にカルマンフィルタを加えると 342、三つすべてを使うと 299 だ。混み合った場面やカメラが速く動く場面では、IoU だけに頼ると ID が次々に入れ替わる。物体が部分的に隠れているときには re-ID 特徴が当てにならないので、ボックスと運動で補う必要がある。
単一画像での訓練
CrowdHuman の単一画像だけで訓練し、身元のアノテーションを一度も見ていないモデルを、そのまま MOT17 の検証セットの追跡に使うと、MOTA は 64.1、IDF1 は 64.9 になる。CrowdHuman で事前学習してから MOT17 で微調整すると、MOTA 71.1、IDF1 75.6 で、MOT17 だけで訓練した 67.5、69.9 よりかなり高く、MIX と MOT17 を使った 69.1、72.8 さえ上回る。
MOTChallenge
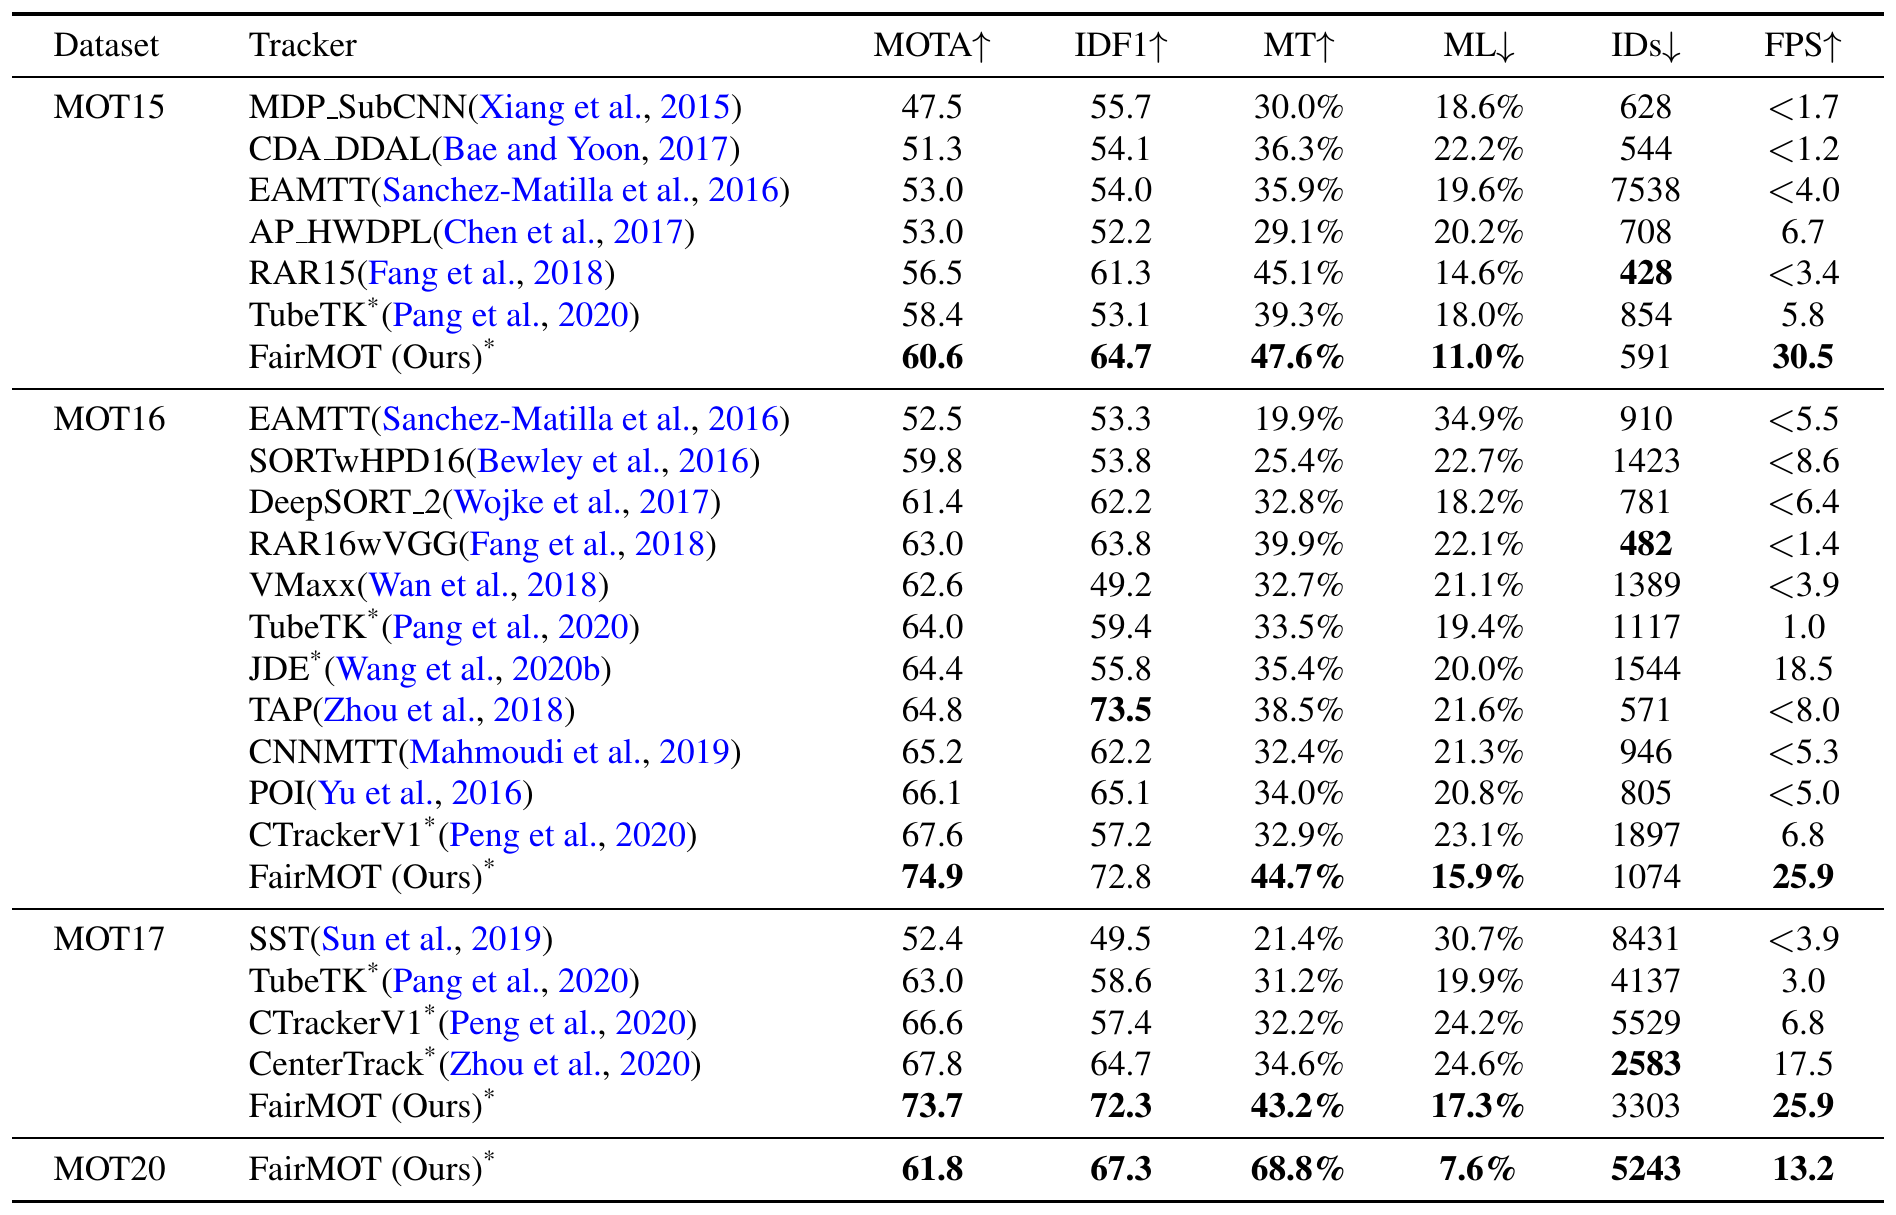
この表は private detector のルール、つまり各チームが自前の検出器を使うものだ。FPS は検出と関連付けの両方を含めて数えている。これは two-step の手法には厳しめで、one-shot トラッカーが示したいことでもある。
FairMOT は四つのデータセットすべてで一位だ。MOT17 の MOTA 73.7、IDF1 72.3 は、同じ one-shot の CenterTrack よりそれぞれ約 6 ポイントと 8 ポイント高く、速度は 25.9 FPS。MOT16 で DeepSORT(表の DeepSORT_2)と比べると、MOTA は 61.4 から 74.9 に、速度は 6.4 FPS 未満から 25.9 に上がる。
ただし、ID スイッチの列はよく見る必要がある。MOT16 では、FairMOT の 1074 回は DeepSORT_2 の 781 回より多い。FairMOT は多く検出し、MT が高く ML が低いので、追えている軌跡がもともと多く、ID スイッチの絶対的な回数もそれにつれて増える。身元を保つ力を比べるなら、IDF1 のほうがふさわしい指標だ。
速度の面では、FairMOT は MOT20 では 13.2 FPS まで落ちる。著者らが各部分の所要時間を分析したところ、検出と re-ID のネットワーク推論は人数にほとんど影響されず、カルマンフィルタと IoU のマッチングは 1~2 ミリ秒で済む。人数に比例して増えていくのは、re-ID の照合で各軌跡の外観特徴を更新する時間だった。
その後
コミュニティでのその後の検討は、ほとんどが混み合った場面に集中している。たとえば 2023 年の CSMOT は、FairMOT は混み合った場面で検出が十分に正確でなく、re-ID 特徴の識別力も足りないので、追跡の性能がはっきり落ちると指摘している。このノートの推測では、これは中心の一点だけで特徴を取る設計と関係している。人が密集すると、ある人の中心点のすぐそばは、たいてい他の誰かの体なのだ。
結論
one-shot トラッカーで ID スイッチが激増する原因として、FairMOT は三つを見つけた。アンカーボックスのせいで re-ID が入り混じった特徴を学ぶこと、特徴を共有するせいで二つのタスクが引っ張り合うこと、高次元の特徴が検出を圧倒すること。それに対応する解決策は、物体を中心点で表すこと、多層融合のバックボーンを使うこと、re-ID を 128 次元まで下げることだ。結果として MOTChallenge の四つのデータセットすべてで一位になり、システム全体は毎秒約 26 フレームで動く。
一つのネットワークに二つのタスクを詰め込むときは、re-ID の指標も別に測ることを覚えておこう。検出だけを訓練したあの組は、特徴がもうほとんど役に立っていないのに、MOTA はびくともしなかった。
面白いことに、一年半後に張一夫が ByteTrack を書いたときには、MOT17 では re-ID すら使わなくなっていた。