原論文
Real-time Multiple People Tracking with Deeply Learned Candidate Selection and Person Re-Identification
- 発表先
- ICME 2018国際会議
- arXiv への初回投稿
- arXiv:1809.04427
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingmotdt2018,
  title = {{Real-time Multiple People Tracking with Deeply Learned Candidate Selection and Person Re-Identification}},
  author = {Long Chen and Haizhou Ai and Zijie Zhuang and Chong Shang},
  year = {2018},
  eprint = {1809.04427},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1809.04427}
}
FairMOT や JDE のコードを読んだことがあるなら、関連付けの部分で MOTDT という名前を見かけたかもしれない。
FairMOT の論文ははっきりと、そのオンラインの関連付けは「MOTDT の階層的な関連付けを踏襲した」と書いている。ByteTrack が比較に使った三つの古典的な関連付けの手法も、SORT と DeepSORT のほかの三つ目は MOTDT だ。
この名前は他人の表によく出てくるのに、論文そのものはたった 6 ページしかない。清華大学の Long Chen、Haizhou Ai らが 2018 年に発表したもので、どのトラッカーも必ずぶつかる問題、つまり検出器が当てにならないときにどうするか、を扱っている。
問題の定義
混み合った場面では、検出器はすぐに間違える。姿勢が変わったり、他の人に隠れたりするだけで、検出漏れ、誤検出、あるいはボックスの位置のずれが出てくる。
オフライン(batch)の手法は動画全体を見て、未来のフレームでこうした誤りを直せるが、リアルタイムではないので、その場で結果を出す必要がある応用には使えない。この論文はオンライン追跡だけを扱い、現在と過去のフレームしか使えない。
従来の tracking-by-detection では、関連付けのときの候補ボックスは検出結果だけだ。検出器がある人を見逃すと、そのフレームにはその人の軌跡に割り当てられるボックスが一つもない。
著者らは、検出と追跡が実は補い合えることに気づいた。
- 軌跡の予測は、短時間の検出漏れやボックスのずれを扱える。検出器がこのフレームで人を見つけられなくても、カルマンフィルタの予測ボックスは残っている。
- 信頼度の高い検出は、軌跡が長い時間をかけて背景へ漂っていくのを防げる。予測ボックスが検出による補正をずっと受けなければ、遅かれ早かれずれていく。
それなら両方とも候補ボックスにしてしまおう。だが検出ボックスと予測ボックスは出どころが違う。どうやって同じ物差しで点数をつけ、重なり合った大量のボックスの中から最良のものを選べばいいのか?
以前にも Yan らが、検出器とトラッカーの出力をどちらも候補にする方法を試しているが、使ったのは色ヒストグラムやオプティカルフローのような手作りの特徴だった。この論文は、それを深層ネットワークで、しかもリアルタイムでやろうとしている。
問題を解く
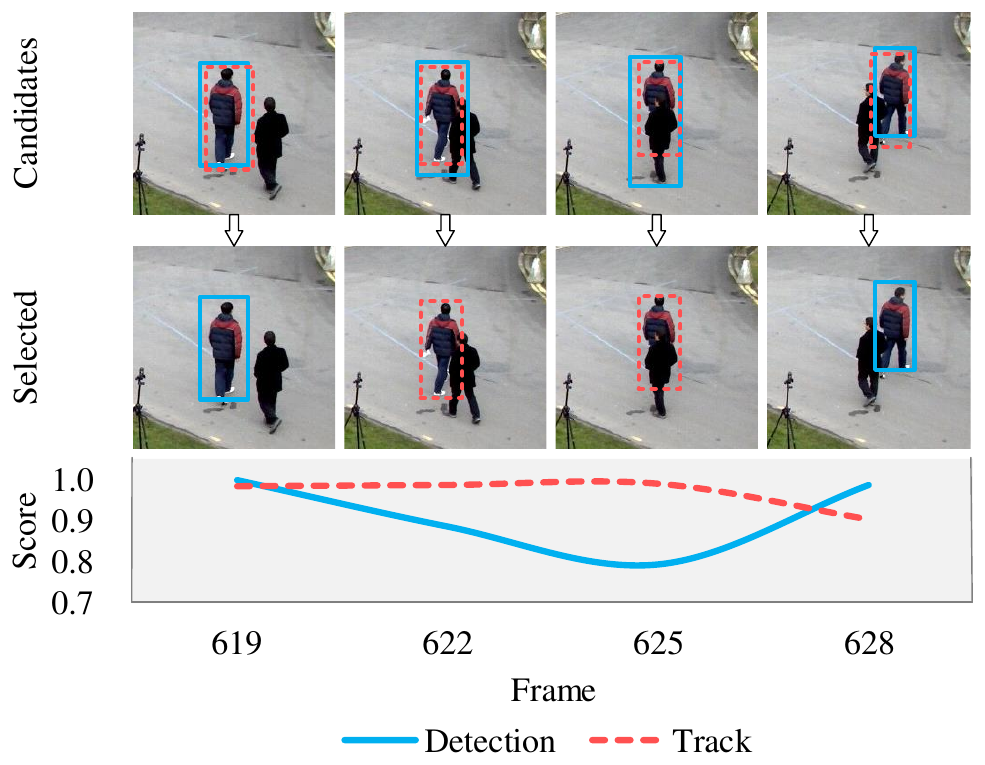
この図が論文全体のアイデアだ。青の実線は検出ボックス、赤の破線は軌跡の予測ボックスで、下の曲線は両者のスコアだ。
前後のフレームでは検出ボックスのスコアのほうが高く、そちらが選ばれる。あいだの第 622 から 625 フレームでは、この人が一部隠れて検出ボックスのスコアが下がり、予測ボックスのほうがかえって信頼できるので、予測ボックスに切り替える。
手法全体は二つのステップに分かれる。まず候補ボックスを選び、次に関連付けを行う。
一、同じ分類器ですべての候補ボックスに点数をつける
検出ボックスに予測ボックスを加えると数はかなり多くなり、しかも互いに大きく重なる。ボックスを一つずつ切り出して分類ネットワークに送っていたら、遅すぎる。
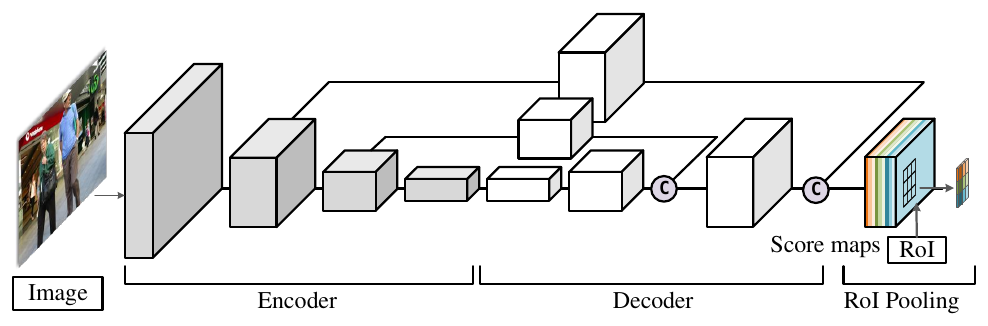
著者らは代わりに R-FCN(region-based fully convolutional network)のやり方を使った。画像全体に一度だけネットワークを走らせて数枚のスコアマップを出力し、すべての候補ボックスがそのスコアマップを共有する。
バックボーンには軽量な SqueezeNet をエンコーダとして使い、その後ろにアップサンプリング付きのデコーダをつないで、スコアマップの解像度を上げる。 の画像を入力して、GTX 1080 Ti でわずか 8 ミリ秒だ。
最も単純な点数のつけ方は、画像全体で各点が「人である」確率を計算し、ボックス内の全点を平均することだ。だがこれでは空間の情報が失われる。ボックスが人の半分しか覆っていなくても、ボックス内の点はすべて人の上にあるので、平均すればスコアはやはり高くなる。
R-FCN は位置に敏感なスコアマップでこの問題を解決する。ネットワークは 枚のスコアマップを出力し、各候補ボックスを のマスに分け、各マスは「自分の位置に対応する」スコアマップだけを読む。最後に 個のマスの反応を平均し、sigmoid にかける。
で想像してみよう。ネットワークは 9 枚のスコアマップを出力し、それぞれ「人の左上」「人の真上」……「人の右下」に反応する。ボックスがちょうど一人を囲んでいれば、左上のマスは左上のマップを、右下のマスは右下のマップを読み、どのマスも高いスコアになる。ボックスが人半分ほど右にずれると、ボックスの右半分は背景に乗り、右側の三マスが読むのはどれも低いスコアなので、平均するとスコアが下がる。
このネットワークは分類だけを行い、ボックスの回帰はしない。実装では で、訓練データは真のボックスの周りでランダムにサンプリングした正例と、同じ数の背景の負例だ。出どころは MS COCO と、MOT16 の訓練動画二本だ。
二、軌跡の信頼度:予測ボックスはいつまで信じられるか?
予測ボックスは短い時間なら役に立つが、時間が経つと当てにならなくなる。カルマンフィルタは、検出による更新を受けない時間が長いほど、予測が不正確になる。
著者らは軌跡ごとに信頼度スコアを定義した。一本の軌跡は途切れては取り戻されることを何度も繰り返すかもしれず、取り戻すたびにカルマンフィルタを初期化し直すので、最後の連続した小さな軌跡(tracklet)だけを見る。
はこの小さな軌跡が検出と何回対応したか、 は最後に検出と対応してから、予測を何回続けて使ったかだ。
この式のふるまいは直感的だ。
- 検出と対応した直後は で、信頼度は 1。
- 予測を一回使うごとに が 1 増え、信頼度は対数に従って下がっていく。
- が を超えると信頼度は 0 になり、この軌跡の予測ボックスはもう候補になれない。
- 軌跡は少なくとも二回検出と対応して、はじめて運動モデルを作るのに十分な観測があるとみなされ、その予測ボックスが候補になれる。
三、統一スコア
二種類の候補ボックスのスコアは次のように定義される。
検出ボックスのスコアは分類確率そのもので、予測ボックスのスコアは分類確率に軌跡の信頼度を掛けたものだ。予測ボックスがどれほど人らしく見えても、長いあいだ検出で確認されていない軌跡から来たものなら、スコアは押し下げられる。
すべての候補ボックスに点数をつけたら、非最大値抑制(IoU のしきい値 0.3)を一度かけ、スコアが 0.4 未満のボックスを捨てる。
四、外観特徴
関連付けのときに候補ボックスと軌跡が同じ人かどうかを判断するため、著者らは re-ID 特徴を使った。ネットワークは Zhao らが提案した部位整列(part-aligned)の構成で、GoogLeNet の畳み込みバックボーンの後ろに、体の異なる部位にそれぞれ対応する 本の全結合の分岐をつなぎ、512 次元の特徴を出力して、ユークリッド距離で比べる。
訓練データには Market-1501、CUHK01、CUHK03 の三つの人物再識別データセットを組み合わせ、triplet loss で訓練した。
は同じ人、 は違う人だ。すでに十分離れている三つ組()は損失がゼロになり、訓練は難しい例に集中する。
五、階層的な関連付け
ここが、のちに JDE や FairMOT が踏襲した部分だ。関連付けは二層に分かれる。
- 第一層:検出の候補ボックス × 軌跡、外観を使う。 re-ID 特徴の距離を計算し、しきい値は 0.4。
- 第二層:残った候補ボックス × 残った軌跡、IoU を使う。 しきい値は 0.3。
- 残った検出ボックスで、新しい軌跡を始める。
なぜ層に分けるのか? 予測ボックスはカルマンフィルタが推定したもので、混み合った場面では、それが囲む領域に他人が混じっていることがある。そういうボックスから外観特徴を取ると、他人の見た目を記憶に取り込みやすい。だから外観の照合は検出ボックスにだけ使い、軌跡の外観も対応した検出ボックスでしか更新しない。予測ボックスは第二層の IoU マッチングにだけ参加する。
こうするほうが速くもある。各フレームで re-ID 特徴を取り出すのは検出ボックスに対して一回だけでよく、予測ボックスからはまったく取らなくていい。
議論
実験は MOT16 で行い、公式に提供された公開検出を使った。検証セットは訓練動画のうち 5 本から作り、アブレーションに使っている。
各要素の貢献
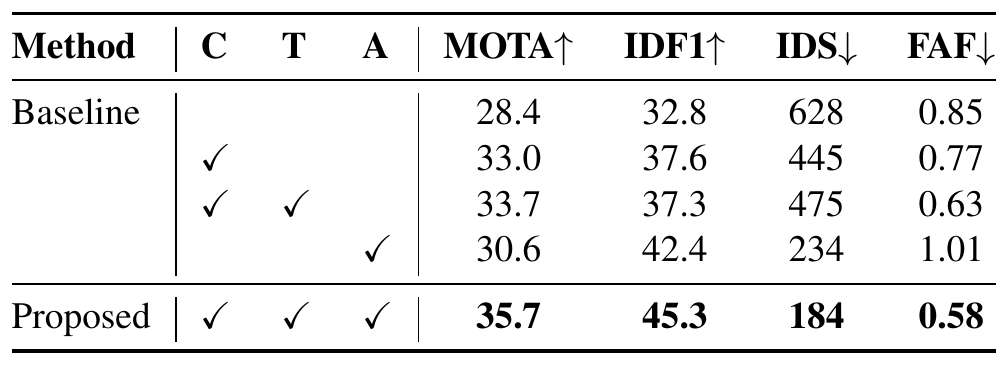
ベースラインは最も単純なカルマンフィルタの予測と IoU のマッチング、つまり SORT のやり方だ。
- 分類器で検出ボックスと予測ボックスから候補を選ぶ(C)と、MOTA は 28.4 から 33.0 に上がり、ID スイッチは 628 から 445 に減った。予測ボックスを候補にすることで、確かに多くの検出漏れを取り戻せている。
- さらに軌跡の信頼度(T)を加えると、MOTA は 33.7 に上がり、1 フレームあたりの誤検出は 0.77 から 0.63 に減った。信頼できない予測ボックスは抑え込まれたが、ID スイッチはわずかに増えて 475 になった。
- 外観特徴(A)だけを加えると、IDF1 は 32.8 から 42.4 に大きく上がり、ID スイッチは 234 に減った。だが MOTA は 30.6 にとどまり、1 フレームあたりの誤検出はかえって 1.01 に増えた。
- 三つすべてを加えると、MOTA 35.7、IDF1 45.3、ID スイッチ 184 で、四つの指標がすべて最良になる。
最初の二つは主に検出に関わる指標を改善し、外観特徴は主に身元に関わる指標を改善する。両方を合わせて、はじめてどちらもそろう。
外観特徴そのものも比べている。次の表は原論文 Table 2 をもとに整理したもので、同じ枠組みのまま外観の表現を替えて比べている。
| 外観表現 | 次元 | MOTA | IDF1 | ID スイッチ |
|---|---|---|---|---|
| 外観なし | – | 33.7 | 37.3 | 475 |
| 色ヒストグラム | 750 | 34.9 | 38.6 | 250 |
| HOG | 1152 | 34.6 | 38.5 | 317 |
| 色 + HOG | 1902 | 34.7 | 39.3 | 307 |
| re-ID 特徴 | 512 | 35.7 | 45.3 | 184 |
手作りの特徴も役には立つが、IDF1 はどれも 39 前後どまりだ。学習した re-ID 特徴は次元が最も小さいのに、IDF1 は 6 ポイント高い。
速度
著者らは、最も混み合った MOT16-03(1 フレームあたり平均 50 人超)で、1 フレームあたりの処理時間を測った。候補ボックスを一つずつ切り出し、SqueezeNet と全結合二層で個別に分類すると、1 フレームに 206.2 ミリ秒かかる。スコアマップを共有する R-FCN に替えると、66.3 ミリ秒まで下がる。
MOT16 テストセット
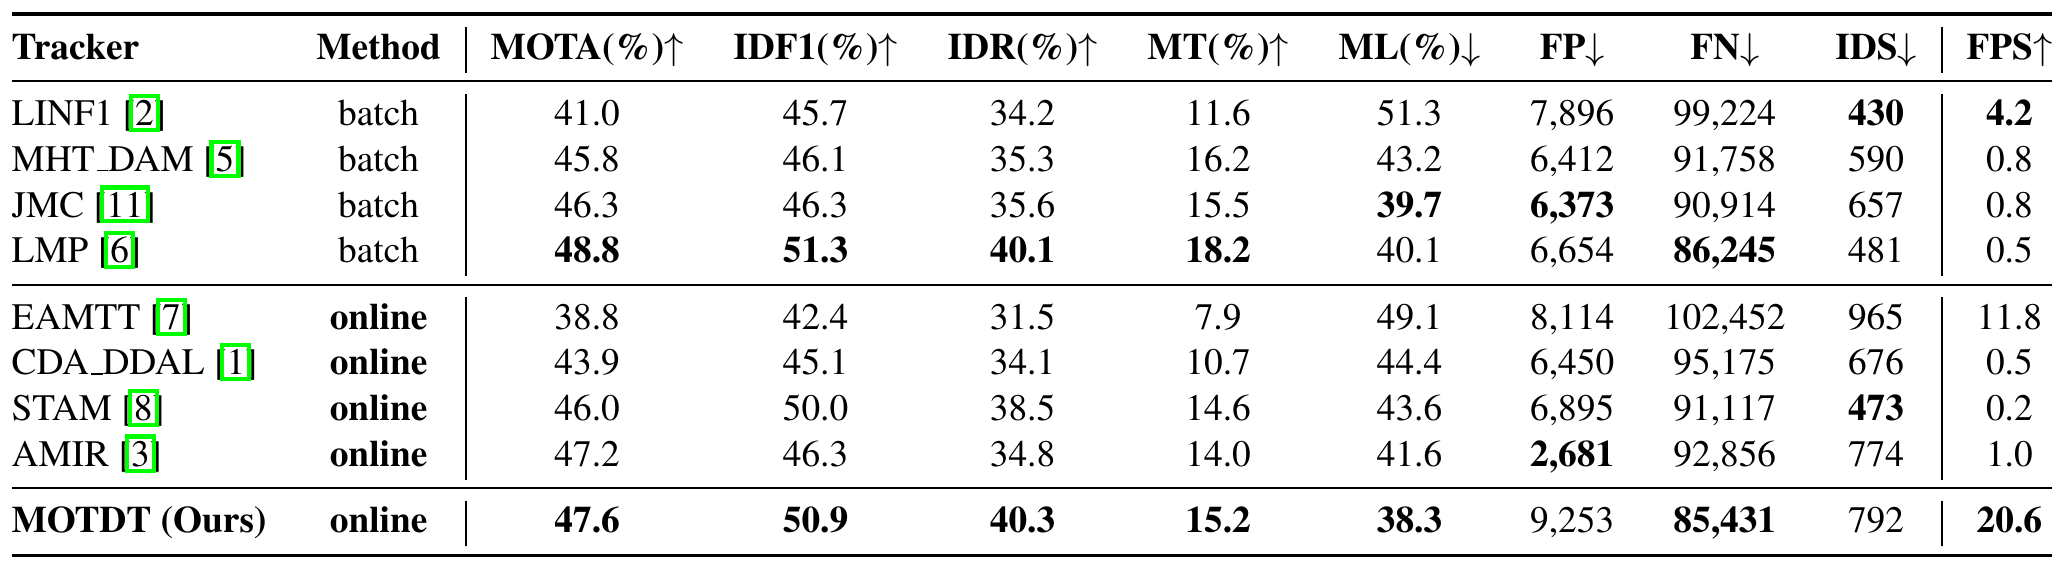
公開検出の設定で、MOTDT は MOTA 47.6、IDF1 50.9 で、どちらも表の中のオンライン手法で最も高く、ML 38.3% と FN 85,431 に至っては表全体で最も低い。速度は 20.6 FPS で、著者らによれば既存の手法の多くよりおよそ 5~20 倍速い。表の大半の手法は毎秒 0.2~1 フレームしか出ていないので、実際の差はもっと大きい。最も良いオフライン手法 LMP と比べると、MOTA の差は 1.2 ポイントしかないのに、速度は 40 倍だ。
ただし、見栄えのよくない列が二つある。FP は 9,253 で、AMIR(2,681)の三倍を超える。ID スイッチ 792 も、STAM の 473 や LMP の 481 より多い。このノートの推測では、予測ボックスを候補にすることで、検出漏れを取り戻すと同時に、本来あるべきでないボックスの一部も残してしまったのだろう。
その後
著者らは結論で、今後は分類と外観特徴で畳み込み層を共有させ、さらに効率を上げたいと書いている。
翌年、清華大学の Zhongdao Wang らが JDE を発表し、一つの検出ネットワークで検出ボックスと re-ID 特徴を同時に出力した。その公式のコードも、関連付けではまず外観と運動でマッチングし、残りを IoU で処理している。その翌年、FairMOT も同じ二段階の関連付けを踏襲した。MOTDT のもう半分、つまり「予測ボックスも候補にする」ことは、FairMOT には引き継がれなかった。
ByteTrack は 2021 年に MOTDT を比較対象に挙げ、同じ YOLOX の検出器で MOT17 の検証セットを走らせた。MOTDT の MOTA は 75.8、BYTE は 76.6 だ。ByteTrack の著者らは、MOTDT が予測ボックスを軌跡のボックスとして使うと、位置が少しずつずれていくおそれがあると考えた。BYTE は代わりに低スコアの検出ボックスから人をすくい上げるので、位置がより正確になる。二つの論文が扱っているのは同じ問題(検出器が当てにならないとき、どうやって人を見失わずにすむか)なのに、選んだ補いの材料が違う。
結論
MOTDT は検出ボックスと軌跡の予測ボックスの両方を候補にし、位置に敏感な全畳み込みの分類器でそれらに統一スコアをつけ、軌跡の信頼度で、長いあいだ確認されていない予測を押し下げる。関連付けでは、外観は検出ボックスにだけ使い、残りは IoU に任せる。この手法は MOT16 で、当時のオンライン手法として最高の MOTA と IDF1 を、毎秒 20 フレームで達成した。
自分のトラッカーに re-ID を加えたいなら、階層的な関連付けはとても実用的な出発点になる。外観特徴は信頼できる検出ボックスからだけ取り、予測ボックスは穴埋めにだけ使う。単純なルールだが、「他人の顔を自分の顔として覚えてしまう」たぐいの誤りを、それだけで直接防いでいる。
一方、タイトルの半分を占めている「候補の選択」のほうは、その後のトラッカーではあまり話題にならなくなった。