原論文
DiffMOT: A Real-time Diffusion-based Multiple Object Tracker with Non-linear Prediction
- 発表先
- CVPR 2024国際会議
- arXiv への初回投稿
- arXiv:2403.02075
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingdiffmot2024,
  title = {{DiffMOT: A Real-time Diffusion-based Multiple Object Tracker with Non-linear Prediction}},
  author = {Weiyi Lv and Yuhang Huang and Ning Zhang and Ruei-Sung Lin and Mei Han and Dan Zeng},
  year = {2024},
  eprint = {2403.02075},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.02075}
}
SORT 以来の数年間、ほとんどのトラッカーが使ってきた運動モデルはカルマンフィルタだ。物体は短い時間なら等速で直進すると仮定し、計算は速く、パラメータも少なく、MOT17 のような歩行者中心のデータではとても使いやすい。
ところが DanceTrack の舞台や SportsMOT の競技場になると、人はおとなしく歩いてくれない。ダンサーは急に振り向き、しゃがみ、跳び上がる。選手は急停止し、向きを変え、加速してダッシュする。等速直線の仮定が崩れると、予測ボックスは検出ボックスと合わなくなり、軌跡は途切れ、新しい ID が湧いて出る。
上海大学の Weiyi Lv、Yuhang Huang、Dan Zeng らは、こうした不規則な運動を拡散モデルで予測しようと考えた。拡散モデルは複雑な分布のフィッティングが得意だが、ふつうは結果を生成するのに千ステップ規模の計算が要る。一方で追跡にはリアルタイム性が求められる。
問題の定義
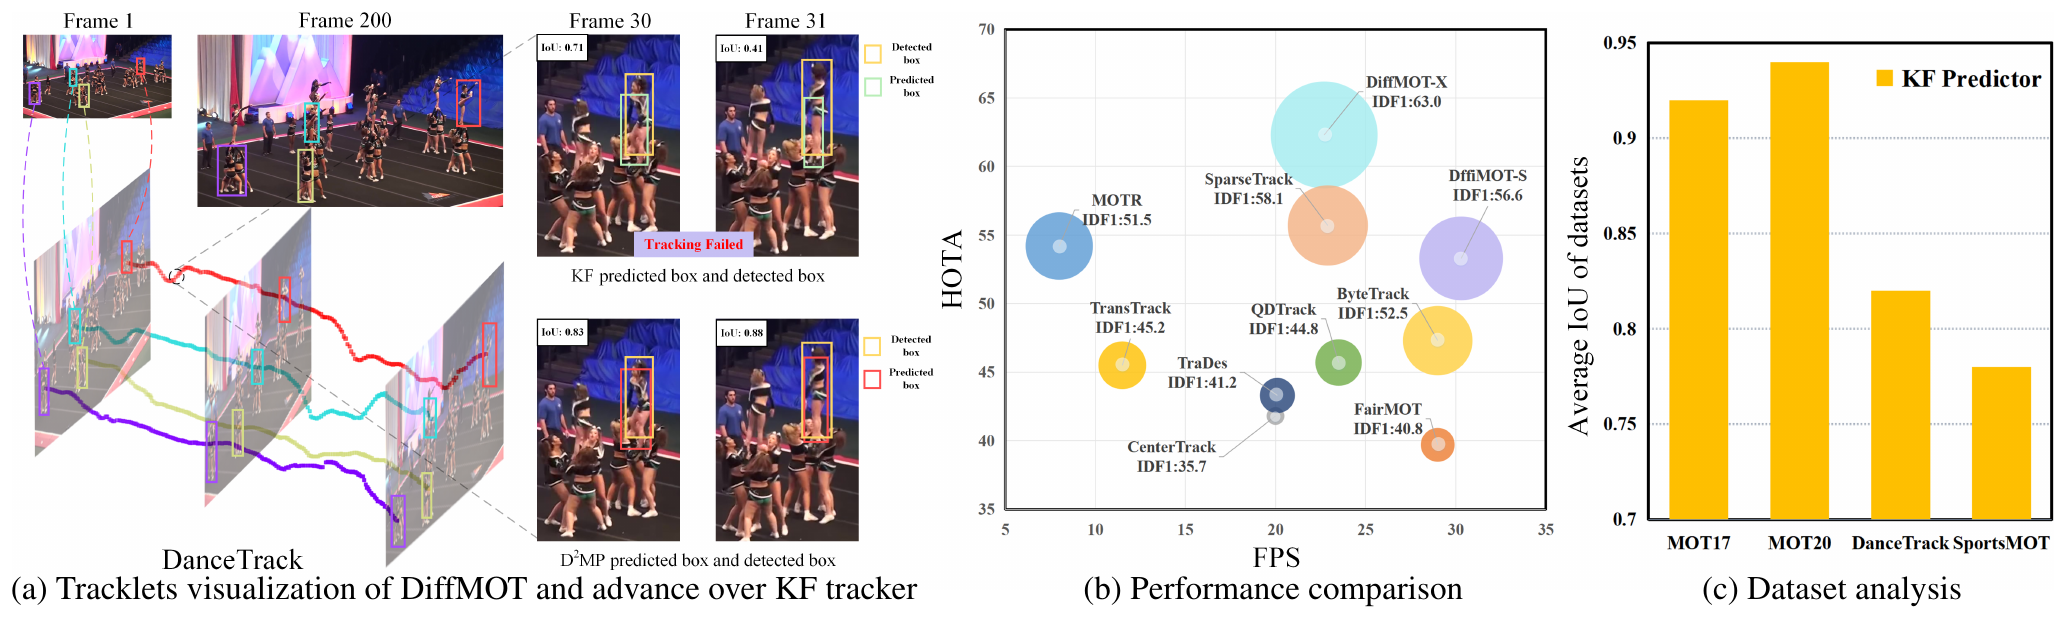
右の (c) がこの論文の出発点だ。著者らはカルマンフィルタで次のフレームのボックスを予測し、正解ボックスとの IoU を計算した。MOT17、MOT20 の平均 IoU はどちらも 0.9 以上だが、DanceTrack は約 0.82、SportsMOT は約 0.78 しかない。
追跡にとって、予測ボックスが合わないなら、関連付けはほかの手がかりで無理に支えるしかない。ニューラルネットワークで予測するにしても、MLP や LSTM のような単純なネットワークでは、これほど複雑な運動をフィッティングしきれない。オプティカルフローや Transformer を使う手法はフィッティングこそうまいが、遅すぎてリアルタイムにならない。
DiffMOT は、非線形の運動を正確に予測しつつ、速度も十分に保とうとする。
問題を解く
全体のアーキテクチャ
DiffMOT は標準的な「検出してから関連付ける」トラッカーで、三つのステップに分かれる。
- 検出。 YOLOX でこのフレームのすべてのボックスを見つける。
- 運動予測。 既存の軌跡それぞれについて、過去 5 フレームの情報を使ってこのフレームでの位置を予測する。このステップが DiffMOT の核心で、D²MP(decoupled diffusion-based motion predictor)と呼ばれる。
- 関連付け。 ByteTrack の二段階マッチングをそのまま使う。高スコアの検出ボックスをまず外観と IoU で予測ボックスとマッチングし、残りを低スコアのボックスと IoU でもう一度マッチングする。外観については、Deep OC-SORT の動的な外観と適応的な重みを借りている。
二番目のステップ以外は、すべて既製の部品だ。だからこの論文の実験は、同じ枠組みの中でカルマンフィルタを拡散モデルに置き換えたもの、と見ることができる。
生成するのは「変位」
D²MP が生成するのはボックスではなく、ボックスの変化量だ。第 フレームの運動は次のように定義される。
運動を予測したら、それを前のフレームのボックスに足せば、このフレームの予測ボックスになる。
モデルが学ぶのはデータセット全体にわたるすべての物体の運動分布で、予測のときに、ある一つの物体自身の履歴を条件にする。著者らは、これは軌跡ごとに運動モデルを個別にフィッティングするより安定していると考える。ダンサーの動きは千差万別だが、「ダンサーがどう動くか」そのものには規則性がある。
分離された拡散過程
一般的な拡散モデルでは、前向き過程が一歩ずつデータをノイズに変えていく。D²MP は「分離拡散」というやり方を踏襲し、この過程を同時に進む二つの部分に分ける。
- データをゼロへ。 きれいな運動データは時間 とともに線形に減衰し、 でゼロになる。
- ノイズの増加。 ゼロからガウスノイズを加え始め、 で純粋なノイズになる。
両者を足したものが、ノイズの乗った運動だ。
は減衰の速度、 は標準正規ノイズだ。 ではきれいな運動で、 では だけが残る。
逆過程では、ノイズから運動を復元する。もともとの分離拡散では二分岐のネットワークが必要で、 と を同時に予測する。著者らは、上の式から を と で表せることに気づき、ネットワークが予測するのは ひとつで済むようにした。
さらに重要なのは、この過程が一歩で完了できることだ。
一歩はどう進むのか
例を使って、前向きと逆向きを一通りたどってみよう。
あるダンサーの前のフレームのボックスが だとする。順に中心 、中心 、幅、高さで、単位はピクセル。このフレームでそのダンサーは右に 12、上に 3 動き、大きさは変わらないので、本当の運動は だ。
前向き過程では で、 では次のようになる。
運動は四分の一だけ減衰し、同時に標準偏差の半分のノイズが混ざる。 になると、 しか残らない。
逆向きでは、 から一歩で に跳ぶ。逆過程の式に代入すると、平均はちょうど に等しく、分散は 0 になる。ネットワークが履歴から を導き出せば、予測される運動は 、予測ボックスは だ。
本稿で整理した計算例。
一般的な拡散モデルは数百から千ステップを回す必要がある。分離拡散の減衰は解析的なので一歩で済み、運動予測の時間は無視できるほど短くなる。
条件はどこから来るのか
を予測するのは、HMINet というネットワークだ。HMINet はこの軌跡の過去 5 フレームの情報を読み込む。各フレームは八つの数字で、ボックスの四つの値と、そのフレームの変位からなる。
この 5 フレームは、まず学習可能な class token と一緒に 6 層のマルチヘッド自己アテンションを通り、最後の class token が条件の埋め込みになる。次に、ノイズの乗った運動と条件の埋め込みが一緒に「運動融合層」に入る。条件の埋め込みは MLP を通ってスケールとシフトを生み出し、ノイズの乗った運動の特徴を調整する。さらに自己アテンションと融合層を何層か重ね、最後の MLP が を出力する。
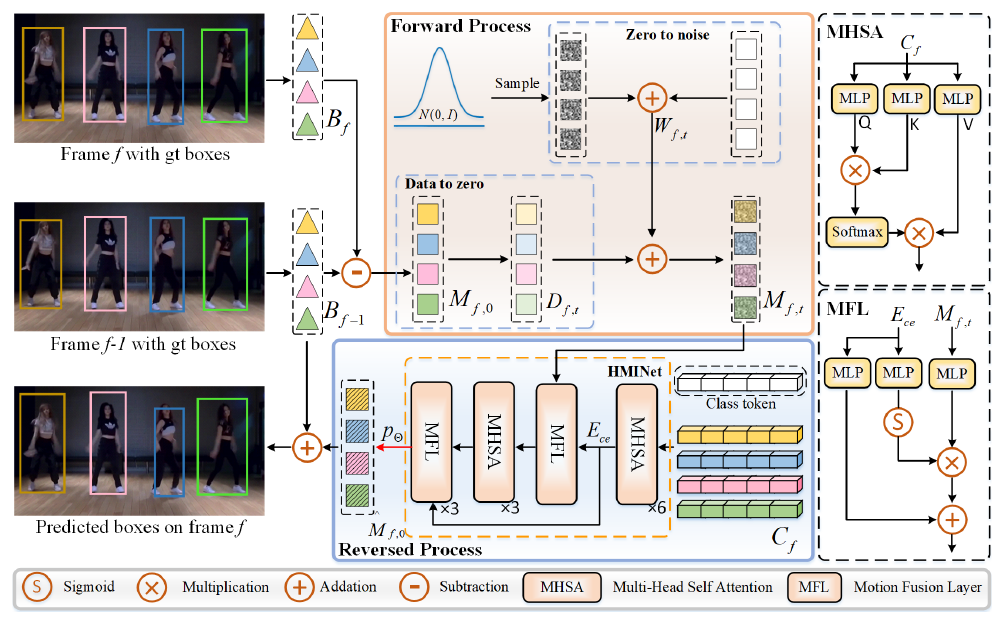
訓練時の損失は、予測した と本当の との smooth L1 だ。
議論
運動モデルを取り替える
アブレーションはすべて DanceTrack 検証セットで行い、検出器と関連付けの方式は変えずに、運動モデルだけを取り替える。
| 運動モデル | HOTA | IDF1 | AssA |
|---|---|---|---|
| IoU のみ | 44.7 | 36.8 | 25.3 |
| カルマンフィルタ | 46.8 | 52.1 | 31.3 |
| LSTM | 51.2 | 51.6 | 34.3 |
| Transformer | 54.6 | 54.6 | 38.1 |
| D²MP | 55.7 | 55.2 | 39.5 |
原論文 Table 5 をもとに整理。DanceTrack 検証セット。
カルマンフィルタは、まったく予測しない場合より HOTA が 2.1 高いだけだ。D²MP に替えると、カルマンフィルタよりさらに 8.9 高くなる。Transformer も悪くなく HOTA 54.6 だが、論文は同じ枠組みでの速度を載せていない。
一歩で足りるのか
| 構造 | ステップ数 | HOTA | FPS |
|---|---|---|---|
| 二分岐 | 1 | 44.5 | 20.9 |
| 二分岐 | 10 | 52.3 | 13.1 |
| 二分岐 | 20 | 54.6 | 7.5 |
| 単分岐 | 1 | 55.7 | 22.7 |
原論文 Table 6 をもとに整理。DanceTrack 検証セット。速度は YOLOX-X の検出を含む。
この表は単分岐の利点を示している。 と を同時に予測する二分岐版は、一歩のサンプリングでは 44.5 しかなく、20 ステップ回してようやく 54.6 に追いつき、速度は 7.5 FPS まで落ちる。 だけを予測する単分岐版は、一歩で 55.7 になる。学ぶ量が一つ減ると、ネットワークはかえってよく学べる。
履歴はどれくらい要るか
条件に使う履歴の長さ を 1 フレームから 10 フレームまで変えると、HOTA は順に 51.7、52.5、53.0、55.7(5 フレーム)、52.5、51.1 になる。短すぎると物体の動く向きが読めず、長すぎると古い情報がかえって予測を邪魔する。5 フレームが最もよい。
条件の中身も三通り試している。前のフレームのボックスだけ、前のフレームの変位だけ、あるいはその両方だ。両方使ったときの HOTA が最も高いが、三つの差は最大でも 1.3 だ。
テストセットでの成績
| データセット | DiffMOT | 表内の他手法の最高 | その手法 |
|---|---|---|---|
| DanceTrack | 62.3 | 61.3 | Deep OC-SORT |
| SportsMOT | 76.2 | 74.1 | MixSort-OC |
| MOT17 | 64.5 | 65.1 | SparseTrack |
| MOT20 | 61.7 | 63.9 | Deep OC-SORT |
テストセットの HOTA。DanceTrack は原論文 Table 1、SportsMOT は原論文 Table 2(検出器は訓練セットと検証セットで訓練)、MOT17 は原論文 Table 3、MOT20 は原論文の付録 Table 9 をもとに整理。
非線形の運動が中心の DanceTrack と SportsMOT では、DiffMOT はどちらも一位だ。DanceTrack では IDF1 63.0、AssA 47.2 で、Deep OC-SORT よりそれぞれ 1.5 と 1.4 高く、改善はおもに関連付けにある。
歩行者が中心の MOT17、MOT20 になると、DiffMOT は最良ではなくなり、Deep OC-SORT や SparseTrack をやや下回る。歩行者の運動はもともと直線に近く、カルマンフィルタで十分なので、拡散モデルが力を発揮する余地はあまりない。
速度は、YOLOX-X を使うと 22.7 FPS、YOLOX-S に替えると 30.3 FPS まで上がり、HOTA は 53.3 に下がる。
データセットをまたぐ
付録で、著者らは DanceTrack で訓練した D²MP をそのまま別のデータセットに持ち込んでいる。SportsMOT では HOTA 75.6 で、SportsMOT で訓練した版より 0.6 低いだけで、MixSort-OC の 74.1 をなお上回る。MOT17 では 2.7 低くなった。
結果を見るかぎり、ダンサーと選手の運動は、歩行者の運動よりも互いに近い。
失敗するとき
付録には二種類の失敗が挙がっている。一つ目は二人が交差して通り過ぎるときに ID が入れ替わるもので、著者らはモデルが速度の向きを制約していないせいだと考えている。二つ目は長いあいだ消えていた人を取り戻せないことだ。D²MP は一度に次のフレームしか予測しないので、長く途切れた軌跡を何フレームも先へ推し進めて待っておくことができない。
結論
DiffMOT が手を入れたのは部品一つだけで、「検出してから関連付ける」枠組みの中のカルマンフィルタを拡散モデルに置き換えた。
これをリアルタイムの追跡で使えるものにした鍵は、分離拡散だ。データの減衰は解析的なので、逆過程は一歩で済む。ネットワークは減衰の速度 だけを予測すればよく、 とノイズを同時に予測するより学びやすい。その結果、ダンサーや選手の不規則な運動をフィッティングできる予測器ができあがり、検出込みでも 20 FPS 台で動く。
半年前の DiffusionTrack と比べると、どちらも拡散モデルを使っているが、DiffusionTrack は二フレームにまたがる対のボックスを生成するのに使い、DiffMOT は変位を生成するのにしか使わない。DanceTrack では、後者の HOTA が 10 近く高い。