原始論文
DiffMOT: A Real-time Diffusion-based Multiple Object Tracker with Non-linear Prediction
- 發表版本
- CVPR 2024會議
- arXiv 首次提交
- arXiv:2403.02075
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingdiffmot2024,
  title = {{DiffMOT: A Real-time Diffusion-based Multiple Object Tracker with Non-linear Prediction}},
  author = {Weiyi Lv and Yuhang Huang and Ning Zhang and Ruei-Sung Lin and Mei Han and Dan Zeng},
  year = {2024},
  eprint = {2403.02075},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.02075}
}
SORT 之後這些年,大部分追蹤器用的運動模型都是卡爾曼濾波。它假設物體在短時間內等速直線前進,計算快、參數少,在 MOT17 這種行人為主的資料上非常好用。
可是到了 DanceTrack 的舞台、SportsMOT 的球場,人不再好好走路。舞者會突然轉身、蹲下、跳起來;球員會急停、變向、加速衝刺。等速直線的假設一失效,預測框就對不準偵測框,軌跡斷掉,新的 ID 冒出來。
上海大學的 Weiyi Lv、Yuhang Huang、Dan Zeng 等人想用擴散模型來預測這些不規則的運動。擴散模型擅長擬合複雜的分布,問題是它通常要跑上千步才能生成結果,追蹤卻需要即時。
定義問題
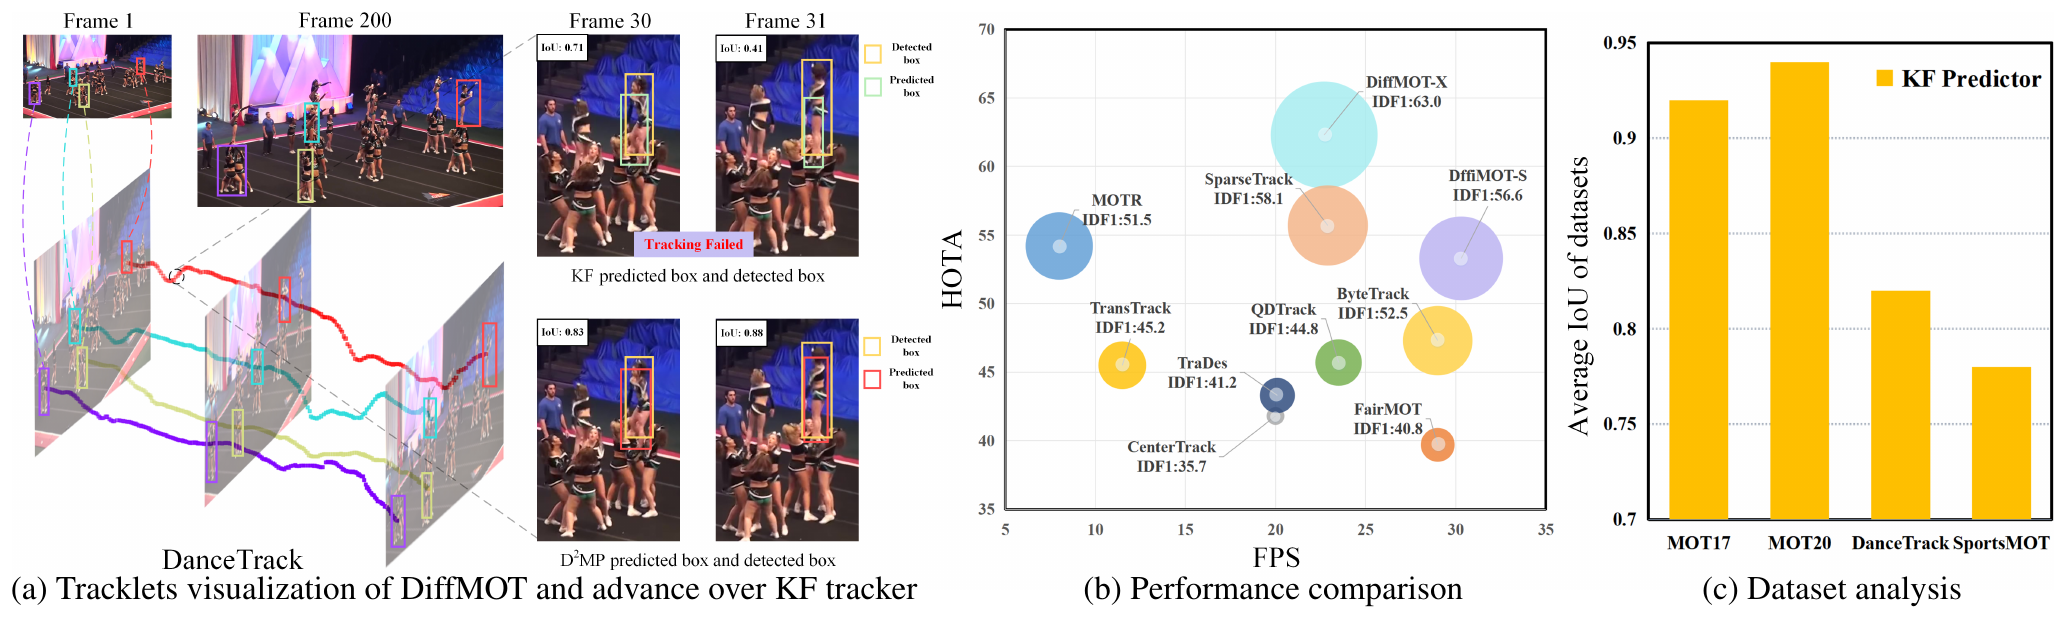
右邊的 (c) 是這篇論文的出發點。作者用卡爾曼濾波預測下一幀的框,再和真值框算 IoU。MOT17、MOT20 的平均 IoU 都在 0.9 以上;DanceTrack 只有約 0.82,SportsMOT 約 0.78。
對追蹤來說,預測框對不準,關聯就要靠其他線索硬撐。換成神經網路來預測,MLP、LSTM 這類簡單的網路擬合不了這麼複雜的運動;用光流或 Transformer 的方法擬合得比較好,卻慢到不能即時。
DiffMOT 要讓非線性運動預測得準,速度又要夠快。
解決問題
整體架構
DiffMOT 是一個標準的「先偵測、再關聯」追蹤器,分成三步:
- 偵測。 用 YOLOX 找出這一幀的所有框。
- 運動預測。 對每條已有的軌跡,用它過去 5 幀的資訊,預測這一幀的位置。這一步就是 DiffMOT 的核心,叫做 D²MP(decoupled diffusion-based motion predictor)。
- 關聯。 沿用 ByteTrack 的兩階段匹配:高分偵測框先用外觀和 IoU 和預測框配對,剩下的再和低分框用 IoU 配一次。外觀的部分則借用 Deep OC-SORT 的動態外觀和自適應權重。
除了第二步,其他都是現成的元件。所以這篇論文的實驗,可以看成是在同一個框架裡,把卡爾曼濾波換成擴散模型。
要生成的是「位移」
D²MP 生成的不是框,而是框的變化量。第 幀的運動定義為:
預測出運動之後,加到上一幀的框上,就是這一幀的預測框。
模型學的是整個資料集裡所有物體的運動分布,預測時再以某一個物體自己的歷史當作條件。作者認為,這比為每條軌跡單獨擬合一個運動模型更穩:舞者的動作千變萬化,但「舞者會怎麼動」本身是有規律的。
解耦的擴散過程
一般的擴散模型,前向過程是一步一步把資料變成雜訊。D²MP 沿用一種「解耦擴散」的做法,把這個過程拆成同時進行的兩半:
- 資料歸零。 乾淨的運動資料隨時間 線性衰減,到 時變成零。
- 雜訊增長。 從零開始加入高斯雜訊,到 時變成純雜訊。
兩者相加,就是加了雜訊的運動:
是衰減的速度, 是標準常態雜訊。 時是乾淨的運動, 時只剩 。
反向過程要從雜訊還原運動。原本的解耦擴散需要一個雙分支的網路,同時預測 和 。作者發現,從上面的式子可以把 用 和 表示出來,所以網路只需要預測 一個量。
更重要的是,這個過程可以一步完成。
一步是怎麼走的
用一個例子把前向和反向都走一遍。
假設某個舞者上一幀的框是 ,依序是中心 、中心 、寬、高,單位是像素。這一幀他往右移了 12、往上移了 3,大小不變,所以真實的運動是 。
前向過程裡,。在 時:
運動被衰減了四分之一,同時混入一半標準差的雜訊。到 ,只剩下 。
反向時,從 一步跳到 。代入反向過程的公式,均值剛好等於 ,變異數是 0。如果網路從歷史推出 ,預測的運動就是 ,預測框是 。
本文整理的算例。
一般的擴散模型要跑幾百到上千步;解耦擴散的衰減是解析的,可以一步走完,運動預測的時間就短到可以忽略。
條件從哪裡來
網路要預測 ,靠的是一個叫 HMINet 的網路。它讀入這條軌跡過去 5 幀的資訊,每一幀八個數字:框的四個值,加上那一幀的位移。
這 5 幀先和一個可學的 class token 一起,經過 6 層多頭自注意力,class token 最後就是條件嵌入。接著,雜訊運動和條件嵌入一起進入「運動融合層」:條件嵌入經過 MLP 產生縮放和平移,調整雜訊運動的特徵。再疊幾層自注意力和融合層,最後一個 MLP 輸出 。
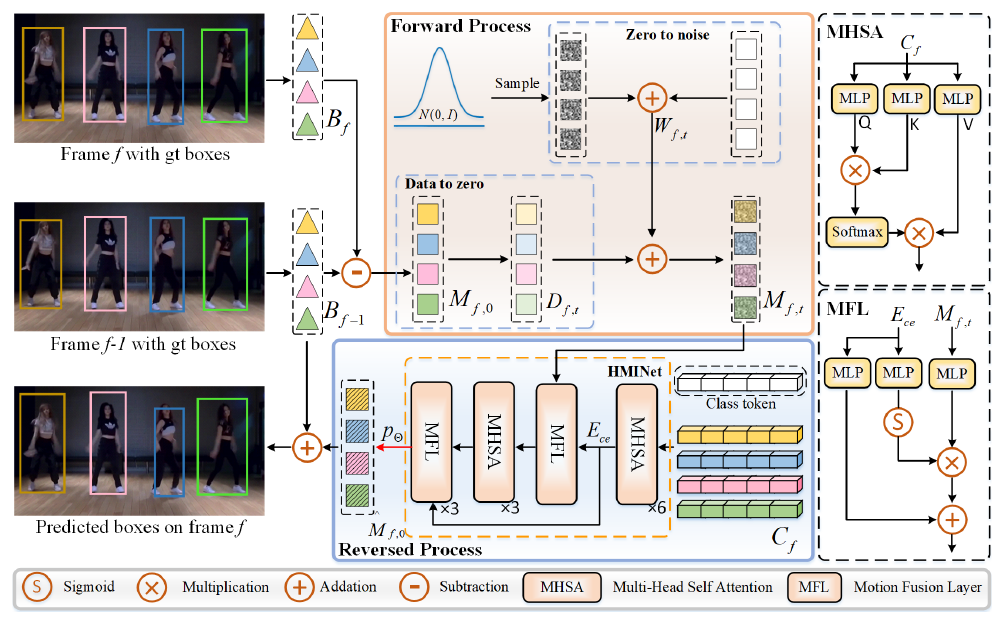
訓練時,損失是預測的 和真實 之間的 smooth L1。
討論
換掉運動模型
消融都在 DanceTrack 驗證集上,偵測器和關聯方式不變,只換運動模型:
| 運動模型 | HOTA | IDF1 | AssA |
|---|---|---|---|
| 只用 IoU | 44.7 | 36.8 | 25.3 |
| 卡爾曼濾波 | 46.8 | 52.1 | 31.3 |
| LSTM | 51.2 | 51.6 | 34.3 |
| Transformer | 54.6 | 54.6 | 38.1 |
| D²MP | 55.7 | 55.2 | 39.5 |
整理自原論文 Table 5,DanceTrack 驗證集。
卡爾曼濾波比完全不預測只好 2.1 HOTA;換成 D²MP,又比卡爾曼濾波高了 8.9。Transformer 也不差,HOTA 54.6,但論文沒有列出它在同一框架下的速度。
一步夠不夠
| 架構 | 取樣步數 | HOTA | FPS |
|---|---|---|---|
| 雙分支 | 1 | 44.5 | 20.9 |
| 雙分支 | 10 | 52.3 | 13.1 |
| 雙分支 | 20 | 54.6 | 7.5 |
| 單分支 | 1 | 55.7 | 22.7 |
整理自原論文 Table 6,DanceTrack 驗證集,速度含 YOLOX-X 偵測。
這張表說明了單分支的好處。同時預測 和 的雙分支版本,一步取樣只有 44.5,要跑 20 步才追到 54.6,速度掉到 7.5 FPS。只預測 的單分支版本,一步就有 55.7。少學一個量,網路反而學得更好。
歷史要多長
條件用的歷史長度 ,從 1 幀到 10 幀,HOTA 依序是 51.7、52.5、53.0、55.7(5 幀)、52.5、51.1。太短,看不出物體的動向;太長,舊的資訊反而干擾預測。5 幀最好。
條件的內容也試過三種:只用上一幀的框、只用上一幀的位移,或兩者都用。兩者都用的 HOTA 最高,不過三者最多只差 1.3。
測試集上的成績
| 資料集 | DiffMOT | 表中其他方法最高 | 該方法 |
|---|---|---|---|
| DanceTrack | 62.3 | 61.3 | Deep OC-SORT |
| SportsMOT | 76.2 | 74.1 | MixSort-OC |
| MOT17 | 64.5 | 65.1 | SparseTrack |
| MOT20 | 61.7 | 63.9 | Deep OC-SORT |
測試集 HOTA。DanceTrack 整理自原論文 Table 1;SportsMOT 整理自原論文 Table 2,偵測器用訓練集加驗證集訓練;MOT17 整理自原論文 Table 3;MOT20 整理自原論文附錄 Table 9。
在非線性運動為主的 DanceTrack 和 SportsMOT,DiffMOT 都是第一。DanceTrack 上 IDF1 63.0、AssA 47.2,也比 Deep OC-SORT 高了 1.5 和 1.4,進步主要在關聯。
到了行人為主的 MOT17、MOT20,DiffMOT 就不是最好的了,比 Deep OC-SORT、SparseTrack 低一些。行人的運動本來就接近直線,卡爾曼濾波已經夠用,擴散模型沒有太多可以發揮的地方。
速度方面,用 YOLOX-X 時是 22.7 FPS,換成 YOLOX-S 可以到 30.3 FPS,HOTA 則掉到 53.3。
跨資料集
附錄裡,作者把在 DanceTrack 上訓練的 D²MP 直接拿到其他資料集。SportsMOT 上 HOTA 75.6,只比在 SportsMOT 上訓練的版本低 0.6,仍然高於 MixSort-OC 的 74.1。MOT17 上則低了 2.7。
從結果看,舞者和球員的運動,彼此比和行人更接近。
失敗的時候
附錄列了兩種失敗。第一種是兩個人交錯走過時互換 ID,作者認為是因為模型沒有約束速度的方向。第二種是長時間消失的人找不回來:D²MP 一次只預測下一幀,一條斷掉很久的軌跡,沒有辦法往前推好幾幀去等它。
結論
DiffMOT 只動了一個零件,把「先偵測、再關聯」框架裡的卡爾曼濾波,換成一個擴散模型。
讓它能用在即時追蹤上的關鍵,是解耦擴散。資料衰減是解析的,反向過程可以一步走完;網路只需要預測衰減的速度 ,比同時預測 和雜訊更好學。結果是一個能擬合舞者、球員不規則運動的預測器,加上偵測還能跑到 20 幾 FPS。
和半年前的 DiffusionTrack 比,兩篇都用擴散模型,DiffusionTrack 拿它生成兩幀的配對框,DiffMOT 只拿它生成位移。在 DanceTrack 上,後者的 HOTA 高了將近 10。