原論文
DiffusionTrack: Diffusion Model For Multi-Object Tracking
- 発表先
- AAAI 2024国際会議
- arXiv への初回投稿
- arXiv:2308.09905
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingdiffusiontrack2023,
  title = {{DiffusionTrack: Diffusion Model For Multi-Object Tracking}},
  author = {Run Luo and Zikai Song and Lintao Ma and Jinlin Wei and Wei Yang and Min Yang},
  year = {2023},
  eprint = {2308.09905},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2308.09905}
}
拡散モデルの最も有名な用途は画像の生成だ。純粋なノイズの画像から始めて、一歩ずつノイズを取り除き、最後にはっきりした画像を得る。
2022 年の終わりに、DiffusionDet はこの考えを物体検出に持ち込んだ。画像ではなくボックスを生成するのだ。画面にランダムなボックスを大量にばらまき、ネットワークに一歩ずつ物体の上へと修正させていく。
深圳先進技術研究院と華中科技大学の Run Luo、Zikai Song らは、さらに一歩先へ進もうとした。一度に生成するのが一つのボックスではなく一対のボックスで、一つは前のフレーム、一つはこのフレームにあり、しかも二つのボックスが同じ人を囲んでいるとしたら、検出と追跡は同じノイズ除去の過程でまとめて片づくことになる。
問題の定義
著者らは当時のトラッカーを二種類に分け、それらに共通する難点が三つあると考えた。
- 一貫性がない。 検出してから追跡する手法では、検出器とトラッカーは別々に訓練される。検出と追跡を同時に行う手法は、一つのネットワークに収めてはいるものの、検出と追跡はやはり別々のブランチに分かれている。
- 頑健さと複雑さの両立が難しい。 検出してから追跡する手法は構造が単純だが、検出が少しずれると、追跡もそれにつれて誤る。同時に行う手法はより頑健だが、構造は複雑で、検出の精度も専用の検出器に及ばない。
- 柔軟さが足りない。 同じ動画の中でも、人が少ない区間もあれば混み合う区間もあり、ゆっくり歩く人もいれば速く走る人もいる。それなのに、ほとんどの手法は動画全体で一組の設定しか使えない。
DiffusionTrack は、一つの統一された枠組みで、この三つを同時に扱おうとした。
問題を解く
一度に一対のボックスを生成する
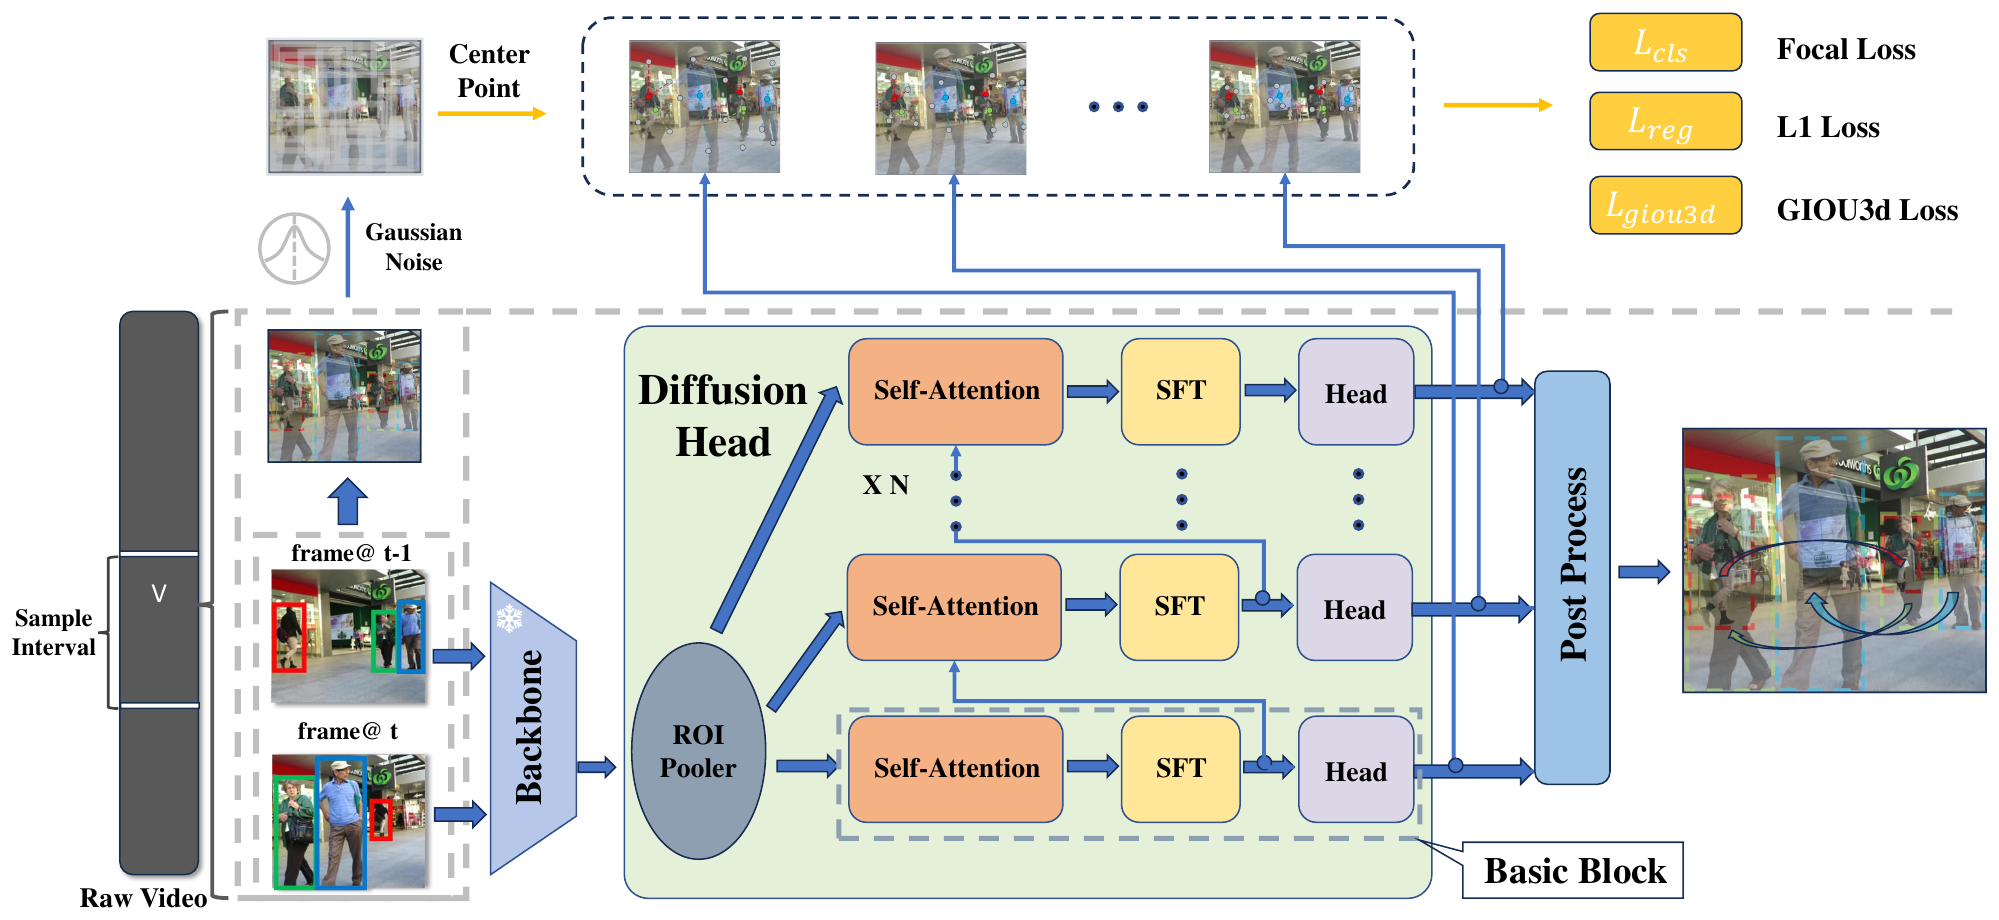
DiffusionTrack が扱うデータの単位は一対のボックスだ。同じ物体の第 フレームと第 フレームでのボックスで、八つの数からなる。ネットワークの仕事は、ノイズでかき乱された一対のボックスから、本当の一対を復元することだ。
二つのフレームが同じ画像なら、この問題はふつうの物体検出に退化する。著者らがこの点を強調するのは、検出と追跡が本当に同じモデル、同じ目標のもとで訓練されていることを示すからだ。
ネットワークは二つの部分に分かれる。
- バックボーン。 ByteTrack が事前学習した YOLOX に FPN を加え、二つのフレームでそれぞれ一回ずつ走らせ、その後は凍結して動かさない。
- 拡散ヘッド。 対になったノイズボックスのそれぞれに従って、二つのフレームの特徴マップから一片ずつ RoI 特徴を取り出し、いくつものブロックで繰り返し修正する。各ブロックはボックスの位置、クラス、そして関連付けスコアを出力する。関連付けスコアは、この一対のボックスが同じ物体かどうかを表す。
各ブロックには時空間融合モジュールがあり、対になった二つのボックスに情報を交換させる。前のフレームのボックスからはこのフレームが見え、このフレームのボックスからも前のフレームが見える。両方が一緒になって、この一対のボックスをどちらへ修正すべきかを決める。
訓練:正解をわざと汚す
訓練では、同じ動画から最大 5 フレーム離れた二フレームを取る。両方のフレームに現れる物体は、それぞれ正しいボックスの対になり、さらに余分なボックスを補って、500 対にそろえる。
続いて拡散モデルのスケジュールに従い、この 500 対のボックスにさまざまな強さのガウスノイズを加え、ネットワークにそれを復元することを学ばせる。マッチングにはハンガリアン法を使い、損失は三項ある。クラスには focal loss、座標には L1、それに 3D GIoU の項が一つ加わる。
3D GIoU は GIoU の拡張だ。一対のボックスを時間軸に沿って積み重ねると、四角錐台のような形になる。二つの四角錐台の共通部分と和集合は、二つのフレームの面積を足し合わせて計算する。これによってネットワークは、二つのフレームのボックスを別々に計算するのではなく、両方を同時に考慮するようになる。
推論:前のフレームのボックスから始める
検出は完全にランダムなボックスから始まるが、追跡はその必要がない。前のフレームで、各人がどこにいるかはもうわかっているからだ。
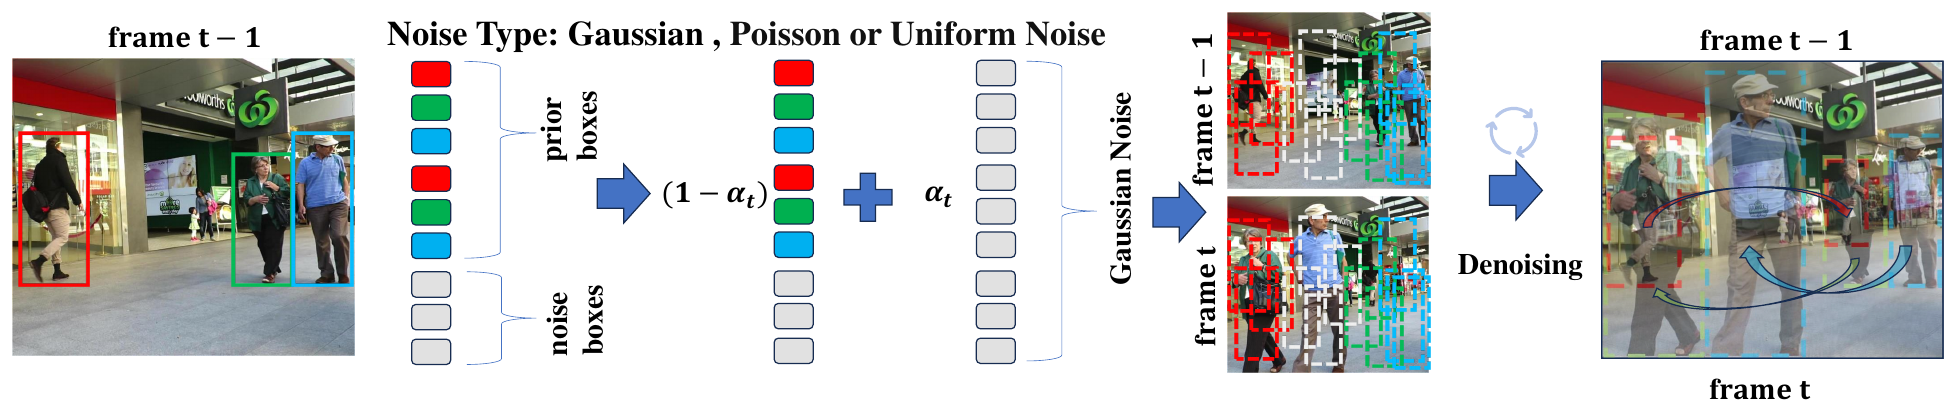
推論は三つのステップからなる。
- ボックスをそろえる。 前のフレームのボックスを何回か繰り返し、残りの分はランダムなガウスボックスで補って、決まった数にそろえる。
- ノイズを加える。 に従ってノイズを混ぜる。
- ノイズを除去する。 DDIM で何ステップか走らせ、対になったボックスを得る。
例を挙げよう。MOT17 ではボックスを 800 個に設定し、そのうち 25% に前のフレームのボックスを使う。前のフレームで 40 人を追跡できていれば、事前ボックスは 200 個になり、一人あたり 5 回繰り返すことになる。残りの 600 個はランダムなボックスだ。
事前ボックスから出発した対は、すでに追跡中の人をこのフレームまで延長する役目を負う。ランダムなボックスから出発した対は、新しく現れた人を見つけるか、以前に見失った人を拾い戻す役目を負う。
本稿で整理した計算例。
ノイズを除去したあと、関連付けスコアが 0.25 未満の対はまず捨て、さらに NMS を二回かけて重複を取り除く。残った対は、IoU で既存の軌跡につなぐ。遮蔽されて見失った軌跡は、単純なカルマンフィルタで位置を推定し、新しく見つかったボックスともう一度マッチングする。
ノイズをどれだけ加えるかは、物体がどれだけ速く動くかによる。著者らは拡散の時間ステップ を、二フレーム間の平均移動量に応じて変えるようにした。動きが大きいほどノイズも大きくし、ネットワークが修正できる余地を広げる。そのため同じ動画の別々の区間で違うノイズ量を使える。これが前に述べた「柔軟さ」だ。
議論
事前ボックスをどれだけ、ノイズは何を
アブレーションはどれも、MOT17 の訓練セットの前半で訓練し、後半でテストする。
| 事前ボックスの割合 | MOTA | IDF1 | HOTA |
|---|---|---|---|
| 0% | 71.2 | 65.9 | 58.1 |
| 25% | 73.6 | 70.0 | 60.7 |
| 50% | 74.5 | 71.2 | 61.8 |
| 75% | 74.1 | 71.4 | 61.9 |
| 100% | 72.9 | 66.8 | 58.4 |
原論文 Table 1(a) をもとに整理。MOT17 検証セット。
0% は前のフレームの情報をまったく使わず、毎フレームを一から検出することに等しい。100% はランダムなボックスをまったく補わない。両極端はどちらも悪く、中間の割合が最も良い。前者は追跡の手がかりを欠き、後者は新しく現れた人を探すランダムなボックスを持たない。
ボックスを補うときにどんなノイズを使うかでも差が出る。ガウスノイズが最も良く、HOTA は 60.7 だ。ポアソン分布や一様分布に変えたり、いっそ画像全体の大きさのボックスを補ったりすると、HOTA はどれも 59 を下回る。
ノイズ量と移動量の関係には対数関数が最も良く、HOTA は 62.6 だ。線形関数では 60.7、固定値では 58.2 になる。
ボックスが多いほど、ステップが多いほど
| ボックス数 | ステップ数 | MOTA | HOTA | 計算量 | FPS |
|---|---|---|---|---|---|
| 500 | 1 | 71.5 | 58.4 | 229.6G | 21.05 |
| 500 | 2 | 71.7 | 59.5 | 459.2G | 10.47 |
| 800 | 1 | 73.6 | 60.7 | 367.3G | 15.89 |
| 1000 | 1 | 74.1 | 61.3 | 459.1G | 13.37 |
原論文 Table 1(d) をもとに整理。MOT17 検証セット、RTX 3090 一枚、FP16。
拡散モデルの利点の一つは、訓練を終えたあとでも、ボックスの数とノイズ除去のステップ数を推論時に調整できることだ。ボックスを少し増やし、ステップを少し多く進めれば、成績は少し良くなり、速度は少し遅くなる。訓練し直す必要はない。
ただし表を見ると、ステップを増やすよりボックスを増やすほうが割がいい。同じおよそ 459G の計算量で、1000 個のボックスで 1 ステップ進めると HOTA は 61.3 だが、500 個のボックスで 2 ステップ進めても 59.5 にとどまる。著者らも付録で、多ステップのノイズ除去による向上は限られていると認めている。
検出が乱されたとき
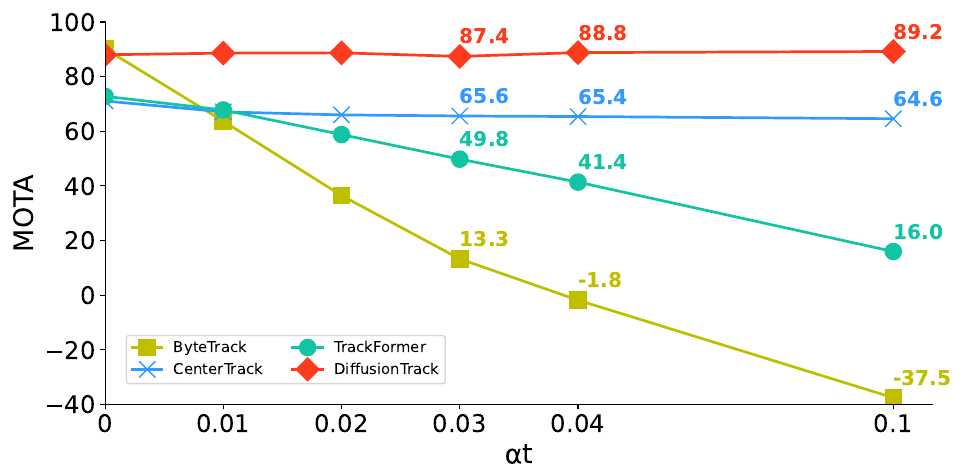
これは論文で最も目を引く図だ。著者らは検出ボックスにノイズを混ぜ、その比率を 0 から 0.1 まで上げていった。ByteTrack は検出ボックスに完全に頼っているので、摂動が 0.04 になった時点で MOTA はもうマイナスになる。DiffusionTrack はほとんど影響を受けない。
この結果は理解しやすい。DiffusionTrack にとって、ノイズを含むボックスはもともと入力そのもので、ノイズ除去は毎日やっていることだからだ。
この図を読むときは、実験の設定に注意が要る。図の説明によれば、四つのトラッカーはどれも MOT17 の訓練セットで訓練され、val-half で評価されているが、val-half はもともと訓練セットの後半だ。だから DiffusionTrack の摂動なしの MOTA は 89 近くあり、前のアブレーションの 73.6 よりずっと高い。比べられるのは曲線の傾向で、値そのものはほかの表と照らし合わせられない。
ほかの手法との比較
| データセット | 手法 | MOTA | IDF1 | HOTA | AssA |
|---|---|---|---|---|---|
| MOT17 | ByteTrack | 80.3 | 77.3 | 63.1 | 62.0 |
| MOT17 | DiffusionTrack | 77.9 | 73.8 | 60.8 | 58.8 |
| MOT20 | ByteTrack | 77.8 | 75.2 | 61.3 | 59.6 |
| MOT20 | DiffusionTrack | 72.8 | 66.3 | 55.3 | 51.3 |
| DanceTrack | OC-SORT | 89.6 | 54.6 | 54.6 | 40.2 |
| DanceTrack | DiffusionTrack | 89.3 | 47.5 | 52.4 | 33.5 |
MOT17、MOT20 は原論文 Table 2、DanceTrack は原論文 Table 3 をもとに整理。いずれもテストセット、独自検出。
検出と追跡を同時に行う手法の中では、DiffusionTrack が原論文の表で最も良い。MOT17 の MOTA は 77.9 で、TrackFormer の 74.1 や MOTR の 71.9 より高い。だが検出してから追跡する ByteTrack や OC-SORT と比べると、三つのデータセットのどれでもまだ後れを取っている。
分けて見ると、DiffusionTrack の強みは検出にある。DanceTrack での DetA は 82.2 で、OC-SORT の 80.4 よりも高い。ところが AssA は 33.5 しかなく、OC-SORT より 6.7 低い。MOT17 での ID スイッチは 3,819 回で、ByteTrack はわずか 2,196 回だ。
著者らは、第 フレームにだけノイズを加えるベースライン版も作った。MOT17 での HOTA は 55.9 で、DiffusionTrack より 4.9 低い。混雑した MOT20 では 42.5、動きの複雑な DanceTrack では 44.0 しかない。著者らの説明では、ベースライン版は前のフレームのボックスからこのフレームへの回帰しか学ばないが、二つのフレームに一緒にノイズを加える過程は、ネットワークに別々の物体を見分けることを学ばせる。
コスト
拡散ヘッドには 2.36 億個の訓練可能なパラメータがあり、RTX 3090 を 8 枚使って約 30 時間の訓練が要る。推論で 800 個のボックスを 1 ステップ進めると、1 フレームあたりの計算量は 367G で、およそ 16 FPS だ。著者らは付録で、MOT20 の小さな物体はうまく扱えないとも述べている。
結論
DiffusionTrack は、追跡をノイズ除去の問題として定式化した。同じ人の二つのフレームでのボックスは、一対のノイズボックスから少しずつ修正して作り出される。検出と追跡は同じネットワーク、同じ目標で訓練される。ボックスの数とノイズ除去のステップ数は推論時に調整でき、検出ボックスが乱されても安定している。
弱点は関連付けにある。検出の指標はとても良いのに、身元の指標はカルマンフィルタと IoU に頼るいくつかの手法にまだ追いつかず、しかも自分自身も最後には IoU とカルマンフィルタを使って軌跡をつないでいる。
拡散モデルには、追跡でのもう一つの使い道がある。半年後の DiffMOT は、それをボックスの生成には使わず、人が次にどこへ歩いていくかの予測に使った。