原論文
CO-MOT: Boosting End-to-end Transformer-based Multi-Object Tracking via Coopetition Label Assignment and Shadow Sets
- 発表先
- ICLR 2025国際会議
- arXiv への初回投稿
- arXiv:2305.12724
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingcomot2023,
  title = {{CO-MOT: Boosting End-to-end Transformer-based Multi-Object Tracking via Coopetition Label Assignment and Shadow Sets}},
  author = {Feng Yan and Weixin Luo and Yujie Zhong and Yiyang Gan and Lin Ma},
  year = {2023},
  eprint = {2305.12724},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.12724}
}
MOTR は追跡を丸ごと Transformer に任せた。一人にひとつのクエリがあり、クエリはその人についてフレームからフレームへと進んでいく。カルマンフィルタもハンガリアン法も要らない。
この設計は美しいが、成績は ByteTrack のような「検出してからマッチングする」手法にずっと追いつけなかった。のちの MOTRv2 は思い切って YOLOX の検出器を外付けし、成績は上がったが、計算量も上がり、もとの「エンドツーエンド」の利点は大半が失われた。
美団の Feng Yan、Weixin Luo らは MOTR を見直し、問題は追跡ではなく、訓練時のラベルの割り当て方にあることに気づいた。
問題の定義
置き去りにされた検出クエリ
MOTR のデコーダには二種類のクエリがある。トラッククエリはすでに追跡中の人を受け持ち、フレームごとに前のフレームから引き継がれる。検出クエリは新しく現れた人を見つける役目だ。
訓練時のラベルの割り当ては TALA(tracking aware label assignment)と呼ばれる。まず追跡中の人を対応するトラッククエリに割り当て、残った新しく現れた物体だけを、検出クエリとの二部マッチングに回す。
問題は「残った」ものが少なすぎることだ。著者らが DanceTrack で数えたところ、新しく現れた人と追跡中の人の比は 213 対 25,483 だった。舞台のダンサーはほぼ最初のフレームからそこにいて、その後に入ってくる人はめったにいない。検出クエリは、ほとんどの時間、学ぶべき正例がない。
さらに厄介なのは、TALA が検出クエリに「すでに誰かが追っている物体には手を出すな」と教えているようなものだということだ。推論で、ある軌跡のトラッククエリが対象を見失っても、検出クエリはその人を拾いに行かない。
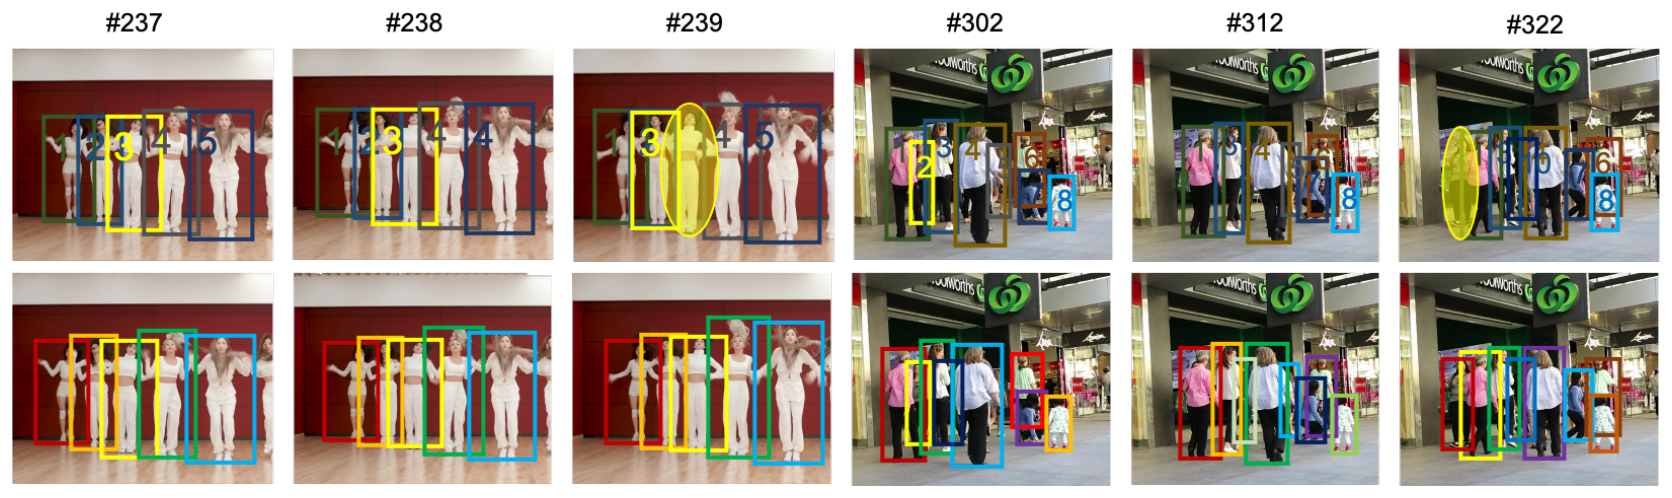
上段は MOTR の追跡結果、下段は同じモデルからトラッククエリを外し、検出だけを行ったものだ。下段では全員が囲まれている。つまり MOTR は検出ができないのではなく、トラッククエリがそばにいると検出が抑え込まれてしまうのだ。
すべてのボックスを検出として測る
著者らは、デコーダが出力したすべてのボックスを、追跡か検出かを区別せず、すべて検出結果として扱い、mAP で測った。
| モデル | 訓練にトラッククエリ | 推論にトラッククエリ | mAP |
|---|---|---|---|
| MOTR | ✓ | ✓ | 42.5 |
| MOTR | ✓ | 60.6 | |
| MOTRv2 | ✓ | ✓ | 70.7 |
| MOTRv2 | ✓ | 72.1 | |
| CO-MOT | ✓ | ✓ | 69.1 |
原論文 Table 1 をもとに整理。DanceTrack 検証セット、デコーダの最終層。
同じ MOTR でも、推論でトラッククエリを外すだけで、mAP は 42.5 から 60.6 へと 18.1 も跳ね上がる。MOTRv2 には YOLOX が出す検出結果があるので、トラッククエリを外しても 1.4 増えるだけで、検出の問題は外付けの検出器でほとんど解決されている。
CO-MOT の目標は、外付けの検出器に頼らずに、MOTR 自身の検出能力を取り戻すことだ。
問題を解く
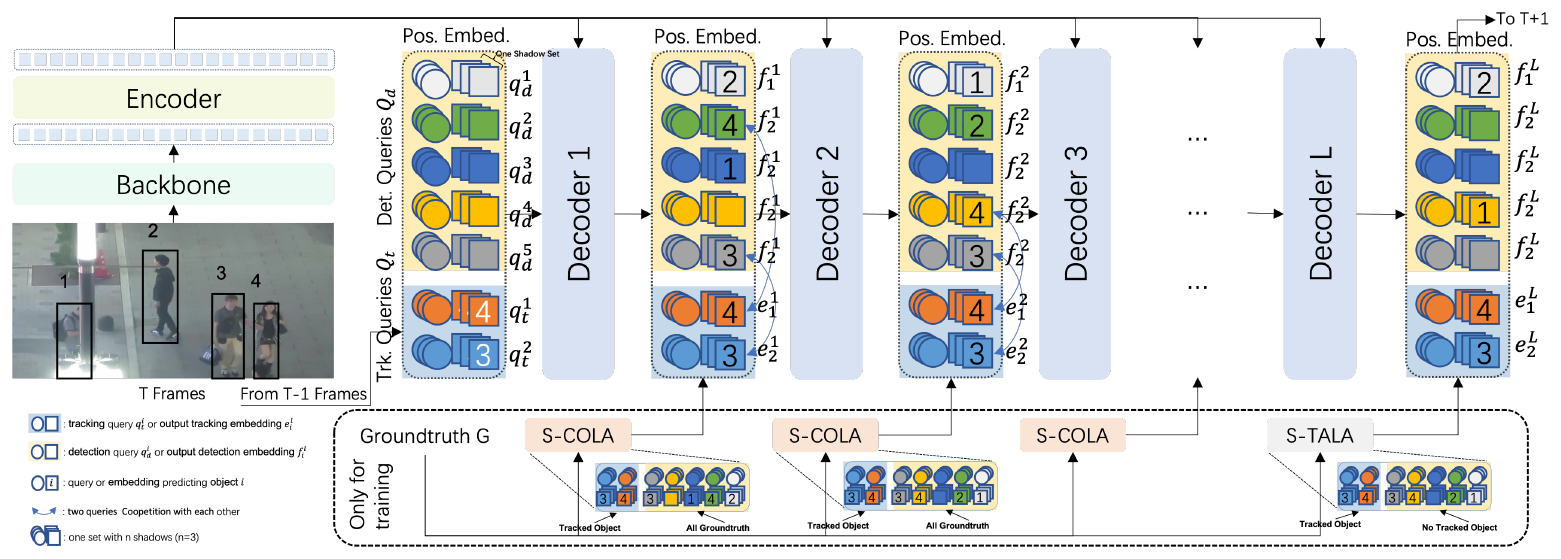
CO-MOT の構成は MOTR とまったく同じで、変えたのは訓練時のラベルの割り当てだけだ。変更は二つの部分に分かれる。
協力しながら競争する
一つ目の変更は COLA(coopetition label assignment)と呼ばれる。coopetition は協力(cooperation)と競争(competition)を合わせた造語だ。
デコーダは六層あり、COLA は最初の五層の検出クエリを、新しい物体に加えて追跡中の人にも割り当てられるようにする。つまり中間の層では、同じ人を一つのトラッククエリと一つの検出クエリが同時に予測していることがある。
最終層は相変わらず TALA を使い、追跡中の人はトラッククエリだけに属する。そうしないと、推論で同じ人に二本の軌跡が現れてしまう。
こうすることの利点は、デコーダの中の自己注意から来る。すべてのクエリは互いを見ていて、検出クエリが見ているのはこのフレームの画面、トラッククエリは過去の記憶を持っている。両者が同じ人を予測しているとき、検出クエリはこのフレームの情報をトラッククエリに渡せるので、外観が大きく変わったときに手を貸してやれる。
中間の層では協力し、最終層では競争する。だから coopetition と呼ぶ。
どのクエリにも影がある
二つ目の変更は影の集合(shadow set)だ。
DETR 系のモデルは一対一のマッチングを使うので、一つの物体に対して正例を得られるクエリは一つだけだ。Co-DETR や H-DETR の対策は一対多で、複数のクエリに同じ物体を学ばせる。CO-MOT のほうは、各クエリを 個の影に複製し、組全体で同じ物体を受け持たせる。
影の初期化には工夫がある。完全にランダムだと、同じ組の影どうしの差が大きすぎて、収束しにくい。完全に同じだと、わざわざ組にした意味がなくなる。著者らは同じ組を同じ学習可能なベクトルで初期化し、そこに標準偏差 のノイズを加えた。差は最初ほとんど見えないが、訓練の終わりには 程度まで広がる。
訓練では、影の組は代表を一つ選んでマッチングに出す。トラッククエリの組は、そのまま前のフレームの対象と結びつく。検出クエリの組は、まず各影の各物体に対するマッチングコストを計算し、その中で最大のものを代表とする。つまり、この組を誰に割り当てるかは、組の中で最も出来の悪い一つが決める。組の中のほかの影はマッチングの結果を共有し、一緒に正例を受け取る。
推論では逆に、組の中で最も低い信頼度スコアで、その組が人を追えているかどうかを判断し、合格したら、スコアが最も高い影のボックスを出力する。
正例を数える例
一つの訓練クリップを使って、二つの変更で検出クエリがどれだけ多く学べるようになったかを見てみよう。
CO-MOT は訓練で毎回 5 フレームを取る。10 人のダンサーが第 1 フレームからずっと画面の中にいて、途中で誰も出入りせず、デコーダは 6 層だとする。
- TALA。 第 1 フレームにはまだトラッククエリがないので、10 人は全員が新しい物体で、検出クエリに属する。第 2 から 5 フレームでは、全員がトラッククエリに属する。検出クエリの正例は各層 10 個だけで、6 層で合計 60 個だ。
- COLA。 最初の 5 層では、検出クエリは 5 フレームのすべての物体に割り当てられるので、各層 50 個、合計 250 個になる。最終層は 10 個のままだ。合わせて 260 個になる。
- さらに影を加える。 各組の 3 つの影がどれも正例を受け取るので、検出クエリの正例は 780 個になる。
本稿で整理した計算例。
トラッククエリの正例は一つも減っておらず、検出クエリの正例は 60 個から 780 個になった。
議論
二つの変更それぞれの貢献
| 設定 | HOTA | DetA | AssA | IDF1 |
|---|---|---|---|---|
| MOTR 基準 | 56.4 | 71.8 | 44.6 | 57.5 |
| +COLA | 60.2 | 73.2 | 49.7 | 62.4 |
| +影の集合 | 59.0 | 72.6 | 48.2 | 59.6 |
| 両方を加える | 61.8 | 73.5 | 52.2 | 63.3 |
原論文 Table 4 をもとに整理。DanceTrack 検証セット。
COLA だけで HOTA は 3.8、影の集合だけで 2.6 上がり、両方合わせると 5.4 上がる。
面白いのは、DetA は 71.8 から 73.5 にしかならないのに、AssA は 44.6 から 52.2 に跳ね上がることだ。COLA は表向きには検出クエリにより多くの正例を与えるもので、検出を助けるはずに見えるが、実際に助けているのは関連付けだ。
検出クエリは本当に手を貸しているのか
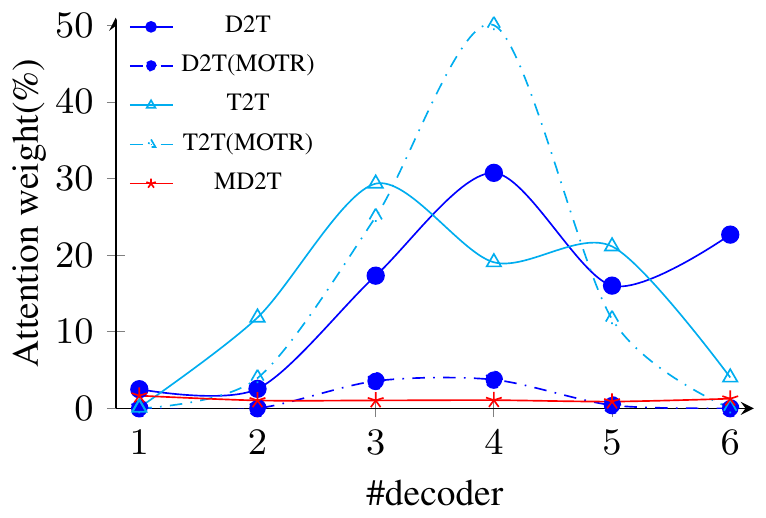
これを確かめるため、著者らはデコーダの各層のアテンションの重みを描いた。二つのボックスの IoU が 0.7 を超えれば、同じ人を予測しているとみなす。
CO-MOT では、同じ人を予測している検出クエリのトラッククエリへの寄与が、第 3 層から 15% を超え、第 4 層と第 6 層ではトラッククエリの自分自身へのアテンションさえ上回る。MOTR では、同じ値が第 4 層でわずか 3.74% だが、CO-MOT では 30.74% だ。
MOTR の検出クエリとトラッククエリは別々の人を受け持っているので、互いに話すことはあまりない。CO-MOT は中間の層で両者に同じ人を見張らせるので、情報が流れていく。
影の細部
- 初期化。 同じベクトルに微小なノイズを加えた場合の HOTA は 61.5、完全な複製は 60.6、完全なランダムは 59.6 だ。
- 代表の選び方。 訓練では最大のコスト、推論では最も低いスコアを使う組み合わせが最も良い。推論を最も高いスコアに変えると、訓練でどう選んでも最悪になる。訓練で最も難しい影にマッチングを決めさせると、モデルはどの影もきちんと学ばざるをえなくなる。
- 影の数。 3 つが最も良く(61.8)、2 つでは 61.5 だ。それより多いと収束しにくい。
- COLA を何層で使うか。 第一層だけで使うと 59.0、最初の三層で 59.6、最初の五層で 59.9 と、多く使うほど良い。
ほかの手法との比較
DanceTrack テストセットでは、DanceTrack だけで訓練した CO-MOT の HOTA は 65.3 で、MOTR より 11.1 高く、同じく ResNet-50 を使う MeMOTR(63.4)よりも高い。CrowdHuman を加えて一緒に訓練した CO-MOT+ は HOTA 69.4 で、YOLOX を外付けした MOTRv2(69.9)との差はわずか 0.5、AssA はほとんど同じだ(58.9 対 59.0)。
| モデル | パラメータ | 計算量 | 速度 | HOTA |
|---|---|---|---|---|
| MOTR | 40M | 173G | 19 FPS | 54.2 |
| MOTRv2 | 139M | 455G | 14 FPS | 69.9 |
| CO-MOT+ | 40M | 173G | 19 FPS | 69.4 |
原論文 Figure 4 をもとに整理。DanceTrack テストセット。
この表が CO-MOT の最も説得力のあるところだ。MOTR と同じパラメータ数と計算量で、成績は MOTRv2 に追いつき、計算量はその 38%、速度は 1.4 倍だ。変えたのは訓練のしかただけで、推論では余分なコストを一切払っていない。
BDD100K では TETA が 52.8 で、MOTR の 50.7 より高いが、MOTRv2 の 54.9 よりは低い。ただし AssocA は 56.2 で、MOTRv2 の 51.9 より高い。
MOT17 はやはり越えられない
MOT17 テストセットでは、CO-MOT の HOTA は 60.1 で、MOTR の 57.8 より良いが、ByteTrack の 63.1 にはまだ届かない。MOTA の 72.6 に至っては、ByteTrack の 80.3 に大きく水をあけられている。
著者らの説明は二点ある。第一に、MOT17 の訓練セットはおよそ 5,000 フレームしかなく、Transformer には少なすぎる。第二に、MOT17 には小さな対象が多い。面積が画面の 0.5% に満たないボックスは、MOT17 では 60.26% を占めるが、DanceTrack では 1.17% しかない。論文に挙げられた失敗例は、ほとんどがはっきり見えている人が検出されていないものだ。
CO-MOT は、MOTR の検出能力が追跡に抑え込まれないようにしたが、MOTR そのものの小さな物体を検出する能力までは変えられない。
結論
CO-MOT は MOTR の訓練の盲点を一つ見つけた。検出クエリは「すでに追っている人には手を出すな」と教え込まれていて、そのせいでトラッククエリが見失ったとき、その人を拾い戻せる者が誰もいなかった。
COLA は二種類のクエリに中間の層で一緒に同じ人を見させ、影の集合は各物体を複数のクエリで一緒に学ばせる。どちらの変更も訓練にしか影響せず、推論の構成は MOTR とまったく同じだ。
DanceTrack では、検出器を外付けしない CO-MOT+ と、YOLOX を外付けした MOTRv2 の差は HOTA でわずか 0.5 で、計算量はその四割にも満たない。小さな対象が多く、データも少ない MOT17 になると、検出してからマッチングする手法との差はまだ残っている。