原論文
TrackFormer: Multi-Object Tracking with Transformers
- 発表先
- CVPR 2022国際会議
- arXiv への初回投稿
- arXiv:2101.02702
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingtrackformer2021,
  title = {{TrackFormer: Multi-Object Tracking with Transformers}},
  author = {Tim Meinhardt and Alexander Kirillov and Laura Leal-Taixe and Christoph Feichtenhofer},
  year = {2021},
  eprint = {2101.02702},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2101.02702}
}
2019 年の Tracktor は、検出器のボックス回帰ヘッドが前のフレームのボックスをそのまま今のフレームまで動かせること、追跡のためにほとんど別途訓練しなくてよいことを示した。CenterTrack は中心点と変位に置き換えたが、同じ路線だ。著者らはこの種の手法を「回帰による追跡」(tracking-by-regression)と呼ぶ。
ただ、この種の手法でトップクラスの成績を出そうとすると、結局は別のものを足すことになる。Tracktor には re-ID と運動モデルが要り、ほかの手法はグラフ最適化をつなげる。理由は、各ボックスの回帰が独立した局所的なものだからだ。ボックス自身は自分が誰なのかも知らないし、隣のほかの軌跡が何をしているのかも知らない。
2020 年、DETR は物体検出を集合予測として定式化した。学習可能な物体クエリ(object query)の組を Transformer デコーダに通すと、重複のないボックスの組が直接出てくる。アンカーボックスも非最大値抑制も要らない。
Tracktor の二人の著者、ミュンヘン工科大学の Tim Meinhardt と Laura Leal-Taixé は、Facebook AI Research の Alexander Kirillov、Christoph Feichtenhofer と組んで、この発想を追跡に持ち込んだ。一つのクエリが一つの物体を表せるのなら、そのクエリに物体を追わせて次のフレームへ進ませれば、それがもう追跡ではないか?
問題の定義
動画の中に 個の物体があり、各物体 には軌跡 がある。これは物体が画面に入ってから出ていくまでの各フレームのボックスを記録したもので、遮蔽されているフレームも含む。
著者らは複数物体追跡を、フレームごとの集合予測問題として定式化した。モデルは各フレームで、身元つきのボックスの組を出力する。そこには、すでに追跡している物体が今どこにいるかと、どれが新しく現れた物体かが含まれる。
検出、身元の維持、新しい軌跡の生成は、すべて一回のデコードの中で完了する。別のマッチングの段階もグラフ最適化も要らず、外観や運動を明示的にモデル化する必要もない。著者らはこの新しいパラダイムを「アテンションによる追跡」(tracking-by-attention)と呼んだ。
問題を解く
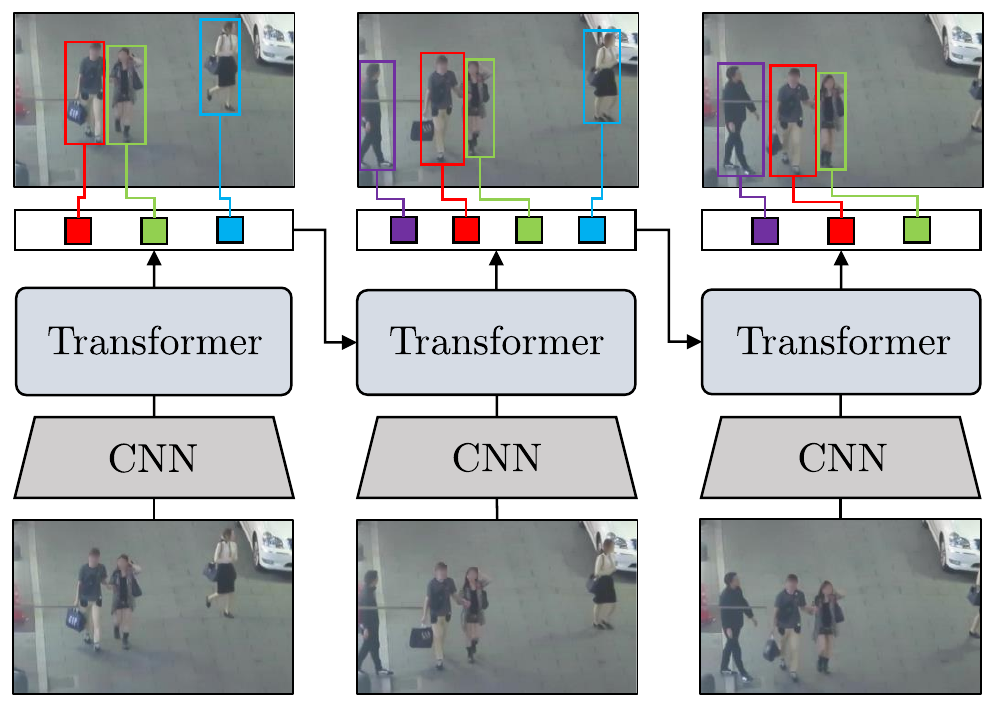
アーキテクチャ
TrackFormer の骨格は Deformable DETR そのものだ。
- ResNet-50 で画像特徴を抽出する。
- Transformer エンコーダは 6 層で、画像特徴に自己注意をかける。
- Transformer デコーダは 6 層で、クエリ同士で自己注意をかけ、さらにエンコード済みの画像特徴に交差注意をかける。
- MLP で各出力埋め込みをボックスとクラスに写す。
DETR との違いは、すべてデコーダのクエリにある。
二種類のクエリ
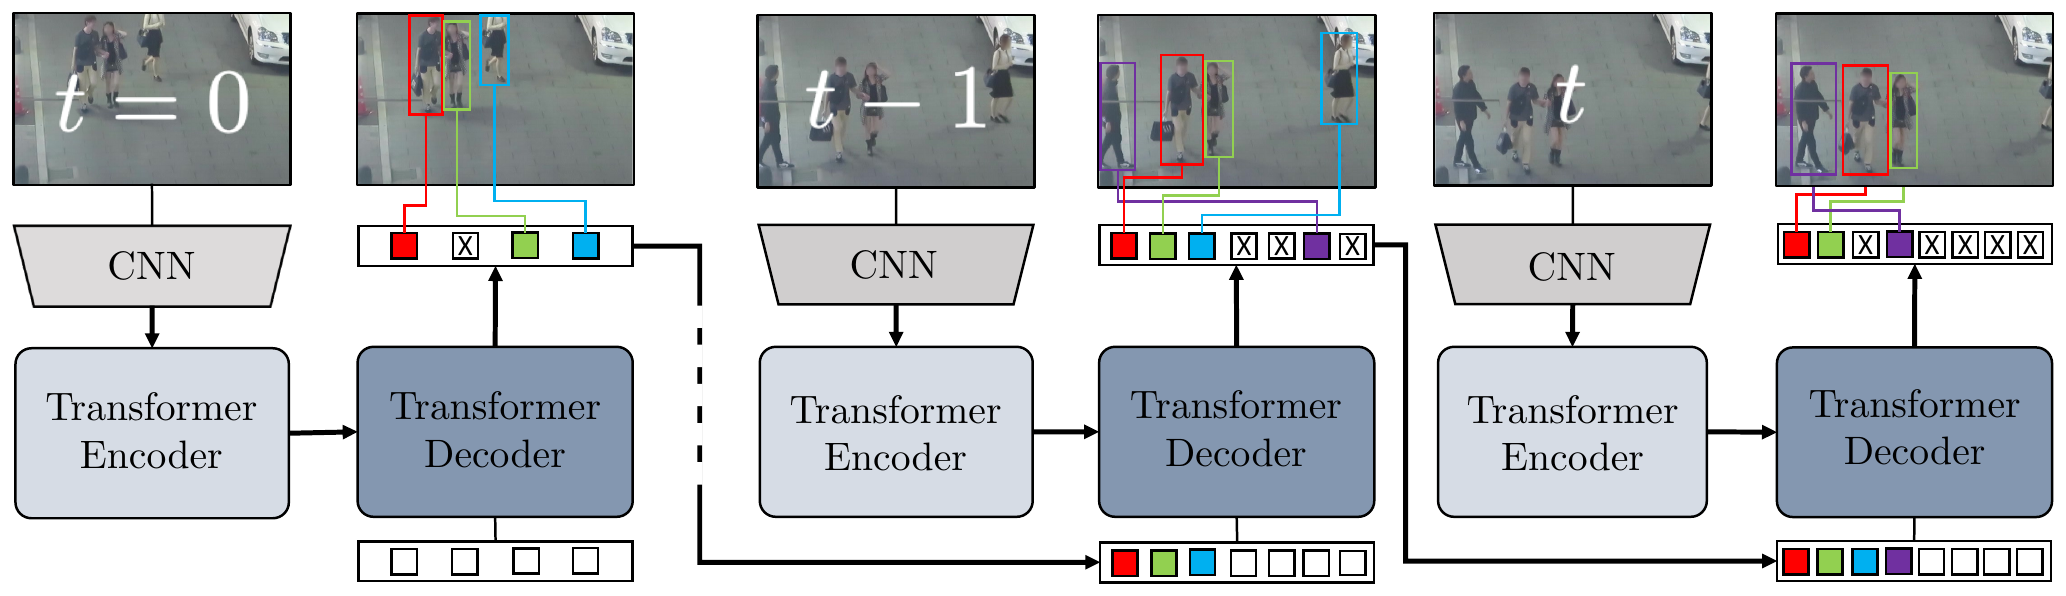
物体クエリ(object query) は DETR と同じく、固定された学習可能な埋め込みの組で、どのフレームでも新しい物体を見つける役目を担う。MOT17 は一フレームあたり最大 52 人なので、著者らは物体クエリを 500 個使った。クエリの数は画面内の物体数よりずっと多くないと、うまく働かない。
トラッククエリ(track query) がこの論文の核心だ。あるフレームで物体クエリが物体を検出すると(分類スコアが 0.4 より大きい)、そのクエリのデコーダ最終層の出力埋め込みが、そのまま次のフレームのトラッククエリの一つになり、身元番号を一つ持つ。
次のフレームでは、デコーダが 個のクエリを同時に処理する。トラッククエリは交差注意で新しい画像の中から自分の物体を探し、更新されたボックスを出力する。更新された埋め込みはさらにその次のフレームへ渡される。身元はこうして一フレームずつ自己回帰的に受け渡され、最初から最後までマッチングは一切ない。
二種類のクエリの間の自己注意にも役割がある。物体クエリはトラッククエリが「見えている」ので、すでに追跡している人をもう一度検出しない。
トラッククエリが自分の物体を見つけやすいように、実装にはさらに二つの工夫がある。deformable attention におけるトラッククエリの参照点は、前のフレームのボックスの中心にそのまま設定する。デコーダの交差注意は前のフレームと今のフレームの特徴マップを同時に見て、時間エンコーディングで区別する。
軌跡の終了と復帰
トラッククエリの分類スコアが 0.4 を下回るか、別のボックスとの IoU が 0.9 を超えると、そのトラッククエリは削除される。著者らによると、ひどく重なった重複ボックスの中にはデコーダの自己注意では処理しきれないものがあるので、このごく緩い非最大値抑制を残した。
削除されたトラッククエリはすぐには捨てられず、さらに 5 フレームのあいだデコードを続ける。ただしこの間は結果を出力しない。スコアが 0.4 以上に戻れば、通常の軌跡に復帰する。これは短時間の再識別で、頼っているのはやはり同じアテンションの仕組みだ。re-ID を別に訓練する必要はない。
ただしトラッククエリには位置の情報が入っているので、物体が長く遮蔽されたり遠くまで移動したりすると、もう見つけ直せない。
訓練
トラッククエリが物体についていけるようになるには、隣り合う二フレームで訓練する必要がある。
- 第 フレームでは、物体クエリだけで検出する。
- 検出された物体はトラッククエリになり、物体クエリと一緒に第 フレームへ送られる。
第 フレームの各出力は、正解物体か背景のどちらかに割り当てる必要がある。、 を二つのフレームそれぞれの正解の身元の集合とすると、割り当ての規則は次のとおりだ。
- (両方のフレームにいる):トラッククエリを身元どおりに直接対応させる。これはハードな割り当てだ。
- (前のフレームにはいて、今のフレームで消えた):対応するトラッククエリは背景と予測しなければならない。
- (新しく現れた):物体クエリに任せ、DETR のハンガリアン法でコストが最小のマッチングを求める。
マッチングのコストは、クラス確率とボックスの差で構成される。
ここでボックスのコストは、L1 距離と一般化 IoU を組み合わせたものだ。
割り当てが終わると、各クエリの損失は次のようになる。
割り当てられなかったクエリは、すべて背景として扱う。
三種類のデータ拡張
隣り合う二フレームだけで訓練すると、モデルが目にする追跡の状況は単純すぎる。著者らは三種類のデータ拡張を加えた。
- フレーム間隔を広げる。 第 フレームはすぐ前のフレームとは限らず、 の周辺の一定範囲からサンプリングする。カメラの移動や低フレームレートを模擬するためだ。
- 検出漏れ。 確率 で一部のトラッククエリを取り除き、それらの物体は第 フレームで物体クエリが検出し直さなければならないようにする。これが二種類のクエリを一緒に訓練できるようにする鍵だ。
- 誤検出。 確率 で、あるトラッククエリに偽のトラッククエリを一つ追加する。偽のクエリは、前のフレームで背景と判定され、しかもそのトラッククエリと大きく重なっている出力埋め込みから取る。遮蔽のときに軌跡を削除する練習だ。
データ
Transformer は大量のデータを必要とするが、MOT17 には訓練動画が 7 本しかない。著者らは CenterTrack と同じく、CrowdHuman の静止画で隣り合う二フレームを模擬した。同じ画像にランダムな拡大縮小と切り抜きをかけ、その幅は最大 20% だ。
独自検出のモデルは、まず CrowdHuman でゼロから 85 epoch 訓練し、続いて CrowdHuman と MOT17 を混ぜて 40 epoch 微調整する。32GB の GPU 7 枚でおよそ二日かかる。
議論
構成要素のアブレーション
| 設定 | MOTA | Δ | IDF1 | Δ |
|---|---|---|---|---|
| TrackFormer 完全版 | 71.3 | 73.4 | ||
| CrowdHuman 事前学習を除く | 69.3 | −2.0 | 71.8 | −1.6 |
| さらにクエリの再識別を除く | 69.2 | −0.1 | 70.4 | −1.4 |
| さらに誤検出拡張を除く | 68.4 | −0.8 | 70.0 | −0.4 |
| さらにフレーム間隔拡張を除く | 64.0 | −4.4 | 59.2 | −10.8 |
| さらにトラッククエリを除く | 61.0 | −3.0 | 45.1 | −14.1 |
原論文 Table 3 をもとに整理。MOT17 訓練セットを前半と後半に分割、独自検出。各行は前の行からさらに一項目を除いたもの。
この表は行ごとに累積していて、各行は前の行より構成要素が一つ少ない。
いくつかの訓練の工夫のうち、影響が最も大きいのはフレーム間隔を広げる拡張で、除くと MOTA が 4.4 ポイント、IDF1 が 10.8 ポイント下がる。すぐ隣の二フレームだけで訓練すると、モデルはすぐに過学習し、物体が大きく動いたときにどうついていけばよいかを学べない。
最後の行ではトラッククエリまで除き、モデルは検出だけを訓練して、CenterTrack 流の中心距離による貪欲マッチングを使う。IDF1 はさらに 14.1 ポイント下がる。この行が表しているのは、従来のルールに頼ったマッチングのやり方だ。
MOT17 と MOT20
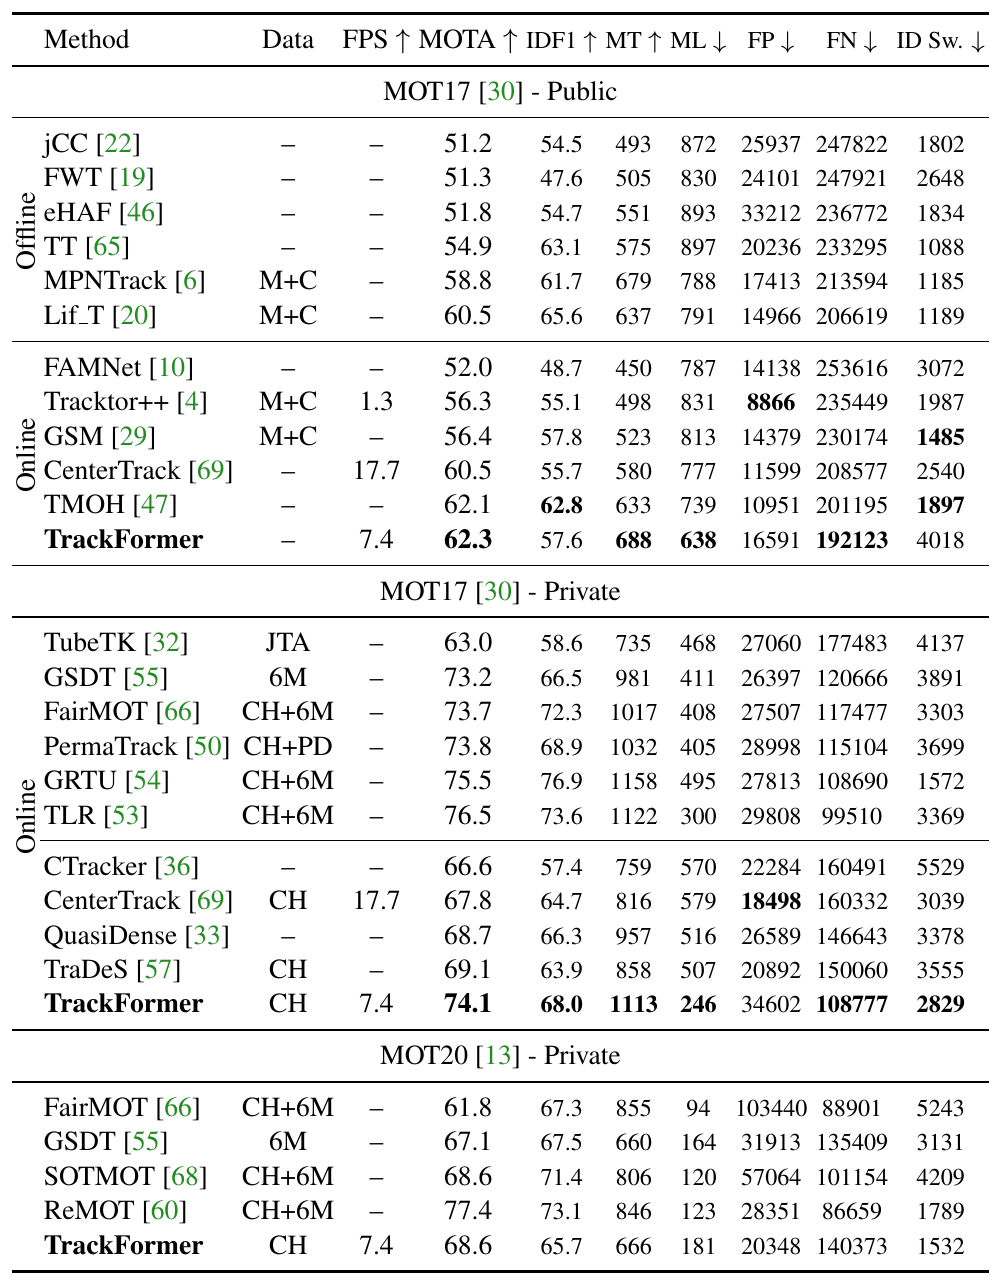
独自検出では、TrackFormer は MOT17 で MOTA 74.1、IDF1 68.0 を出した。追加データとして CrowdHuman だけを使う手法の中では、MOTA が二番手の TraDeS より 5.0 ポイント、CenterTrack より 6.3 ポイント高い。FN はわずか 108,777 で、CenterTrack より五万以上少なく、再現率がずっと高い。
ただし表には、追加の追跡データセットを 6 つ使った FairMOT、GRTU、TLR といった手法もあり、IDF1 はどれも TrackFormer より高い。MOT20 では、MOTA は SOTMOT と並んだが、ReMOT より 9 ポイント近く低く、IDF1 でも後れを取っている。
速度は毎秒 7.4 フレームで、CenterTrack の 17.7 の半分にも届かない。
公開検出でどう比べるか
TrackFormer は検出ボックスを受け取って関連付ける手法ではないので、公開検出をそのまま入力にはできない。著者らは代わりにフィルタリングを使い、ある公開検出ボックスとの IoU が 0.5 を超える物体クエリだけが新しい軌跡を始められるようにした。
CenterTrack にも似たフィルタリングがあるが、こちらは中心点を使い、公開検出の中心がボックスの中に入っていればよい。著者らは付録で二つのフィルタリングを比べ、中心点の版では、品質に大きな差がある三種類の公開検出(DPM、FRCNN、SDP)でほぼ同じ結果が出ることを見つけた。検出の良し悪しが結果に反映されていないということだ。IoU の版はより厳しく、スコアはどれも下がるが、「公開検出を入力にする」という本来の趣旨により近い。
IoU のフィルタリングのもとで、TrackFormer の MOTA は 62.3 で、最良のオンライン手法と同等だった。ただし ID スイッチは 4,018 で、表の中で最も多い。
マスクを加える
TrackFormer にはセグメンテーションヘッドも加えられ、MOTS20 で複数物体の追跡とセグメンテーションを行える。著者らによると、マスクと一緒に訓練すると、ボックスだけの追跡で見ても IDF1 が 1.2 ポイント上がる。マスクの情報が、訓練中の曖昧な遮蔽の状況のいくつかを解決する助けになった。
限界とその後
TrackFormer は隣り合う二フレームだけで訓練するので、トラッククエリが学ぶ時間情報は短い。著者ら自身も論文で、二フレームを超えて訓練・推論する手法には大きな可能性があるはずだと書いている。
数か月後の MOTR はまさにそうした。訓練を短いクリップ一本分まで延ばし、トラッククエリを複数フレームにわたって受け渡し、軌跡の NMS や再識別といったルールも取り除いた。また、MOTR と後の MOTRv2 が比較表で引用している TrackFormer の成績は MOT17 で MOTA 65.0、IDF1 63.9 だが、これは初期の版の数字だ。正式版は CrowdHuman で隣接フレームを模擬して訓練した結果、ここで見た 74.1 と 68.0 まで上がった。
結論
TrackFormer は一つのクエリに一つの物体を表させ、検出したらその物体について一フレームずつ進んでいく。新しい物体は物体クエリに、既存の物体はトラッククエリに任せ、両者は同じデコーダの中で互いを見ることができる。マッチングという段階は、こうして消えた。
数字ですべてにおいて先頭に立ったわけではなく、速度も遅い。それでも追跡の別の書き方を示し、その後の MOTR も MOTRv2 も、この書き方の上で続けられた。
二年前、Meinhardt と Leal-Taixé は Tracktor で、追跡用に訓練しなくてもうまく追えることを示した。今度は、追跡は GPU 7 枚で二日かけて訓練するものになった。