原論文
SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
- 発表先
- ICLR 2024国際会議
- arXiv への初回投稿
- arXiv:2310.06770
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelevaluationswebench2023,
  title = {{SWE-bench: Can Language Models Resolve Real-World GitHub Issues?}},
  author = {Carlos E. Jimenez and John Yang and Alexander Wettig and Shunyu Yao and Kexin Pei and Ofir Press and Karthik Narasimhan},
  year = {2023},
  eprint = {2310.06770},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2310.06770}
}
2023 年当時、言語モデルのプログラミング能力は、たいてい HumanEval のような評価で測られていた。関数シグネチャと説明を与えて関数の本体を書かせ、単体テストをいくつか走らせる。問題はどれも独立していて、数行のコードで解ける。
現実のソフトウェア開発はそうではない。バグを一つ直すにも、何千ものファイルがあるプロジェクトの中から関係するコードを探し出し、異なるファイルの関数が互いにどう呼び出し合っているかを理解し、込み入ったロジックの中から間違っている一行を見つけ出し、さらにほかの機能を壊さないように直さなければならないことがある。
当時の評価は次々と満点近くまで解かれてしまい、最も強いモデルが実際にどこまでできるのかを、もう測れなくなっていた。Princeton の Jimenez、Yang らは GitHub に目を向けた。オープンソースプロジェクトには、実際の問題報告(issue)と、それを実際に直したプルリクエスト(pull request)が大量にあり、プロジェクト自身のテストもついている。
問題の定義
良い評価は、既存のモデルがつまずくほど難しく、しかも答えを検証しやすくなければならない。プログラミングの問題の長所はテストを走らせられることだが、既存のプログラミングの評価は簡単すぎるし、きれいすぎる。
著者らが求めた評価は、いくつかの条件を満たすものだ。問題は実際の仕事から取られ、入力は長くて雑多で、修正箇所は複数のファイルに散らばっていることもあり、正誤はプロジェクトにもともとあるテストで判定する。そして新しい問題を継続的に追加でき、モデルが訓練時に答えを見てしまっている事態を避けられること。
問題を解く
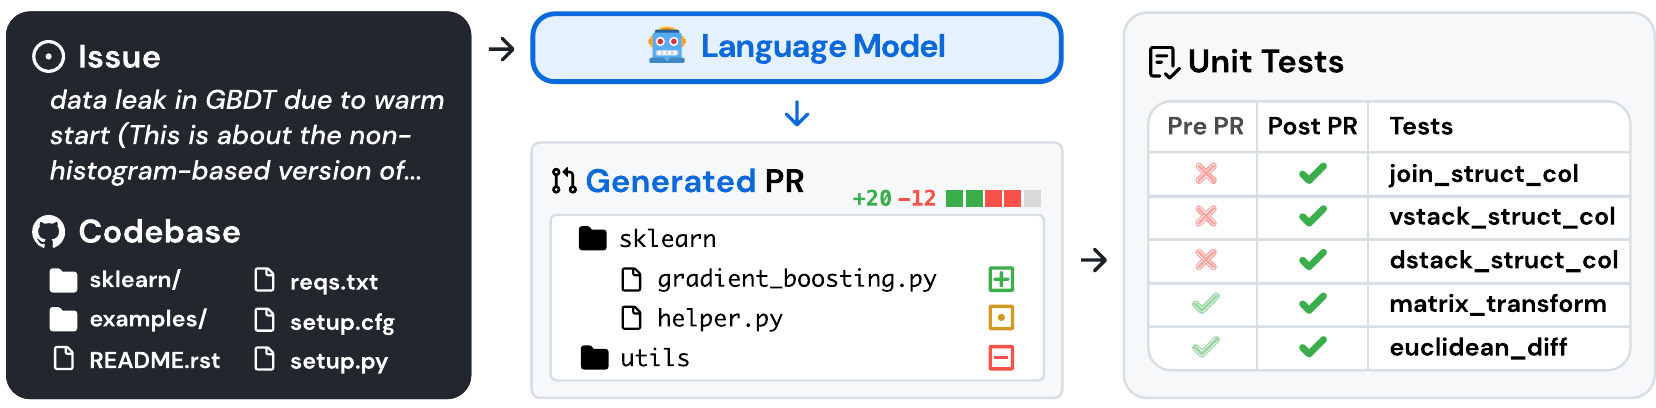
タスクは単純明快だ。モデルに issue の本文とコードベース全体を与え、修正を生成させる。どの行を変えるかは patch ファイルの形式で表す。評価時には Unix の patch プログラムで修正を適用し、その問題に関係するテストを実行する。修正が問題なく適用でき、しかもテストがすべて通ってはじめて、解決とみなす。評価全体の成績は、解決できた問題の割合だ。
9 万件のプルリクエストから 2,294 問へ
著者らは三段階で絞り込んだ。
- プロジェクトを選び、データを集める:人気のある Python のオープンソースプロジェクトを 12 個選び、合わせて約 9 万件のプルリクエストを集めた。人気のあるプロジェクトはたいてい保守が行き届いていて、コントリビューションのガイドラインがはっきりしており、テストも比較的充実している。各プルリクエストに対応するコードベースのバージョンが、その base commit だ。
- 属性で絞り込む:マージ済みで、ある issue を解決していて、しかもテストファイルを変更しているプルリクエストだけを残す。テストファイルを変更しているということは、作成者が問題の修正を確かめるテストを追加した可能性が高い。
- 実行結果で絞り込む:まずプルリクエストのうちテストの変更だけを適用して、テスト結果を記録する。次に残りのコードの変更を適用して、もう一度記録する。少なくとも一つのテストが失敗から成功に変わったものだけを残し、インストールに失敗したものや実行時にエラーが出たものも削除する。
最終的に 2,294 問が残った。
問題の中身
| 項目 | 平均 | 最大 |
|---|---|---|
| issue の本文の長さ(語) | 195.1 | 4,477 |
| コードベースのファイル数(テストを除く) | 3,010 | 5,890 |
| コードベースの行数(テストを除く) | 438K | 886K |
| 正解の修正で変更された行数 | 32.8 | 5,888 |
| 正解の修正で変更されたファイル数 | 1.7 | 31 |
| 正解の修正で変更された関数の数 | 3 | 36 |
| 修正前に失敗し修正後に通るテストの数 | 9.1 | 1,633 |
| テストの総数 | 120.8 | 9,459 |
原論文 Table 1 をもとに整理。「正解の修正」は実際にマージされた修正(gold patch)。
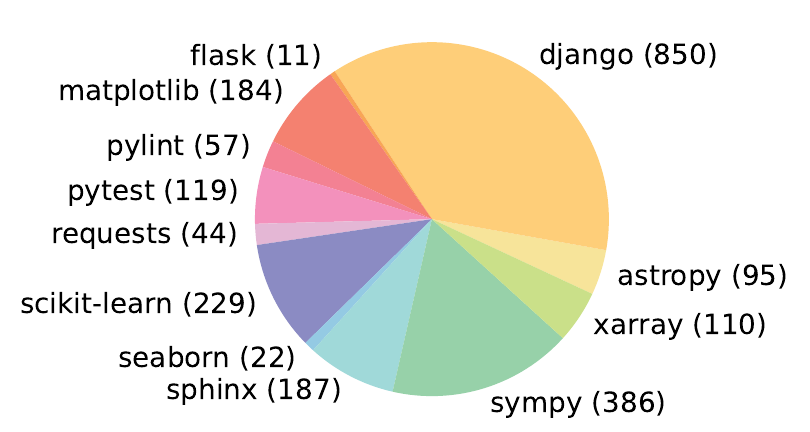
1 問あたりのコードベースは平均 3,000 ファイル、43.8 万行もあるのに、変更すべきなのは 1.7 ファイル、30 行あまりにすぎない。モデルは広大なコードの中から、本当に変更すべき数行を見つけ出さなければならない。
テストは二種類に分かれる。修正前に失敗し、修正後に通る(fail-to-pass、F2P)テストは、issue で報告された問題が直ったかを確認するもので、各問に少なくとも一つあり、40% の問題には二つ以上ある。修正の前後どちらでも通らなければならない(pass-to-pass、P2P)テストは、もともとの機能が壊れていないかを確認するもので、各問の中央値は 51 個だ。
両方のテストに通ってはじめて解決とみなされる。簡単な例を挙げよう。issue が、1900 年がうるう年と誤判定されると報告していれば、F2P テストは 1900 年を確認する。もし修正が「100 で割り切れない」という条件を加えるだけなら、1900 年は直るが、2000 年まで平年になってしまい、もともと通っていた P2P テストがこの誤りを捕まえる。
この設計の利点
- 現実的:問題も解答も利用者が実際に提出したもので、求められるのはベテランエンジニアのスキルだ。
- 継続的に更新できる:収集の流れにはほとんど人手が要らず、どんな Python プロジェクトにも適用できる。モデルの訓練データのカットオフ後に出てきた issue で試験すれば、答えが訓練データに含まれていないことを確かめられる。
- 入力が長くて雑多:issue は平均 195 語、コードベースはしばしば千を超えるファイルからなる。
- ファイルをまたぐ修正:関数一つを変えるだけの HumanEval や穴埋め式の問題とは違い、どこを変えればよいかを教えるヒントは一切ない。
- 解き方が開かれている:モデルの修正は正解の修正と同じである必要はなく、テストに通れば認められる。検索、長いコンテキスト、エージェントなど、さまざまなやり方を同じ基準で比べられる。
全 2,294 問を一通り走らせるには時間も API 費用もかかるので、著者らは別に 300 問を選んで SWE-bench Lite を作った。比較的独立した機能的なバグに寄せたもので、12 プロジェクトのうち 11 個をカバーしている。
SWE-Llama
当時のオープンソースモデルで、これほど長いコンテキストを扱えるのは CodeLlama だけだった。しかし既製の版は、指示どおりにコードベース全体に対する修正を生成するのが苦手で、プレースホルダーの文字列や無関係なコードを出力することがよくあった。著者らは同じ流れで、別の 37 個の Python プロジェクトから 1.9 万組の issue とプルリクエストを集めた。今回はテストの変更を必須とせず、プロジェクトも評価とはまったく重ならない。
このデータで CodeLlama-Python 7B と 13B を微調整したのが SWE-Llama だ。メモリを節約するため、LoRA で注意層だけを微調整し、3 万 token を超える訓練シーケンスを除外したので、実際に使ったのは約 1 万件になった。入力は指示、issue、関連するコードファイルで、目標は正解の修正を生成することだ。
コードベースをどうコンテキストに詰め込むか
平均 43.8 万行のコードベースを、当時のコンテキストに丸ごと詰め込むのは不可能だ。著者らは二通りのやり方でファイルを選んだ。
- BM25 検索:issue の本文をクエリにして関連するファイルを検索し、1.3 万、2.7 万、5 万 token の上限に達するまで詰め込む。コードに自然言語のクエリを合わせることになり、しかもクエリも文書も長いので、著者らは密ベクトル検索は向かないと考えた。
- Oracle 検索:正解の修正が変更したファイルをそのまま与える。これは現実的ではない。エンジニアも最初はどのファイルを変えればよいか知らないからだ。ただ、分析には使える。
上限 2.7 万 token のとき、BM25 は約 4 割の問題で oracle のファイルをすべて見つけられたが、半分近くの問題では一つも見つけられなかった。
評価したモデルは ChatGPT-3.5(16K コンテキスト)、GPT-4(32K)、Claude 2(100K)、SWE-Llama だ。コンテキストが短いほど、oracle のファイルを丸ごと入れられる問題は少なくなり、GPT-4 では 84.1%、ChatGPT-3.5 では 58.1% しかない。
議論
ほとんど解けない
| モデル | 解決 | 修正を適用できた | Lite での解決 |
|---|---|---|---|
| Claude 3 Opus | 3.79 | 46.56 | 4.33 |
| Claude 2 | 1.97 | 43.07 | 3.00 |
| ChatGPT-3.5 | 0.17 | 26.33 | 0.33 |
| GPT-4-turbo | 1.31 | 26.90 | 2.67 |
| SWE-Llama 7b | 0.70 | 51.74 | 1.33 |
| SWE-Llama 13b | 0.70 | 53.62 | 1.00 |
原論文 Table 5 をもとに整理。BM25 検索、単位は %。
最も良いモデルでも解決率は 4% に届かず、論文発表時点で最も良かった Claude 2 は 2% 未満だった。修正の半分以上は形式からして間違っていて、そもそも適用できない。
oracle のファイルを与えると少し良くなる。Claude 2 は 2% 未満から 4.80% に上がり、SWE-Llama 13b は 3.97%、GPT-4(無作為に選んだ四分の一の問題でしか試していない)は 1.74% だった。
プロジェクトによって難しさが大きく違う
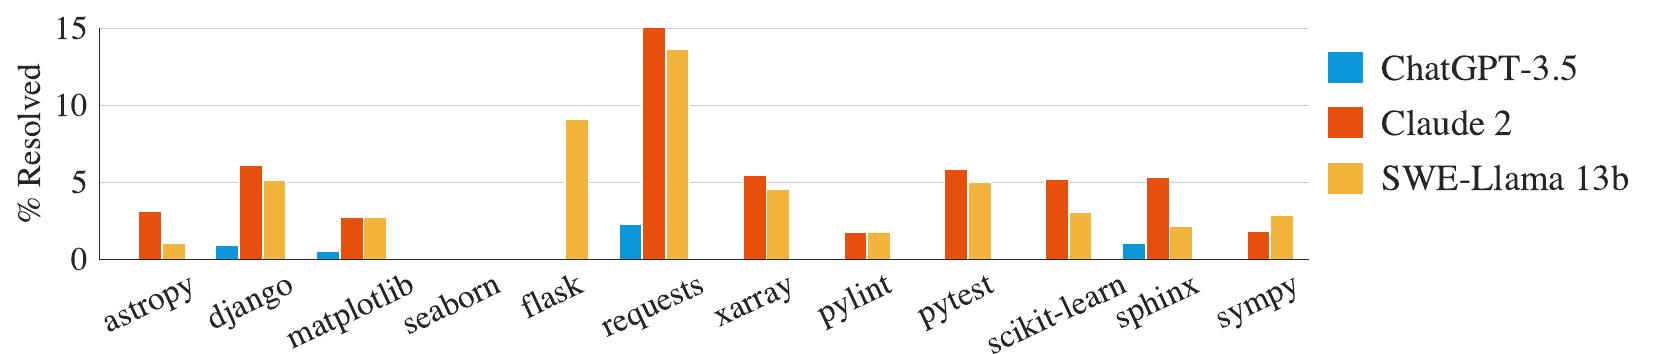
三つのモデルのプロジェクトごとの高低の傾向は似ているが、解けた問題はあまり重ならない。oracle の設定で、Claude 2 は 110 問、SWE-Llama 13b は 91 問を解いたが、SWE-Llama が解いた問題のうち、Claude 2 も解けたのは 42% だけだった。
issue に画像がついているプロジェクトもあり、Markdown の画像リンクとして本文に埋め込まれている。matplotlib では 32% の問題に画像があり、seaborn では 10%、全体では 2% だけだ。こうした問題には、マルチモーダルモデルや、画像を扱えるツールが必要になるかもしれない。
コンテキストが長いほど成績が悪い
Claude 2 の成績は、入力の総長が増えるにつれてはっきり下がり、ほかのモデルも同じだった。BM25 の上限を 1.3 万から 5 万 token に緩めると、oracle のファイルを見つけられる割合は上がったのに、Claude 2 の解決率は逆に 1.96% から 1.22% に下がった。問題と関係のないコードを見せられすぎると、モデルは本当に変えるべき場所を見つけられなくなる。
著者らは別に「oracle 折りたたみ」の実験も行った。同じく oracle のファイルを与えるが、正解の修正が変更した行だけを残して上下に 15 行ずつ添え、それ以外はすべて折りたたむ。Claude 2 は 4.8% から 5.9% に、GPT-4 は 3.40% に上がった。
その他の観察
- issue の日付とは関係ない:問題を 2023 年より前と後に分けても、ほとんどのモデルの成績は同じくらいだった(GPT-4 は四分の一の問題でしか試しておらず、後のほうの組は 0)。著者らは、モデルが古いバージョンのコードベースを見たことがあっても、答えの丸暗記でズルをするのは難しいことを示していると考えている。
- 微調整したモデルはコンテキストが変わると弱い:SWE-Llama は oracle のファイルで訓練されたので、「渡されたファイルはすべて変更する」ことを覚えてしまった。BM25 が渡す無関係なファイルの山に変わると、成績はひどく悪くなる。
- patch を書くほうがファイル全体を書き直すより易しい:モデルがふだん目にするのはたいてい完全なコードファイルで、patch を見ることは少ない。そこで著者らは、修正後のファイル全体をモデルに直接出力させることも試した。結果はかえって悪く、Claude 2 は oracle 検索で 4.8% から 2.2% に下がった。
- モデルの修正は小さめ:patch ファイル全体の行数(前後の文脈行を含む)で数えると、適用に成功した修正は平均 17 行から 30 行しかなく、同じ問題群の正解の修正は 34 行から 44 行、正解の修正全体では 74.5 行だった。モデルはほとんどの場合、ファイルを一つしか変更しない。
直せなかった一例
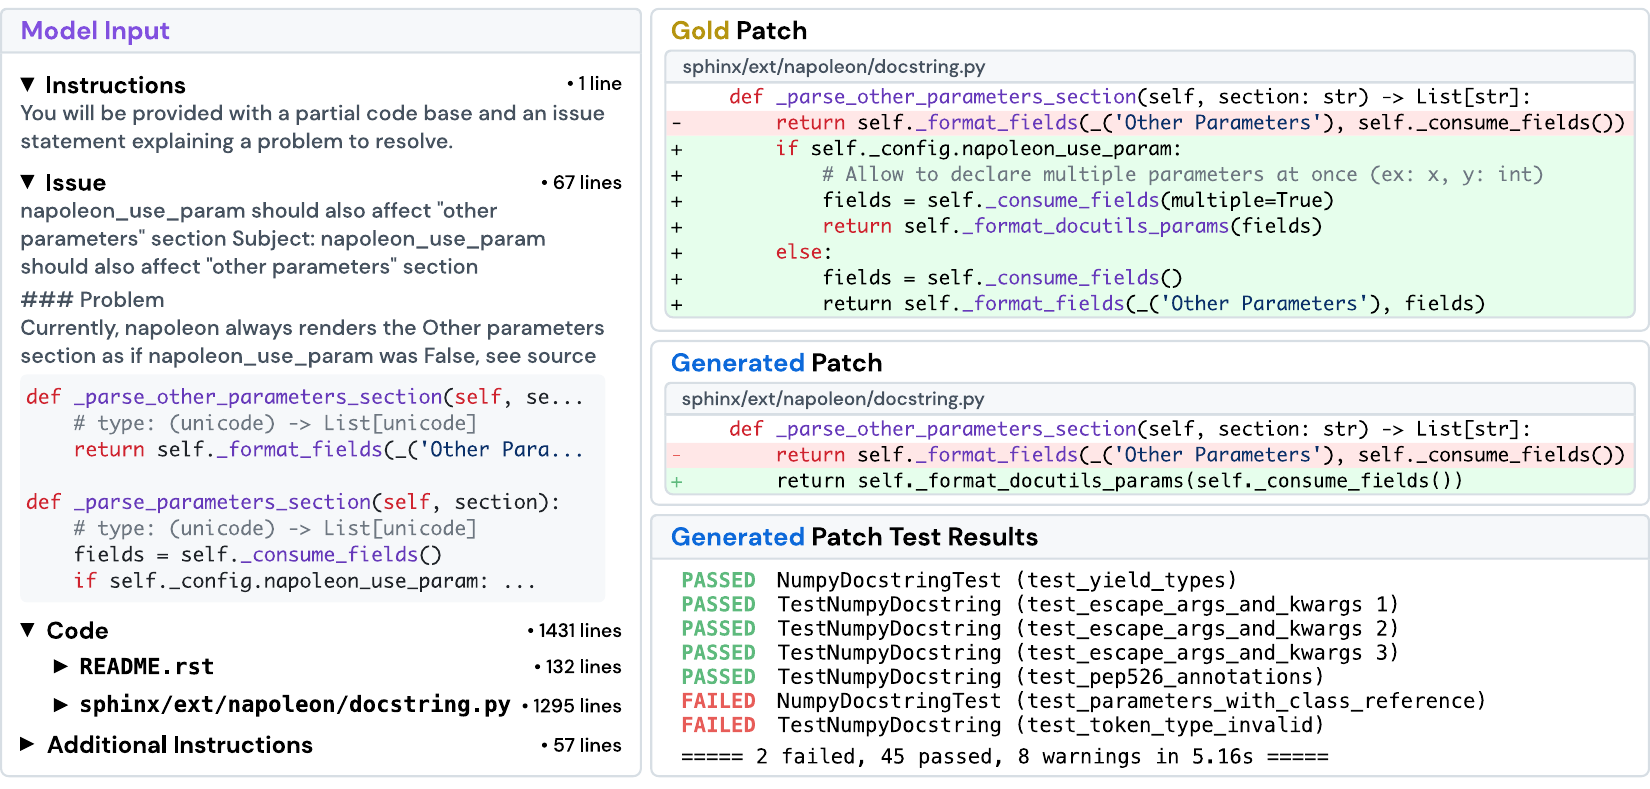
この issue は、Sphinx の napoleon 拡張で napoleon_use_param を True に設定したとき、「Other Parameters」セクションの書式がおかしい、というものだ。issue は詳しく書かれていて、問題がありそうなコード片まで添えられていた。
oracle の設定では、入力は全部で 1,558 行、20,882 token だった。SWE-Llama は正しい関数を変更したが、設定が何であっても napoleon_use_param が True であるかのように扱うようにしてしまった。正解の修正のほうは、すぐ隣の _parse_parameters_section の書き方にならって、まず設定を確認している。ちょうど設定が False の場合の出力を照合するテストが一つあり、すぐにこの誤りを捕まえた。
著者らは SWE-Llama と Claude 2 の出力を 11 件見て、いくつかの傾向をまとめた。モデルの書くコードは素朴で、既存のライブラリやコードベースにすでにあるツールをあまり使わない。解き方は「貪欲」で、issue に書かれた状況だけを直し、コードのスタイルやプロジェクトの慣習、たとえば相対インポートと絶対インポートのどちらを使うべきかといったことはあまり気にしない。人が書いた正解の修正は、ついでに構造の改善もしていることが多く、起こりうる関連する問題までまとめて片づけている。
限界
- Python だけ:著者らは今後、同じ収集の流れをほかの言語にも使いたいとしている。
- ベースラインを作っただけ:論文が使ったのは最も単純なやり方で、ファイルをいくつか検索し、一回で修正を生成するだけだ。著者らは、今後エージェントやツールとの組み合わせなど、ほかのやり方を試すよう促している。
- テストで捕まえられないところ:テストに通るコードでも、不完全だったり、非効率だったり、読みにくかったりすることがある。モデルの書く修正は、こうした面で人の書いたものに劣ることが多い。
その後
著者らが限界の中で提案したエージェントのやり方は、すぐに同じチームによって実現された。2024 年 5 月の SWE-agent は、言語モデル専用の操作インターフェースを設計し、コードベース全体を見て回り、ファイルを開き、編集し、テストを走らせられるようにした。完全な SWE-bench で 12.5% の問題を解決している。
2024 年 8 月 13 日、OpenAI は SWE-bench Verified を公開した。経験のある Python 開発者 93 人に、無作為に抜き出した 1,699 問を確認してもらい、説明が不明瞭な問題や、正しい解き方に対してテストが不公平な問題を除いて、500 問を残した。当時最良のオープンソースのフレームワークのもとで、GPT-4o は 33.2% を解決した。
その後、SWE-bench Verified は、各社が新しいモデルを発表するときに最もよく挙げるプログラミング能力の指標になった。2024 年 10 月、アップグレード版の Claude 3.5 Sonnet は 33.4% から 49.0% に上がり、2025 年 5 月の Claude Opus 4 は 72.5% だった。これらはどれも人手で選別した Verified での数字で、元の 2,294 問の数字と直接は比べられないが、2% 未満から 7 割まで、わずか一年半しかかからなかった。
結論
SWE-bench は、人気のある 12 個の Python プロジェクトの 9 万件のプルリクエストから、実際の issue 2,294 件を絞り込み、プロジェクト自身のテストで直ったかどうかを判定する。論文発表時、最も良い Claude 2 でも解けたのは 2% 未満で、正しいファイルを与えても 4.8% だった。
難しいのはコードを書くことだけではない。モデルは 43.8 万行のコードベースの中から変更すべき 30 行を見つけなければならず、与えるコードが多いほど、かえって見つけられなくなる。変更したうえで、ほかの機能を壊してもいけない。各問では、中央値で 51 個の P2P テストが横で目を光らせている。
この評価は十分に現実的に設計されていたので、すぐに満点まで解かれることはなかった。一年半後、ランキングの数字は一桁台から 7 割まで上がった。それを支えたのは、モデルが強くなったことだけではない。モデルがエンジニアのように、コードベースのあちこちを探し回り、テストを走らせ、エラーメッセージを見てまた直すことを覚えたからでもある。