原論文
Toolformer: Language Models Can Teach Themselves to Use Tools
- 発表先
- NeurIPS 2023国際会議
- arXiv への初回投稿
- arXiv:2302.04761
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modeltuningtoolformer2023,
  title = {{Toolformer: Language Models Can Teach Themselves to Use Tools}},
  author = {Timo Schick and Jane Dwivedi-Yu and Roberto Dessì and Roberta Raileanu and Maria Lomeli and Luke Zettlemoyer and Nicola Cancedda and Thomas Scialom},
  year = {2023},
  eprint = {2302.04761},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.04761}
}
大規模言語モデルには、とても矛盾したところがある。例をいくつか見ただけで新しいタスクをこなし、文章を書くのも、翻訳も、質問への回答もそれらしくできるのに、簡単な割り算をよく間違え、ある人の出身地を覚え違え、今日が何月何日なのかも知らない。どれも、電卓、検索エンジン、カレンダーが一つあれば片づくことだ。
モデルにツールを使わせる研究は、2023 年初めにはすでにあった。ただ、やり方は大きく二つに分かれていた。一つは大量の人手アノテーションを必要とするもので、たとえば LaMDA は、いつ情報を調べるべきかをアノテーターに実演させた。もう一つは特定のタスク向けに少数ショットのプロンプトを書き、この問題は電卓を、あの問題は検索を使え、と前もって教えておくものだ。前者は高くつき、後者はタスクが変わるたびに書き直さなければならない。
Meta の Schick らは、モデルに自分で学ばせようとした。ツールごとに実演をいくつか与えるだけで、モデルが大量の一般的なテキストに自分でツール呼び出しを挿入し、どの呼び出しが本当に役立ったかもモデル自身が判断する。
問題の定義
著者らは、学習されるツールの使い方に二つの条件を求めた。
- 自己教師あり:大量の人手アノテーションを必要としない。アノテーションが高くつくからだけでなく、人が役に立つと思う情報が、モデルにとって必要な情報とは限らないからでもある。
- 汎用性を失わない:ツールを使うかどうか、どれを使うか、どう使うかをモデルが自分で決める。特定のタスクに縛られない。
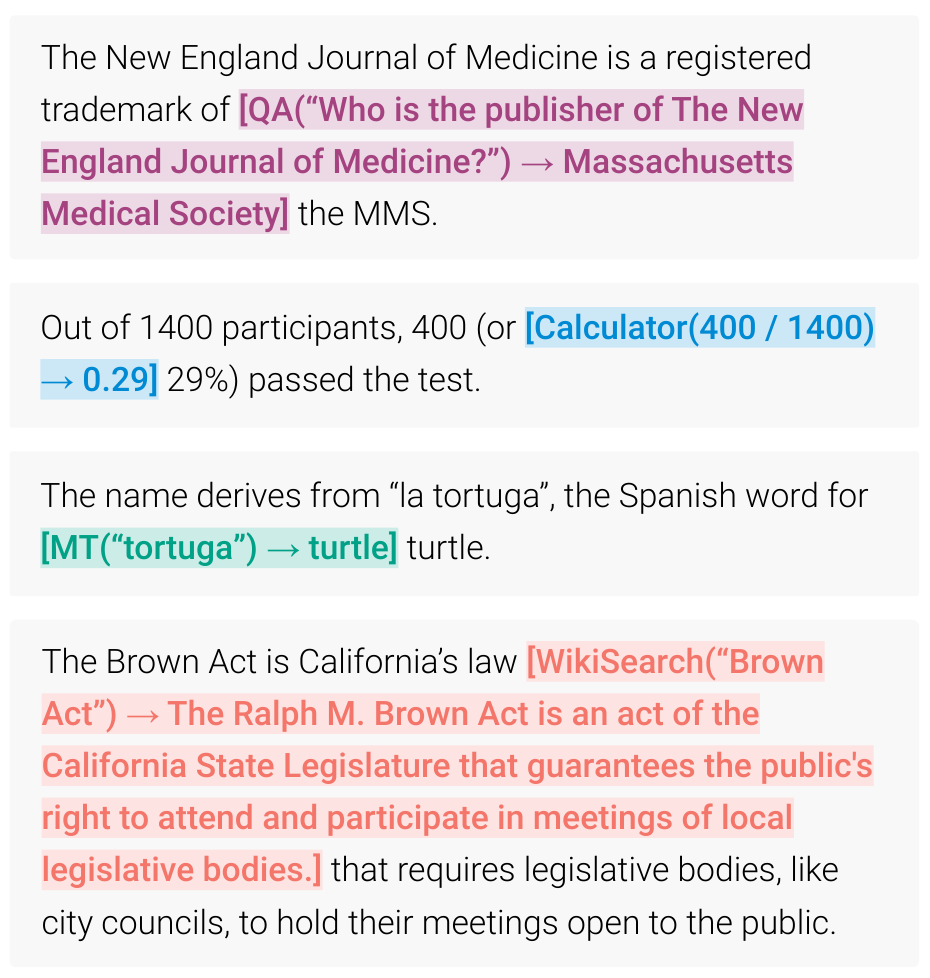
ツール呼び出しをテキストに直接書き込めるように、著者らは各 API 呼び出しを一続きのテキストとして書いた。呼び出し は API 名 と入力 からなり、得られる結果が だ。
実装では、特殊な記号の代わりに「[」「]」「->」という既存の文字を使うので、モデルの語彙を変える必要はない。
問題を解く
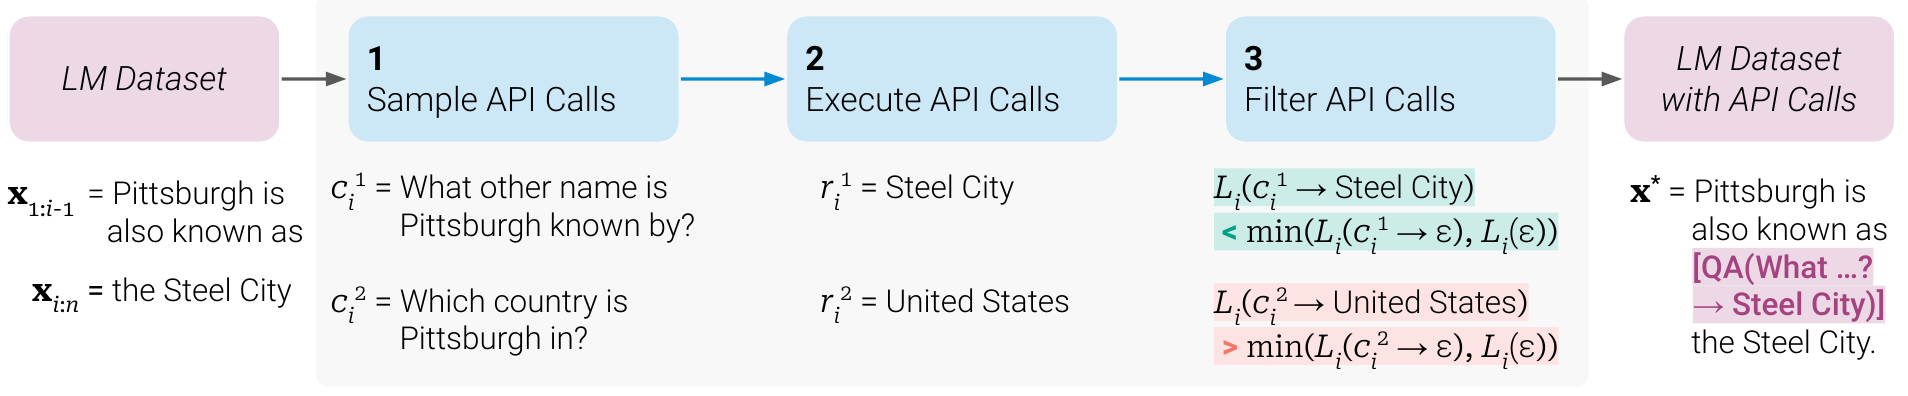
全体の流れは、普通の言語モデル用の訓練データに手を加えるものだ。元のデータセット はただのプレーンテキストの山で、著者らはモデルにそこへツール呼び出しを挿入させて新しいデータセット を作り、それでモデル自身を微調整する。
ステップ 1:呼び出しをサンプリングする
ツールごとにプロンプトを一つずつ書き、そこに実演をいくつか入れる。質問応答ツールのプロンプトはこうだ。
Your task is to add calls to a Question Answering API to a piece of text.
The questions should help you get information required to complete the text.
You can call the API by writing "[QA(question)]" where "question" is the
question you want to ask. Here are some examples of API calls:
Input: Joe Biden was born in Scranton, Pennsylvania.
Output: Joe Biden was born in [QA("Where was Joe Biden born?")] Scranton,
[QA("In which state is Scranton?")] Pennsylvania.
Input: Coca-Cola, or Coke, is a carbonated soft drink manufactured by
the Coca-Cola Company.
Output: Coca-Cola, or [QA("What other name is Coca-Cola known by?")] Coke,
is a carbonated soft drink manufactured by [QA("Who manufactures Coca-Cola?")]
the Coca-Cola Company.
Input: x
Output:
原論文 Figure 3 のプロンプト。
テキスト をプロンプトに入れ、各位置 について、モデルがそこで <API> を書き始める確率 を計算する。確率がしきい値 を超える位置を最大 個残し、各位置で呼び出しの中身を最大 個サンプリングする。
ステップ 2:呼び出しを実行する
著者らは五種類のツールを用意した。入力も出力もテキストだ。
| ツール | 入力例 | 出力例 |
|---|---|---|
| 質問応答 | Where was the Knights of Columbus founded? | New Haven, Connecticut |
| Wikipedia 検索 | Fishing Reel Types | 釣り竿とリールの種類についての Wikipedia の抜粋 |
| 電卓 | 27 + 4 * 2 | 35 |
| カレンダー | (入力不要) | Today is Monday, January 30, 2023. |
| 翻訳 | sûreté nucléaire | nuclear safety |
原論文 Table 1 をもとに整理。
- 質問応答:Atlas。Natural Questions で微調整された、先に検索してから答える言語モデルだ。
- Wikipedia 検索:KILT の Wikipedia データを BM25 で検索し、短いテキスト片を返す。
- 電卓:四則演算だけで、結果は小数点以下 2 桁に丸める。
- カレンダー:入力は不要で、今日の日付を返す。
- 翻訳:600M パラメータの NLLB。fastText で元の言語を自動判定し、常に英語に翻訳する。
ステップ 3:フィルタリング(この呼び出しは役に立ったか)
ここが論文全体で最も肝心なステップだ。著者らは、呼び出しが役に立ったかどうかを、モデル自身の損失で判断する。
を、先頭に を加えたうえで、モデルが位置 以降の各 token を予測するときの重みつき交差エントロピーとする。
次に、二つの場合を比べる。
は、呼び出して結果を得た場合。 は、呼び出さない場合と、呼び出したが結果を得なかった場合のうち、良いほうだ。 を満たす呼び出しだけが残る。
「呼び出したが結果を得なかった」場合とも比べるのは、ある状況を除外するためだ。質問を書くこと自体が、後に続く内容のヒントになることがある。そういう呼び出しの手柄はツールにはないので、残すべきではない。
重み は を正規化したもので、呼び出しの後の 1~5 番目の token の元の重みは順に 1、0.8、0.6、0.4、0.2、それより後は 0 だ。近いほど重くすることで、情報が本当に役立つ場所に呼び出しが置かれるようにしている。「Pittsburgh is also known as the Steel City」という文を例にとると、the の前に質問応答の呼び出しを挿入して「Steel City」を得れば、モデルは次の語が Steel だとほぼ確信でき、損失が大きく下がるので、この呼び出しは残る。Pittsburgh がどの国にあるかを尋ねて「United States」を得ても、「the Steel City」の予測にはまったく役立たないので、捨てられる。
フィルタリングにはもう一つ細かい点がある。この時点のモデルはまだツール呼び出しを一度も見ていないので、呼び出しを文の途中に無理やり挿入すると、テキストの流れが断ち切られ、かえってパープレキシティが上がる。そこで を計算するときには、呼び出しと結果をテキスト全体の先頭に置き、プレフィックスにする。
ステップ 4:微調整
各ツールで残った呼び出しをまとめ、元のテキストに挿入し直して を得る。 は、追加された呼び出しを除けば とテキストの中身がまったく同じなので、そこで微調整されたモデルが目にする知識は元と変わらず、言語能力も損なわれにくい。
テキストデータは CCNet の一部で、モデルは GPT-J 6B。アノテーションの計算量を節約するため、著者らはまずルールで、ツールを使いそうなテキストを選び出した。たとえば電卓では、数字を少なくとも三つ含む段落だけを処理する。微調整はバッチサイズ 128、学習率 で、最初の 10% のステップで線形ウォームアップする。
最終的にどれだけの呼び出しが残るかは、ツールによって異なる。フィルタのしきい値が のとき、Wikipedia 検索は 60,974 件、カレンダーは 20,587 件、質問応答は 18,526 件、翻訳は 1,034 件、電卓はわずか 994 件だった。
推論時
微調整の後は普通にデコードする。モデルが「→」を書いたら、ツールの結果を待っているという意味だ。そこでデコードを止めて実際にツールを呼び出し、結果と「]」をつなげてから、モデルに続きを書かせる。たとえばモデルが「[Calculator(400 / 1400) →」まで書いたところで止め、電卓が 0.29 を計算して「0.29]」をつなげると、モデルはその先に「29%」と書く。
デコードにも二か所の調整がある。<API> が確率の上位 10 個の token に入っていれば、一位でなくても呼び出しを始めさせ、ツールを多く使うよう促す。また、各入力につき呼び出しは最大一回に制限し、モデルが呼び出しばかり繰り返して答えを書かないループに陥るのを防ぐ。
議論
実験設定
主に四つのモデルを比べる。元の GPT-J、同じ CCNet のテキストで微調整したがツール呼び出しは加えていない GPT-J + CC、Toolformer、そして <API> の確率を 0 にしてツールを使えなくした Toolformer だ。さらに OPT 66B、GPT-3 175B(指示チューニングなしの davinci)とも比べる。
すべてゼロショットで、タスクはテキストで説明するだけで例は与えず、どのツールを使うべきかもモデルに教えない。採点は比較的ゆるく、たとえばモデルの出力の最初の数語に答えが含まれていれば正解とする。
結果
| タスク | GPT-J | ツール無効 | Toolformer | GPT-3 175B |
|---|---|---|---|---|
| LAMA SQuAD | 17.8 | 22.1 | 33.8 | 26.8 |
| LAMA Google-RE | 4.9 | 6.3 | 11.5 | 7.0 |
| LAMA T-REx | 31.9 | 34.9 | 53.5 | 39.8 |
| ASDiv | 7.5 | 14.8 | 40.4 | 14.0 |
| SVAMP | 5.2 | 6.3 | 29.4 | 10.0 |
| MAWPS | 9.9 | 15.0 | 44.0 | 19.8 |
| WebQS | 18.5 | 18.9 | 26.3 | 29.0 |
| Natural Questions | 12.8 | 12.6 | 17.7 | 22.6 |
| TriviaQA | 43.9 | 46.7 | 48.8 | 65.9 |
| TempLAMA | 13.7 | 12.7 | 16.3 | 15.5 |
| Dateset | 3.9 | 5.9 | 27.3 | 0.8 |
原論文 Table 3、4、5、7 をもとに整理。「ツール無効」は API の呼び出しを禁じた Toolformer で、単位は %。
穴埋め式の知識問題(LAMA):98.1% の問題でモデルが自分から質問応答ツールに尋ね、三つのサブセットすべてで GPT-3 に勝った。LAMA の文は Wikipedia から取られているので、簡単になりすぎないよう、ここでは Wikipedia 検索を無効にしている。
数学の文章題:97.9% の問題で電卓を呼び出し、スコアはツール無効時の二倍以上で、GPT-3 も大きく上回った。面白いことに、ツール無効の Toolformer も GPT-J より良い。著者らは、大量の計算式と結果を見たことで、モデル自身の計算能力も上がったのだろうと推測している。
オープンドメインの質問応答:質問応答ツールは Natural Questions で微調整されているので、使えばカンニングと同じになる。そのためここでは無効にした。モデルは 99.3% の場合に代わりに Wikipedia 検索を使い、ほかの GPT-J には勝ったが、GPT-3 にはやはり負けた。著者らは原因を二つ挙げている。BM25 の検索エンジンはかなり素朴で、関係のない結果をよく返す。また Toolformer は、キーワードを変えて検索し直したり、結果をもう何件か読み進めたりできない。
時間に関する問題:Dateset は今日の日付を知らないと答えられない問題で、たとえば「30 日前は何曜日か?」のようなものだ。54.8% の問題でカレンダーを使い、スコアは 5.9% から 27.3% に上がった。TempLAMA は時間とともに変わる事実、たとえばある選手がどのチームに所属しているかを問う。Toolformer はここでも伸びたが、カレンダーを使ったのは問題のわずか 0.2% で、主に頼ったのは検索と質問応答だった。最善のやり方は、まず日付を調べ、その日付を使って尋ねることだが、呼び出しは一問につき一回に限られ、しかも訓練データの呼び出しはツールごとに別々にサンプリングされているので、モデルはこういうリレーを見たことがない。
多言語の質問応答(MLQA):質問はアラビア語、ドイツ語、スペイン語、ヒンディー語、ベトナム語、簡体字中国語のいずれかで、背景の段落は英語だ。言語によって、モデルは 63.8%~94.9% の問題でまず質問を英語に翻訳し、ツール無効時より良くなった。例外はヒンディー語で、翻訳を使ったのは 7.3% だけだった。ただし Toolformer は、元の GPT-J を安定して上回るには至らなかった。CCNet での微調整そのものが、一部の言語の性能を下げてしまったからだ。
言語能力は落ちていない
| モデル | WikiText | CCNet |
|---|---|---|
| GPT-J | 9.9 | 10.6 |
| GPT-J + CC | 10.3 | 10.5 |
| Toolformer(ツール無効) | 10.3 | 10.5 |
原論文 Table 8 をもとに整理。数値はパープレキシティで、低いほど良い。
CCNet で微調整すると WikiText のパープレキシティは少し悪くなるが、ツール呼び出しを加えるかどうかでは差がない。ツールを有効にしたときのパープレキシティは計算できない。どの位置でもさまざまなツールを呼び出す可能性があり、確率を得るにはそのすべての可能性を足し合わせなければならないからだ。
どれくらいの大きさのモデルなら学べるか
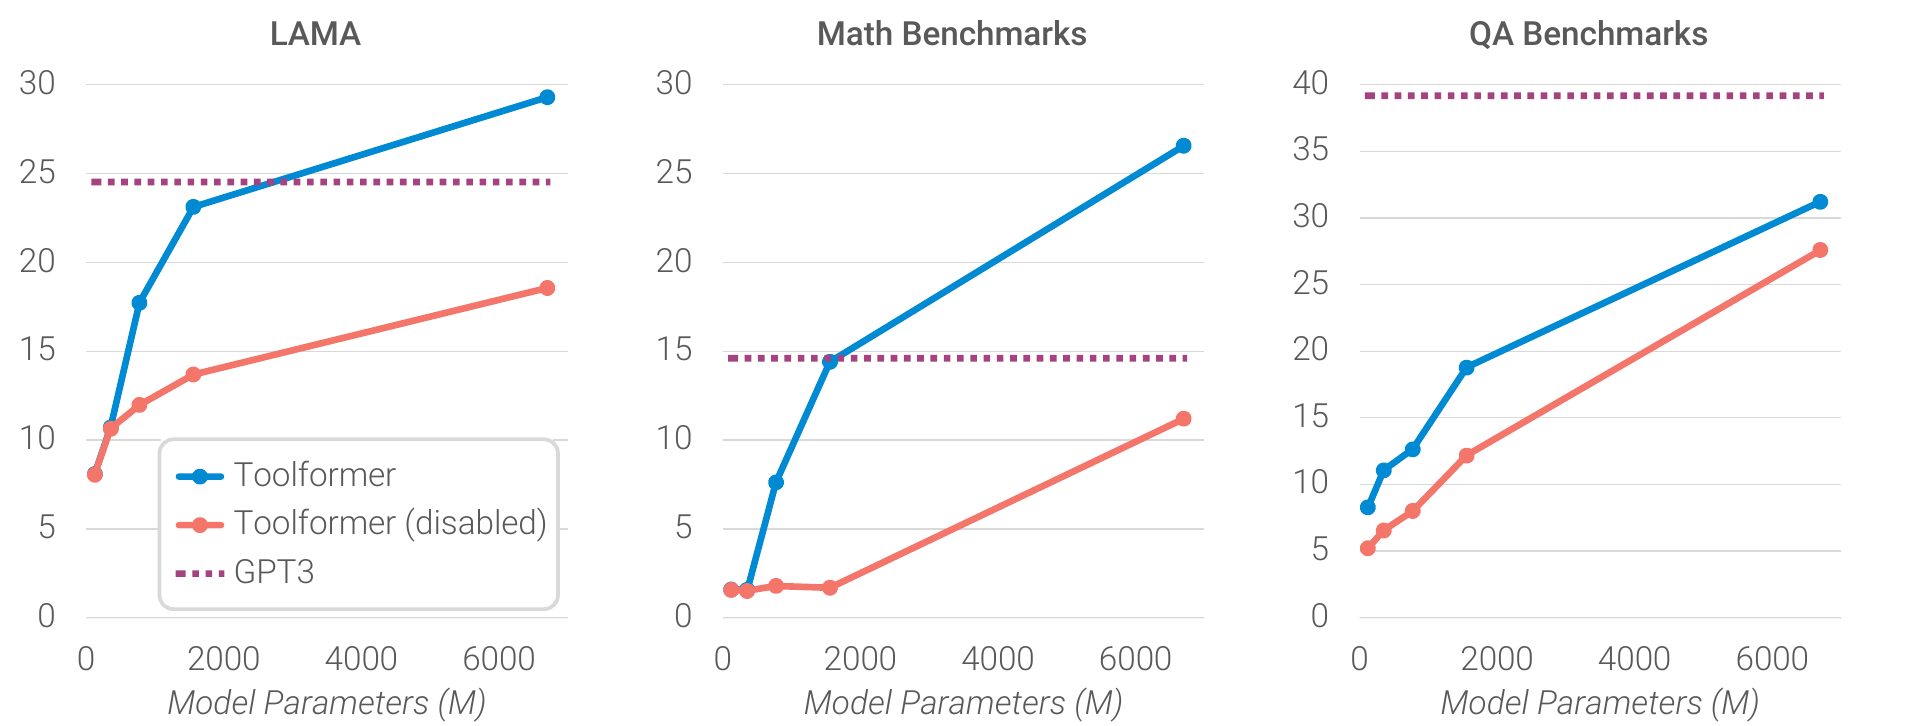
著者らは GPT-2 の四つのサイズでやり直した。ツールは質問応答、電卓、Wikipedia 検索の三種類だけだ。ツールを使う能力が現れるのはおよそ 775M パラメータからで、それより小さいモデルはツールの有無でほとんど変わらない。例外は Wikipedia 検索で、小さいモデルでも使いこなせる。著者らは、この API が比較的単純だからだろうと推測している。モデルが大きくなると、ツールなしの能力が強くなり、ツールを使う能力も同時に強くなるので、両者の差はずっと残る。
デコードのしきい値
| T-REx | 呼び出し率 | WebQS | 呼び出し率 | |
|---|---|---|---|---|
| 0 | 34.9 | 0.0% | 18.9 | 0.0% |
| 1 | 47.8 | 40.3% | 19.3 | 8.5% |
| 3 | 52.9 | 82.8% | 26.3 | 99.3% |
| 10 | 53.5 | 98.1% | 26.3 | 100% |
原論文 Table 9 をもとに整理し、一部の列を抜粋。T-REx と WebQS の列は正答率(%)。
は、<API> が上位何位までに入れば呼び出しを始めるかを表し、 はツール無効と同じ、 は普通の貪欲デコーディングだ。普通の貪欲デコーディングでは、モデルが WebQS でツールを呼び出すのは問題の 8.5% だけで、スコアもほとんど変わらない。しきい値を上位 3 位までゆるめて、ようやく大量に使い始める。
のとき、モデルが呼び出さないと決めた問題のスコア(T-REx 44.3%、WebQS 19.9%)は、ツールをまったく使えないときの平均(34.9%、18.9%)よりむしろ高い。つまりモデルは、自分がどの問題を解けないかをある程度わかっていて、ツールをそういう問題のためにとっておく。しきい値をゆるめると、この判断は見られなくなる。
残った呼び出しはどんなものか
著者らは、フィルタのスコア を高い順に並べ、例をいくつか示している。スコアの高いものはほとんどが理にかなっている。たとえばイギリス最古の戦争記念窓に触れたところで Flodden を検索したものはスコア 5.49、「The Nile has an approximate length of」と書いたところでナイル川の長さを尋ねたものはスコア 2.08 だ。
スコアの低いものは、ほとんどが役に立たない。たとえば「85 patients (23%)」と書いたところで 85 / 23 を計算したものは、スコア −0.02 だ。ただ、「Catch this fast train to success!」で「Fast train success」を検索したものは、1971 年のある曲がヒットして内容はまったく関係ないのに、それでもパープレキシティを下げ、スコアは 0.92 だった。著者らは、こうしたノイズが少しあるのは必ずしも悪いことではなく、そのおかげでモデルはどのツールの結果も盲信しなくなると考えている。
限界
著者ら自身が次の点を挙げている。
- ツールを連鎖させられない:たとえば日付を調べてから、その日付で尋ねることができない。ツールごとの呼び出しは別々にサンプリングされていて、訓練データにこういう例がないからだ。
- 対話的に使えない:検索エンジンは何百件もの結果を返すことがあるが、モデルは結果を見て回ることも、クエリを修正することもできない。
- 言い回しに敏感:ツールを呼び出すかどうかが、入力の書き方に左右されやすい。
- とても効率が悪い:百万を超える文書を処理しても、役に立つ電卓の呼び出しは数千件しか得られない。著者らは、ほかのブートストラップ手法のように反復して行うことを提案している。
- コストを考慮しない:ツールによって呼び出しの計算コストは大きく違うが、モデルは決めるときにそれを考えない。
その後
Toolformer の発表から四か月後、ツールの使用は商用モデルの標準機能になったが、たどった道は別のものだった。2023 年 6 月 13 日、OpenAI は API に function calling を加えた。開発者が自分の関数を JSON で記述しておくと、モデルは必要と判断したときに引数つきの JSON オブジェクトを出力し、アプリケーションがそれを実行して、結果をモデルに返す。ツールは開発者が定義し、モデルは訓練の段階で記述どおりに呼び出すことを身につけているので、一般的なテキストから手探りで覚える必要はもうない。
Toolformer が限界に挙げた連鎖と対話は、エージェントのループでは基本的な能力になった。モデルがツールを呼び出し、結果を見て、次の一手を決める。一つのタスクで何十回もやり取りすることもある。2024 年 11 月、Anthropic は Model Context Protocol を提案した。AI アシスタントをさまざまなデータソースやツールにつなぐためのオープン標準で、ツールのつなぎ方も統一され始めた。
結論
Toolformer はツールごとに実演をいくつか与えるだけで、GPT-J に一般的なテキストへ自分でツール呼び出しを挿入させ、「後に続くテキストが予測しやすくなったか」でふるい分けた。微調整の後、この 6B のモデルは知識の穴埋め、数学の文章題、日付の問題で GPT-3 175B に勝ち、言語能力も落ちなかった。
この論文で最も面白い設計は、ツールが役に立ったかどうかをモデル自身に判断させたことだ。どこに質問を差し込むべきか、どの答えが役に立つかは、すべてモデルの損失が決めていて、人は何も教えていない。1971 年の古い曲がヒットしたあの呼び出しでさえ、モデル自身が役に立つと感じたから残ったのだ。
その後のツール使用はこの自己教師ありの方式を引き継がず、開発者がツールの説明を書いておき、モデルがそれに従って呼び出す形になった。単純で、制御もしやすい。それでも「呼び出しをテキストに書き、結果をテキストにつなぎ、モデルが続きを書く」という形式は残り、今日のエージェントはどのステップもこうして動いている。