原論文
Evaluating Large Language Models Trained on Code
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2107.03374
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modelevaluationcodex2021,
  title = {{Evaluating Large Language Models Trained on Code}},
  author = {Mark Chen and Jerry Tworek and Heewoo Jun and Qiming Yuan and Henrique Ponde de Oliveira Pinto and Jared Kaplan and Harri Edwards and Yuri Burda and Nicholas Joseph and Greg Brockman and Alex Ray and Raul Puri and Gretchen Krueger and Michael Petrov and Heidy Khlaaf and Girish Sastry and Pamela Mishkin and Brooke Chan and Scott Gray and Nick Ryder and Mikhail Pavlov and Alethea Power and Lukasz Kaiser and Mohammad Bavarian and Clemens Winter and Philippe Tillet and Felipe Petroski Such and Dave Cummings and Matthias Plappert and Fotios Chantzis and Elizabeth Barnes and Ariel Herbert-Voss and William Hebgen Guss and Alex Nichol and Alex Paino and Nikolas Tezak and Jie Tang and Igor Babuschkin and Suchir Balaji and Shantanu Jain and William Saunders and Christopher Hesse and Andrew N. Carr and Jan Leike and Josh Achiam and Vedant Misra and Evan Morikawa and Alec Radford and Matthew Knight and Miles Brundage and Mira Murati and Katie Mayer and Peter Welinder and Bob McGrew and Dario Amodei and Sam McCandlish and Ilya Sutskever and Wojciech Zaremba},
  year = {2021},
  eprint = {2107.03374},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2107.03374}
}
2021 年 6 月末、GitHub は Copilot のテクニカルプレビュー版を公開した。エディタで関数名とコメントを書いておけば、関数の本体を補完してくれる。その一週間後、OpenAI はこの論文を発表して、裏にあるモデル Codex を紹介した。論文は第一段落で、Copilot が使っているのは Codex の別の本番用バージョンだと明記している。
発想の元は GPT-3 だ。著者らは以前、GPT-3 が Python の docstring を読むと、簡単なプログラムをいくつか書けることに気づいていた。できることはごく素朴なものだったが、GPT-3 はコード向けの特別な訓練を一度も受けていない。そこで GPT を GitHub のコードでさらに訓練し、どこまで書けるようになるかを試した。
ただ、この論文がいちばん力を注いだのは、「モデルが書いたものの良し悪しをどう判定するか」のほうだ。論文が残した HumanEval と pass@k は、その後コードモデルの標準の試験問題と採点方法になり、Codex 本体よりも長生きしている。
問題の定義
それまで、コードを生成するモデルの採点はたいてい照合に頼っていた。モデルが書いたプログラムを参照解答と比べ、完全に一致するか BLEU スコアが十分に高ければ、よく書けたとみなす。
問題は、プログラムの書き方が無数にあることだ。return [i + 1 for i in l] と、for ループで一つずつ append する書き方とでは、機能はまったく同じなのに、字面は大きく違う。逆に、一文字しか違わない二つのプログラムでも、片方は正しく、片方は間違っていることがある。著者らも後で実際に確かめていて、Codex が書いた間違ったプログラムの BLEU スコアは、正しいものより高いことがよくあった。
著者らは、機能的な正しさを見るべきだと主張する。単体テストを通ってはじめて正解とするのだ。これはエンジニアが普段プログラムを判断するやり方でもあり、テスト駆動開発では、まず要件をテストとして書き、それから実装を書く。
このように採点するには、先に三つのことを片づけなければならない。
- 試験問題が訓練データに含まれていてはならない。 Codex は GitHub の大半を読んでおり、GitHub には Codeforces の問題の解答だけでも、公開リポジトリが十数個ある。
- 1 問について答えを何個もサンプリングするとき、スコアをどう計算すれば公平か。
- モデルが書いたプログラムは信用できないので、安全に実行できる場所が要る。
三つ目はエンジニアリングの問題だ。著者らは gVisor のコンテナランタイムでホストとコンテナを隔離し、さらに eBPF のファイアウォールで、実験の制御に使うもの以外のネットワーク接続をすべて遮断した。前の二つへの答えが、HumanEval と pass@k である。
HumanEval
著者らは 164 問を手で書いた。各問には関数シグネチャ、docstring、参照解答があり、単体テストは平均 7.7 個。問題は言語理解、推論、アルゴリズム、簡単な数学にわたり、ソフトウェアエンジニアの簡単な面接問題と同じくらいの難しさのものもある。
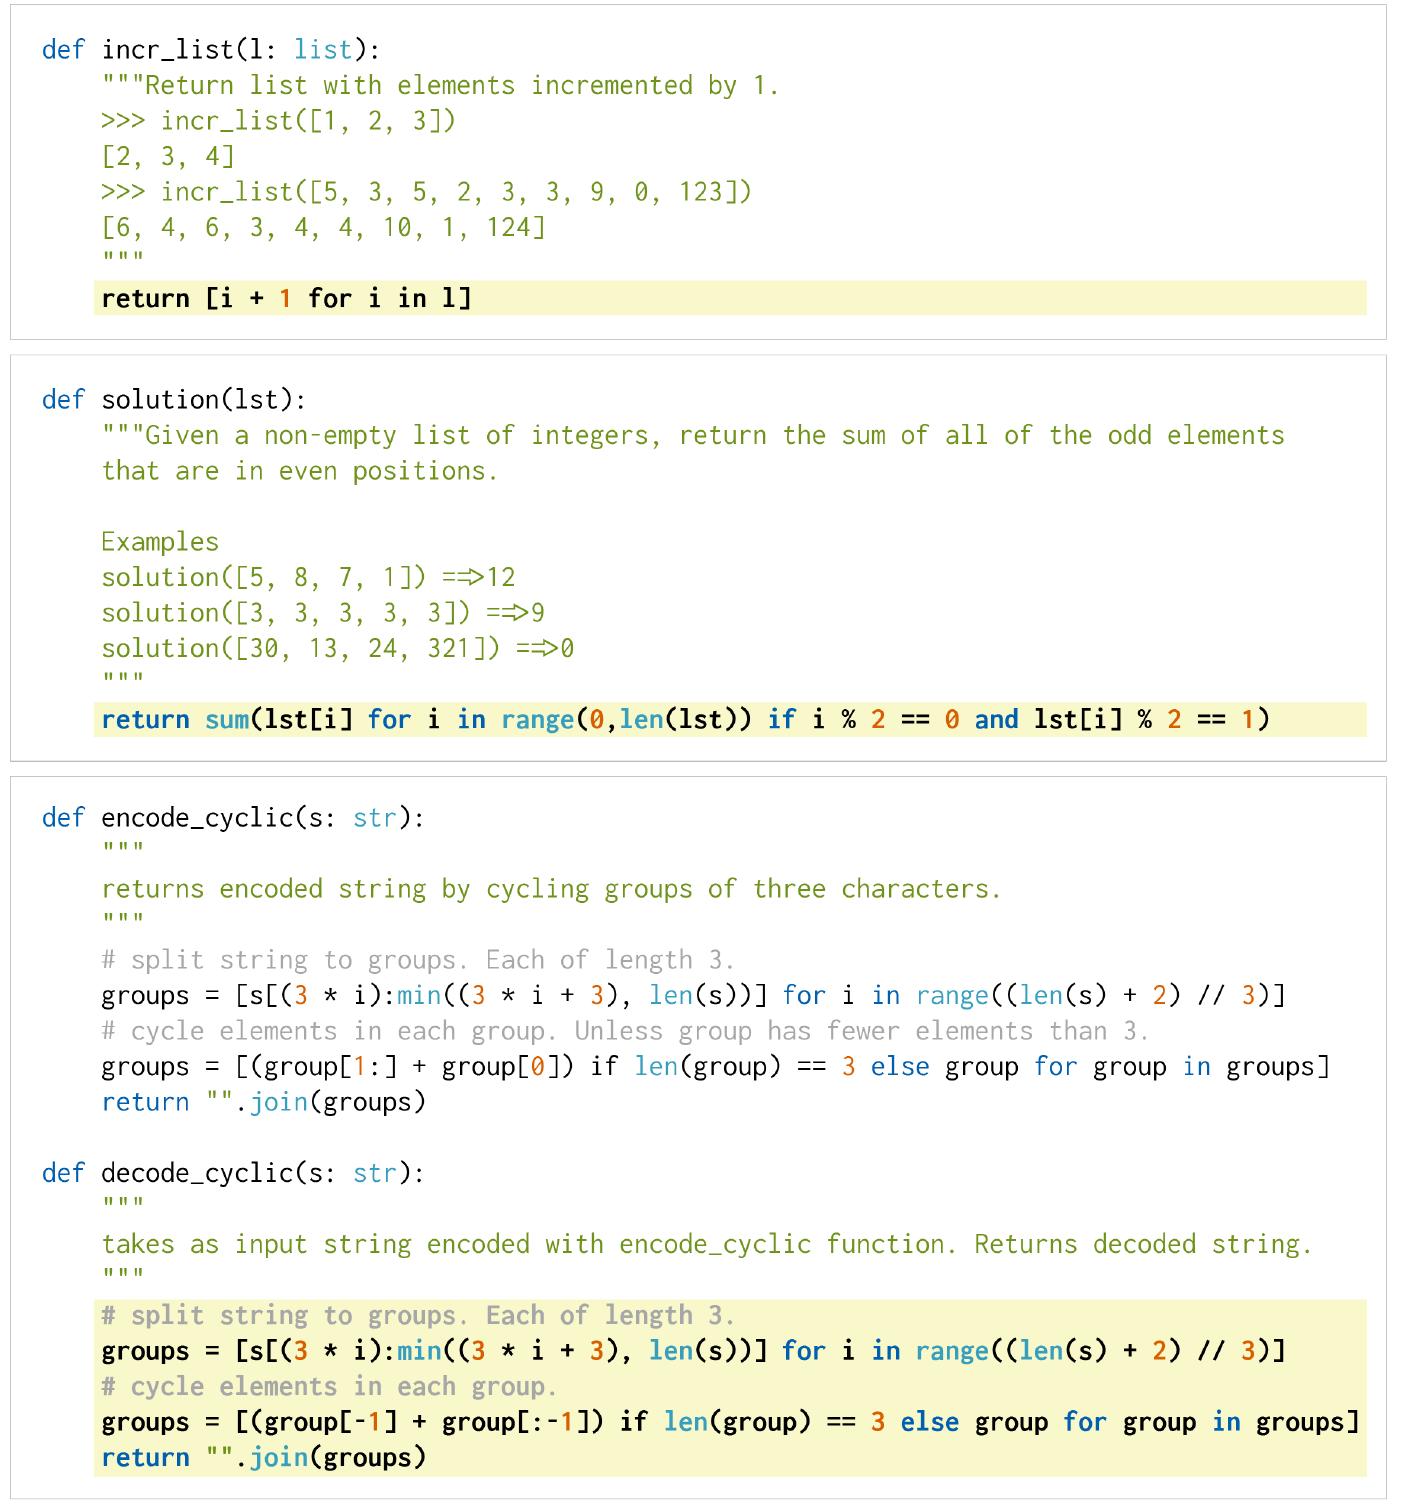
白地がモデルへのプロンプト、黄色地がモデルの書いた答えだ。三問は易しい順に並んでおり、Codex-12B が一回のサンプリングで正解する確率はそれぞれ 0.9、0.17、0.005。いちばん難しい問題では、まず encode_cyclic が 3 文字ごとにどう文字を巡回させているかを読み取り、それから逆の操作を書かなければならない。
プロンプトはヘッダ、関数シグネチャ、docstring だけだ。モデルはどこまでも書き続けるので、\nclass、\ndef、\n#、\nif、\nprint が出たところで止める。そうしないと、次の関数やテストコードまで書き始めてしまう。
pass@k
1 問につき、モデルに何回でもサンプリングさせられる。pass@k とは、答えを k 個サンプリングして、一つでもテストを通ればその問題は解けたとみなし、それを全問で平均したものだ。
いちばん素直な計算は、各問で本当に k 回サンプリングすることだが、それでは分散が大きい。著者らは代わりに、各問で 個のサンプルを取り(論文では 、)、そのうち 個が通ったと数えて、次のように推定する。
分数の項は「 個のサンプルからランダムに 個取ったとき、すべて間違っている」確率で、1 からそれを引けば、 個のうち少なくとも一つは正しい確率になる。
組み合わせ数をそのまま計算すると非常に大きくなるので、論文は数値的に安定な書き方を添えている。積を一項ずつ展開する方法だ。これで 1 問分を計算してみよう。
import numpy as np
from math import comb

def pass_at_k(n, c, k):
    """論文 Figure 3 の書き方:n 個のサンプルのうち c 個が通過したとき、pass@k を推定する"""
    if n - c < k:
        return 1.0
    return 1.0 - np.prod(1.0 - k / np.arange(n - c + 1, n + 1))

n, c = 200, 10              # 1 問につき 200 回サンプリングし、10 回がテストを通過
for k in (1, 10, 100):
    exact = 1 - comb(n - c, k) / comb(n, k)       # 組み合わせ数で直接計算する
    naive = 1 - (1 - c / n) ** k                  # pass@1 から強引に推定する
    print(f"k={k:3d}  unbiased={pass_at_k(n, c, k):.4f}  comb={exact:.4f}  naive={naive:.4f}")

# k=  1  unbiased=0.0500  comb=0.0500  naive=0.0500
# k= 10  unbiased=0.4085  comb=0.4085  naive=0.4013
# k=100  unbiased=0.9992  comb=0.9992  naive=0.9941
安定な書き方は、組み合わせ数を直接計算した結果と一致する。直感的な のほうはやや低めに出て、論文は付録で、これが必ず過小評価になることを証明している。これは 個のサンプルから「復元抽出」で 回取ることに相当し、不偏推定のほうは非復元抽出だ。
もっとはまりやすい落とし穴もある。pass@k は問題ごとに推定してから平均するもので、データセット全体の pass@1 から推定してはいけない。難しさが大きく違う三問を例にしよう。1 回あたりの通過確率はそれぞれ 0.9、0.17、0.005 で、HumanEval の例題のあの三問だ。各問 200 回サンプリングして、それぞれ 180 回、34 回、1 回通ったとする。
三問の pass@1 の平均は 0.358 で、これを使って pass@100 を推定すると 1.0 になる。実際には、いちばん難しい問題は 200 回中 1 回しか正解しておらず、ランダムに 100 個取っても、その一つを引ける確率は半分しかない。だから三問の平均は 0.833 だ。問題の難しさが大きく違うと、易しい問題の成績が難しい問題を覆い隠してしまう。
問題を解く
Codex:GitHub で GPT を追加訓練する
訓練データは、2020 年 5 月に GitHub の公開リポジトリ 5,400 万個から集めた Python ファイルで、重複を除いた 1MB 未満のファイルが合計 179GB。著者らはさらに、自動生成と思われるファイル、平均行長が 100 を超えるもの、最長の行が 1,000 を超えるもの、英数字の割合が低すぎるものを除き、最終的に 159GB が残った。
モデルは GPT-3 ファミリーの重みから微調整し、最大で 120 億パラメータ。著者らは当初、GPT はすでに強力な自然言語表現を持っているので、そこから始めたほうが良いだろうと考えていた。ところが最終的な性能はゼロから訓練した場合とほぼ同じで、著者らは微調整データの量が多すぎるためだろうと推測している。それでも GPT から始めると収束が速いので、以降の実験はすべてそうしている。訓練は合計 1,000 億 token で、学習率は対応する GPT モデルの設定をそのまま使う。
トークナイザも GPT-3 のものを流用したが、コード中の単語の分布は自然言語とかなり違い、いちばん無駄が大きいのはインデントの空白だった。著者らは、さまざまな長さの連続する空白を表す token を一組追加し、同じコードを約 30% 少ない token で表せるようにした。
サンプリングには nucleus sampling を使い、top p = 0.95。温度は k に合わせて調整する。679M のモデルでは、pass@1 の最適温度は 0.2、pass@100 では 0.8 だ。k が大きいときは、サンプル同士が違っているほど良い。どうせ一つ当たれば正解になるのだから。
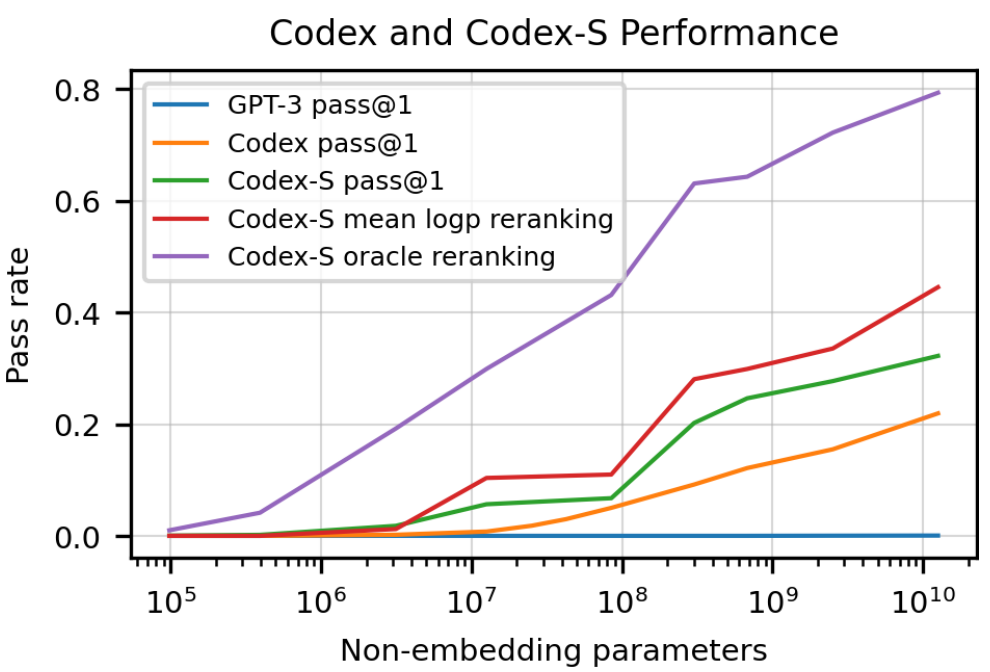
この図は論文全体の結果を一枚にまとめている。横軸は非埋め込みパラメータ数。青線は GPT-3 の pass@1 で、ずっと 0 に張りついている。オレンジ線が Codex、緑線が次の節の Codex-S だ。図のサンプルはすべて温度 0.8 なので、この二本の pass@1 は論文が報告する最良の成績より低い。それぞれに最適な温度を使えば、12B の Codex は一回のサンプリングで 28.8% を解き、Codex-S は 37.7% を解く。赤線と紫線は、どちらも Codex-S に各問 100 個のサンプルを取らせたもので、違いは選び方にある。赤線は平均対数確率が最も高いものを選んで 44.5%。紫線はテスト結果を知っている oracle が選び、100 個のうち一つでも通れば正解とするもので、77.5% だ。
他のモデルと比べると次のとおり。
| モデル | pass@1 | pass@10 | pass@100 |
|---|---|---|---|
| TabNine | 2.58% | 4.35% | 7.59% |
| GPT-Neo 2.7B | 6.41% | 11.27% | 21.37% |
| GPT-J 6B | 11.62% | 15.74% | 27.74% |
| Codex-300M | 13.17% | 20.37% | 36.27% |
| Codex-2.5B | 21.36% | 35.42% | 59.50% |
| Codex-12B | 28.81% | 46.81% | 72.31% |
原論文 Table 1 をもとに整理。
GPT-Neo と GPT-J は、EleutherAI が The Pile で訓練したオープンソースモデルで、データの約 8% が GitHub のコードだ。同じサイズの GPT シリーズはほぼ 0 だった。GPT-J 6B はだいたい Codex-300M と同程度で、パラメータは 20 倍多い。TabNine は当時の代表的なコード自動補完ツールで、その最大の無料モデルはだいたい Codex-12M と同程度だ。
Codex-S:訓練データを試験問題に近づける
GitHub の Python は独立した関数ばかりではない。クラス、設定ファイル、スクリプト、さらにはデータの保存に使われているファイルまであり、「docstring を読んで関数を書く」こととはかけ離れている。著者らは、正しく実装された独立関数を別に集め、もう一度教師あり微調整を行った。これを Codex-S と呼ぶ。
データの出どころは二つある。
- 競技プログラミングと面接対策のサイト:問題文を docstring とし、関数シグネチャと解答を添える。完全なテストはふつう公開されていないので、著者らは問題文中の例からテストを作ったり、わざと間違った解答を提出して、フィードバックからさらにテストケースを掘り出したりした。合計 10,000 問。
- 継続的インテグレーション(CI)を備えたオープンソースプロジェクト:Python の
sys.setprofileで統合テスト中の各関数の入力と出力を追跡し、それを単体テストに変える。著者らは travis と tox の設定ファイルに従って環境を構築してテストを走らせ、PyPI のパッケージも使った。この種の関数は多くがコマンドラインツールの部品で、問われるのはアルゴリズムではなく、docstring どおりに機能を実装することだ。合計約 40,000 問。
自動で集めた問題は品質がまちまちだ。説明が不完全で、正しい答えまでテストで不正解と判定されるものもあれば、状態を持っていて実行のたびに結果が変わるものもある。著者らは Codex-12B に各問 100 個の答えを出させ、一つも通らなかった問題は、問題に不備があるか難しすぎるとみなしてそのまま削除した。このチェックは何度か繰り返し、結果が安定しない問題もふるい落とした。
訓練では参照解答の部分だけで損失を計算し、プロンプトの部分はマスクする。学習率は Codex の十分の一で、検証損失が下がらなくなるまで訓練し、使った token は 100 億に満たない。
各モデルサイズで、Codex-S の pass@1 は Codex より平均 6.5 ポイント、pass@100 は 15.1 ポイント高い。
テストがないときはどう選ぶか
pass@k は、どの答えが正しいかを誰かが知っていることを前提にしている。実際に自動補完として使うときは、ユーザーに見えるのは提案一つだけで、手元に単体テストもない。
著者らはいくつかの選び方を比べた。「token あたりの平均対数確率」が最も高いサンプルを選ぶと、ランダムに選ぶより良い。「対数確率の合計」が最も高いものを選ぶと、かえってランダムよりわずかに悪くなることがある。
もう一つの発想は、逆向きに書くことだ。著者らは、コードを読んで docstring を書く Codex-D を訓練し、それで「このコードから元の docstring を書き戻す」確率を計算して、最も高いものを選んだ。この方法はランダムには勝つが、平均対数確率には負け、しかもすぐに過学習する。
Codex-D 自体もちょっと面白い。著者らはそれが書いた docstring を人手で採点し、プログラムを一意かつ正確に説明できていれば正解とした。その pass@1 は 20.3% で、同じ条件で Codex-S がコードを書くと 32.2% だ。著者らは考えられる理由の一つとして、開発者がもともと docstring をあまり丁寧に書かないことを挙げている。モデルは「I just found this function online」や「This test is not correctly written and it's not my solution」と書くことまで覚えてしまった。
議論
説明が長いほど書けなくなる
著者らは、「文字列を小文字に変換する」「3 文字ごとに 1 文字を削除する」といった 13 個の簡単な文字列操作を部品にして、どんどん長くなる docstring につなげ、Codex-12B が書けるかどうかを見た。
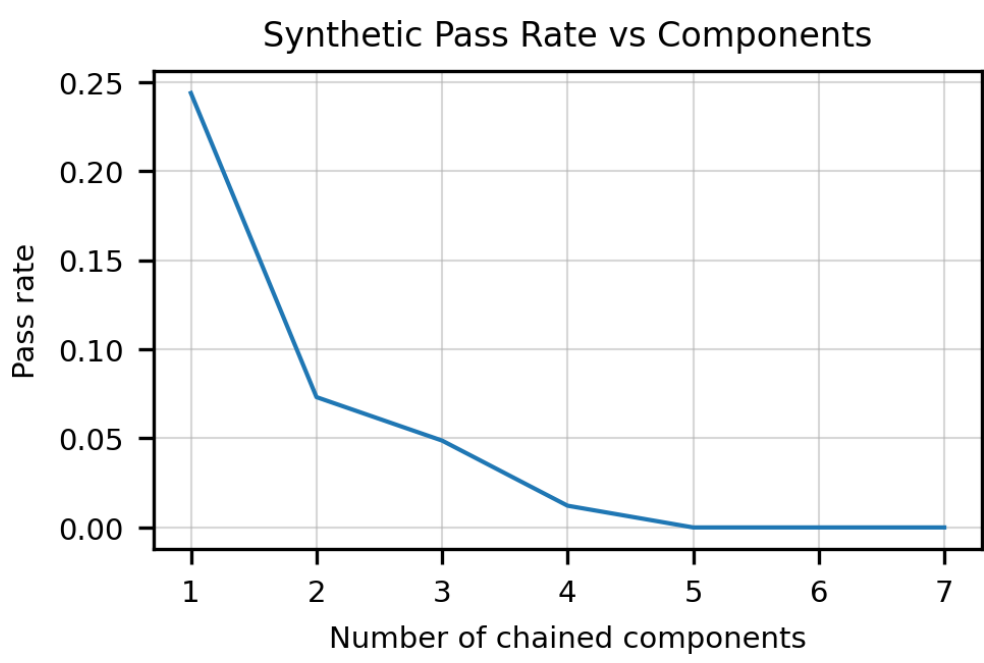
部品が一つ増えるごとに、通過率はおよそ元の二分の一から三分の一に落ち、五つ以上つなぐと 0 になる。人間のエンジニアはこうはならない。二ステップを書ける人なら、七ステップでも時間が余計にかかるだけだ。
もう一つの問題は、操作を正しい変数に結びつけることだ。論文が挙げている例では、「y に 3 を足し、x と w の両方から 4 を引いて、四つの数の積を返す」よう求めている。
def do_work(x, y, z, w):
    """ Add 3 to y, then subtract 4
    from both x and w. Return the
    product of the four numbers. """
    t = y + 3
    u = x - 4
    v = z * w
    return v
Codex-12B は w から 4 を引いておらず、最後も二つの数の積しか返していない。
できるのに、つられて間違える
これは論文の中で最も先見の明がある実験だ。著者らはプロンプトにまず例をいくつか置く。一方のグループは正しいプログラム、もう一方は細かな誤り、たとえば境界の off-by-one エラーや一文字のタイプミスを含むものだ。そのうえでモデルに次の問題を書かせる。
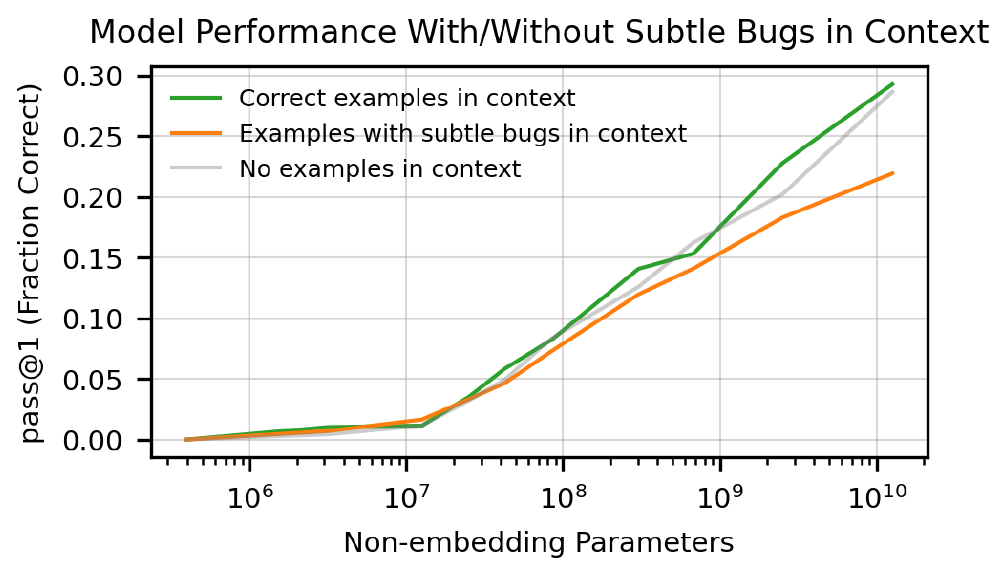
緑線は正しい例を見た場合、オレンジ線は誤りのある例を見た場合、灰色線は例なしだ。モデルが小さいうちは三本ともほぼ同じだが、モデルが大きいほどオレンジ線の遅れが大きくなり、12B ではおよそ 0.22 対 0.29 になる。著者らはプロンプトで「正しいプログラムを書け」とはっきり求めることも試したが、少し効いただけだった。
Codex の訓練目標は訓練データを真似ることなので、文脈にバグがあれば、それにならってバグのあるコードを書く。正しく書く能力はあるのに、ユーザーが本当に望むとおりにはしない。論文はこれをミスアラインメント(misalignment)と呼び、「能力不足」と区別する。できないのは能力の問題で、できるのにやらないのがミスアラインメントだ。厄介なのは、この差がモデルが大きくなるほど広がることだ。論文が付録で挙げている改善の方向には、人間のフィードバックによる強化学習も含まれている。
ハザード分析
論文の第 7 節はハザード分析で、分量は前半の実験に引けを取らない。
- 過度の依存:Codex は、正しく見えて実はユーザーの求めを満たしていないコードを出すことがあり、初心者は特に引っかかりやすい。能力が高いほど、人は警戒を解きやすくなる。
- セキュリティ:モデルは脆弱性のあるコードを書くことがある。著者らはテストの結果、当時の能力では、Codex がマルウェアを書くハードルを目立って下げることはないと判断した。
- 経済:エンジニアの一日の仕事はコードを書くことだけではないので、短期的な影響は限られる。ただ、Codex が各パッケージを使う頻度には差があり、よく推薦されるパッケージの作者はそれで得をするかもしれない。
- 法律:生成されたコードが訓練データとまったく同じになるケースは 0.1% 未満で、しかもその多くは言語の中で繰り返し現れる定番の書き方だ。
その後
HumanEval はすぐにコードモデルの標準の試験問題になり、ほぼすべての LLM 技術報告がその pass@1 を載せるようになった。ただ、164 問で平均 7.7 個のテストでは、長く使ううちに穴が見えてくる。2023 年の EvalPlus は各問に大量のテストを自動で追加し、総数は元の約 80 倍になった。各モデルの pass@k は最大で 19.3% から 28.9% 下がり、順位も入れ替わった。もともと「通過」していたプログラムの少なからぬものが、たまたまテストされていなかっただけだった。
スコアもすぐに天井に達した。2023 年の GPT-4 は 67% で、2024 年にはフロンティアモデルの pass@1 が 9 割を超えていた。結局、より実際の仕事に近い評価に乗り換えるしかなくなった。たとえば、モデルに GitHub の issue を直させる SWE-bench だ。
Codex というモデル自体については、OpenAI が 2023 年 3 月に API の Codex シリーズの提供を終了している。名前のほうは無駄にならなかった。2025 年 4 月、OpenAI はターミナルでコードを書く Codex CLI を、5 月にはクラウドのコーディングエージェントを出し、どちらも Codex と名づけた。
結論
Codex が示したのは、GPT を大量のコードでさらに訓練すれば、docstring から動く関数を書けるようになるということだ。12B は一回のサンプリングで HumanEval の 28.8% を解き、各問 100 回サンプリングすれば、7 割以上の問題で少なくとも一回は正解する。
この論文で最も長く残ったのは、採点のルールだ。プログラムの正誤はテストに判定させ、参照解答と字面で比べない。pass@k は問題ごとに推定してから平均する。その後数年のコードモデルは、ほぼすべてこのルールで比べられてきた。
だから docstring を適当に書けば、モデルが書いてくるものもそうそう真面目にはならない。GitHub でモデルが読んできた docstring には、「I just found this function online」なんてものまであるのだから。