原論文
Reflexion: Language Agents with Verbal Reinforcement Learning
- 発表先
- NeurIPS 2023国際会議
- arXiv への初回投稿
- arXiv:2303.11366
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{reinforcementlearningreflexion2023,
  title = {{Reflexion: Language Agents with Verbal Reinforcement Learning}},
  author = {Noah Shinn and Federico Cassano and Edward Berman and Ashwin Gopinath and Karthik Narasimhan and Shunyu Yao},
  year = {2023},
  eprint = {2303.11366},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2303.11366}
}
2023 年の春、言語モデルをエージェントとして使う研究が一気に増えた。ReAct はモデルに考えながら資料を調べさせ、Toolformer はモデルに自分でツールを呼び出させた。ほかにも、ゲームやウェブページ、プログラミング環境の中でモデルに作業をさせる研究があった。
これらのエージェントはどれも同じで、失敗しても何も学べない。従来の強化学習は失敗から学べるが、大量の試行と高価な微調整が必要で、数百億パラメータのモデルにはあまり現実的でない。だから当時のエージェントはプロンプトの例に頼るしかなく、今回間違えたことは、次回もそのまま同じように間違えた。
米国 Northeastern University の Shinn ら(後の版では Princeton の Narasimhan と Yao が加わった)は、発想を変えた。人は失敗した後、どこで間違えたか、次はどうすべきかを振り返る。モデルにも同じことをさせればよい。反省を文章に書き、次の試行のプロンプトに入れるのだ。重みはまったく動かさず、学んだことはすべてテキストに書かれる。
問題の定義
エージェントは環境の中で一連の行動をとり、最後にフィードバックを受け取る。このフィードバックはたいてい疎で、「成功」か「失敗」だけ、あるいはスコアが一つだけということもある。
従来の強化学習がこうした信号から学ぶとき、難しいのは信用割り当て(credit assignment)だ。何十もの行動が続いたとき、いったいどのステップが間違っていたのか。0 か 1 の一つだけでは、なかなか答えられない。
著者らが問うのは、言語モデル自身にこの疎な信号を、たとえば「3 ステップ目で違うものを取った。次はまず机に行って卓上ランプを探すべきだ」のような具体的な助言へと「増幅」させ、そのテキストで次の試行を導けないか、ということだ。
問題を解く
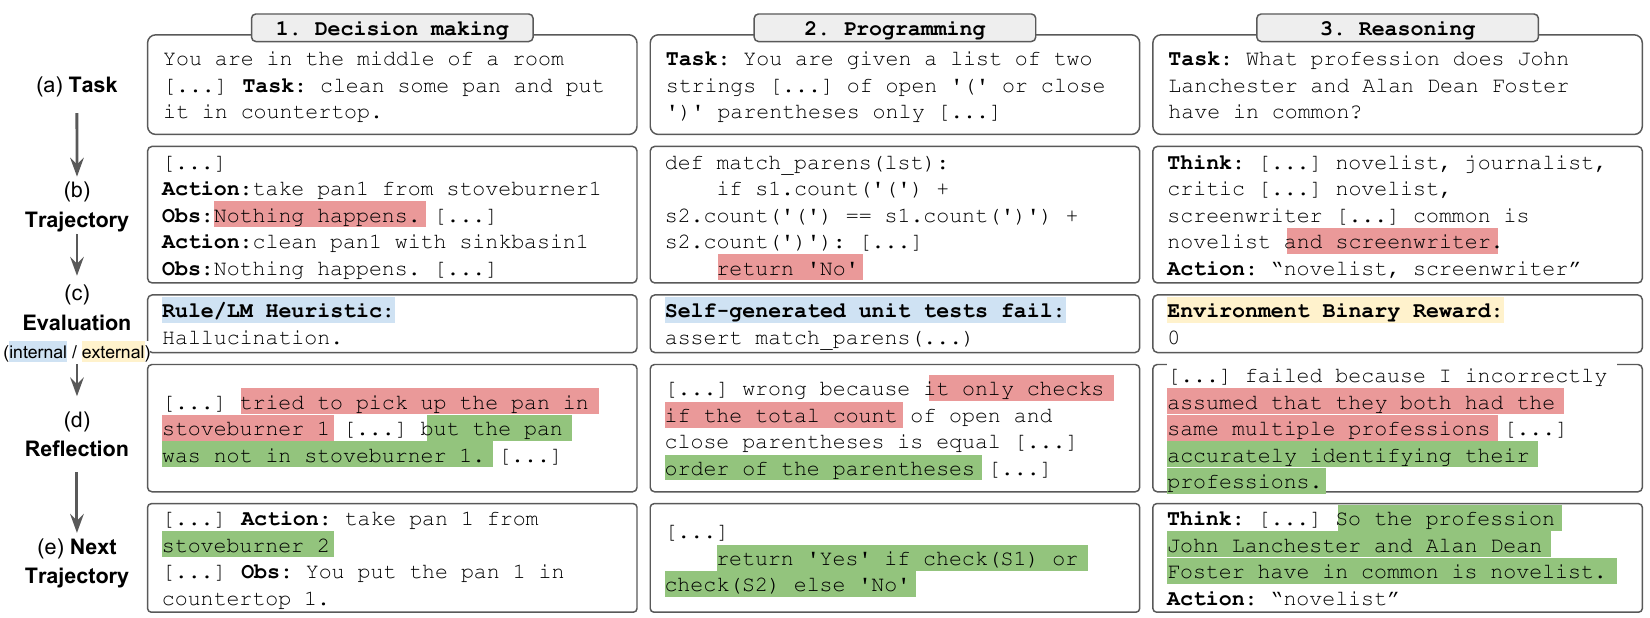
三つのモデル
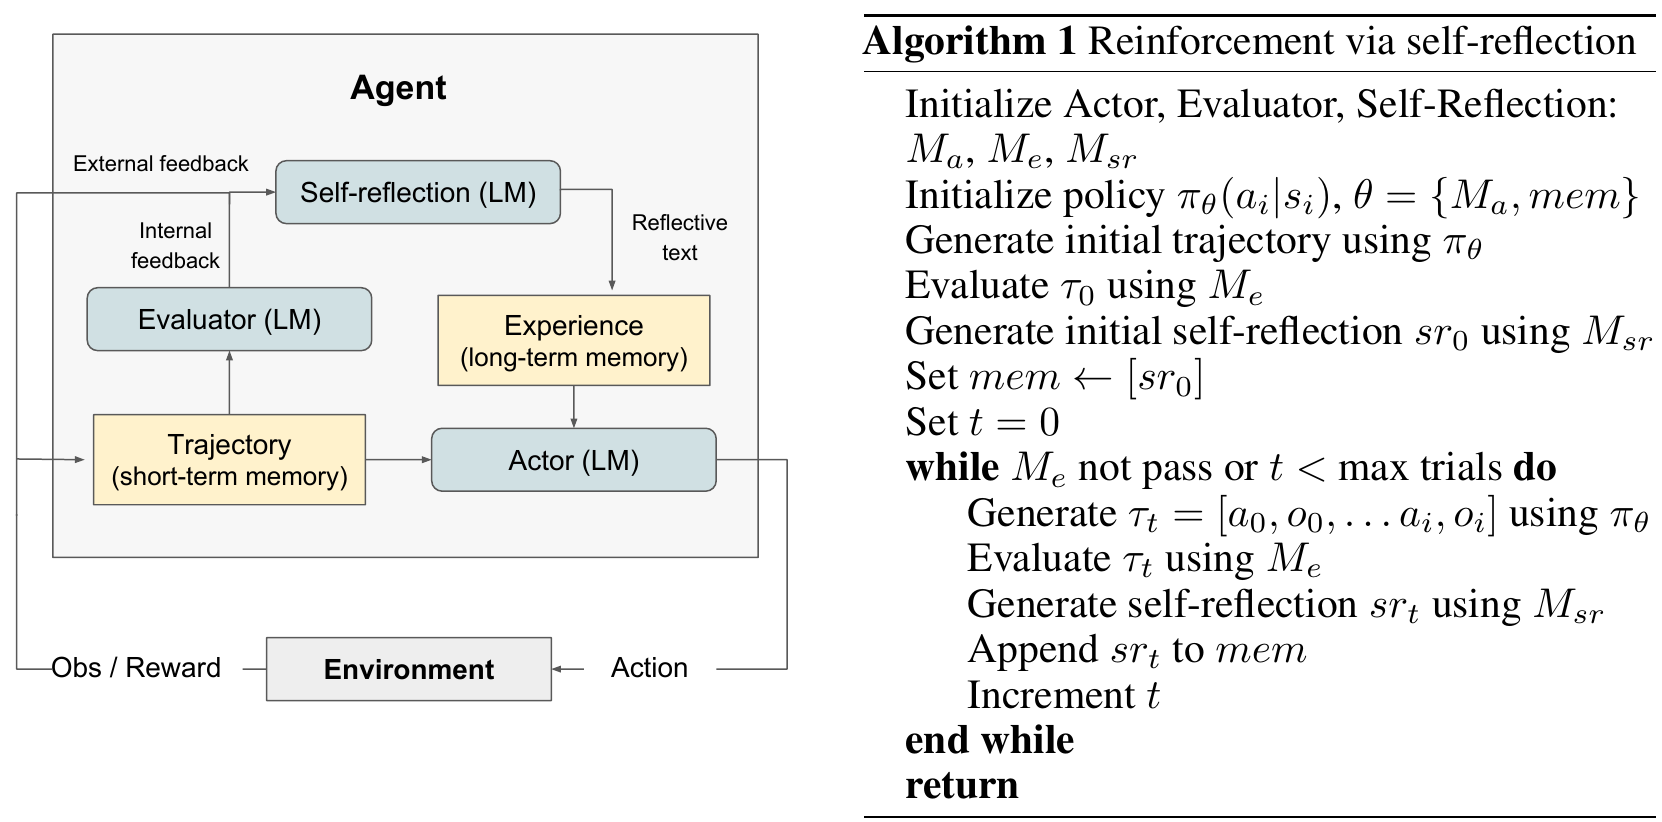
Reflexion は三つの役割からなる。三つとも同じ言語モデルでよく、プロンプトが違うだけだ。
- Actor:環境の中で作業し、テキストと行動を生成する。著者らは思考の連鎖と ReAct の二つの書き方を試し、プロンプトに記憶の欄を加えた。
- Evaluator:今回の出来を評価する。推論問題では正解と完全に一致するか(exact match)で判定する。意思決定タスクでは前もって書いたルールを使うか、別の言語モデルに成否を判定させる。プログラミング問題では、モデルが自分で書いた単体テストを走らせる。
- Self-reflection:成否の信号、今回の軌跡、過去の記憶を受け取り、どこで間違えたか、次はどうするかを説明する反省を書く。
二種類の記憶
今回の試行の完全な軌跡は短期記憶で、細部が多い。反省として書いたテキストは長期記憶で、より簡潔で、学んだ教訓が保存されている。次の試行では、Actor はこの二種類の記憶を両方見る。
長期記憶をいくらでも溜めることはできない。そうするとプロンプトの長さの上限を超えてしまう。著者らは直近の反省だけを残し、意思決定と推論のタスクでは 3 つ、プログラミングのタスクでは 1 つにした。
流れ
- Actor が一回試行し、軌跡 を得る。
- Evaluator がスコア を出す。
- Self-reflection が をもとに反省 を書き、記憶に入れる。
- 繰り返し:Actor が記憶を持ってもう一度試行し、評価し、新しい反省を書いて記憶に加える。Evaluator が成功と判定するか、試行回数を使い切るまで続ける。
著者らはこれを「言語による」強化学習と呼んでいる。従来の強化学習では方策は重みで決まるが、ここでの方策は「言語モデル + 記憶」で、方策の更新は記憶の中のテキストを書き換えることで行われる。著者らは、この方法が言語モデルの自己評価の能力に依存していて、成功する保証は何もないことも率直に認めている。
議論
意思決定:AlfWorld
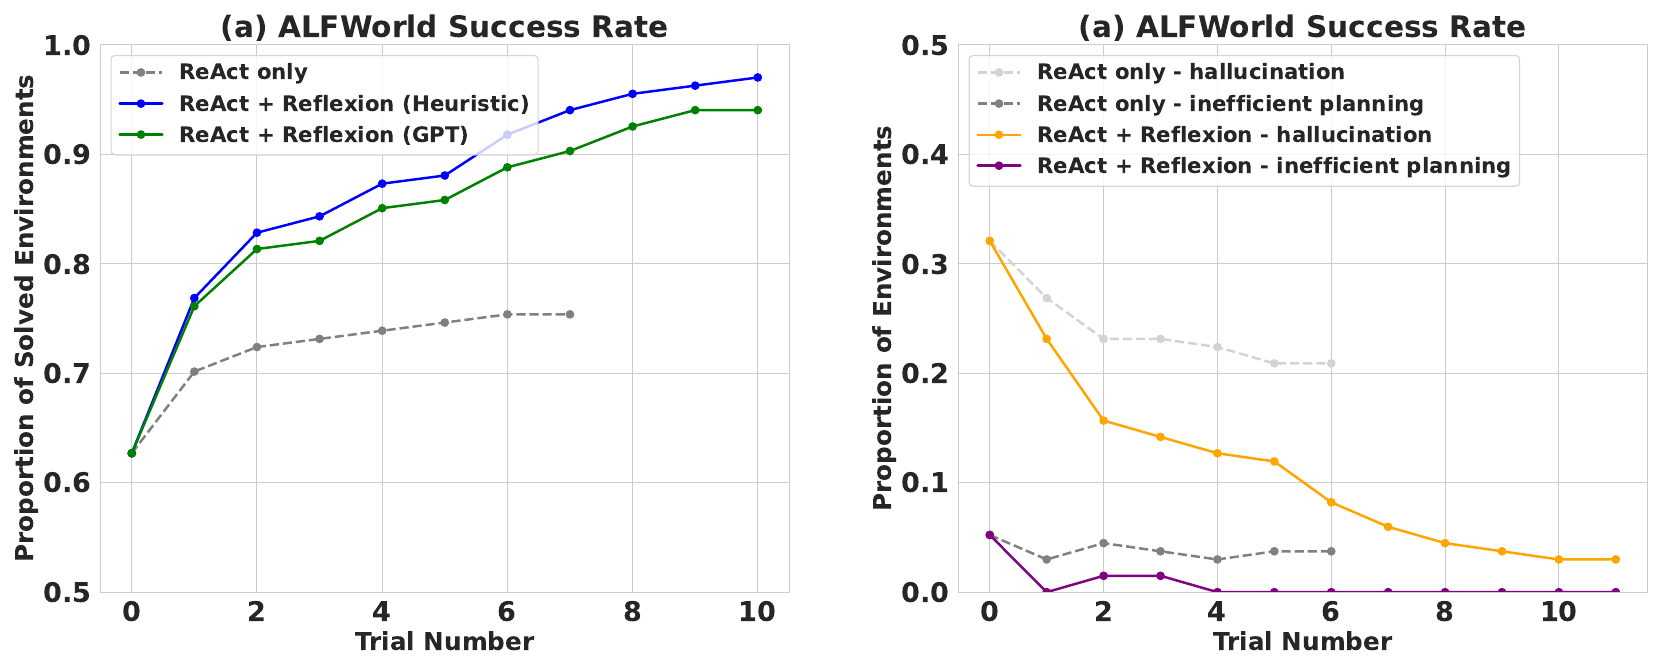
AlfWorld はテキスト版の家庭環境で、エージェントはテキストの指示でタスクをこなす。たとえば引き出しに隠れたフライ返しを見つける、包丁をまな板に持っていく、トマトを冷蔵庫に入れて冷やす、といったものだ。著者らは ReAct の設定を踏襲して 134 の環境でテストし、Actor には ReAct を使った。
この環境はタスクが完了したかどうかしか教えてくれないので、Evaluator はいつ失敗とみなすかを自分で判断しなければならない。著者らは単純なルールを二つ使った。同じ行動を 3 回を超えて繰り返し、同じ応答を得たらハルシネーションと判定し、この環境での行動が 30 ステップを超えたら非効率な計画と判定する。
結果、ReAct + Reflexion は 134 タスクのうち 130 を解いた。ReAct 単独では、6、7 回目の試行以降はもう伸びなかった。
右図は失敗を原因別に分類したものだ。ReAct で最も多い失敗は、あるものをもう手に入れたと思い込んでいて実は持っていない、というもので、その後に長々と行動を続けても誤りを取り戻せない。この種のハルシネーションはずっと 22% 前後にとどまった。Reflexion は長い失敗の軌跡を数文の注意書きに凝縮し、次回はそれを避ける。
付録には具体的な例がある。タスクは「卓上ランプでマグカップを調べる」で、エージェントはまずマグカップを見つけて手に取り、それから卓上ランプを探したが、うまく使えなかった。反省にはこう書かれた。自分の計画はマグカップを探してからランプを探すことだったが、タスクはランプでマグカップを調べることなので、先にランプを探すべきだった。ランプは机 1 の上にあったので、次は直接机 1 に行く。二回目の試行では、エージェントは三つの行動でタスクを完了した。
推論:HotPotQA
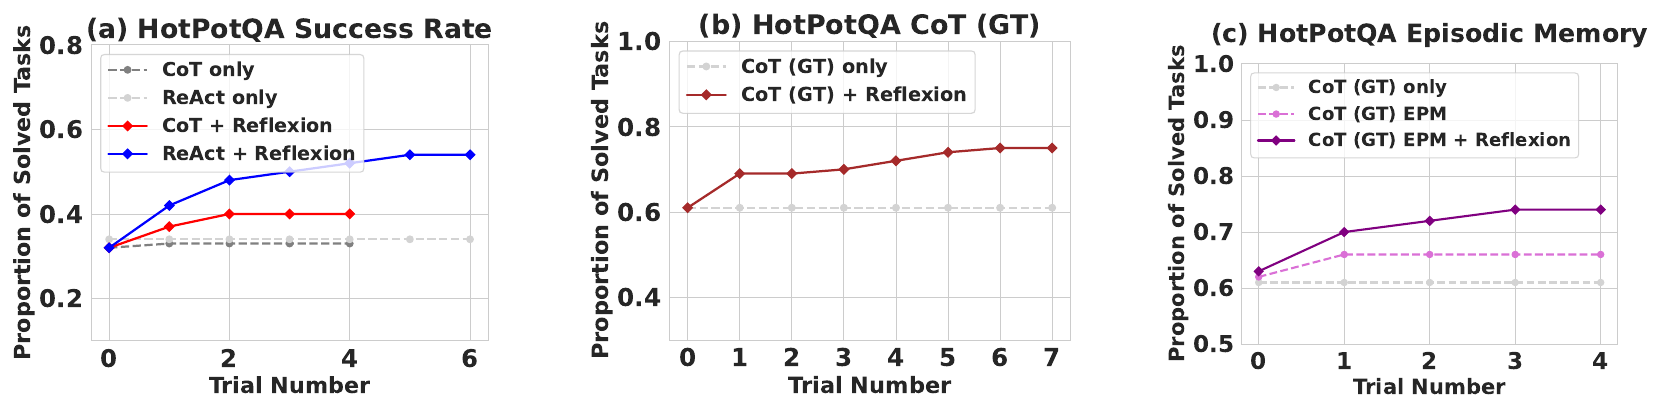
HotPotQA は、Wikipedia の記事を何本もまたがないと答えられない問題だ。著者らは三種類のエージェントを、どれも 100 問で試した。
- ReAct:Wikipedia の API で検索でき、考えながら調べる。
- 思考の連鎖:資料は調べず、推論だけに頼る。
- 正しい背景段落を加えた思考の連鎖(CoT (GT)):データセットに付いている正しい段落をそのままモデルに与え、推論能力だけを測る。
単独で使うと、三種類のエージェントはどれも、何回やり直しても新しく正解する問題がなく、温度 0.7 でサンプリングしても同じだった。Reflexion を加えると、ReAct は約 20 ポイント多く正解した。正しい段落がある思考の連鎖はもともとスコアが高めだが、それでも 39% の問題を間違えていて、Reflexion は正答率をさらに 14 ポイント引き上げた。
改善は反省から来ているのか、それとも前回の試行を見たからにすぎないのか。右図のアブレーションは、この二つを分けて比べている。前回の完全な軌跡だけをプロンプトに入れても、いくらか効果はある。一人称の反省を加えると、さらに 8 ポイント上がる。著者らはこれをもとに、モデルにただもう一度書き直させるより、反省してから書き直させるほうが効果が高いと考えている。
ここでは採点の仕方に注意が必要だ。HotPotQA では毎回の試行の後、環境が正解を使って正誤を判定し、今回は成功か失敗かをエージェントに伝える。言い換えれば、エージェントは自分が間違えたことを毎回知っていて、知らないのは正解が何かだけだ。この設定には後でまた触れる。
プログラミング:HumanEval、MBPP、LeetCode
プログラミング問題は、Reflexion が最も鮮やかに活躍する舞台だ。正解を必要としない評価方法、つまり自分でテストを書くという手があるからだ。
著者らはまず思考の連鎖でモデルにさまざまな単体テストを書かせ、構文木で検査して構文的に正しいものだけを残し、その中から最大 6 個を抜き出してテストセットにする。プログラムを書いたらこれらのテストを走らせ、通らなければ反省して書き直し、すべて通ってはじめて提出する。この過程で問題の隠しテストには一切触れないので、提出された一本はやはり pass@1 として数えられる。
| 評価(言語) | 従来の最高 | GPT-4 | Reflexion |
|---|---|---|---|
| HumanEval(Python) | 65.8 | 80.1 | 91.0 |
| HumanEval(Rust) | - | 60.0 | 68.0 |
| MBPP(Python) | 67.7 | 80.1 | 77.1 |
| MBPP(Rust) | - | 70.9 | 75.4 |
| LeetCode Hard(Python) | - | 7.5 | 15.0 |
原論文 Table 1 をもとに整理。従来の最高は CodeT と GPT-3.5 または Codex の組み合わせで、単位は pass@1 の %。
- Rust の問題は、MultiPL-E で Python の問題を自動翻訳したものだ。HumanEval は最も難しい 50 問だけを使い、手法が言語に依存しないことを示している。
- LeetCode Hard は著者らが新しく作った 40 問で、どれも 2022 年 10 月 8 日(GPT-4 の事前学習データのカットオフ日)より後に公開された。
- ここでの GPT-4 は著者らが自分で測ったもので、HumanEval は 80.1% と、GPT-4 のテクニカルレポートにある 67.0% より高い。
HumanEval Python は 80.1% から 91.0% に上がったが、MBPP Python はむしろ 80.1% から 77.1% に下がった。著者らが原因を調べると、問題はモデルが自分で書いたテストにあった。
テストの誤りには二種類ある。一つはテストがゆるすぎて、間違ったプログラムでもすべて通ってしまう場合で、エージェントは間違った答えを早々に提出してしまう。もう一つはテスト自体が間違っていて、正しいプログラムが通らない場合で、エージェントは実は間違っていないプログラムについて反省することになる。著者らは後者のほうがまだ許容できると考えている。エージェントには、反省の中でテストのほうが間違っていると気づくチャンスが残るからだ。
MBPP Python では「テストはすべて通るのにプログラムは間違っている」割合が 16.3%、HumanEval Python ではわずか 1.4% だった。両者の基準の正答率はほぼ同じなので、差はテストの質にある。
一部を取り除くとどうなるか
著者らは HumanEval Rust の最も難しい 50 問でアブレーションを行った。ベースモデルは GPT-4 だ。
| やり方 | 自作テスト | 反省 | pass@1 |
|---|---|---|---|
| ベースモデル | いいえ | いいえ | 60% |
| テストを書かない | いいえ | はい | 52% |
| 反省しない | はい | いいえ | 60% |
| Reflexion | はい | はい | 68% |
原論文 Table 3 をもとに整理。
テストを書かずに反省だけすると、ベースモデルよりかえって悪くなる。エージェントは今のプログラムが正しいかどうかを判断できないので、すべての回を使い切るまで修正を続け、もともと正しかったプログラムまで壊してしまう。
テストはあっても反省しないと、まったく改善しない。テストとコンパイラは構文や論理の誤りを確かに捕まえているが、モデルがそのまま書き直すとき、その修正は捕まった誤りに対応していない。著者らはこれをもとに、反省なしで闇雲に試行錯誤するだけのデバッグは、Rust のような難しめのタスクではあまり効果がないと考えている。
モデルが十分に強くなければならない
付録では、異なるモデルで同じことをやり直している。オープンソースの starchat-beta は HumanEval Python で、Reflexion を使っても使わなくても 26% だった。HotPotQA では、text-davinci-003、gpt-3.5-turbo、gpt-4 のどれも Reflexion を加えると伸びた。著者らの結論は、役に立つ自己修正を書けるのは、より強く大きいモデルだけが持つ能力だ、というものだ。
限界
- 局所最適:Reflexion は本質的にテキストで方策を最適化するものなので、十分に良くない解にはまり込むことがある。付録の WebShop の実験がその例だ。エージェントはショッピングサイトで要件に合う商品を探さなければならないが、4 回試行しても改善せず、書かれた反省も役に立たなかった。著者らは、この種のタスクには検索キーワードを変えるといった、非常に多様で創造的な探索が必要で、Reflexion にはそれができないと考えている。
- 記憶が単純:直近のいくつかを残すだけのスライディングウィンドウで、著者らは将来、ベクトルデータベースや SQL データベースに替えることを提案している。
- テストの限界:非決定的な関数、外部 API を呼び出す関数、出力がハードウェアによって変わる関数や並列処理を含む関数は、どれも正確なテストを書くのが難しい。
著者らはまた、プログラムを自動で書く実験は隔離された環境で走らせるよう注意を促している。生成されたプログラムは、実行前に何のチェックも受けていないからだ。
その後
2023 年 10 月、Google DeepMind と UIUC の Huang らは Large Language Models Cannot Self-Correct Reasoning Yet で、この種の自己修正研究に共通する問題を指摘した。Reflexion を含む手法はどれも、修正をいつやめるかを正解で決めている。正解したらやめ、間違えたときだけ続ける。現実の状況では、正解はわからない。
彼らはかなり鋭い対照群を設計した。やり直すかどうかは同じく正解で決めるが、「修正」の仕方は残りの選択肢から適当に一つ選び直すだけ、というものだ。CommonsenseQA は五択なので、一回間違えるごとに選択肢が一つ消え、当てずっぽうを最大四ラウンド続ければ必ず当たる。
GPT-3.5 と GPT-4 の CommonsenseQA での出発点は、それぞれ 75.8% と 82.0%。当てずっぽうを二ラウンド行うと GPT-3.5 は 87.9% に達し、モデルに二ラウンド自己修正させた 89.7% とほぼ同じだった。GPT-4 は当てずっぽうで 91.0% と、自己修正の 85.5% より高い。四ラウンド当てずっぽうを続ければ、どちらも 100% になる。誰かが「違う、もう一回」と言ってくれさえすれば、まったく頭を使わなくても正答率はどんどん上がる。正解を取り除くと、モデルが推論問題を自分で修正したときの成績は、上がるどころか下がることがわかった。
この批判は主に推論問題に向けられている。プログラミング問題は事情が違い、テストと実行環境そのものが、正解を必要としないチェックになる。Reflexion が HumanEval で取った 91% は、まさにこの方法で得たものだ。Huang らも、プログラム生成のように実行環境と単体テストで検証できるタスクは別の話だと述べている。
その後のコーディングエージェントもこの道を進んだ。コードを書き、テストを走らせ、エラーメッセージを読み、修正する。これを繰り返す。違うのは、テストがプロジェクト本来のテストに、フィードバックが本物のエラーメッセージに替わったことだ。
結論
Reflexion は重みを変えず、失敗した経験を毎回反省として書き、次の試行のプロンプトに入れる。AlfWorld では 134 タスクのうち 130 を解き、HotPotQA では約 20 ポイント多く正解し、HumanEval Python の pass@1 は 80.1% から 91.0% になった。
最も説得力があるのはプログラミング問題だ。テストはモデルが自分で書いたもので、提出前に正解は一切見ていない。アブレーションも、テストと反省のどちらが欠けてもだめなことを示した。テストなしで反省だけすると、成績はかえって悪くなる。
推論問題の部分は割り引いて見る必要がある。エージェントは毎回「間違えた」と知らされていて、それこそ現実の世界で最も欠けている情報だからだ。反省がどれほどうまく書けていても、まず誰かに間違いだと言ってもらわなければ始まらない。