Article original
Large Language Models are Zero-Shot Reasoners
- Publication
- NeurIPS 2022Conférence
- Premier dépôt sur arXiv
- arXiv:2205.11916
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{transformerszeroshotcot2022,
  title = {{Large Language Models are Zero-Shot Reasoners}},
  author = {Takeshi Kojima and Shixiang Shane Gu and Machel Reid and Yutaka Matsuo and Yusuke Iwasawa},
  year = {2022},
  eprint = {2205.11916},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2205.11916}
}
L'article de GPT-3 s'intitule « Language Models are Few-Shot Learners ». Depuis, quand on parle de ce qui rend les grands modèles de langage impressionnants, on pense d'abord à l'apprentissage few-shot ; quelques exemples dans le prompt, et le modèle apprend une nouvelle tâche.
Le prompting par chaîne de pensée de janvier 2022 suit la même voie. On écrit les étapes du raisonnement dans la réponse des exemples, le modèle fait de même, et les scores en maths progressent nettement. L'article ne donne même pas de résultats en zero-shot, comme s'il était inutile de comparer sans exemples.
Quatre mois plus tard, Kojima, de l'Université de Tokyo, Shane Gu, de Google, et leurs collègues découvrent qu'on peut se passer complètement d'exemples. Il suffit d'ajouter « Let's think step by step » devant la réponse pour que text-davinci-002 passe de 17.7 % à 78.7 % sur MultiArith, et de 10.4 % à 40.7 % sur GSM8K.
Définir le problème
La chaîne de pensée few-shot pose deux problèmes. Il faut écrire les exemples à la main, tâche par tâche, avec des étapes de raisonnement bien rédigées et un format de réponse uniforme ; et quand les exemples ne correspondent pas aux questions, les résultats se dégradent nettement, comme le montreront les chiffres plus loin.
Le prompting zero-shot existait déjà, mais il s'agissait surtout de concevoir un gabarit pour chaque tâche, à repenser dès qu'on change de tâche.
Existe-t-il une phrase, indépendante de la tâche, qui suffise à faire écrire au modèle un raisonnement en plusieurs étapes, sans aucun exemple ? C'est la question que pose cet article.
Résoudre le problème
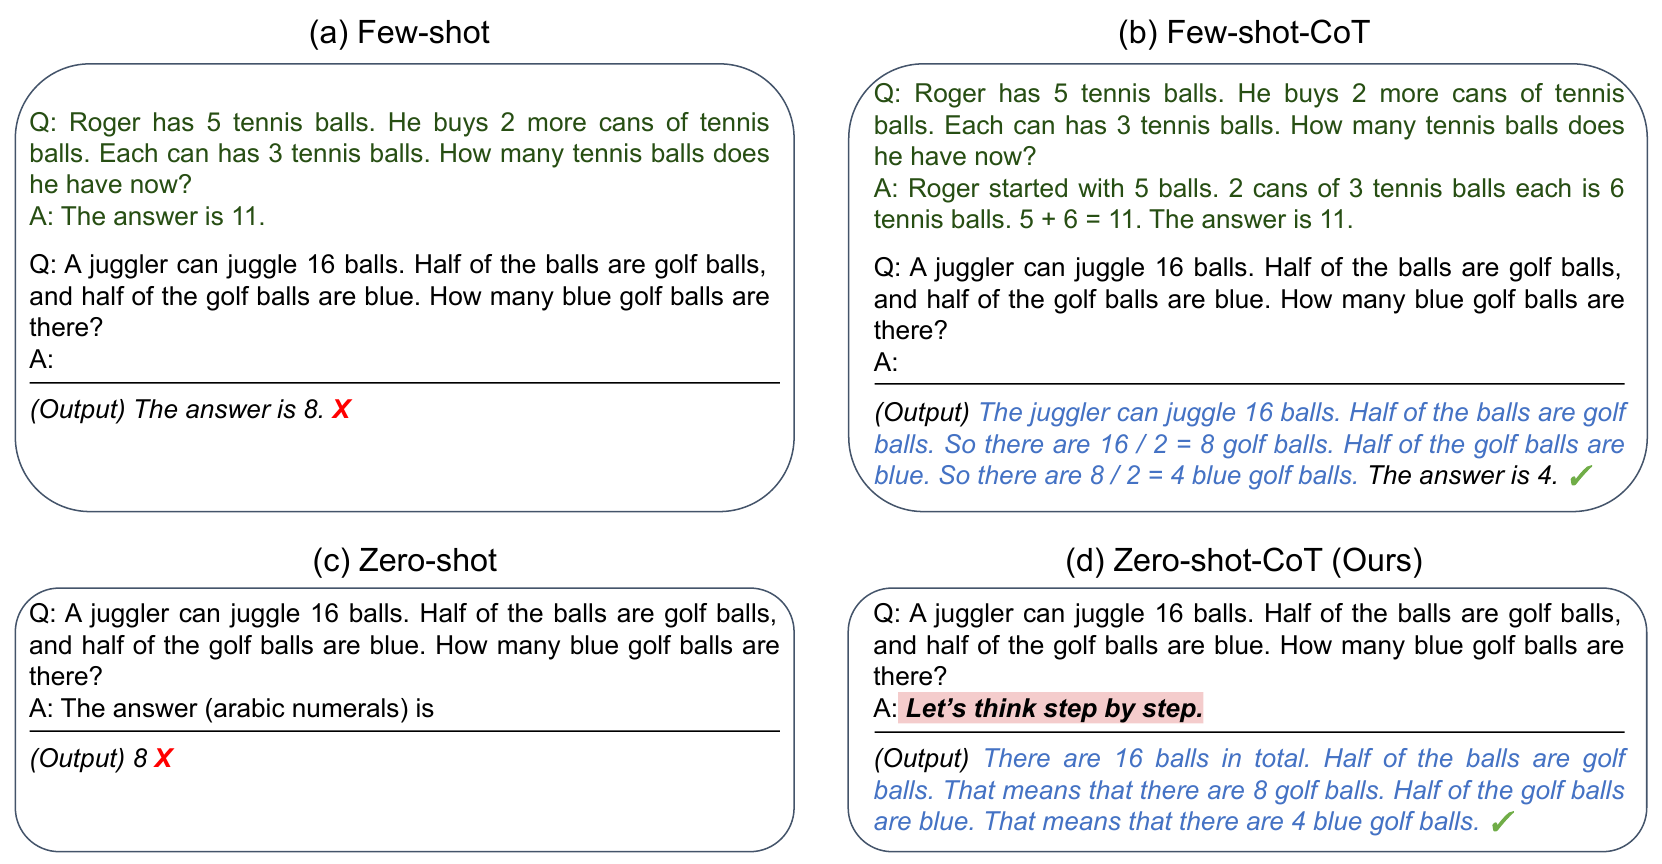
En haut, le few-shot ; en bas, le zero-shot. À gauche, la réponse directe ; à droite, le raisonnement d'abord. La case en bas à droite est la méthode de l'article, sans aucun exemple, avec la même phrase pour toutes les tâches.
Un prompt en deux temps
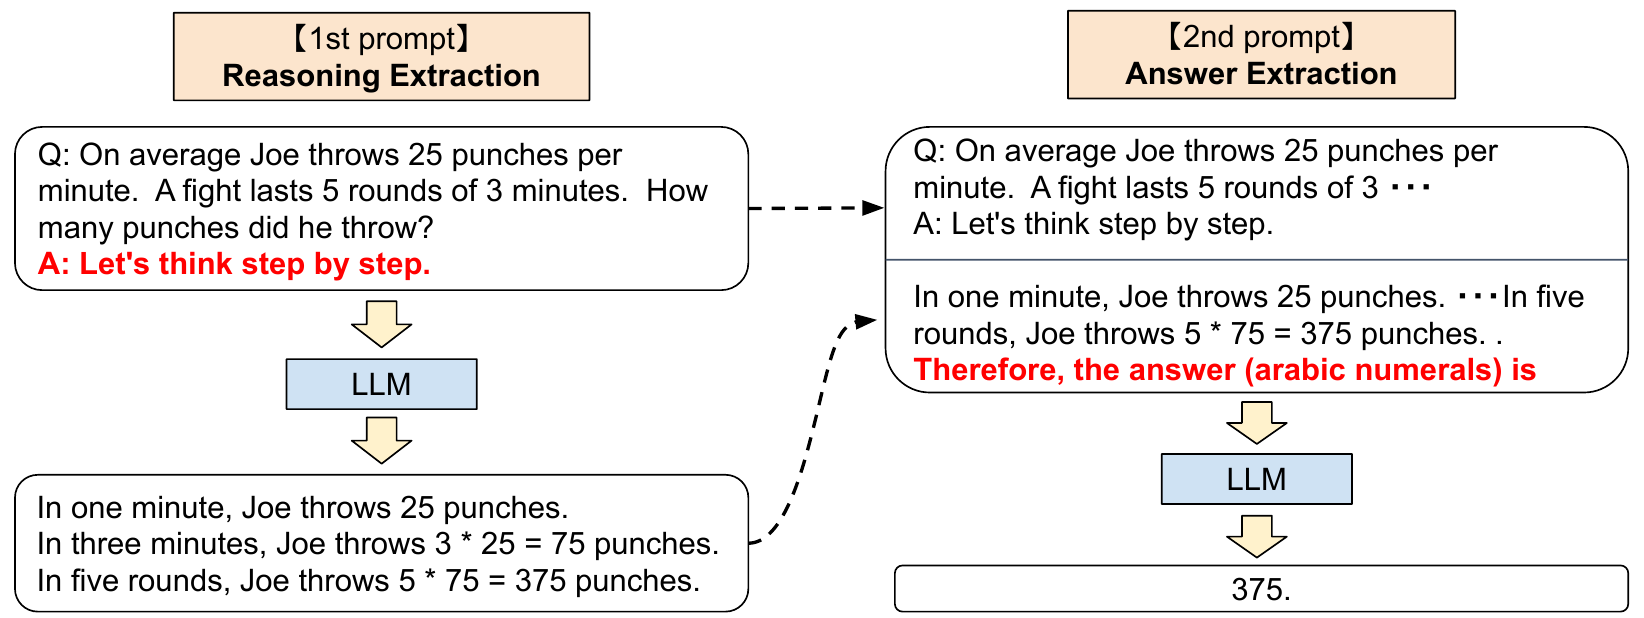
La méthode tient en une phrase, mais en pratique, il faut interroger le modèle deux fois :
- Extraction du raisonnement : on insère la question dans « Q: [question]. A: Let's think step by step. » et l'on laisse le modèle poursuivre, ce qui donne le raisonnement . Tout l'article utilise le décodage glouton.
- Extraction de la réponse : on renvoie au même modèle le premier prompt et le raisonnement , suivis d'une phrase de déclenchement de la réponse. Pour les réponses numériques, c'est « Therefore, the answer (arabic numerals) is » ; pour les QCM, « Therefore, among A through E, the answer is ».
La seconde étape est nécessaire parce qu'aucun exemple ne montre qu'il faut finir par « The answer is X » ; une fois le raisonnement écrit, le modèle ne donne pas forcément de lui-même une réponse facile à extraire. Le prompting few-shot se passe de cette étape, puisque les exemples ont déjà montré le format de réponse.
Une fois la réponse donnée, il reste à la nettoyer. Pour les nombres, on prend le premier nombre qui apparaît ; pour les QCM, la première lettre majuscule ; pour les questions oui/non, le premier yes ou no. Dans le problème de boxe ci-dessus, le modèle écrit « 375. » à la seconde étape, et le nettoyage donne 375. Ces règles sont rudimentaires ; si le modèle écrit d'un coup « B, C, and D », on ne récupère que B, et si la phrase commence par Among, la première majuscule trouvée est le A de Among. Mais toutes les méthodes utilisent les mêmes règles, si bien que la comparaison reste à peu près équitable.
Dispositif expérimental
- Tâches : 12 jeux de données répartis en quatre catégories. En arithmétique, SingleEq, AddSub, MultiArith, AQUA-RAT, GSM8K et SVAMP, les deux premiers se résolvant le plus souvent en une seule étape ; en sens commun, CommonsenseQA et StrategyQA ; en raisonnement symbolique, la concaténation des dernières lettres de quatre noms et une pièce retournée quatre fois ; en autres raisonnements logiques, la compréhension de dates et le suivi de trois objets échangés, tirés de BIG-bench.
- Modèles : 17 au total, de 0.3B à 540B. Les expériences principales utilisent InstructGPT (text-ada/babbage/curie/davinci-001 et text-davinci-002), le GPT-3 d'origine en quatre tailles et PaLM 8B/62B/540B ; l'étude d'échelle ajoute GPT-2, GPT-Neo, GPT-J, T0 et OPT. Sauf mention contraire, le modèle est text-davinci-002.
- Références : la référence zero-shot utilise des phrases de déclenchement de réponse similaires ; le few-shot et la chaîne de pensée few-shot reprennent les exemples de Wei et al., avec le même jeu de 8 exemples pour l'arithmétique.
Discussion
Face au zero-shot
| Jeu de données | Zero-shot | Zero-shot CoT |
|---|---|---|
| SingleEq | 74.6 | 78.0 |
| AddSub | 72.2 | 69.6 |
| MultiArith | 17.7 | 78.7 |
| GSM8K | 10.4 | 40.7 |
| AQUA-RAT | 22.4 | 33.5 |
| SVAMP | 58.8 | 62.1 |
| CommonsenseQA | 68.8 | 64.6 |
| StrategyQA | 12.7 | 54.8 |
| Compréhension de dates | 49.3 | 67.5 |
| Suivi d'objets échangés | 31.3 | 52.4 |
| Dernières lettres | 0.2 | 57.6 |
| Pièce retournée | 12.8 | 91.4 |
D'après la Table 1 de l'article, avec les phrases de déclenchement adaptées au format de réponse ; valeurs en %.
Les tâches qui demandent un raisonnement en plusieurs étapes progressent toutes fortement. MultiArith gagne 61 points, la concaténation des dernières lettres passe de presque 0 à 57.6 %, et la pièce retournée de 12.8 % à 91.4 %. SingleEq et AddSub, qui ne demandent guère de calcul en plusieurs étapes, restent à peu près au même niveau.
CommonsenseQA, à l'inverse, recule de 68.8 % à 64.6 %. Les auteurs rappellent que l'article sur la chaîne de pensée observait un phénomène semblable ; la chaîne de pensée few-shot n'aidait pas LaMDA 137B sur les questions de sens commun, et ne devenait efficace sur StrategyQA qu'avec PaLM 540B.
Deux chiffres du tableau méritent un second regard. StrategyQA et la pièce retournée sont des questions oui/non, où le hasard donne 50 %, et pourtant la référence zero-shot n'obtient qu'environ 12 %. Le tableau d'origine donne aussi les résultats obtenus en extrayant la réponse avec « The answer is » ; ces deux références zero-shot remontent alors à 54.3 % et 53.8 %. Une partie des mauvais scores de la référence zero-shot semble donc venir de réponses mal extraites ; pour la chaîne de pensée zero-shot, l'écart entre les deux méthodes d'extraction est bien plus faible.
Face au few-shot
| Méthode | MultiArith | GSM8K |
|---|---|---|
| Zero-shot | 17.7 | 10.4 |
| Few-shot (8 exemples) | 33.8 | 15.6 |
| Chaîne de pensée zero-shot | 78.7 | 40.7 |
| Chaîne de pensée few-shot (2 exemples) | 84.8 | 41.3 |
| Chaîne de pensée few-shot (8 exemples) | 93.0 | 48.7 |
| Chaîne de pensée à 8 exemples, avec « Let's think step by step. » avant la réponse | 92.8 | 51.5 |
| GPT-3 175B fine-tuné | - | 33 |
| GPT-3 175B fine-tuné + vérificateur | - | 55 |
| PaLM 540B : zero-shot | 25.5 | 12.5 |
| PaLM 540B : chaîne de pensée zero-shot | 66.1 | 43.0 |
| PaLM 540B : chaîne de pensée zero-shot + Self-Consistency | 89.0 | 70.1 |
| PaLM 540B : chaîne de pensée few-shot | - | 56.9 |
D'après la Table 2 de l'article, sélection de lignes ; sauf mention du modèle, il s'agit de text-davinci-002 ; valeurs en %.
La chaîne de pensée zero-shot reste évidemment en dessous de la chaîne de pensée few-shot et de ses exemples soigneusement rédigés, mais elle bat le prompting few-shot standard à 8 exemples et, sur GSM8K, GPT-3 175B fine-tuné. Autrement dit, les 8 exemples du prompting few-shot apportent bien moins qu'une simple phrase « réfléchissons étape par étape ».
Ajoutée aux exemples de la chaîne de pensée few-shot, cette phrase fait encore passer GSM8K de 48.7 % à 51.5 %. Et avec l'échantillonnage et le vote de Self-Consistency, PaLM 540B atteint 70.1 % même en zero-shot.
Il faut un modèle assez grand
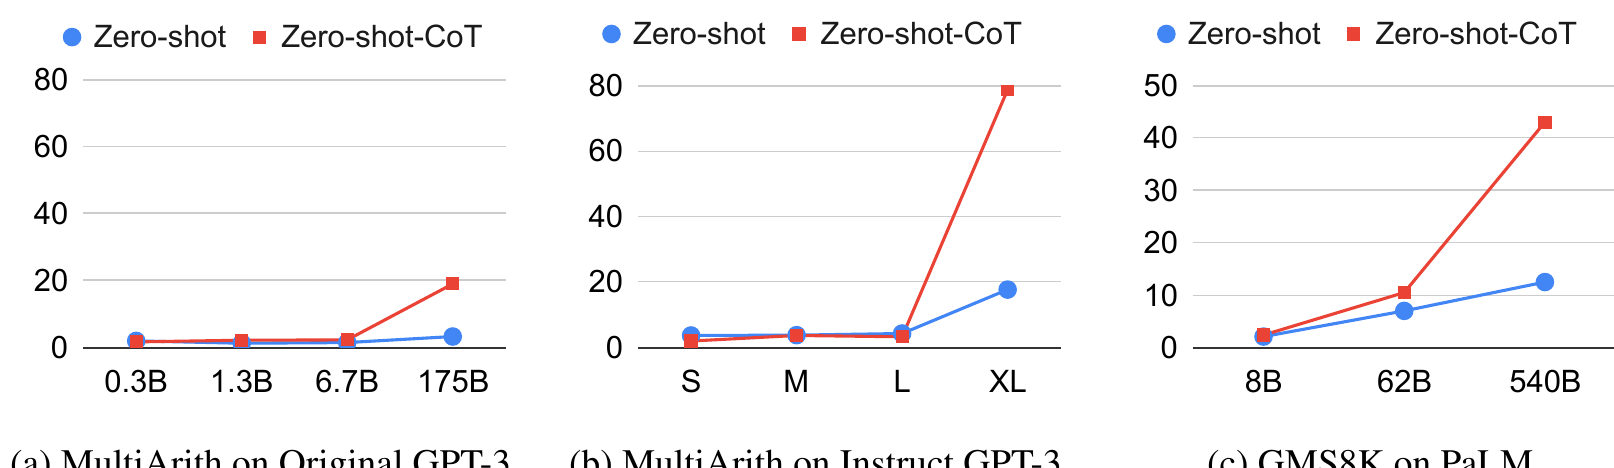
Sans raisonnement, agrandir le modèle ne fait presque pas bouger les scores ; avec cette phrase, ils grimpent en flèche à mesure que le modèle grossit. Sur les petits modèles, en revanche, elle est inutile, et les raisonnements produits sont de mauvaise qualité. C'est cohérent avec les résultats de la chaîne de pensée few-shot ; la capacité de raisonnement n'apparaît qu'à partir d'une certaine taille, et la phrase ne fait que la faire sortir.
Le gain du GPT-3 175B d'origine est bien plus faible que celui de text-davinci-002, qui a reçu un fine-tuning sur instructions ; les auteurs reconnaissent dans leur discussion que les détails des données d'entraînement de ces modèles ne sont pas publics, et qu'ils ne peuvent pas dire d'où vient la différence.
Et avec une autre phrase ?
| Type | Déclencheur | MultiArith |
|---|---|---|
| Incitatif | Let's think step by step. | 78.7 |
| Incitatif | First, | 77.3 |
| Incitatif | Let's think about this logically. | 74.5 |
| Incitatif | Let's solve this problem by splitting it into steps. | 72.2 |
| Incitatif | Let's think like a detective step by step. | 70.3 |
| Incitatif | Let's think | 57.5 |
| Incitatif | The answer is after the proof. | 45.7 |
| Trompeur | Don't think. Just feel. | 18.8 |
| Trompeur | Let's think step by step but reach an incorrect answer. | 18.7 |
| Trompeur | By using the fact that the earth is round, | 9.3 |
| Hors sujet | By the way, I found a good restaurant nearby. | 17.5 |
| Hors sujet | Abrakadabra! | 15.5 |
| Aucun | (zero-shot) | 17.7 |
D'après la Table 4 de l'article, 12 des 16 phrases de déclenchement ; text-davinci-002, valeurs en %.
Toutes les phrases qui incitent le modèle à raisonner fonctionnent, mais avec des écarts importants. Sans « step by step », « Let's think » tombe de 78.7 % à 57.5 %. Les phrases trompeuses ou hors sujet restent autour du niveau zero-shot, et « By using the fact that the earth is round » fait même chuter le score à 9.3 %. Les auteurs remarquent aussi que des déclencheurs différents amènent le modèle à rédiger son raisonnement de façons très différentes. Quant à trouver automatiquement de meilleurs déclencheurs, ils laissent la question ouverte.
Des exemples qui ne collent pas
| Méthode | AQUA-RAT | MultiArith |
|---|---|---|
| Zero-shot | 22.4 | 17.7 |
| Chaîne de pensée few-shot, exemples de CommonsenseQA | 31.9 | 27.0 |
| Chaîne de pensée zero-shot | 33.5 | 78.7 |
| Chaîne de pensée few-shot, exemples de la même tâche | 39.0 | 88.2 |
D'après la Table 5 de l'article ; valeurs en %.
Ici, on résout des problèmes de maths avec des exemples de sens commun. AQUA-RAT et CommonsenseQA sont tous deux des QCM, au même format, et les exemples aident encore un peu ; MultiArith attend une réponse numérique, dans un autre format, et les exemples ne servent presque à rien. Cela rejoint l'observation de Min et al., selon laquelle le modèle tire surtout des exemples le format de la réponse, plutôt que la tâche elle-même. Dans les deux cas, le résultat reste en dessous de la chaîne de pensée zero-shot.
Où le modèle se trompe
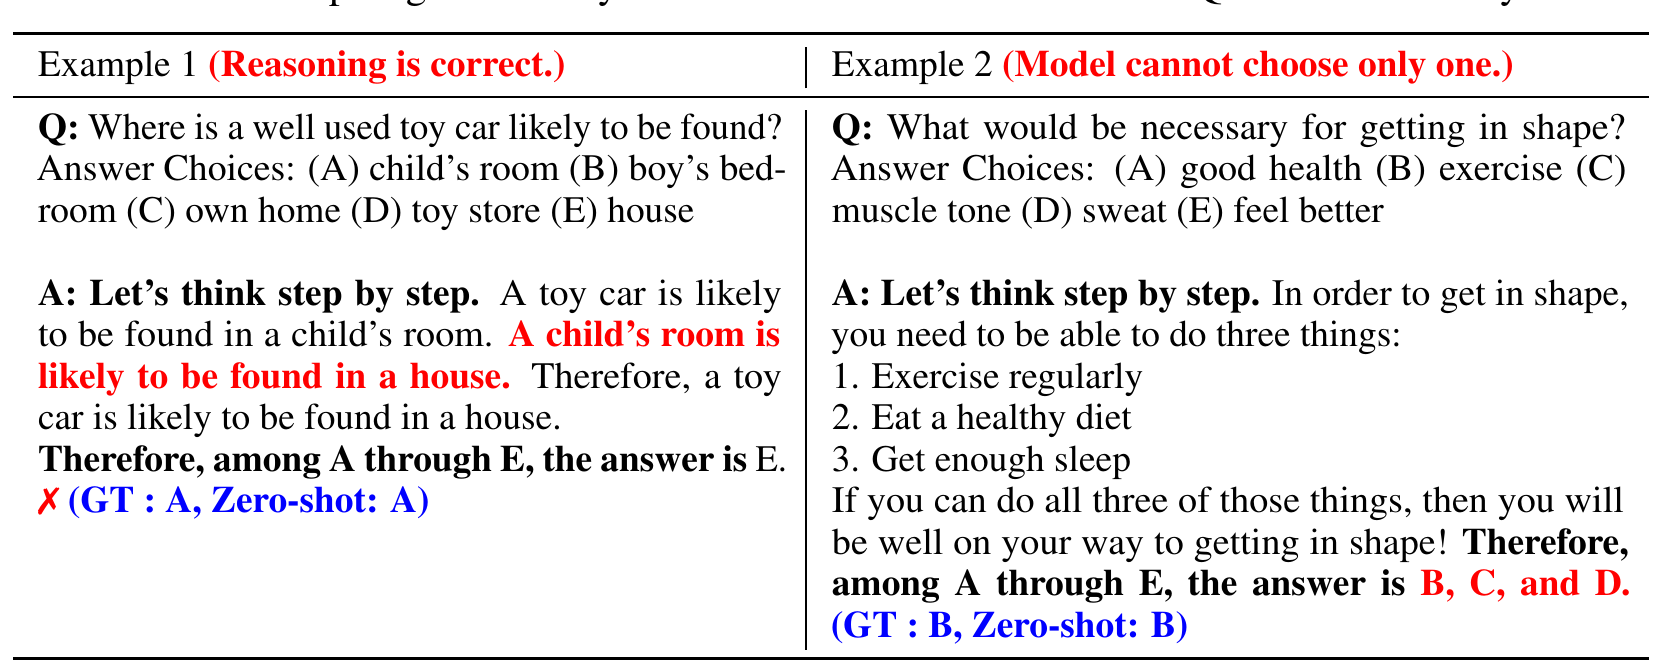
Les auteurs ont examiné à la main les sorties de text-davinci-002 :
- Sens commun : le raisonnement tient souvent la route, mais la réponse diffère de la référence ; dans le premier exemple, « la petite voiture est dans la maison » n'a rien de faux. Quand le modèle n'arrive pas à trancher entre plusieurs options, il lui arrive aussi d'en choisir plusieurs à la fois.
- Arithmétique : la chaîne de pensée zero-shot a souvent déjà trouvé la bonne réponse, puis continue à écrire quelques étapes de trop et la rend fausse ; parfois, elle ne commence même pas à raisonner et se contente de reformuler la question. La chaîne de pensée few-shot se trompe autrement ; elle bute souvent sur des expressions qui enchaînent deux opérations d'un coup, comme (3 + 2) * 4.
Limites
Les auteurs en mentionnent deux :
- Données d'entraînement opaques : ni ce qui distingue les versions 001 et 002 de la série GPT-3, ni les données utilisées pour PaLM n'ont été rendus publics. L'argument des auteurs est que les progrès sont constants sur tous les modèles et sur les tâches arithmétiques comme non arithmétiques, ce qui ressemble moins à des réponses apprises par cœur qu'à une capacité générale de raisonnement.
- Biais : le prompt exploite des schémas que le modèle a appris sur des données du web, et fait donc ressortir aussi les biais de ces données.
Par ailleurs, la plupart des résultats portent sur text-davinci-002, avec le seul décodage glouton ; les résultats clés ont été reproduits sur PaLM.
La suite
« Let's think step by step » est vite devenu le prompt zero-shot le plus répandu, et la question laissée ouverte par les auteurs n'a pas tardé à trouver preneur.
En novembre 2022, APE, de l'Université de Toronto, fait proposer des instructions candidates par un modèle de langage, puis les note. Les auteurs génèrent d'abord une série de raisonnements avec « Let's think step by step », jettent ceux qui aboutissent à une mauvaise réponse (une étape inspirée de STaR), puis cherchent la phrase d'ouverture la plus à même de produire ces raisonnements corrects ; ils trouvent « Let's work this out in a step by step way to be sure we have the right answer. ». Sur text-davinci-002, MultiArith passe de 78.7 % à 82.0 %, et GSM8K de 40.7 % à 43.0 %.
En septembre 2023, OPRO, de Google DeepMind, se sert d'un modèle de langage comme optimiseur, qui propose de nouvelles phrases, regarde leur score et les réécrit, encore et encore. Quand c'est PaLM 2-L qui répond, la meilleure phrase est « Take a deep breath and work on this problem step-by-step. », avec 80.2 % sur GSM8K ; « Let's think step by step » obtient 71.8 %, et la phrase trouvée par APE seulement 58.8 %. La meilleure phrase change avec le modèle ; celle qu'on avait trouvée pour text-davinci-002 se retrouve loin derrière une fois passée sur PaLM 2-L.
Avec les modèles de raisonnement, la boucle est bouclée. Ces modèles écrivent de toute façon un long raisonnement avant de répondre, et le guide de prompting d'OpenAI pour ses modèles de raisonnement dit explicitement d'éviter les prompts par chaîne de pensée ; comme ces modèles raisonnent en interne, leur demander de « think step by step » ou d'« explain your reasoning » est superflu.
Conclusion
Une phrase, « Let's think step by step », ajoutée devant la réponse, et text-davinci-002 passe de 17.7 % à 78.7 % sur MultiArith et de 10.4 % à 40.7 % sur GSM8K, au-dessus même du prompting few-shot standard à 8 exemples. C'est là que l'article pèse le plus ; la capacité de raisonnement était déjà dans le modèle, et les exemples few-shot apportaient pour une bonne part un simple format.
Mais la méthode est capricieuse. Il faut un modèle assez grand, elle n'aide pas sur le sens commun, quelques mots de différence dans le déclencheur font varier le score de 20 points, et la meilleure phrase change d'un modèle à l'autre.
La suite ne manque pas d'ironie. On a passé plus d'un an à chercher, par algorithme, une meilleure formulation de cette phrase ; puis les modèles de raisonnement ont intégré « réfléchir avant de répondre » directement dans leurs poids, et les guides de prompting vous demandent désormais de ne plus le leur rappeler.