Article original
Unifying Short and Long-Term Tracking with Graph Hierarchies
- Publication
- CVPR 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2212.03038
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingsushi2022,
  title = {{Unifying Short and Long-Term Tracking with Graph Hierarchies}},
  author = {Orcun Cetintas and Guillem Brasó and Laura Leal-Taixé},
  year = {2022},
  eprint = {2212.03038},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2212.03038}
}
Suivre une longue vidéo, c'est en réalité résoudre toute une série de problèmes à des échelles de temps différentes.
D'une image à la suivante, les gens n'ont presque pas bougé, et la position suffit pour apparier. Si quelqu'un reste caché une demi-seconde puis réapparaît, il faut un modèle de mouvement pour extrapoler un peu. S'il reste caché une bonne dizaine de secondes avant de ressortir, sa position ne correspond plus à rien depuis longtemps, et seule l'apparence permet de le reconnaître.
Les meilleurs traqueurs de l'époque enchaînaient le plus souvent plusieurs méthodes, avec un filtre de Kalman ou Tracktor pour le court terme et un module ReID accroché par-dessus pour le long terme. Les méthodes à réseaux de neurones sur graphes n'y échappaient pas ; MPNTrack ne traite que 15 images à la fois, et ses détections publiques doivent d'abord passer par Tracktor.
Guillem Brasó et Laura Leal-Taixé, de l'Université technique de Munich, sont justement les auteurs de MPNTrack. Cette fois, avec Orcun Cetintas, ils se demandent si un seul et même modèle peut tout traiter, des images voisines jusqu'à des écarts de cinq cents images.
Définir le problème
Les auteurs comparent, en quatre schémas, les traqueurs courants de l'époque.
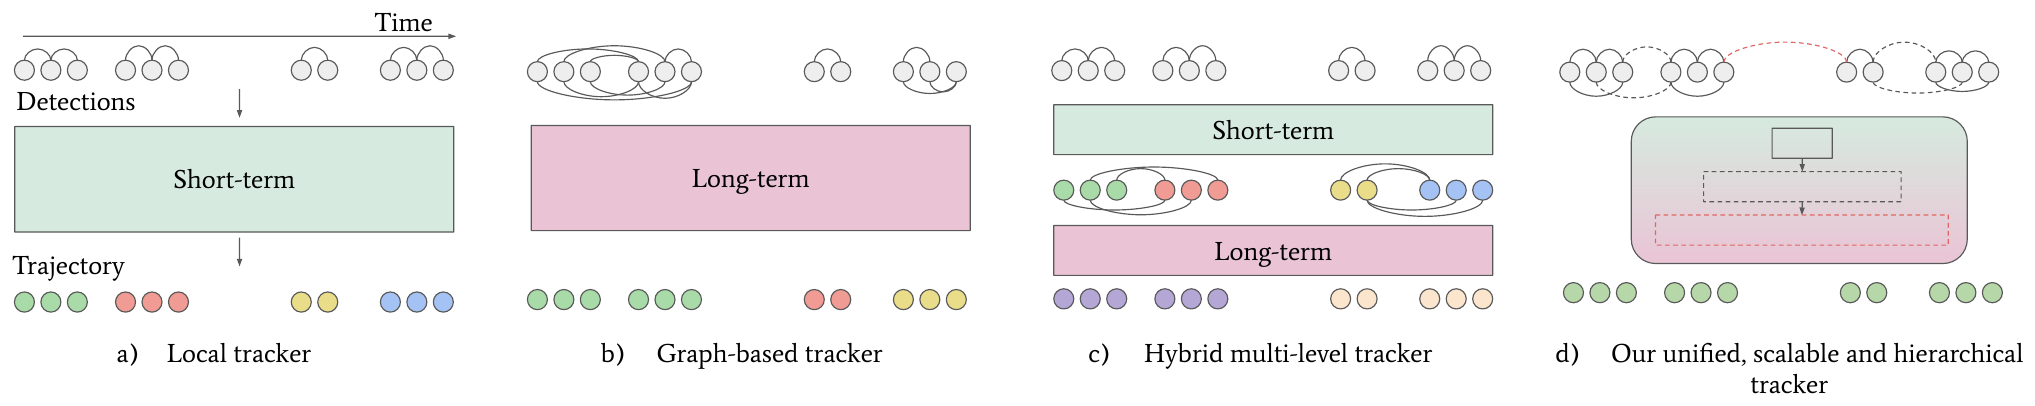
Pour les auteurs, l'approche hybride de (c) pose deux problèmes.
Le premier est l'échelle. Quand on traite l'association par graphe, une arête est l'hypothèse « ces deux détections sont la même personne ». Pour pouvoir relier des détections séparées de images, il faut tirer des arêtes entre toutes les images, et le nombre d'arêtes croît comme le carré du nombre de détections.
Les étiquettes posent un problème encore plus gênant. Chaque détection a au plus deux arêtes correctes, l'une vers le passé, l'autre vers le futur. Avec détections, il y a au plus arêtes correctes, mais le total peut atteindre . Dès que les détections se multiplient, la proportion d'arêtes correctes tend vers zéro, et le réseau ne voit presque que des exemples négatifs.
Le second est la généralité. Quel indice utiliser à quelle échelle de temps, c'est l'ingénieur qui le décide d'avance. Or chaque jeu de données demande des indices différents. Dans DanceTrack, tout le monde est habillé pareil et la fréquence d'images est élevée ; position et mouvement y sont plus fiables que l'apparence. BDD est filmé depuis un véhicule, la caméra bouge beaucoup, et c'est au contraire l'apparence seule qui tient. À chaque nouveau type de scène, il faut réajuster la combinaison.
Résoudre le problème
Empiler les étages un à un
SUSHI découpe récursivement un long extrait en petites fenêtres temporelles, et chaque niveau ne tire des arêtes qu'à l'intérieur de ses fenêtres.
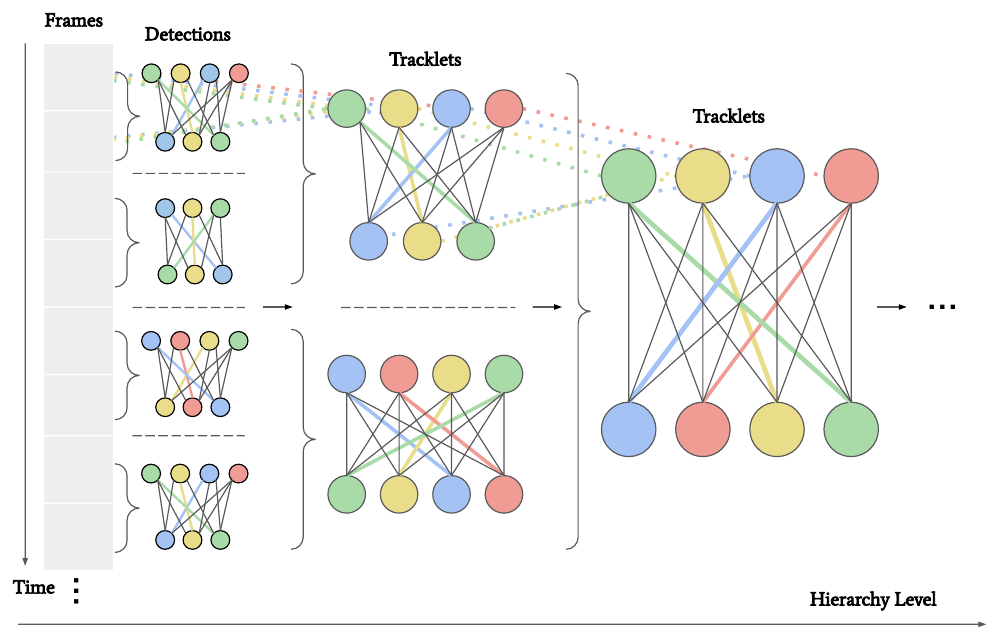
Au premier niveau, chaque fenêtre ne compte que deux images ; on relie les détections de deux images voisines, et on obtient des tracklets de longueur 2. Au deuxième niveau, les fenêtres font quatre images, les nœuds sont les tracklets du niveau précédent, qu'on fusionne en tracklets plus longs. La fenêtre du niveau couvre images ; au bout de neuf niveaux, une fenêtre fait 512 images. Sur MOT17, cela représente environ 17 à 36 secondes.
À chaque niveau, il y a un peu moins de nœuds, mais les arêtes enjambent des durées plus longues.
Compter les arêtes sur un exemple
Un exemple idéalisé montre combien d'arêtes la hiérarchie économise.
Un extrait de 512 images, avec 20 personnes dans chaque image ; chacune est toujours détectée, et chaque niveau fusionne correctement. On ne fait aucun élagage.
- Un seul grand graphe. Entre deux images, il y a arêtes. Il existe 130 816 façons de choisir deux images parmi 512, soit 52 326 400 arêtes au total.
- Une hiérarchie à neuf niveaux. Chaque fenêtre se compose de deux sous-fenêtres de 20 tracklets chacune, avec seulement 400 arêtes candidates entre les deux. Le nombre de fenêtres sur neuf niveaux est , soit 204 400 arêtes au total.
Dans les deux cas, le nombre d'arêtes correctes à retenir est le même, : chaque personne compte 512 détections, et il faut 511 arêtes pour les enchaîner en un chemin.
| Approche | Arêtes | Part correcte |
|---|---|---|
| Grand graphe unique | 52 326 400 | 0.02 % |
| Neuf niveaux | 204 400 | 5 % |
Exemple de calcul établi pour cette note.
Il y a 256 fois moins d'arêtes, et la part d'arêtes correctes passe de deux pour dix mille à 5 %. Le premier chiffre décide si le graphe tient dans le GPU, le second si le réseau parvient à apprendre.
Le vrai modèle élague encore une fois les arêtes, et chaque nœud n'est relié qu'à ses 10 plus proches voisins. Un grand graphe unique a besoin d'un très grand nombre de voisins pour ne pas élaguer d'arêtes correctes ; dans un petit graphe, 10 suffisent.
Chaque niveau est le même bloc
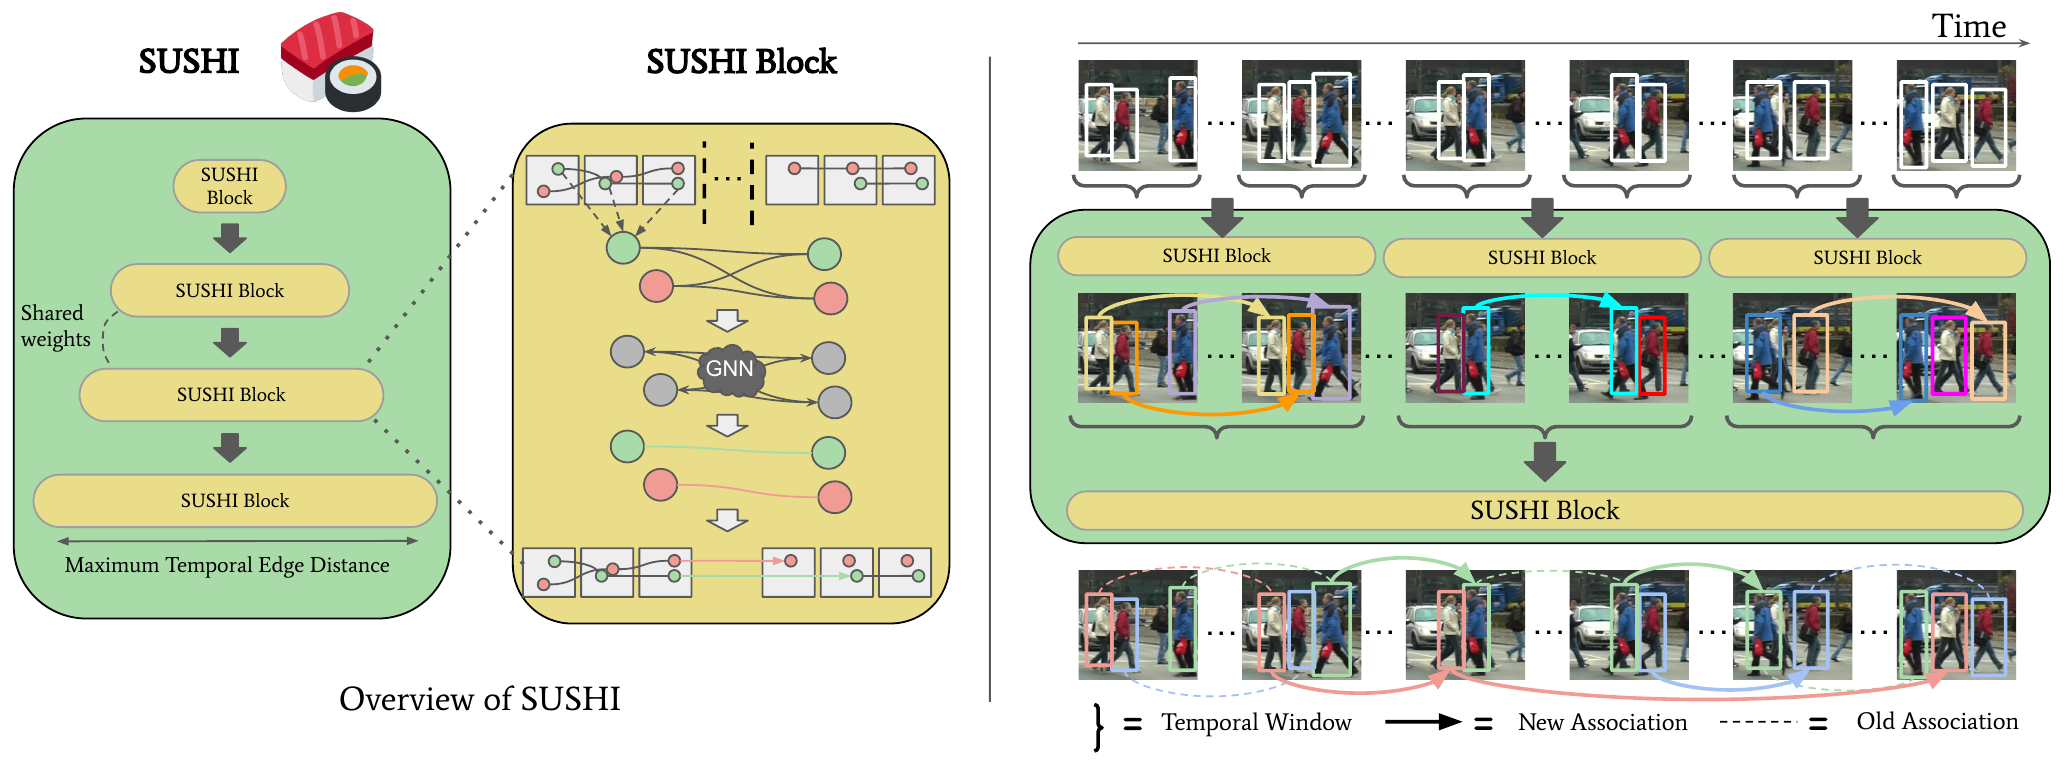
Chaque niveau s'appelle un SUSHI block, et fait la même chose que MPNTrack :
- Les tracklets du niveau précédent servent de nœuds, et l'on relie les tracklets de la fenêtre qui appartiennent à des instants différents.
- Le passage de messages sensible au temps de MPNTrack fait échanger des informations entre nœuds et arêtes pendant quelques tours. Chaque nœud agrège séparément les arêtes venues du passé et celles venues du futur.
- Un petit MLP décide pour chaque arête s'il s'agit de la même personne.
- Un programme linéaire arrondit les scores, en garantissant que chaque nœud a au plus une arête vers l'avant et une vers l'arrière, puis les tracklets reliés sont fusionnés.
Les caractéristiques initiales des arêtes sont de quatre sortes. Position, taille et distance temporelle se calculent sur les deux détections les plus proches dans le temps des deux tracklets. L'apparence est la moyenne des caractéristiques ReID de toutes les détections du tracklet, plus stable que celle d'une détection isolée.
La quatrième est le mouvement, absent de MPNTrack. Une détection isolée n'a pas de vitesse, un tracklet en a une. On extrapole la dernière position du premier tracklet vers l'avant et la première position du second vers l'arrière, jusqu'à l'instant situé entre les deux, puis on calcule le GIoU des deux boîtes extrapolées. Comme on extrapole des deux bouts vers le milieu, chaque côté n'a à prédire que sur la moitié de l'intervalle.
Neuf niveaux, un seul jeu de poids
Le choix de conception décisif de cet article, c'est que les neuf SUSHI blocks ne partagent pas seulement leur architecture, mais aussi leurs poids.
Les données vues par les différents niveaux sont très différentes. Au premier niveau, deux nœuds ne sont séparés que d'une image ; au neuvième, ils peuvent l'être de plusieurs centaines. Pour que le modèle sache à quel niveau il se trouve, les auteurs apprennent un level embedding par niveau, ajouté à l'embedding initial des arêtes.
Grâce au partage des poids, les données des neuf niveaux servent toutes à entraîner le même réseau, avec plusieurs fois plus d'exemples ; la convergence est plus rapide, et il y a moins de paramètres. Sans compter le réseau ReID, le modèle entier n'a qu'environ 22K paramètres.
Surtout, le choix de l'indice à regarder pour chaque échelle de temps n'est plus fait par un humain. Le même réseau, face à des arêtes où les positions diffèrent beaucoup et où l'écart temporel est grand, apprend de lui-même à regarder plutôt l'apparence.
À l'entraînement, l'entrée des niveaux supérieurs est la sortie des niveaux inférieurs. Tant que les niveaux inférieurs n'ont pas bien appris, les niveaux supérieurs reçoivent des tracklets erronés. Les auteurs commencent donc par le premier niveau et en dégèlent un nouveau toutes les 500 itérations ; une fois les neuf niveaux dégelés, ils entraînent l'ensemble. Chaque niveau a sa propre focal loss, et les pertes sont additionnées.
À l'inférence, on utilise une fenêtre glissante de 512 images, avec un recouvrement de 256 images à chaque pas ; les trajectoires qui partagent le plus de détections dans la zone de recouvrement sont considérées comme la même, et raccordées par appariement biparti. Les détections étant fournies, le tout tourne à 21 fps sur MOT17.
Discussion
Un même réseau à chaque niveau
Les ablations se font en validation croisée à trois plis sur l'ensemble d'entraînement de MOT17. Les auteurs comparent quatre portées temporelles, surtout en IDF1 :
| Portée | Hybride | IDF1 | SUSHI | IDF1 |
|---|---|---|---|---|
| 25 images | Tracktor | 65.6 | — | — |
| 75 images | MPNTrack++ | 73.2 | 2 niveaux | 73.5 |
| 150 images | MPNTrack++ | 73.4 | 3 niveaux | 74.8 |
| 512 images | MPNTrack++ | 73.7 | 9 niveaux | 77.6 |
D'après la Table 1 de l'article, ensemble d'entraînement de MOT17 en validation croisée à trois plis.
MPNTrack++ est MPNTrack doté des caractéristiques de mouvement de SUSHI, le court terme étant toujours confié à Tracktor. En passant de 75 à 512 images, l'approche hybride ne gagne que 0.5 d'IDF1 ; SUSHI, lui, monte sans interruption de 73.5 à 77.6.
Dans l'approche hybride, l'étape à long terme reste toujours un seul graphe. Plus la durée s'allonge, plus le graphe grossit, et plus le déséquilibre des étiquettes évoqué plus haut s'aggrave.
Longueur d'extrait et nombre de niveaux
| Longueur | 1 niv. | 3 niv. | 5 niv. | 7 niv. | 9 niv. |
|---|---|---|---|---|---|
| 8 images | 64.1 | 65.9 | — | — | — |
| 32 images | 64.2 | 70.0 | 71.3 | — | — |
| 128 images | 61.9 | 75.1 | 75.6 | 75.8 | — |
| 512 images | — | 76.2 | 76.8 | 77.1 | 77.6 |
D'après la Figure 4(b) de l'article, ensemble d'entraînement de MOT17, IDF1.
Avec un seul niveau, un extrait de plus de 32 images fait même reculer le résultat, qui tombe à 61.9 à 128 images. Le graphe est trop grand, les exemples négatifs trop nombreux, et le réseau n'arrive plus à apprendre. Dès qu'on ajoute des niveaux, plus l'extrait est long, mieux c'est. Neuf niveaux sur 512 images donnent 77.6, 13.4 de plus que le meilleur résultat à un seul niveau, 64.2.
Ce que regarde chaque niveau
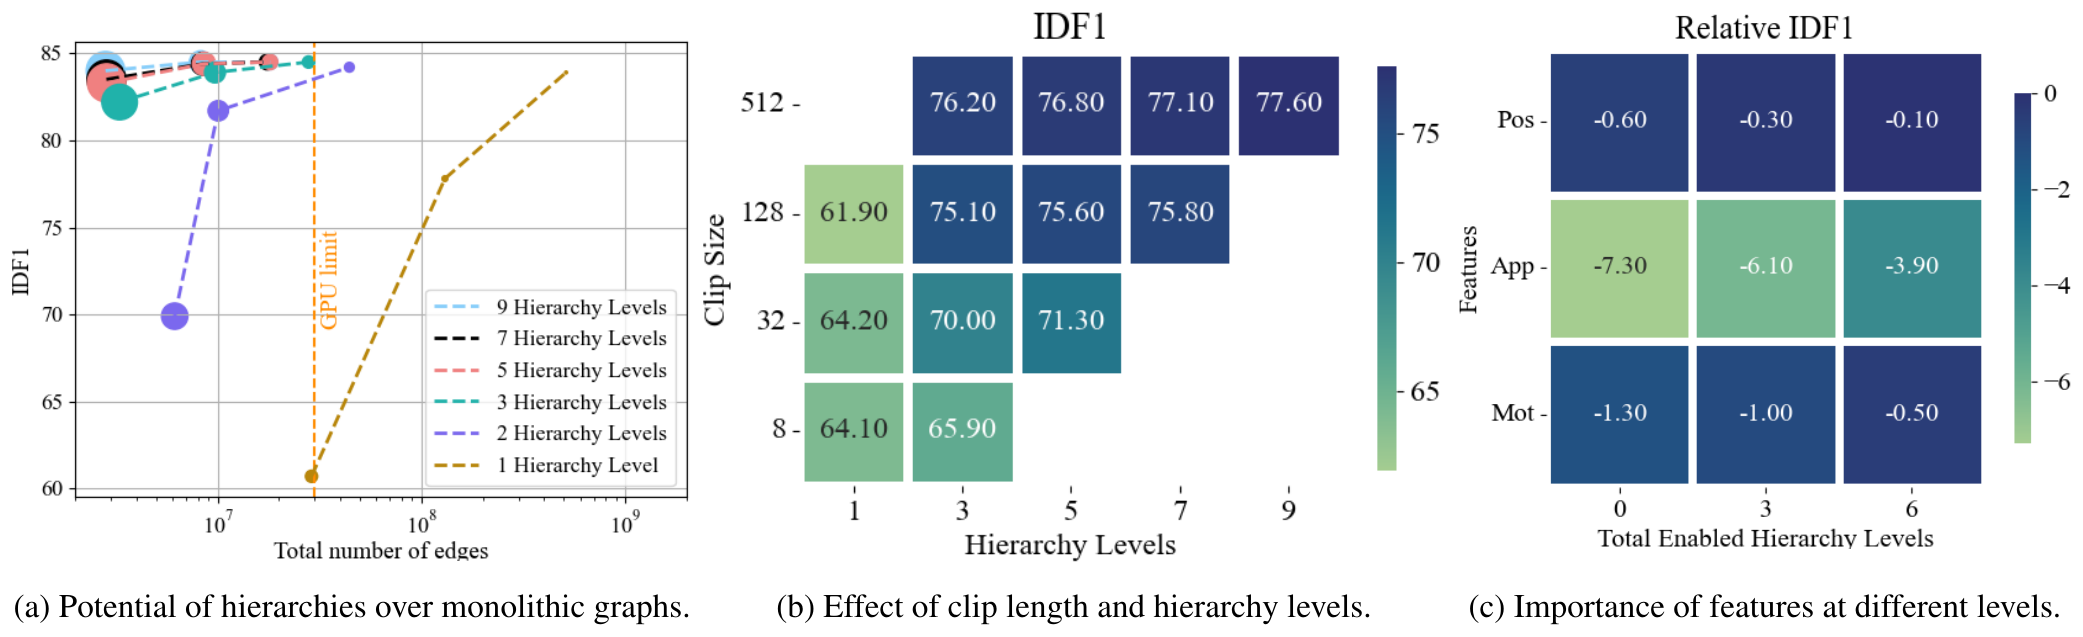
(c) vérifie si un même réseau s'appuie sur des indices différents selon le niveau.
- L'apparence compte le plus, et surtout aux niveaux supérieurs. La désactiver partout coûte 7.3 points d'IDF1. La couper seulement aux niveaux 7 à 9 coûte déjà 3.9 ; la garder seulement aux niveaux 1 à 3 ne regagne que 1.2 par rapport à la coupure totale.
- Le mouvement pèse à peu près autant à tous les niveaux. Le désactiver partout coûte 1.3, un effet modéré.
- La position ne sert qu'aux niveaux inférieurs. La désactiver partout ne coûte que 0.6, et la garder aux trois premiers niveaux en récupère la moitié.
Entre images voisines, on regarde la position ; quand l'écart grandit, on regarde l'apparence, ce qui est conforme à l'intuition. La différence, c'est que le réseau l'a appris lui-même à partir des données, sans que personne ne lui écrive de règle.
Quatre jeux de données
| Jeu | Rival | IDF1 | HOTA | SUSHI IDF1 | HOTA |
|---|---|---|---|---|---|
| MOT17 public | MPNTrack | 61.7 | 49.0 | 71.5 | 54.6 |
| MOT17 privé | ByteTrack | 77.3 | 63.1 | 83.1 | 66.5 |
| MOT20 privé | ByteTrack | 75.2 | 61.3 | 79.8 | 64.3 |
| DanceTrack | ByteTrack | 53.9 | 47.7 | 63.4 | 63.3 |
D'après les Tables 2 à 4 de l'article, ensembles de test.
Avec les détections publiques de MOT17, SUSHI utilise exactement le réseau de MPNTrack, et pourtant son IDF1 est supérieur de 9.8 ; seule la hiérarchie fait la différence. Avec les détections YOLOX de ByteTrack, l'IDF1 gagne 5.8, et les changements d'identité passent de 2 196 à 1 149, presque moitié moins.
Le progrès le plus net est sur DanceTrack, où le HOTA saute des 47.7 de ByteTrack à 63.3, au-dessus aussi de MOTR et de QDTrack, les meilleurs HOTA du tableau de l'article (54.2 tous les deux). ByteTrack est très fort sur MOT17 et MOT20, mais décroche sur DanceTrack ; SUSHI est en tête sur les trois jeux de données. Sur BDD, filmé depuis un véhicule, SUSHI applique directement le même GNN à huit catégories, et le mIDF1 de test passe de 55.8 à 60.0.
Pour le MOTA, c'est une autre histoire. Sur MOT20, SUSHI obtient un MOTA de 74.3, sous les 77.8 de ByteTrack. SUSHI améliore l'association ; les détections manquées et les faux positifs ne relèvent pas de lui.
Limites
SUSHI est une méthode hors ligne, qui a besoin de tout un extrait de 512 images avant de commencer, ce qui l'exclut des systèmes qui doivent produire leur sortie en temps réel. Les 21 fps s'entendent aussi une fois les détections déjà calculées.
Le réseau ReID est pris tel quel, sans réglage fin sur des données de suivi ; tous les gains de SUSHI viennent du côté de l'association. Avec les détections publiques, il affine d'abord les boîtes de détection avec Tracktor, comme les autres méthodes par graphe, et cette étape est en soi un traqueur à court terme.
Conclusion
SUSHI n'invente pas de nouveau réseau de graphes ; chaque niveau est MPNTrack. Il remplace un graphe à la fois immense et creux par neuf petits graphes empilés. Les arêtes diminuent de deux ordres de grandeur, la part d'arêtes correctes remonte de deux pour dix mille à 5 %, et le réseau arrive enfin à apprendre.
Le partage des poids rend aux données la question « quel indice pour quelle échelle de temps ». Le même réseau regarde la position aux niveaux bas et l'apparence aux niveaux hauts, sans que personne ne le lui impose.
Neuf niveaux, 512 images, soit environ une demi-minute sur MOT17. Pour une occultation plus longue que ça, tout dépendra des coutures entre fenêtres glissantes.