Article original
Learning a Neural Solver for Multiple Object Tracking
- Publication
- CVPR 2020Conférence
- Premier dépôt sur arXiv
- arXiv:1912.07515
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingmpntrack2019,
  title = {{Learning a Neural Solver for Multiple Object Tracking}},
  author = {Guillem Brasó and Laura Leal-Taixé},
  year = {2019},
  eprint = {1912.07515},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1912.07515}
}
Le suivi hors ligne repose sur une vieille idée très élégante, qui consiste à représenter toutes les détections d'une vidéo sous la forme d'un graphe.
Chaque détection est un nœud, et une arête relie deux détections d'images différentes. Si deux détections appartiennent à la même trajectoire et se suivent dans le temps, l'arête est « active ». Le suivi devient alors un problème de partitionnement de graphe, qui consiste à trouver quelles arêtes activer.
L'approche standard de ce cadre se fait en deux temps. On attribue d'abord à chaque arête un coût, qui exprime la probabilité que les deux détections correspondent à la même personne ; on confie ensuite ces coûts à un solveur d'optimisation, qui trouve le meilleur partitionnement global.
En 2019, les recherches dans cette direction se partagent grosso modo en deux écoles. La première soigne la formulation du graphe, avec des optimisations de plus en plus complexes qui intègrent des relations d'ordre supérieur, mais des coûts le plus souvent conçus à la main. La seconde apprend de meilleurs coûts d'arête avec des modèles profonds, des réseaux siamois par exemple, puis les confie à un solveur simple ; mais ces coûts ne regardent que des paires, sans voir l'ensemble de la scène.
Guillem Brasó et Laura Leal-Taixé, de l'université technique de Munich, trouvent que chacune des deux voies ne fait que la moitié du chemin. Leal-Taixé compte parmi les auteurs de MOT16 et de Tracktor. Cette fois, tous deux veulent voir si le réseau peut apprendre même l'étape de « résolution ».
Définir le problème
Écrire le suivi comme un flot dans un réseau
Les auteurs partent du flot de coût minimal (min-cost flow) classique, en le simplifiant un peu.
On dispose de toutes les détections d'une vidéo, , où chaque détection contient l'image dans la boîte, les coordonnées de la boîte et l'horodatage. On construit un graphe non orienté où chaque détection est un nœud, et une arête relie toute paire de détections prises dans des images différentes. Autoriser les liaisons qui sautent des images permet de raccorder une trajectoire malgré une détection manquée au milieu.
Chaque arête porte une variable binaire . Si les deux nœuds appartiennent à la même trajectoire et sont deux détections voisines de cette trajectoire, ; sinon, elle vaut 0.
Les trajectoires ne peuvent pas partager de nœud ; doit donc satisfaire deux conditions. Chaque nœud a au plus une arête active vers le passé :
Et au plus une vers le futur :
C'est une version simplifiée des contraintes de conservation du flot.
L'approche traditionnelle attribue à chaque arête un coût et résout
Sous les deux familles de contraintes ci-dessus, ce problème admet une solution optimale calculable en temps polynomial.
Prédire directement la réponse
Puisque ce qu'on veut au bout du compte, c'est , les auteurs renoncent à apprendre les coûts et apprennent directement .
Chaque arête devient un problème de classification binaire, dont l'étiquette est . Tout le problème de suivi devient ainsi une tâche entraînable de bout en bout, où les caractéristiques et la « résolution » s'apprennent dans le même réseau.
Reste un problème. Un classifieur qui ne regarde que deux nœuds ne peut pas apprendre une information globale comme « cette personne a déjà été reliée à quelqu'un d'autre ». Pour que la décision sur chaque arête tienne compte de tout le graphe, les auteurs utilisent un réseau de passage de messages (Message Passing Network, MPN).
Résoudre le problème
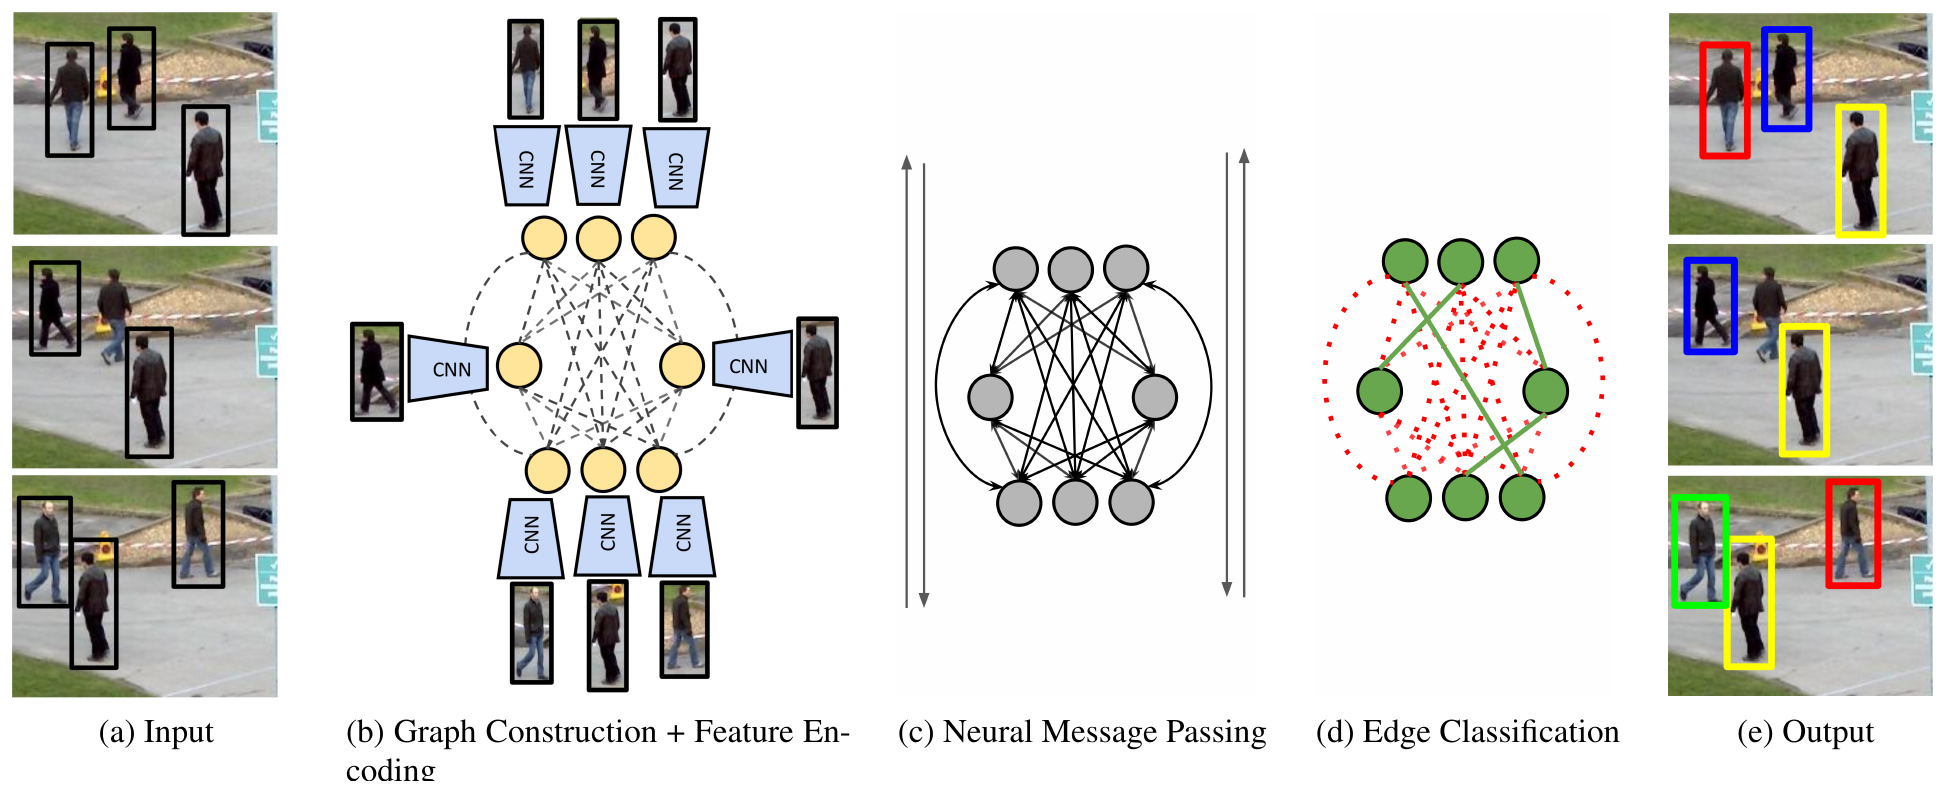
Le processus se divise en quatre étapes : construction du graphe, encodage des caractéristiques, passage de messages et classification des arêtes.
Caractéristiques initiales
L'embedding initial des nœuds vient de l'apparence. Les auteurs entraînent un ResNet-50 préentraîné sur ImageNet sur trois jeux de ré-identification de piétons, Market-1501, CUHK03 et DukeMTMC, ce qui donne des caractéristiques de re-ID de 256 dimensions ; trois couches entièrement connectées ajoutées ensuite compriment l'embedding des nœuds à 32 dimensions.
L'embedding initial des arêtes vient des relations géométriques. Pour deux boîtes de détection d'images différentes, et , on calcule d'abord la position et la taille relatives :
Le déplacement est divisé par la hauteur moyenne des deux boîtes, si bien que des personnes plus ou moins éloignées se comparent à la même échelle. On y ajoute l'écart temporel et la distance euclidienne entre les deux caractéristiques de re-ID, et le tout passe dans un MLP qui donne l'embedding initial de l'arête.
Passage de messages
Dans un réseau de passage de messages ordinaire, chaque étape comprend deux mises à jour. On met d'abord à jour chaque arête avec ses deux nœuds :
On met ensuite à jour chaque nœud avec les arêtes qui le touchent. Chaque arête produit un message, et la somme de tous les messages (ou leur moyenne, ou leur maximum) donne le nouvel embedding du nœud.
Après répétitions, chaque nœud et chaque arête portent l'information située à une distance d'au plus , un peu comme le champ récepteur d'un CNN. La classification d'une arête, qui ne regardait que deux boîtes, peut désormais voir « quelles autres candidates entourent ces deux nœuds ».
Une mise à jour des nœuds sensible au temps
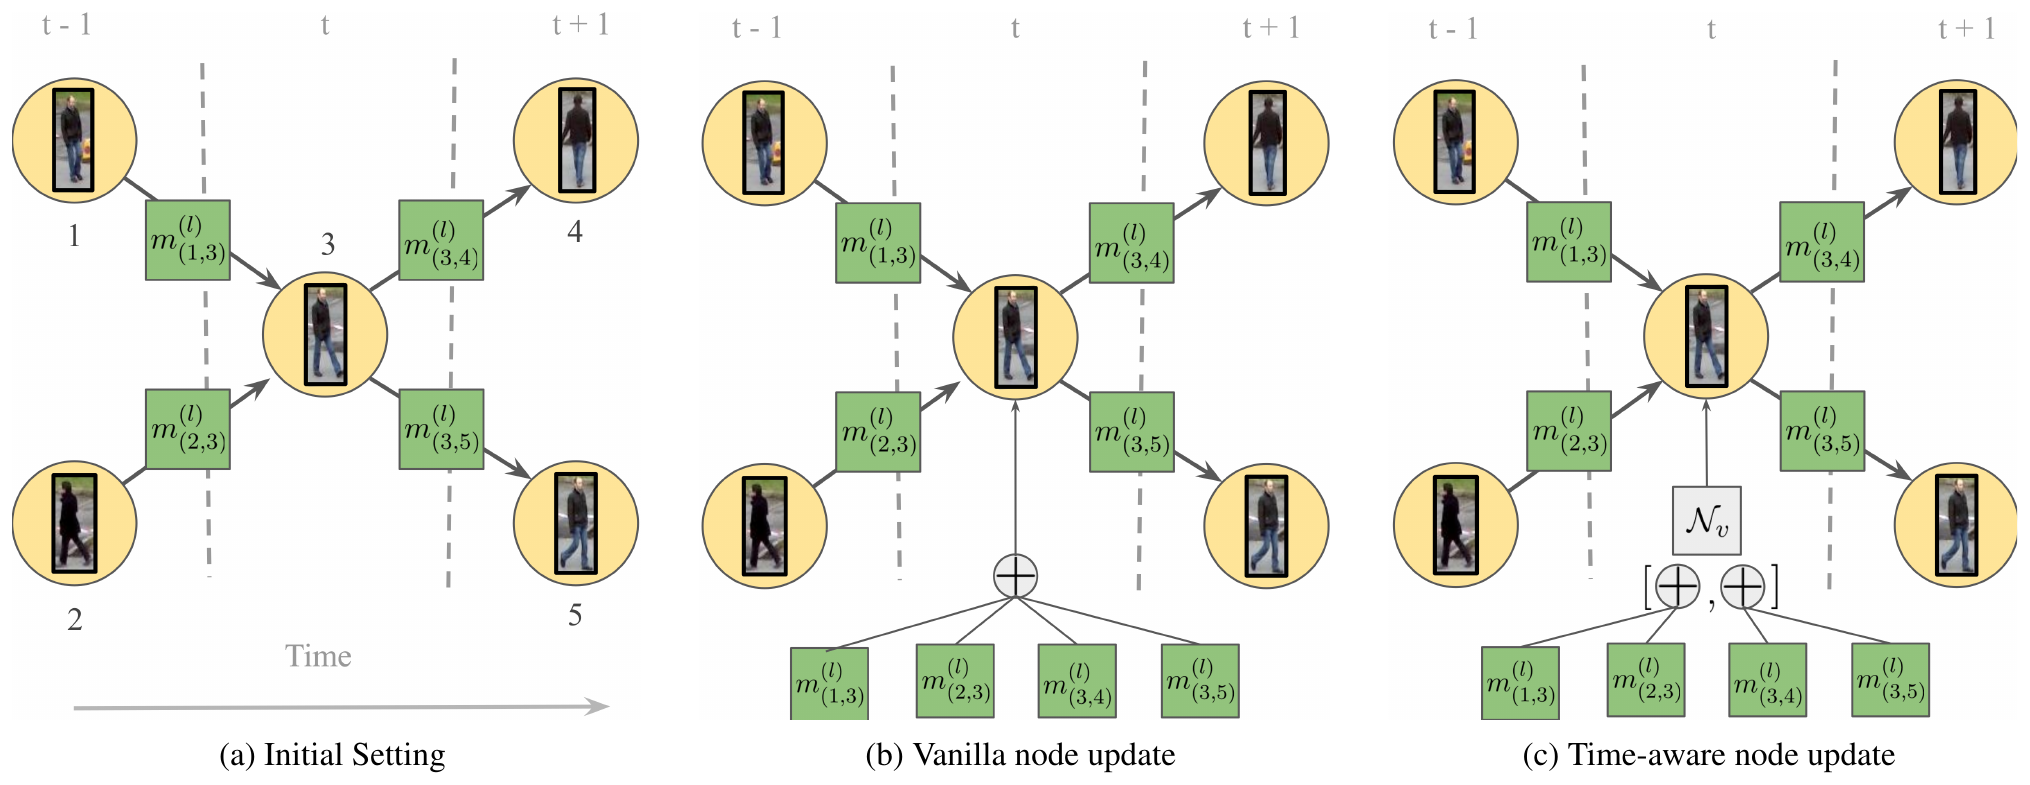
La principale modification d'architecture de l'article porte sur la mise à jour des nœuds.
Revenons aux contraintes du flot, selon lesquelles chaque nœud a au plus une liaison vers le passé et au plus une vers le futur. Mais la mise à jour ordinaire mélange et additionne les messages de tous les voisins ; une fois la somme faite, le nœud ne peut plus distinguer les messages venus du passé de ceux venus du futur, et il lui devient difficile de savoir si les contraintes sont violées.
Les auteurs inscrivent directement la structure temporelle du graphe de MOT dans la règle de mise à jour. Pour le nœud , les messages des voisins passés et futurs sont calculés par deux MLP différents. Les voisins passés utilisent
Les voisins futurs utilisent . Les deux côtés sont additionnés séparément pour donner et , qui sont concaténés puis envoyés dans un dernier MLP :
Dans la formule, est l'embedding initial, transmis à chaque étape pour que le réseau n'oublie pas les caractéristiques d'origine, même après de nombreuses propagations. La mise à jour des arêtes reçoit de même les caractéristiques initiales des arêtes.
Entraînement et inférence
Le classifieur d'arêtes est un MLP qui produit une seule valeur sigmoïde. De l'étape à la dernière étape , les embeddings d'arêtes de chaque étape servent à prédire, et l'on calcule sur l'ensemble une entropie croisée binaire pondérée :
La perte de chaque arête à l'étape s'écrit
Les arêtes actives sont bien moins nombreuses que les inactives ; les exemples positifs sont donc multipliés par un poids .
À l'inférence, les prédictions de la dernière étape servent directement de réponse pour , binarisées avec un seuil de 0.5. Rien n'oblige le réseau à respecter les contraintes du flot ; après seuillage, un nœud peut donc se retrouver avec deux arêtes sortantes. Les auteurs prévoient deux corrections : soit garder de façon gloutonne l'arête au score le plus élevé, soit calculer l'arrondi optimal exact par programmation linéaire. En pratique, les arêtes qui violent les contraintes sont rares, les deux méthodes donnent presque le même résultat, et la méthode gloutonne ne perd que 0.2 point d'IDF1.
Détails d'implémentation
Quelques réglages comptent beaucoup quand on fait réellement tourner la méthode :
- CNN gelé. Les auteurs constatent qu'entraîner aussi le ResNet n'améliore pas nettement les résultats, mais alourdit beaucoup le calcul ; toutes les couches de convolution sont donc gelées, et seuls les MLP en aval sont entraînés.
- Fenêtre glissante. La vidéo est découpée en graphes de 15 images, deux graphes consécutifs se chevauchant sur 14 images ; pour les arêtes du chevauchement, on fait la moyenne des prédictions des différents graphes. Les séquences à caméra fixe sont échantillonnées à 6 images par seconde, celles à caméra mobile à 9 ; chaque graphe ne couvre donc qu'environ une seconde et demie à un peu plus de deux secondes de vidéo.
- Élagage. Relier tous les nœuds d'images différentes ferait exploser le nombre d'arêtes ; deux nœuds ne sont donc reliés que si chacun figure parmi les 50 plus proches voisins de l'autre selon les caractéristiques de re-ID.
- Prétraitement par Tracktor. Les détections publiques passent d'abord par Tracktor ; on jette les ID qu'il attribue pour ne garder que les boîtes corrigées comme entrée. Les boîtes de Tracktor sont plus précises, et il rajoute aussi dans les images voisines quelques détections manquées. Pour les images manquantes au milieu des trajectoires de sortie, on comble d'abord avec les trajectoires de Tracktor, puis par interpolation pour le reste.
Ce dernier point mérite l'attention. Le réseau de MPNTrack tourne seul à 35 images par seconde, mais Tracktor, en amont, n'en traite que 8 ; le système complet tourne en moyenne à 6.5 images par seconde.
Discussion
Les ablations sont toutes faites sur le jeu d'entraînement de MOT17, en validation croisée à trois plis.
La mise à jour sensible au temps
| Mise à jour | MOTA ↑ | IDF1 ↑ | Chang. d'ID ↓ | Contraintes ↑ |
|---|---|---|---|---|
| Classique | 63.0 | 67.3 | 1 022 | 82.1 % |
| Sensible au temps | 64.0 | 70.0 | 602 | 98.8 % |
D'après la Table 1 de l'article. La colonne Contraintes donne la proportion moyenne de contraintes de conservation du flot satisfaites avec un seuil de 0.5.
Séparer passé et futur fait gagner près de 3 points d'IDF1, et les changements d'identité passent de 1 022 à 602.
La dernière colonne est plus intéressante encore. Avec un MPN classique binarisé directement, seules 82.1 % des contraintes sont satisfaites ; avec la version sensible au temps, 98.8 %. Le réseau a presque appris de lui-même la règle selon laquelle « chacun ne peut se relier qu'à une personne en avant et une en arrière », sans qu'un solveur externe ait à l'imposer.
Combien d'étapes de propagation
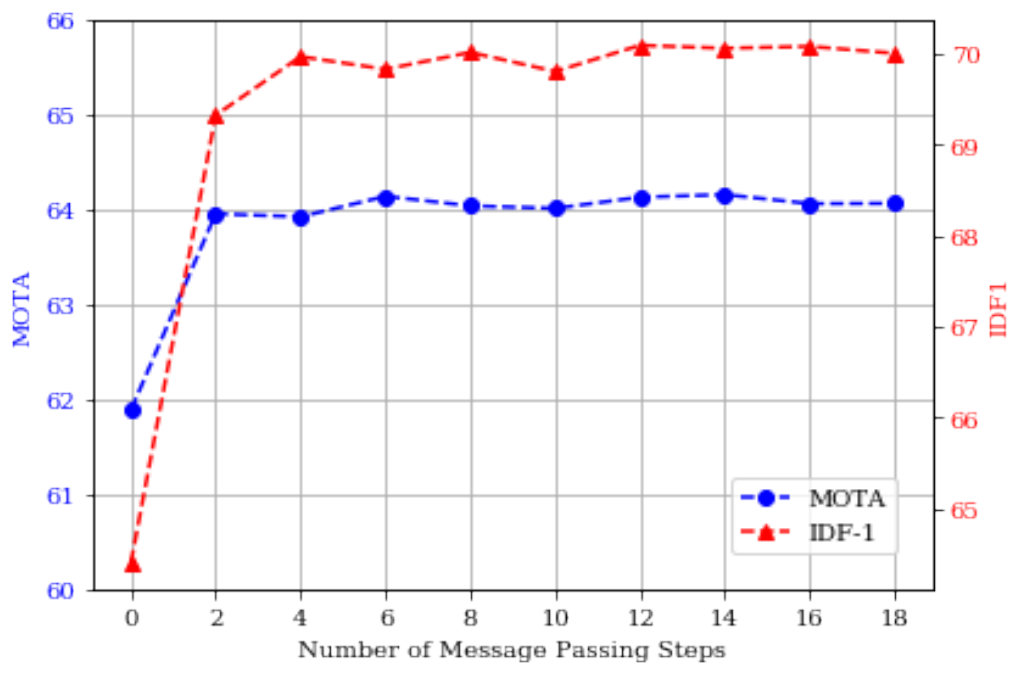
Zéro étape signifie aucun passage de messages ; on fait une classification binaire sur les seuls embeddings initiaux des arêtes, ce qui revient à l'approche traditionnelle qui « apprend des coûts par paires ».
De 0 à 2 étapes, le MOTA et l'IDF1 font un bond, celui du passage des relations par paires aux relations d'ordre supérieur. La tendance à la hausse s'arrête ensuite vers 6 étapes, et il n'y a plus d'amélioration au-delà de 12. La configuration finale utilise .
L'origine des caractéristiques
| Caract. d'arête | MOTA ↑ | IDF1 ↑ | FP ↓ | Chang. d'ID ↓ |
|---|---|---|---|---|
| Temps seul | 58.8 | 52.6 | 13 127 | 2 962 |
| Temps + position | 63.6 | 68.7 | 6 308 | 895 |
| Temps + position + apparence | 64.0 | 70.0 | 6 169 | 602 |
D'après la Table 2 de l'article.
Ce tableau a de quoi surprendre. L'ajout de la position relative fait passer l'IDF1 de 52.6 à 68.7, le plus grand saut ; ajouter ensuite les caractéristiques d'apparence ne rapporte que 1.3 point d'IDF1. Mais l'apparence fait encore tomber les changements d'identité de 895 à 602, et mérite d'être gardée.
Dans ce cadre, la position compte bien plus que l'apparence. L'article n'analyse pas la raison plus avant ; une explication possible est que les nœuds portent déjà l'embedding d'apparence, auquel les arêtes ont aussi accès pendant le passage de messages, si bien qu'une distance d'apparence placée sur les arêtes fait en partie double emploi.
Face aux autres méthodes
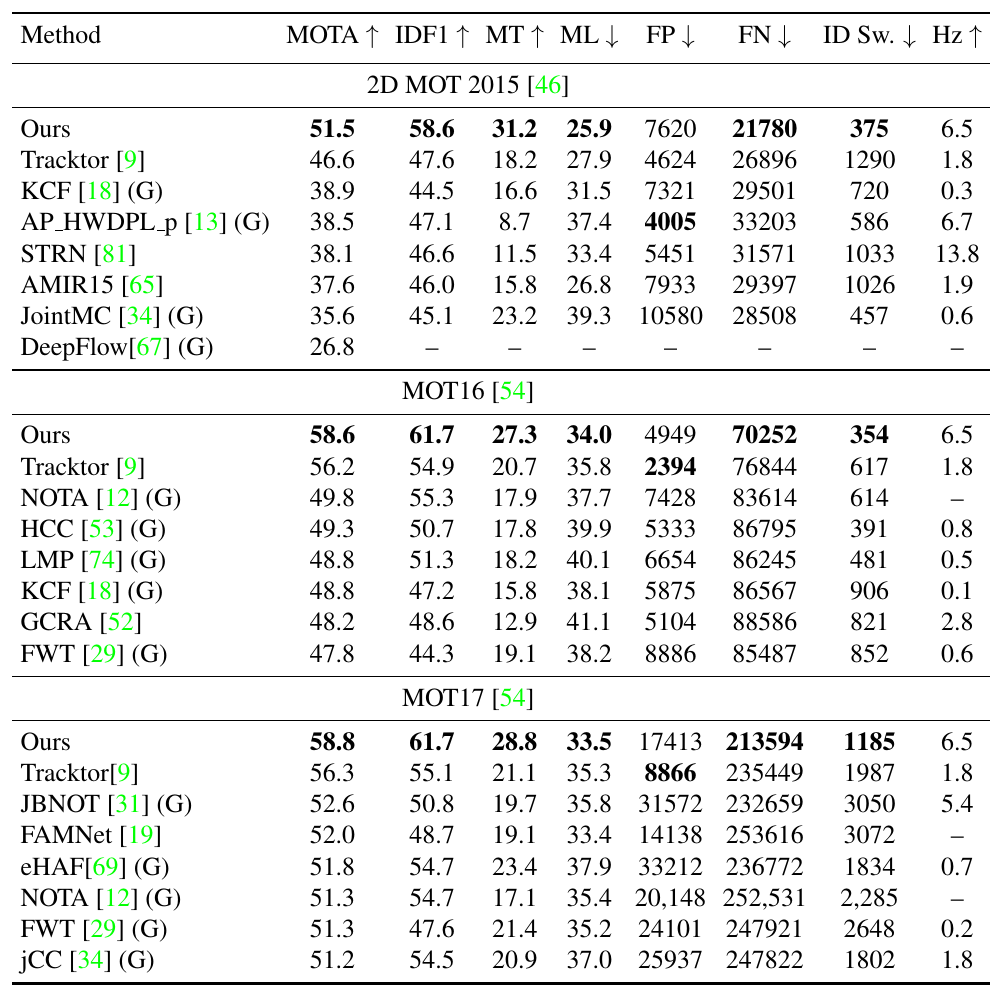
Les trois benchmarks utilisent les détections publiques. MPNTrack arrive premier sur les trois jeux de données, et dépasse le meilleur IDF1 antérieur de respectivement 11, 6.4 et 6.6 points. Face aux autres méthodes de partitionnement de graphe, il est non seulement bien plus précis, mais aussi plus rapide d'un ordre de grandeur que certaines d'entre elles ; JointMC, par exemple, ne tourne qu'à 0.6 Hz.
Le prétraitement par Tracktor aide toutefois beaucoup ici. En annexe, les auteurs rapportent aussi une version sans Tracktor, qui corrige les détections publiques avec la tête de régression d'un Faster R-CNN :
| Jeu | MOTA (avec Tracktor) | MOTA (sans) | IDF1 (avec Tracktor) | IDF1 (sans) |
|---|---|---|---|---|
| MOT15 | 51.5 | 46.6 | 58.6 | 53.8 |
| MOT16 | 58.6 | 54.3 | 61.7 | 56.8 |
| MOT17 | 58.8 | 56.0 | 61.7 | 58.4 |
D'après la Table 7 de l'annexe de l'article.
Sans Tracktor, le MOTA perd de 2.8 à 4.9 points, et l'IDF1 de 3.3 à 4.9 points. Même ainsi, la méthode bat encore les autres méthodes à base de graphe du tableau, dont plusieurs utilisent des détections brutes sans suppression des non-maxima, des caractéristiques d'image de bas niveau ou une conception hiérarchique, et disposent donc de plus d'informations qu'elle.
Limites
MPNTrack est une méthode hors ligne ; chaque graphe doit voir les images futures pour décider, et la méthode ne se transpose pas directement à un système temps réel.
La fenêtre temporelle est aussi très courte. Un graphe ne couvre qu'environ deux secondes ; une personne masquée longtemps, même si elle revient dans l'image, n'est plus dans le même graphe et ne peut pas être raccordée. Le nombre d'arêtes croît comme le carré du nombre de nœuds ; pour allonger la fenêtre, il faudrait élaguer encore plus sévèrement.
Le même laboratoire a ensuite empilé les graphes en plusieurs niveaux dans SUSHI, en 2023 ; les niveaux inférieurs traitent les liaisons à court terme, les niveaux supérieurs raccordent les courtes trajectoires en longues trajectoires, ce qui répond justement à ce problème de fenêtre trop courte.
Conclusion
Avant cet article, l'apprentissage servait surtout, en suivi multi-objets, à apprendre des caractéristiques et des coûts ; c'était encore un solveur d'optimisation traditionnel qui décidait vraiment des trajectoires. MPNTrack prend directement les variables binaires du flot comme étiquettes de classification, utilise le passage de messages pour que chaque arête voie tout le graphe, et laisse le réseau apprendre lui-même des solutions presque admissibles.
La mise à jour sensible au temps est une petite modification discrète, qui se contente d'additionner séparément passé et futur ; elle suffit pourtant à ce que le réseau apprenne presque seul les contraintes de conservation.
Le titre de l'article promettait d'apprendre un solveur, et le réseau a bel et bien appris 98.8 % du travail. Les 1.2 % restants, il faut finalement les confier à une règle d'arrondi ; une boucle gloutonne suffit.