Article original
Learnable Graph Matching: Incorporating Graph Partitioning with Deep Feature Learning for Multiple Object Tracking
- Publication
- CVPR 2021Conférence
- Premier dépôt sur arXiv
- arXiv:2103.16178
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackinggmtracker2021,
  title = {{Learnable Graph Matching: Incorporating Graph Partitioning with Deep Feature Learning for Multiple Object Tracking}},
  author = {Jiawei He and Zehao Huang and Naiyan Wang and Zhaoxiang Zhang},
  year = {2021},
  eprint = {2103.16178},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2103.16178}
}
De SORT à DeepSORT, la plupart des traqueurs en ligne disposent les trajectoires de l'image précédente et les détections de l'image courante en un graphe biparti, calculent la similarité de chaque paire, et confient l'appariement à l'algorithme hongrois.
Ce graphe biparti n'a qu'une sorte d'arête, celle qui dit « à quel point la trajectoire ressemble à la détection ». Ni la relation entre deux détections d'une même image, ni la question de savoir laquelle de deux trajectoires se trouvait à gauche de l'autre n'entrent en ligne de compte.
Jiawei He et Zhaoxiang Zhang, de l'Institut d'automatique de l'Académie chinoise des sciences, avec Zehao Huang et Naiyan Wang, de TuSimple, pensent que ces relations sont justement l'indice le plus fiable en cas d'occultation. Les piétons marchent souvent en groupe ; quand quelqu'un est caché et que son apparence devient illisible, on peut encore le reconnaître à « la personne à côté de qui il marchait ».
Définir le problème
Les auteurs relèvent trois problèmes de l'association de données de l'époque :
- Le contexte à l'intérieur d'une même image est ignoré. Qu'il s'agisse d'appariement biparti entre deux images ou de flot de coût minimal sur plusieurs images, seuls comptent les appariements « d'une image à l'autre » ; les relations entre objets d'une même image ne sont pas exploitées.
- Les méthodes de bout en bout se contentent de l'ajustement par le réseau. Certaines méthodes font produire directement l'appariement par un réseau, sans recourir aux outils accumulés en des décennies d'optimisation combinatoire.
- Les méthodes d'optimisation utilisent des caractéristiques entraînées à part. Les méthodes qui associent par optimisation sur graphe tirent en général leurs caractéristiques d'un réseau entraîné séparément ; l'objectif de l'entraînement et la façon d'apparier à l'inférence ne concordent pas.
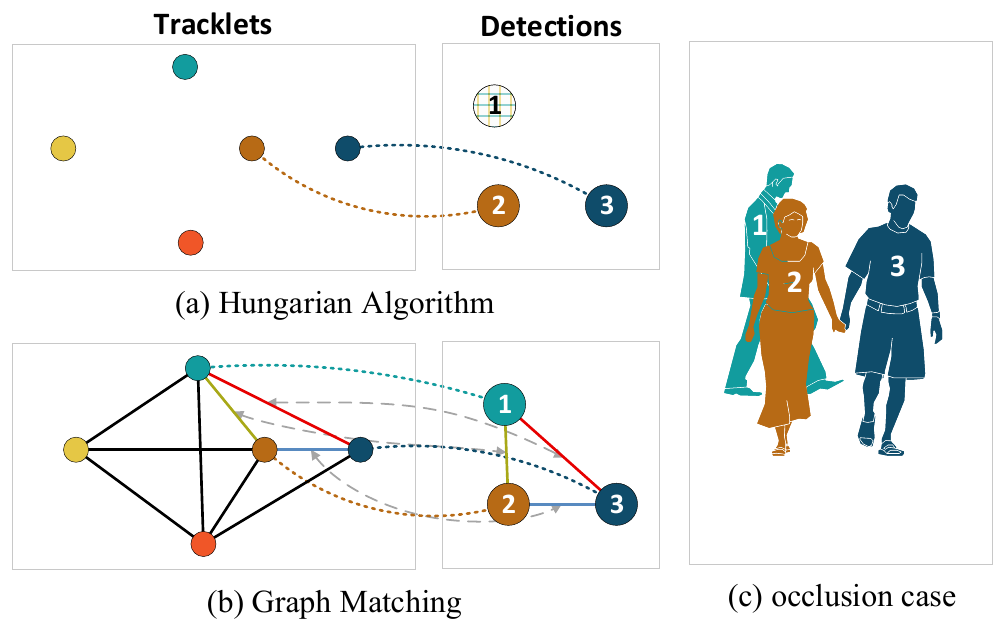
Regardons (c), à droite. La personne 1 est cachée en grande partie par la personne 2, et les caractéristiques d'apparence qu'on en extrait ne sont sans doute pas fiables. L'algorithme hongrois de (a) ne regarde que « à quelle trajectoire ressemble cette détection », et la personne 1 reste sans partenaire. (b) regarde en plus les positions relatives des détections 1, 2 et 3 ; elles concordent avec celles des trajectoires, et la personne 1 est reconnue.
Les auteurs appellent ce type de relation « arête à arête » une similarité du second ordre. Pour l'exploiter dans l'association, l'appariement n'est plus un appariement biparti, mais un appariement de graphes au sens général.
Résoudre le problème
De l'appariement biparti à l'appariement de graphes
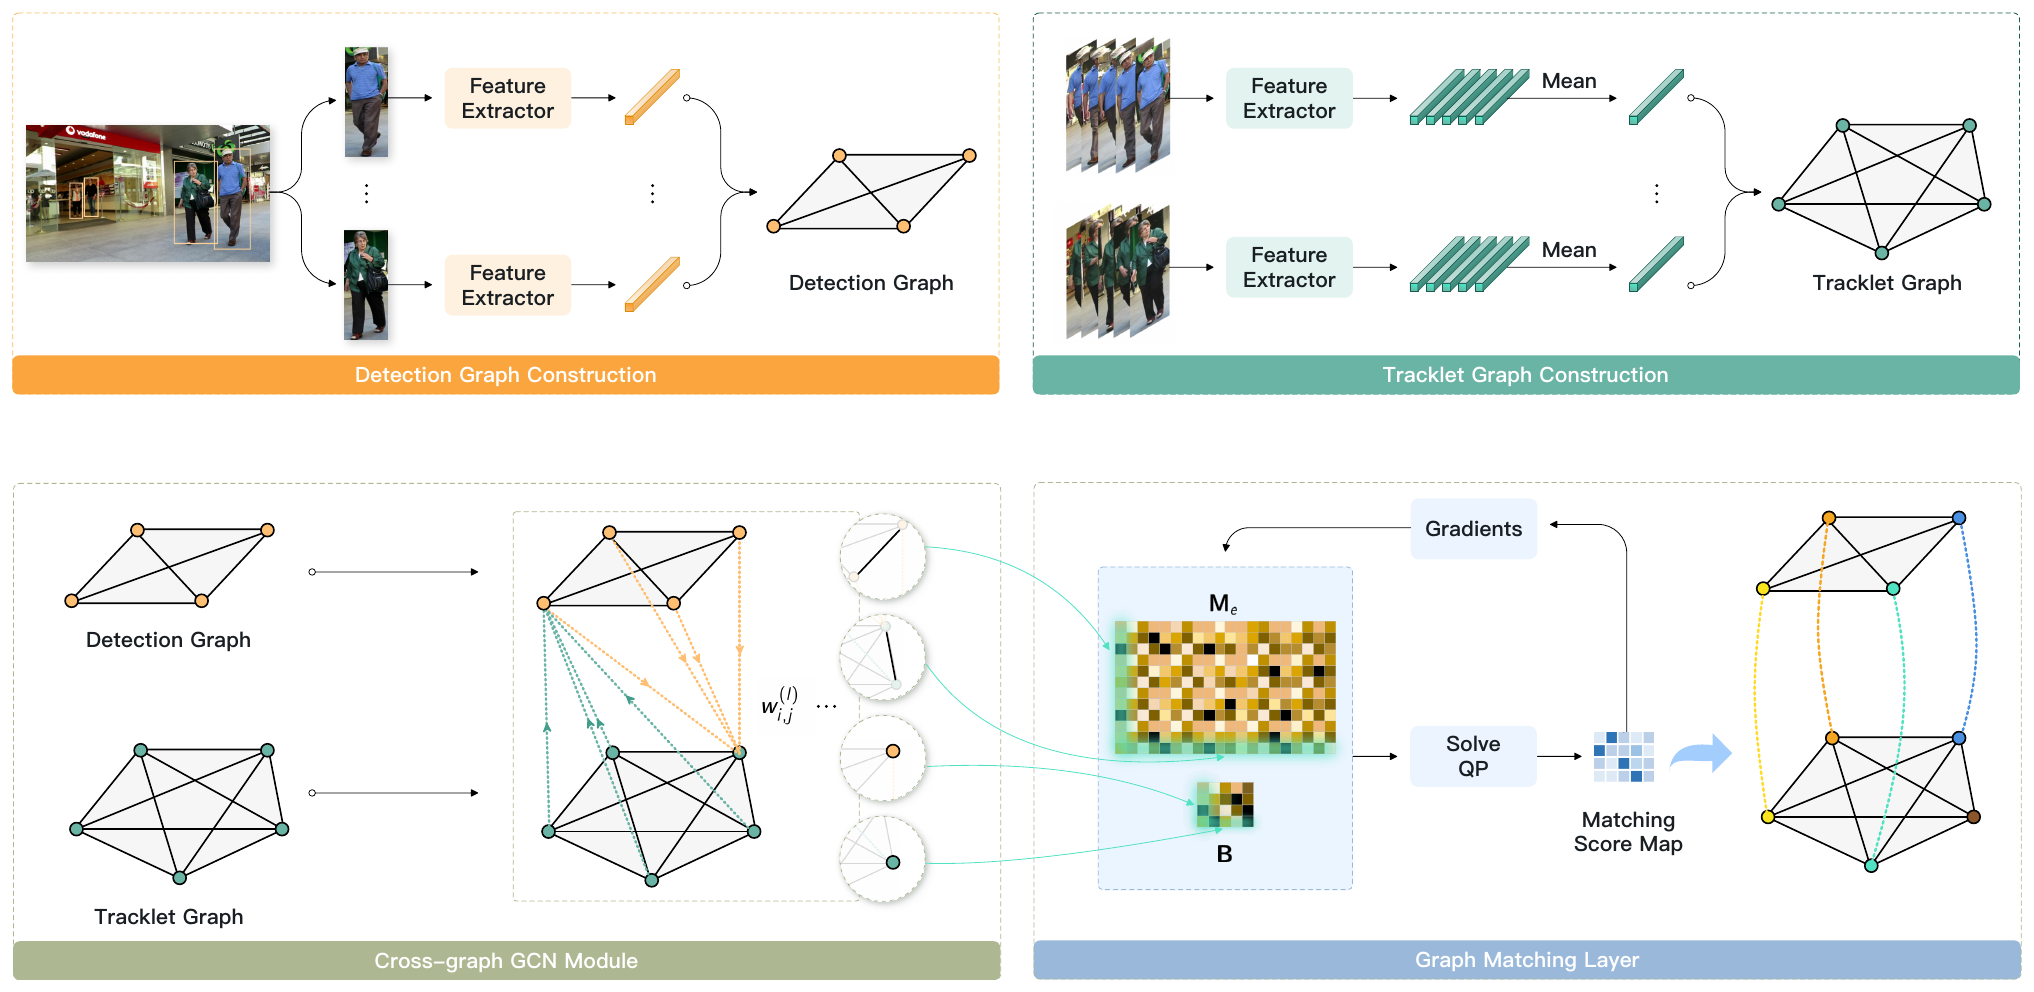
À chaque image, les auteurs construisent deux graphes. Les sommets du graphe des détections sont les détections de l'image, ceux du graphe des trajectoires les trajectoires en cours ; tous deux sont des graphes complets, où chaque paire de sommets est reliée par une arête.
L'appariement de graphes cherche un appariement tel que les sommets appariés se ressemblent, et que les arêtes appariées se ressemblent aussi. Mathématiquement, c'est un problème d'affectation quadratique :
et sont les poids des arêtes des deux graphes, la similarité entre sommets. Le premier terme exige que les arêtes appariées aient des poids proches, le second que les sommets appariés se ressemblent.
Avec le second terme seul, on retrouve l'algorithme hongrois habituel. Le premier terme est la nouveauté.
L'exemple des jumeaux
Prenons un cas extrême pour voir à quoi sert le premier terme.
Deux trajectoires et ; marche toujours à gauche de . Dans l'image courante apparaissent deux détections et , mais ce sont des jumeaux habillés à l'identique, et toutes les similarités d'apparence valent 0.5.
Si l'on ne regarde que les sommets, les deux appariements ont le même score :
| Appariement | Score des sommets |
|---|---|
| –, – | 0.5 + 0.5 = 1.0 |
| –, – | 0.5 + 0.5 = 1.0 |
L'algorithme hongrois ne peut que choisir au hasard.
Ajoutons maintenant les arêtes. Dans GMTracker, la caractéristique d'une arête est la concaténation des caractéristiques de ses deux sommets ; les arêtes sont donc orientées, et et sont deux arêtes différentes. Supposons que la détection soit à gauche de ; l'arête a une similarité de 0.9 avec , et de 0.2 seulement avec ; de même dans l'autre sens.
| Appariement | Sommets | Arêtes | Total |
|---|---|---|---|
| –, – | 1.0 | 0.9 + 0.9 | 2.8 |
| –, – | 1.0 | 0.2 + 0.2 | 1.4 |
Exemple de calcul établi pour cette note.
Deux personnes qu'on ne distingue pas à leur apparence, on les distingue à la place qu'elles occupent par rapport à leurs voisins.
Relaxation en programmation quadratique différentiable
L'ennui, c'est que le problème d'affectation quadratique est NP-difficile ; il n'existe pas, comme avec l'algorithme hongrois, de méthode polynomiale pour le résoudre, et encore moins de moyen de l'intégrer à un réseau de neurones pour la rétropropagation.
Les auteurs procèdent en deux temps :
- La relaxation. La matrice de permutation, qui ne contient que des 0 et des 1, est élargie en une « matrice bistochastique », dont chaque ligne et chaque colonne somment à 1. C'est la relaxation convexe la plus serrée de la matrice de permutation, et le problème devient un programme quadratique convexe.
- Remplacer les poids d'arête par des caractéristiques d'arête. Au lieu d'un simple poids, chaque arête porte désormais un vecteur. La similarité entre deux arêtes est la similarité cosinus de leurs caractéristiques ; on en forme une matrice de similarité arête à arête , qu'on déploie ensuite en la matrice du terme quadratique.
Le problème à résoudre devient :
est la matrice d'appariement mise à plat en vecteur, la similarité des sommets. Les contraintes imposent que les scores d'appariement de chaque détection somment à 1, et que ceux de chaque trajectoire ne dépassent pas 1, puisque certaines trajectoires ont disparu dans cette image.
Pour la solution optimale d'un programme quadratique, les conditions KKT et le théorème des fonctions implicites permettent de calculer le gradient par rapport aux entrées. Les auteurs s'inspirent d'OptNet pour faire de tout l'appariement de graphes une couche différentiable du réseau. À l'entraînement, le gradient traverse cette couche et remonte jusqu'aux caractéristiques ; à l'inférence, une résolution en passe avant suffit.
Le troisième problème cité plus haut est ainsi réglé. Les caractéristiques sont entraînées pour que l'appariement de graphes apparie juste, et entraînement et inférence utilisent la même façon d'apparier.
Une convolution de graphe entre les deux graphes
Les caractéristiques des sommets viennent d'un réseau ReID préentraîné, suivi de deux couches entièrement connectées entraînables. La caractéristique d'une trajectoire est la moyenne des caractéristiques de toutes ses détections.
Avant l'appariement de graphes, les auteurs renforcent les caractéristiques avec une couche de convolution de graphe inter-graphes. Chaque sommet du graphe des détections collecte des messages de tous les sommets du graphe des trajectoires, pondérés par la similarité d'apparence et de position :
La boîte d'une trajectoire est prédite par un filtre de Kalman à vitesse constante. Dans les vidéos où la caméra bouge, la position prédite n'est pas fiable, et l'on n'utilise que la similarité d'apparence.
Le message collecté, , est normalisé puis ajouté à la caractéristique d'origine, et le tout passe dans un MLP :
Les sommets du graphe des trajectoires sont mis à jour de la même façon. Comme dans MPNTrack, les messages ne circulent qu'entre les deux graphes, jamais à l'intérieur d'un même graphe. Enfin, la caractéristique de chaque arête est la concaténation des caractéristiques de ses deux sommets, normalisée en l2.
Entraînement et inférence
L'entraînement utilise une entropie croisée binaire pondérée ; le poids des exemples positifs vaut , pour compenser le déséquilibre entre l'unique bonne trajectoire d'une détection et ses nombreuses mauvaises. La solution du programme quadratique étant plutôt lisse, on accentue l'écart entre les scores avec une softmax à très basse température () avant de calculer la perte.
À l'inférence, la solution relâchée ne vaut pas forcément 0 ou 1 ; les auteurs l'arrondissent de façon gloutonne, en attribuant chaque détection à la trajectoire de score le plus élevé. La création et la suppression des trajectoires reprennent DeepSORT : les détections dont l'apparence est trop différente, qui sont trop loin de toutes les trajectoires (distance de Mahalanobis du filtre de Kalman au-delà d'un seuil), ou qui ne recouvrent aucune trajectoire, sont d'abord tenues à l'écart de l'appariement ; elles sont ensuite appariées une seconde fois avec les trajectoires restées sans partenaire, par IoU et algorithme hongrois. S'y ajoute une compensation du mouvement de caméra par ECC. Une trajectoire n'est supprimée qu'après 100 images sans mise à jour.
Discussion
L'apport de chaque pièce
Les ablations se font en validation croisée à trois plis sur l'ensemble d'entraînement de MOT17, avec l'appariement hongrois de DeepSORT comme référence :
| Réglage | IDF1 | MOTA | ID switch |
|---|---|---|---|
| Référence DeepSORT | 68.1 | 62.1 | 1 135 |
| + app. de graphes | 70.0 | 62.3 | 1 128 |
| GMTracker complet | 71.5 | 62.3 | 1 017 |
| Association parfaite | 77.2 | 62.6 | 14 |
D'après la Table 1 et la Table A de l'annexe de l'article, ensemble de validation de MOT17, sans interpolation.
- L'appariement de graphes apporte le plus. Remplacer seulement l'algorithme hongrois par l'appariement de graphes fait gagner 1.9 point d'IDF1. Les caractéristiques d'apparence entraînées et la convolution de graphe ajoutent environ 0.6, l'information de position environ 1.0 de plus.
- MOTA ne bouge presque pas. De 62.1 à 62.3, parce que GMTracker traite l'association et que la détection ne change pas. C'est aussi pourquoi les auteurs prennent IDF1 comme métrique principale.
- La perfection est encore loin. Dans l'annexe, les auteurs font une association parfaite à partir de la vérité terrain, qui atteint 77.2 en IDF1. GMTracker comble environ un tiers de l'écart entre la référence et la perfection.
La couche d'appariement de graphes n'est utile que si elle est entraînée avec le reste. Sans elle, ni à l'entraînement ni à l'inférence, l'IDF1 est de 69.5 ; ajoutée seulement à l'inférence, 70.2 ; il faut l'utiliser à l'entraînement comme à l'inférence pour atteindre 71.5.
Combien de temps tient-il ?
| Images gardées | 30 | 50 | 80 | 100 | 150 |
|---|---|---|---|---|---|
| Algo. hongrois | 67.2 | 67.9 | 68.1 | 68.1 | 67.3 |
| App. de graphes | 68.0 | 69.3 | 69.7 | 70.0 | 70.0 |
D'après la Table 4 de l'article, ensemble de validation de MOT17, IDF1.
Plus on garde les trajectoires longtemps, plus il y a de trajectoires candidates ; l'algorithme hongrois perd même 0.8 à 150 images, car plus il y a de candidats, plus on se trompe facilement. L'appariement de graphes, lui, se maintient ou progresse tout du long, et les auteurs en concluent que GMTracker peut rattraper des trajectoires disparues depuis environ 5 secondes.
Quand les candidats sont nombreux, comparer les seules apparences mène facilement à confondre les gens ; si l'on y ajoute les positions relatives, les mauvaises combinaisons deviennent plus difficiles à assembler.
Face aux autres méthodes
Sur l'ensemble de test de MOT17, avec les détections publiques affinées par Tracktor, GMTracker en ligne obtient un IDF1 de 63.8 et un MOTA de 56.2, au-dessus des autres méthodes en ligne de l'époque ; avec les détections de CenterTrack, l'IDF1 monte à 66.9. Avec une interpolation linéaire, face aux méthodes hors ligne, il atteint 65.9 en IDF1, au-dessus des 61.7 de MPNTrack et des 65.6 de LifT ; avec les détections de CenterTrack et l'interpolation, IDF1 68.7 et MOTA 65.0.
Ces comparaisons demandent de faire attention aux conditions de détection. Le MOTA dépend surtout de la détection ; pour un même GMTracker, il suffit de changer de détections pour que le MOTA passe de 56.2 à 61.5.
Le prix
L'article ne rapporte aucune vitesse. Le nombre de variables de la programmation quadratique est le nombre de détections multiplié par le nombre de trajectoires, et la matrice de similarité arête à arête est encore bien plus grande ; à l'inférence, les auteurs passent à CVXPY et ne font que la résolution en passe avant. Dans une scène encombrée, il faut résoudre un programme quadratique à chaque image ; c'est un coût de calcul à évaluer avant de l'utiliser.
La version étendue publiée ensuite en revue applique le même appariement de graphes appris à l'appariement de points caractéristiques d'images et au recalage de nuages de points, et son titre devient « un paradigme pratique pour l'association de données ».
Conclusion
GMTracker remplace, pour l'appariement du suivi en ligne, l'appariement biparti qui ne regarde que les sommets par un appariement de graphes qui regarde à la fois les sommets et les arêtes. Quand une personne est cachée et que son apparence n'est plus fiable, ses positions relatives par rapport aux gens qui l'entourent permettent encore de la reconnaître. Pour faire entrer cela dans un réseau de neurones, les auteurs relâchent le problème d'affectation quadratique en programme quadratique convexe, puis obtiennent le gradient par les conditions KKT, si bien que les caractéristiques apprennent au service de l'appariement.
Cet article et MPNTrack prennent tous deux les relations entre objets comme indices d'association, au lieu de s'en tenir à des comparaisons deux à deux. MPNTrack laisse un réseau de graphes prédire directement quelles arêtes relier ; GMTracker garde la résolution par optimisation et ne laisse le réseau apprendre que les caractéristiques.
SUSHI, issu lui aussi de l'équipe de MPNTrack, poussera plus tard l'approche par réseau de graphes jusqu'au suivi sur de longues durées.
Référence
- Learnable Graph Matching: A Practical Paradigm for Data Association (version étendue, TPAMI 2024)