Article original
Object-Centric Multiple Object Tracking
- Publication
- ICCV 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2309.00233
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingocmot2023,
  title = {{Object-Centric Multiple Object Tracking}},
  author = {Zixu Zhao and Jiaze Wang and Max Horn and Yizhuo Ding and Tong He and Zechen Bai and Dominik Zietlow and Carl-Johann Simon-Gabriel and Bing Shuai and Zhuowen Tu and Thomas Brox and Bernt Schiele and Yanwei Fu and Francesco Locatello and Zheng Zhang and Tianjun Xiao},
  year = {2023},
  eprint = {2309.00233},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2309.00233}
}
En 1989, le chercheur en sciences cognitives Zenon Pylyshyn propose une théorie de la perception visuelle de l'espace. Selon Pylyshyn, le système visuel humain dispose d'un petit jeu d'« index », chacun collé à un objet ; que l'objet bouge, frôle un autre objet ou soit même en partie caché, l'index reste collé.
Cela ressemble beaucoup à ce que fait le suivi multi-objets, et beaucoup aussi aux slots de Slot Attention.
Zixu Zhao, Tianjun Xiao et leurs collègues d'Amazon AWS, avec Francesco Locatello, co-premier auteur de Slot Attention, veulent voir si l'apprentissage centré sur les objets peut servir directement au suivi. Si c'est le cas, plus besoin d'annoter autant de boîtes pour le suivi, et encore moins d'indiquer à qui appartient chaque boîte.
Définir le problème
L'annotation du suivi coûte cher
Les traqueurs dominants suivent le schéma « détecter puis associer ». Le détecteur a besoin d'énormément de boîtes pour s'entraîner ; si le module d'association doit apprendre des caractéristiques d'apparence, il lui faut en plus savoir quelles boîtes correspondent à la même personne, autrement dit des annotations d'identité.
Les annotations d'identité coûtent plus cher que les boîtes. L'annotateur doit regarder la vidéo entière pour confirmer que la personne de l'image 37 et celle de l'image 512 sont bien la même.
L'apprentissage centré sur les objets prend un autre chemin. Les méthodes comme Slot Attention n'ont besoin d'aucune annotation ; en se contentant de reconstruire l'image, elles découpent la scène en slots, chaque slot correspondant à peu près à un objet. SAVi étend l'idée à la vidéo, et les slots se prolongent d'une image à l'autre.
Des slots qui se dédoublent et changent de cible
Mais utiliser SAVi tel quel pour le suivi pose deux problèmes.
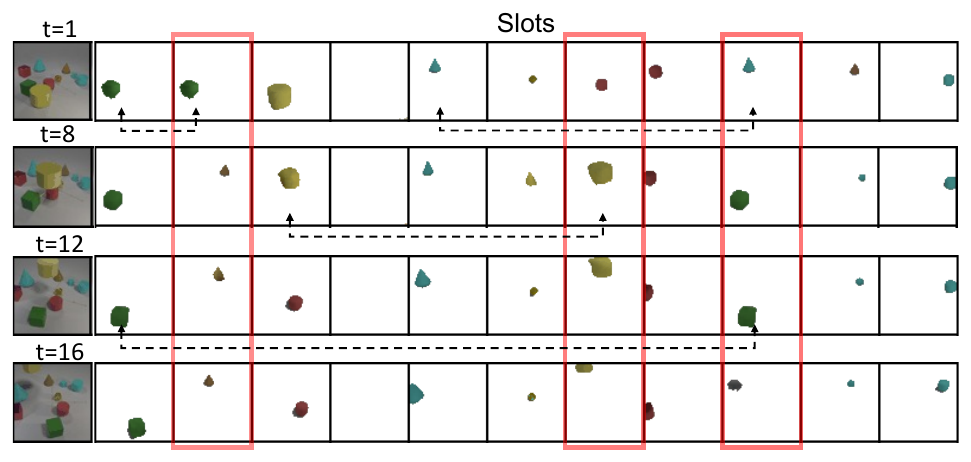
- Le dédoublement. Un même objet est saisi par plusieurs slots à la fois, ou un slot n'en saisit qu'une partie. C'est le problème dit part-whole.
- Le changement de cible. Le même slot saisit un cube vert à l'image 1, puis autre chose à l'image 12. Pour le suivi, c'est un changement d'identité (ID switch).
L'apprentissage centré sur les objets s'évalue souvent avec FG-ARI, une métrique qui ne regarde que la qualité du regroupement image par image ; un échange de « propriété » entre slots n'y est guère pénalisé. Voilà pourquoi ces deux problèmes sont longtemps restés dans l'ombre.
Résoudre le problème
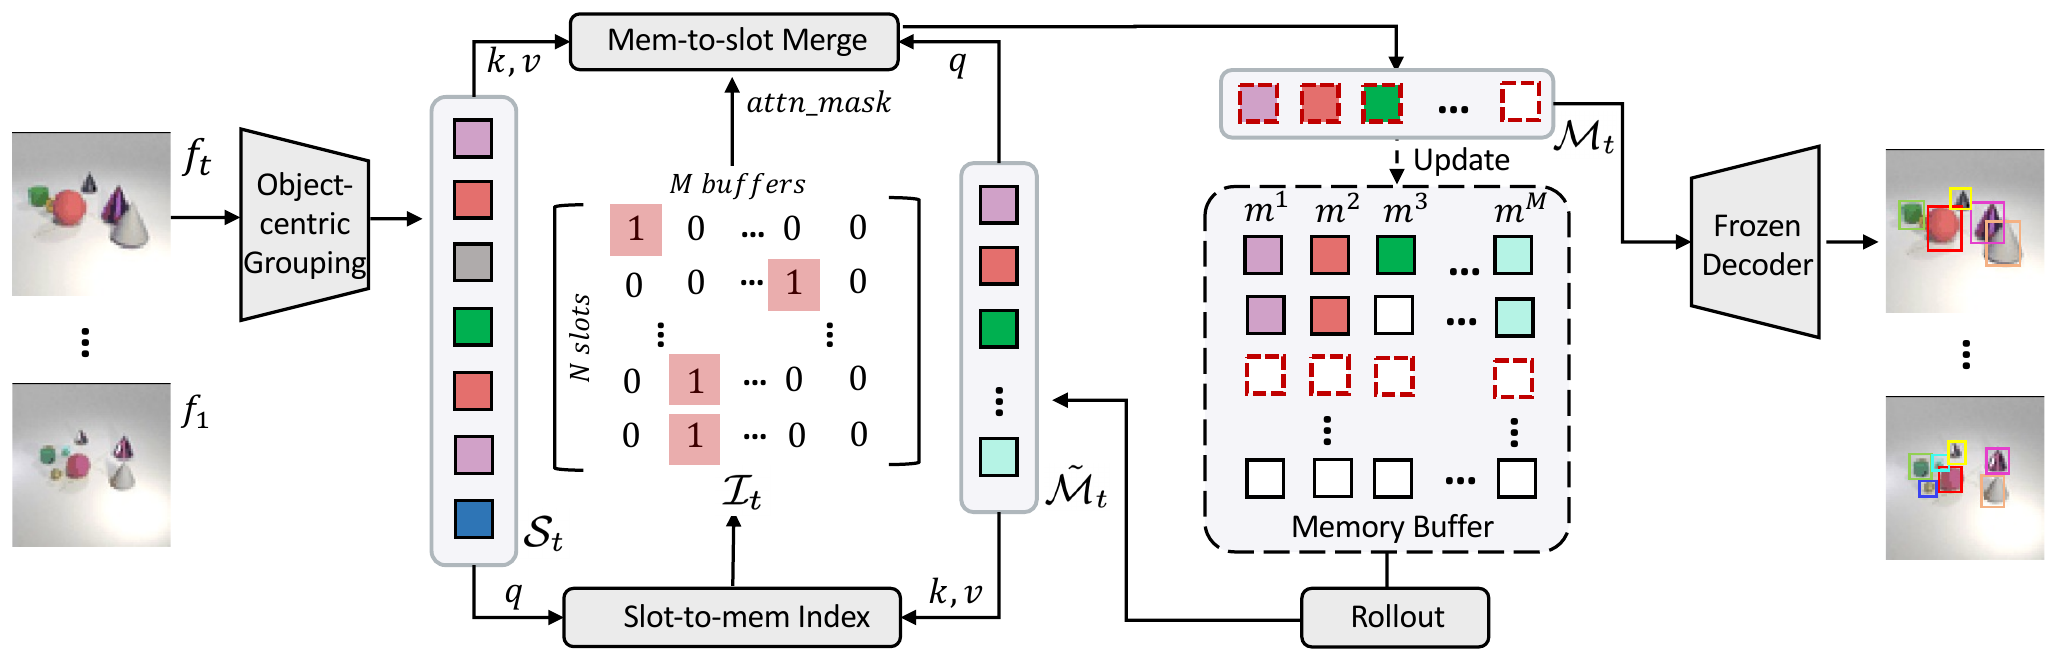
OC-MOT traite le modèle centré sur les objets comme un détecteur, le gèle, et branche un module de mémoire à sa suite. Seul le module de mémoire est entraîné.
La mémoire : chaque tampon est une trajectoire
La mémoire se compose de tampons ; chacun stocke la représentation d'un objet sur les dernières images, en file premier entré, premier sorti, et garde au plus images. Vu autrement, chaque tampon est une trajectoire.
Avant chaque image, un petit GPT-2 de seulement 1.6 million de paramètres lit l'historique de tous les tampons et prédit l'aspect que chaque objet devrait avoir dans cette image. Cette étape s'appelle le rollout.
Le rollout combine l'aspect de l'objet sur plusieurs images passées. Si un objet est à moitié caché dans l'image courante, le rollout prédit quand même l'objet entier.
L'indexation : chaque slot cherche sa place
Ensuite, chaque slot doit trouver à quel tampon il appartient.
Les auteurs utilisent une attention multi-têtes, avec les slots comme requêtes et les rollouts comme clés et valeurs ; les poids d'attention ainsi obtenus forment une matrice d'index de taille . La ligne donne la probabilité que le slot soit attribué à chacun des tampons.
Des slots en double, ou qui ne saisissent qu'une partie d'un objet, peuvent pointer vers le même tampon ; les morceaux d'un même objet sont de toute façon censés reprendre la même place.
La fusion : recoller les morceaux
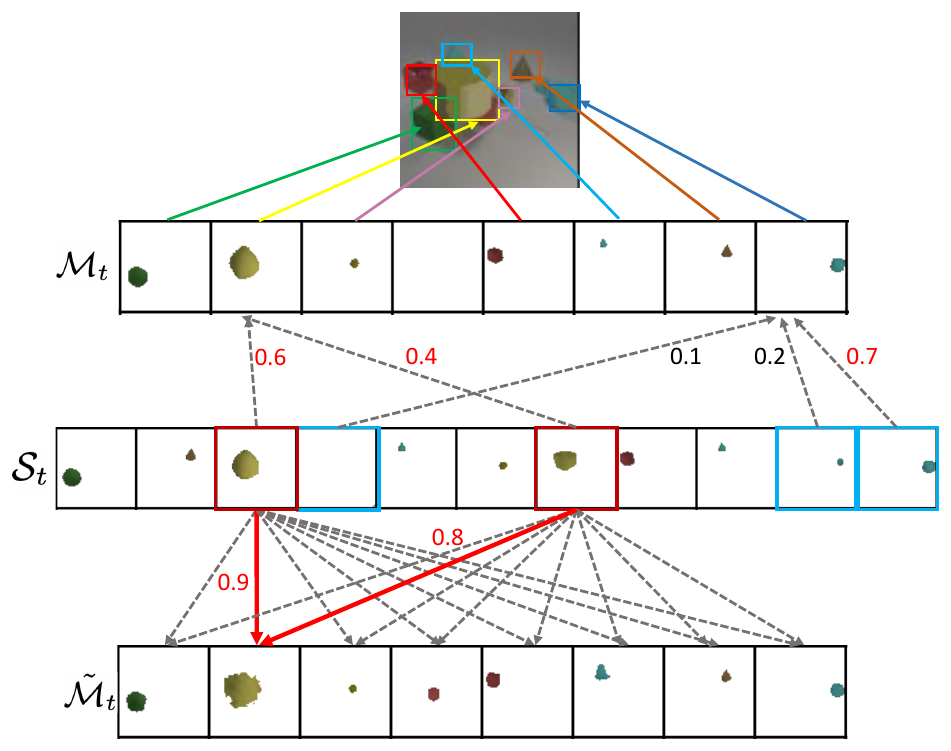
La seconde attention multi-têtes inverse les rôles ; les rollouts servent de requêtes, les slots de clés et valeurs, et la matrice d'index sert de masque, de sorte que chaque tampon ne voit que les slots qui lui ont été attribués.
Les poids renormalisés après masquage donnent les proportions de la fusion. L'exemple de l'article est celui de trois slots dont deux pointent vers le même tampon ; les poids de fusion peuvent alors valoir . Le deuxième slot a beau avoir été attribué à ce tampon, il n'appartient pas vraiment à cet objet ; son poids est très faible, ce qui revient à le filtrer.
Le résultat de la fusion est réécrit dans la mémoire et devient la sortie de suivi pour cette image.
S'entraîner sans étiquettes d'identité
L'objectif de l'entraînement est d'envoyer chaque slot vers le tampon qui « lui ressemble le plus ». Pour mesurer la ressemblance, le décodeur gelé décode les deux en masques et en images, que l'on compare ; l'entropie croisée des masques compare les formes, l'erreur quadratique de la reconstruction de l'objet compare les couleurs, et la distance entre vecteurs de représentation compare les caractéristiques.
La difficulté est dans l'indexation. Chaque slot ne peut finalement être attribué qu'à un seul tampon ; l'approche intuitive serait de prendre l'argmax, mais l'argmax n'est pas dérivable. Si l'on force le passage avec l'astuce straight-through, le modèle ne voit plus que le tampon qu'il a choisi, et reste facilement bloqué sur une mauvaise attribution.
Les auteurs empruntent l'idée de l'algorithme EM ; ils traitent la matrice d'index comme une probabilité et minimisent le coût espéré :
Un exemple montre la différence. Un slot, deux tampons, avec des coûts de comparaison respectifs de 0.2 et 1.0. L'index actuel vaut ; l'attribution est mauvaise.
| Approche | Perte | Ce que l'on voit |
|---|---|---|
| argmax | 1.0 | Tampon 2 seul |
| Coût espéré | 0.4 × 0.2 + 0.6 × 1.0 = 0.68 | Les deux |
Exemple de calcul établi pour cette note.
Avec le coût espéré, déplacer 0.1 de probabilité du tampon 2 vers le tampon 1 fait tomber la perte à 0.60, soit 0.08 de moins, exactement . Le gradient pousse naturellement la probabilité vers le côté le moins coûteux. Tout le processus se contente de comparer la ressemblance entre slots et mémoire, sans la moindre étiquette d'identité.
Ce n'est qu'à l'inférence que la matrice d'index est binarisée, chaque slot n'étant alors attribué qu'à un seul tampon. À la première image, les slots initialisent les tampons, après élimination des slots en double dont les masques se recouvrent trop ; par la suite, un slot qui ne recouvre aucun rollout ouvre un nouveau tampon. Un tampon n'est fermé que lorsque l'objet a disparu depuis plus de 5 images.
Discussion
Deux jeux de données
Les expériences portent sur deux jeux de données synthétiques. CATER montre une foule d'objets géométriques 3D qui se déplacent sur une table en s'occultant mutuellement ; FISHBOWL est enregistré à partir d'un aquarium WebGL et compte 20 000 vidéos d'entraînement et 1 000 vidéos de validation et de test, de 128 images chacune, avec des bancs de poissons qui s'occultent davantage et un fond plus complexe.
Sur CATER, le modèle centré sur les objets est SAVi, sans aucune annotation. FISHBOWL est plus difficile ; les auteurs ajoutent un peu de supervision à DINOSAUR, en annotant au hasard les masques de 8 images sur les 128 de chaque vidéo, soit 6.25 %. Dans les deux cas, il n'y a aucune annotation d'identité.
| Méthode | Annot. dét. | Annot. ID | IDF1 | MOTA | Chang. ID |
|---|---|---|---|---|---|
| SAVi | 6.25 % | — | 46.9 | 32.3 | 12 504 |
| SORT | 6.25 % | — | 68.4 | 64.3 | 15 278 |
| IOU | 6.25 % | — | 71.3 | 66.6 | 10 306 |
| Visual-Spatial | 6.25 % | — | 74.6 | 68.1 | 8 754 |
| OC-MOT | 6.25 % | — | 77.9 | 70.3 | 5 898 |
| MOTR | 100 % | 100 % | 81.6 | 79.8 | 4 185 |
D'après la Table 1 de l'article, FISHBOWL.
Par souci d'équité, SORT, IOU et Visual-Spatial prennent comme détections la sortie du même modèle centré sur les objets. OC-MOT a le moins de changements d'identité de toutes les méthodes non supervisées, 60 % de moins que SORT. Les poissons ne nagent pas en ligne droite, et le filtre de Kalman comme l'IoU ont du mal à suivre.
Face à MOTR, entraîné avec une annotation complète, OC-MOT reste en retrait de 3.7 points d'IDF1 et de 9.5 de MOTA. Selon les auteurs, l'écart vient surtout de la détection ; DINOSAUR prédit ses masques à très basse résolution, et les boîtes manquent de précision.
Sur CATER, l'écart est encore plus faible. OC-MOT, sans aucune annotation, obtient un IDF1 de 88.6 et un MOTA de 82.4, contre 89.3 et 83.3 pour MOTR.
Ce que FG-ARI ne voit pas
| Méthode | FG-ARI | IDF1 | Track mAP |
|---|---|---|---|
| SAVi | 90.2 | 72.3 | 42.8 |
| OC-MOT | 93.8 | 88.6 | 66.2 |
D'après la Table 2 de l'article, CATER.
SAVi atteint 90.2 en FG-ARI et semble très bien regrouper ; mais son Track mAP, qui apparie sur la vidéo entière, n'est que de 42.8. Bien découper chaque image et bien suivre toute la vidéo sont deux choses différentes.
La mémoire et les deux attentions
| Index et fusion | Mémoire | IDF1 | Chang. ID |
|---|---|---|---|
| Produit scalaire | rollout | 72.0 | 22 050 |
| Une attention partagée | rollout | 86.2 | 7 655 |
| Deux attentions | Image précédente | 77.2 | 16 582 |
| Deux attentions | rollout | 88.6 | 5 658 |
D'après la Table 3 de l'article, CATER.
Si l'on retire le rollout et que l'on prend seulement le résultat de l'image précédente comme requête, les changements d'identité passent de 5 658 à 16 582, presque le triple. Pendant une occultation, l'image précédente ne montre qu'une moitié d'objet, alors que le rollout sait reconstituer l'objet entier.
La longueur de la mémoire compte aussi. Avec un échantillonnage continu, plus la mémoire est longue, mieux c'est ; l'IDF1 passe de 82.9 avec 6 images à 88.4 avec 32 images. Mais une mémoire longue est gourmande en matériel ; les auteurs passent donc à un échantillonnage qui alterne cadence lente et cadence rapide, et qui permet à une mémoire de 6 images de voir aussi, à l'entraînement, des intervalles longs et des occultations. L'IDF1 atteint 88.6, plus que les 32 images en échantillonnage continu.
Limites
Les deux jeux de données sont synthétiques. Les auteurs ont appliqué le même module de regroupement à de vraies scènes de rue de KITTI ; les voitures sont bien détectées, mais les masques sont grossiers, en particulier pour les voitures lointaines. Les caractéristiques de DINOSAUR n'ont qu'une résolution de 1/16 de l'image d'origine, une limite qui tient à l'architecture.
L'article n'évalue pas non plus sur MOT17. Les auteurs expliquent en annexe que les scores de MOT17 reflètent surtout la détection, et que les modèles centrés sur les objets actuels ne détectent pas encore aussi bien que les détecteurs supervisés. Ils ont essayé de remplacer le détecteur par SEEM et d'entraîner l'association sur TAO avec la même méthode auto-supervisée, mais ne montrent que des visualisations, sans chiffres.
Par ailleurs, le système n'est pas entraîné de bout en bout. Le modèle centré sur les objets est d'abord entraîné puis gelé, et le module de mémoire n'est entraîné qu'ensuite.
Conclusion
OC-MOT s'attaque à deux vieux problèmes de l'apprentissage centré sur les objets appliqué au suivi. Les slots dédoublés sont recollés en un même objet par l'indexation et la fusion ; les slots qui changent de cible sont pris en charge par la mémoire et le rollout, qui prolongent l'historique de chaque objet.
Le plus remarquable, c'est que l'apprentissage de l'association ne demande aucune étiquette d'identité. Il suffit de comparer la ressemblance entre slots et mémoire et d'écrire l'attribution comme un coût espéré ; le gradient ramène alors chaque slot à sa place.
Le vrai goulot d'étranglement est en amont, dans le modèle centré sur les objets. Sur CATER, OC-MOT fait déjà presque jeu égal avec MOTR et son annotation complète, et reste à quelques points derrière sur FISHBOWL ; sur de vraies scènes de rue, la précision des masques ne suffit pas encore. La partie association ne dépend pas du détecteur ; il suffit de mettre un modèle plus fort en amont pour la brancher directement, et l'essai de SEEM en annexe va dans ce sens.