Article original
MOTR: End-to-End Multiple-Object Tracking with Transformer
- Publication
- ECCV 2022Conférence
- Premier dépôt sur arXiv
- arXiv:2105.03247
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingmotr2021,
  title = {{MOTR: End-to-End Multiple-Object Tracking with Transformer}},
  author = {Fangao Zeng and Bin Dong and Yuang Zhang and Tiancai Wang and Xiangyu Zhang and Yichen Wei},
  year = {2021},
  eprint = {2105.03247},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2105.03247}
}
Les traqueurs vus jusqu'ici, quelle que soit la dose d'apprentissage profond qu'ils contiennent, finissent tous par une étape d'association écrite à la main.
SORT utilise l'IoU et l'algorithme hongrois, DeepSORT y ajoute une distance d'apparence et une cascade d'appariement, FairMOT reprend un appariement en deux étapes, et CenterTrack ramène les centres à l'image précédente avec les déplacements prédits, avant un appariement glouton. Le mouvement repose sur le filtre de Kalman ou sur des déplacements appris, l'apparence sur des caractéristiques re-ID ; la façon de les combiner et la valeur des seuils sont décidées par des humains. Ce post-traitement fait barrage au milieu, et l'information temporelle ne peut pas circuler de bout en bout.
En 2020, DETR a reformulé la détection d'objets comme une prédiction d'ensemble. Un ensemble de requêtes d'objet (object queries) apprenables interagit avec les caractéristiques de l'image ; chaque requête produit une boîte, appariée une à une avec les boîtes de vérité terrain par appariement biparti, sans même de suppression des non-maxima.
Si la détection peut se passer de post-traitement, pourquoi pas le suivi ?
Fangao Zeng, Bin Dong, Yuang Zhang, Tiancai Wang et leurs collègues de MEGVII et de l'Université Jiao Tong de Shanghai proposent MOTR, qui tente de construire un traqueur sans le moindre appariement écrit à la main, du début à la fin.
Définir le problème
Les auteurs s'inspirent de la traduction automatique. Un modèle de traduction représente le contexte courant par un état caché ; le décodeur fait interagir cet état avec les caractéristiques d'entrée, encore et encore, et produit les mots traduits un par un.
Le suivi multi-objets peut se voir comme un problème similaire, dont la sortie est un ensemble de séquences, chacune étant la trajectoire d'un objet. Si chaque trajectoire a elle aussi un état caché, qui interagit image après image avec les caractéristiques de l'image et produit une boîte à chaque image, l'identifiant suit naturellement cet état caché, et il n'y a plus besoin d'apparier.
MOTR étend les requêtes d'objet de DETR en requêtes de piste (track queries), qui servent d'état caché aux trajectoires. Il faut pour cela résoudre deux problèmes :
- Comment une requête peut-elle suivre toujours le même objet ? Dans DETR, une requête d'objet peut être attribuée à n'importe quel objet de l'image, et cela à chaque image ; elle n'a aucune notion d'identité.
- Que faire des objets qui apparaissent et de ceux qui partent ? Le nombre d'objets dans l'image change sans cesse, et le nombre de requêtes de piste doit suivre.
Résoudre le problème
Deux types de requêtes
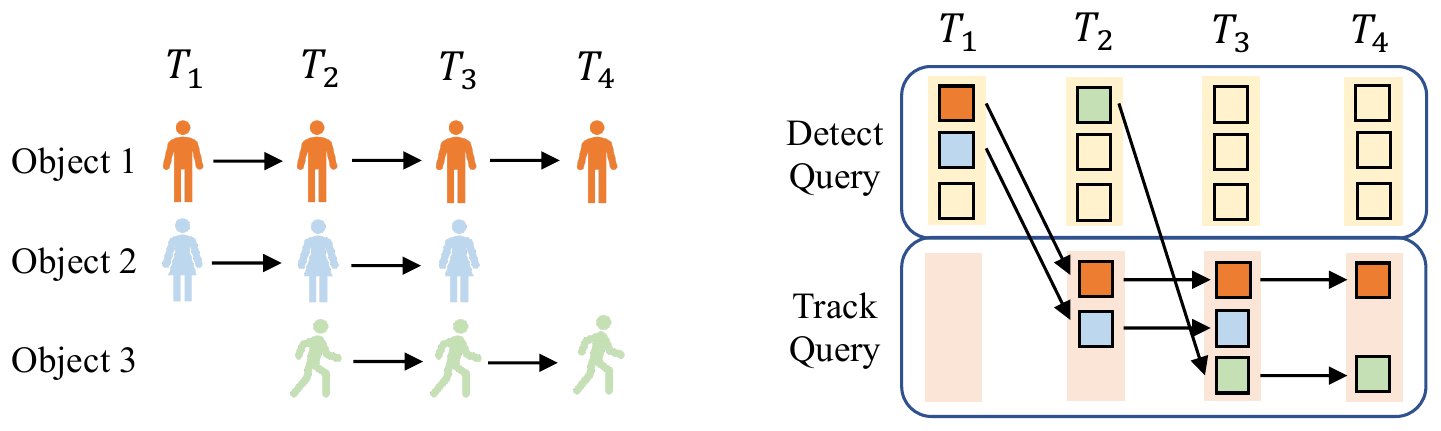
MOTR distingue deux types de requêtes ; suivons la figure pas à pas :
- Requêtes de détection (detect queries) : ce sont les requêtes d'objet d'origine de DETR, en nombre fixe, apprenables et identiques à chaque image. Elles ne servent qu'à trouver les objets nouvellement apparus.
- Requêtes de piste (track queries) : un ensemble de requêtes de taille variable, chacune représentant une trajectoire déjà suivie.
T1 : au départ, il n'y a encore aucune trajectoire, et l'ensemble des requêtes de piste est vide. Seules les requêtes de détection entrent dans le décodeur, et deux d'entre elles trouvent les objets 1 et 2.
T2 : les états cachés, en sortie du décodeur, des deux requêtes qui ont trouvé les objets 1 et 2 deviennent les requêtes de piste de l'image suivante. À T2, le décodeur reçoit « deux requêtes de piste + un ensemble de requêtes de détection ». Les deux requêtes de piste produisent chacune la nouvelle boîte de l'objet 1 et de l'objet 2, avec le même identifiant ; l'une des requêtes de détection trouve l'objet 3, qui vient d'apparaître.
T3 : l'état caché de l'objet 3 rejoint à son tour les requêtes de piste, qui sont maintenant trois.
T4 : l'objet 2 est parti, et sa requête de piste est retirée de l'ensemble.
Tout au long du processus, chaque requête de piste ne représente qu'un seul objet, de sa création à sa suppression. Le résultat du suivi est simplement la suite des boîtes produites par une même requête de piste à chaque image.
Attribuer les étiquettes
À l'entraînement, DETR décide par appariement biparti de quel objet réel chaque requête est responsable. MOTR remplace cela par une « attribution d'étiquettes consciente des tracklets » (Tracklet-Aware Label Assignment, TALA), qui traite séparément les deux types de requêtes :
- Requêtes de détection : appariement biparti uniquement avec les objets nouvellement apparus dans l'image.
- Requêtes de piste : elles ne participent pas à l'appariement et reprennent directement l'attribution de l'image précédente. La requête responsable de l'objet 1 à l'image précédente reste responsable de l'objet 1 dans celle-ci.
En formule, l'attribution des requêtes de piste à l'image , , est l'attribution des requêtes de piste de l'image précédente plus celle des nouveaux objets de l'image précédente :
À l'inférence, il n'y a pas d'étiquettes ; comment une requête de détection sait-elle qu'elle ne doit pas chercher un objet déjà suivi ? Les deux types de requêtes entrent ensemble dans le décodeur, et l'auto-attention abaisse le score des requêtes de détection qui trouvent un objet déjà suivi. C'est pour la même raison que DETR ne produit pas de boîtes en double, même sans NMS.
Architecture d'ensemble
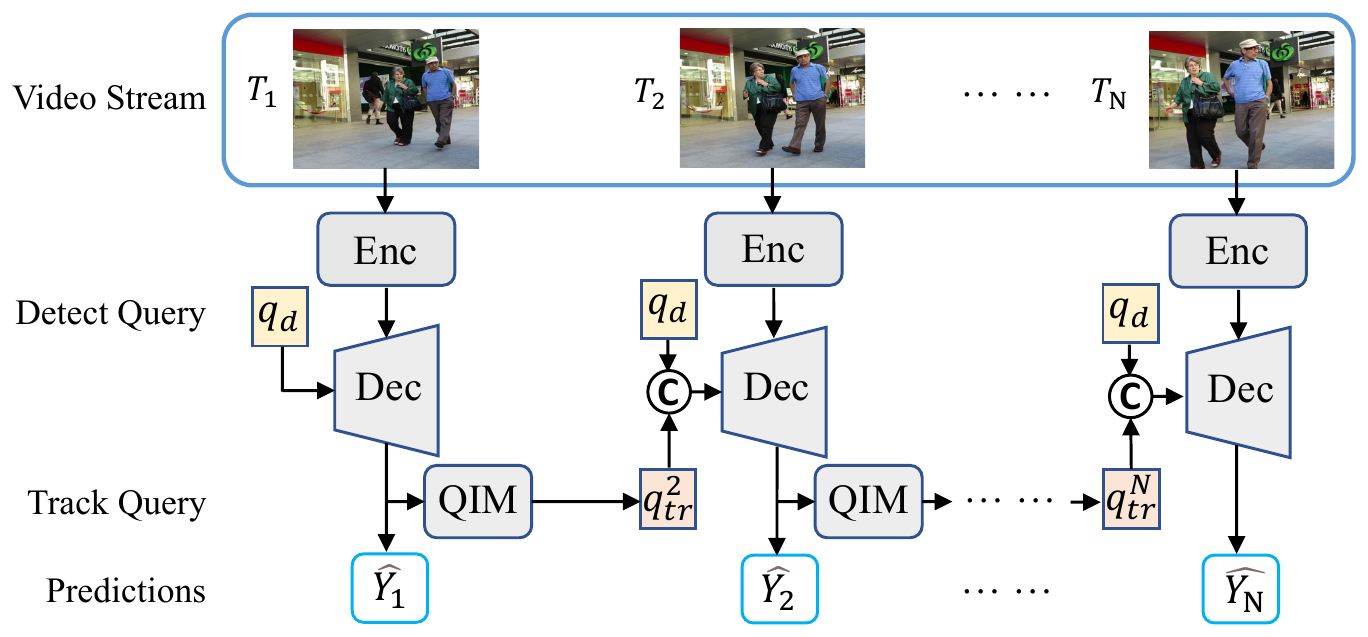
Le backbone est un ResNet-50, et le cadre de détection Deformable DETR. Chaque image passe par le backbone et l'encodeur Transformer pour en extraire les caractéristiques ; le décodeur reçoit les requêtes de piste de l'image précédente concaténées aux requêtes de détection, et ses états cachés en sortie servent d'une part à prédire les boîtes et les classes, et passent d'autre part par le module d'interaction des requêtes (Query Interaction Module, QIM), qui produit les requêtes de piste de l'image suivante.
QIM a deux rôles.
Entrées et sorties des objets. À l'entraînement, si un objet disparaît de l'annotation de vérité terrain, ou si l'IoU entre sa boîte prédite et sa boîte réelle passe sous 0.5, son état caché est abandonné ; les nouveaux objets sont conservés selon le résultat de l'appariement des requêtes de détection. À l'inférence, on passe aux scores de classification ; une requête de détection ne devient une nouvelle trajectoire que si son score dépasse le seuil d'entrée , et une requête de piste n'est supprimée que si son score reste sous le seuil de sortie pendant images consécutives.
Le réseau d'agrégation temporelle (Temporal Aggregation Network, TAN). C'est une couche de décodeur Transformer modifiée. Pour chaque objet suivi, la requête de piste de l'image précédente et l'état caché de l'image courante sont additionnés pour servir de query et de key à l'auto-attention multi-têtes, l'état caché de l'image courante servant de value ; le tout passe ensuite par un réseau feed-forward. Cela offre aux requêtes de piste un raccourci pour faire entrer l'information historique. La sortie de TAN est ensuite concaténée aux états cachés des nouveaux objets pour former les requêtes de piste de l'image suivante.
Une perte calculée sur tout l'extrait
L'hypothèse de vitesse constante du filtre de Kalman est écrite à la main ; le modèle de mouvement de MOTR doit être appris à partir des données. Mais en entraînant seulement sur deux images adjacentes, le réseau ne voit que des mouvements très courts, et ne peut pas apprendre des évolutions longues comme la réapparition d'un objet après une occultation.
Les auteurs proposent la perte moyenne collective (Collective Average Loss, CAL). À l'entraînement, on fournit un extrait vidéo entier d'un coup, on rassemble les prédictions de chaque image, on calcule la perte sur tout l'extrait, puis on la divise par le nombre total d'objets réels dans l'extrait :
est le nombre d'objets réels dans l'image . Comme dans DETR, la perte par image est une somme pondérée de la focal loss, de la perte L1 et de la perte GIoU.
La longueur des extraits commence à 2 images et passe progressivement à 3, 4 puis 5 images au cours de l'entraînement. Selon les auteurs, cette augmentation progressive améliore l'efficacité et la stabilité de l'entraînement.
Quelques astuces d'entraînement
Dans les vraies vidéos, les apparitions de nouveaux objets et les départs d'anciens sont rares. Les auteurs créent davantage d'exemples avec deux opérations aléatoires :
- Avec une probabilité , supprimer au hasard certaines requêtes de piste, pour que les requêtes de détection puissent s'exercer à « trouver de nouveaux objets ».
- Avec une probabilité , insérer des requêtes de faux positifs parmi les requêtes de piste, pour que le modèle s'exerce à « faire sortir des objets qui n'existent pas ».
Par ailleurs, les images des extraits d'entraînement ne sont pas prises consécutivement, mais échantillonnées à intervalles aléatoires, pour simuler différentes fréquences d'images et des mouvements plus amples.
Face à TransTrack et TrackFormer, leurs contemporains, les auteurs soulignent que MOTR n'a besoin d'aucun post-traitement. TransTrack détecte des paires d'objets formant de courtes trajectoires sur deux images adjacentes, puis les relie en longues trajectoires par appariement IoU ; TrackFormer partage l'idée des requêtes de piste, mais n'apprend qu'entre deux images adjacentes, et a encore besoin d'une NMS des trajectoires et de caractéristiques re-ID pour filtrer les trajectoires en double. Les auteurs précisent aussi expressément que ce travail a commencé indépendamment, avant que TrackFormer et TransTrack ne paraissent sur arXiv.
Discussion
MOTR est entraîné sur 8 V100, avec un extrait de 5 images par lot. Sur MOT17, l'entraînement dure 200 epochs, sur l'ensemble d'entraînement de MOT17 et environ 5000 images fixes de l'ensemble de validation de CrowdHuman (transformées en pseudo-extraits par des décalages aléatoires, comme dans CenterTrack). Le petit côté des images d'entrée est ramené à 800, et l'inférence tourne à environ 7.5 FPS sur V100.
MOT17 : un résultat embarrassant
Sur l'ensemble de test de MOT17, MOTR obtient un HOTA de 57.8, un IDF1 de 68.6, un MOTA de 73.4 et 2439 changements d'identité (ID switches).
Face aux autres méthodes à base de Transformer, son IDF1 dépasse de 4.7 points ceux de TransTrack et de TrackFormer ; son HOTA dépasse de 3.7 points celui de TransTrack, et son MOTA est bien au-dessus des 65.0 de TrackFormer. Mais le MOTA de TransTrack (74.5) est plus élevé que celui de MOTR. Les auteurs supposent que TransTrack, qui sépare détection et suivi en deux branches, détecte mieux ; dans MOTR, les requêtes de détection sont étouffées par les requêtes de piste, ce qui limite la détection des nouveaux objets.
Face aux méthodes à base de CNN, c'est encore plus embarrassant. ByteTrack obtient un HOTA de 63.1, un MOTA de 80.3 et un IDF1 de 77.3, et MOTR perd sur chacun de ces points. Les auteurs écrivent sans détour dans l'article que MOTR est « frustratingly inferior ». Leur explication est que les scores sur MOT17 dépendent surtout de la qualité de la détection, et que chaque équipe utilise un détecteur différent ; il est donc difficile de comparer équitablement la modélisation du mouvement, et MOT17 ne suffit pas à évaluer complètement MOTR.
DanceTrack : à domicile
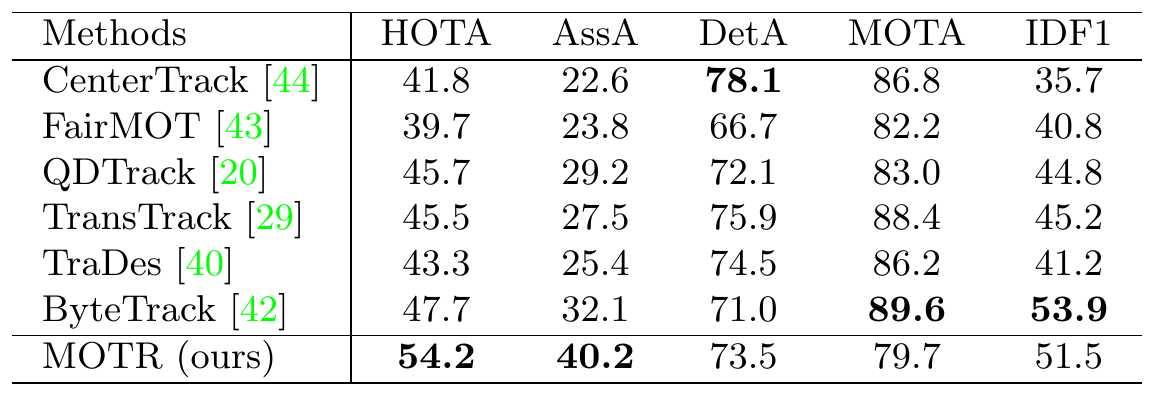
DanceTrack est un jeu de données de scènes de danse ; les danseurs sont habillés de façon similaire, font des mouvements complexes et se croisent sans arrêt. La détection n'y est pas difficile ; la difficulté est dans l'association.
Ici, MOTR obtient un HOTA de 54.2, 6.5 points de plus que les 47.7 de ByteTrack ; en AssA, c'est 40.2 contre 32.1, soit 8.1 points de plus. Mais son DetA de 73.5 est inférieur aux 78.1 de CenterTrack et aux 75.9 de TransTrack, et son MOTA de 79.7 est même le plus bas du tableau.
Ce tableau met très clairement côte à côte les forces et les faiblesses de MOTR. Un AssA élevé montre que les requêtes de piste ont bien appris à maintenir les identités d'une image à l'autre ; un DetA et un MOTA bas montrent qu'il trouve les objets moins bien que les autres méthodes. Cela rejoint exactement la note précédente sur HOTA, qui conseillait de jeter aussi un œil à DetA et AssA quand on regarde HOTA.
Sur l'ensemble de validation multi-classes de BDD100K, MOTR obtient un mMOTA de 32.0, avec 3493 changements d'identité, bien moins que les 8315 de la méthode de référence. Selon les auteurs, les méthodes fondées sur la re-ID ont du mal à gérer un grand nombre de classes et d'objets, alors que MOTR n'a qu'à modifier le nombre de classes de sa tête de classification pour faire du suivi multi-classes.
Ablations : que vaut chaque choix ?
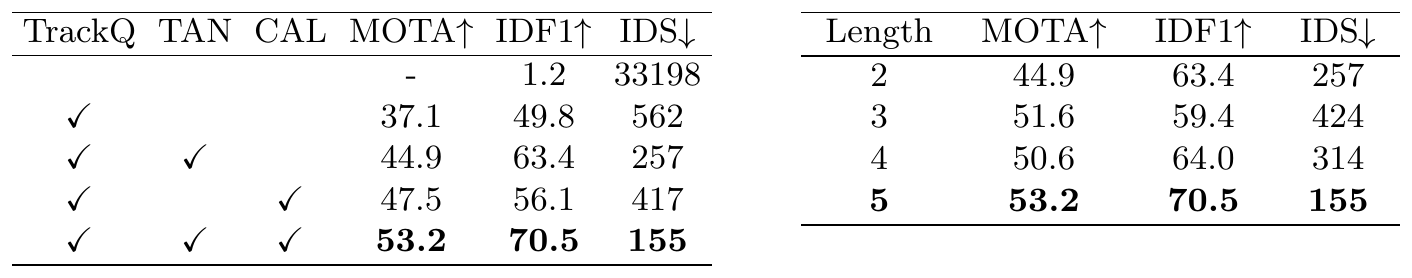
Les ablations sont entraînées sur l'ensemble d'entraînement de MOT17 et validées sur l'ensemble d'entraînement de MOT15.
Le tableau de gauche part de la version la plus rudimentaire. Avec des requêtes d'objet seules, sans requêtes de piste, les objets de chaque image sont traités comme de nouveaux objets ; on atteint 33 198 changements d'identité, et IDF1 n'est que de 1.2. Avec les requêtes de piste, IDF1 monte à 49.8 et les changements d'identité tombent à 562. Les requêtes de piste suffisent à elles seules à rendre le suivi possible.
TAN et CAL aident chacun de leur côté. TAN seul ajoute 7.8 points de MOTA et 13.6 points d'IDF1 ; CAL seul ajoute 10.4 points de MOTA. Avec les deux, on obtient un MOTA de 53.2, un IDF1 de 70.5 et 155 changements d'identité.
Le tableau de droite porte sur la longueur des extraits pour CAL. De 2 à 5 images, MOTA passe de 44.9 à 53.2, IDF1 de 63.4 à 70.5, et les changements d'identité baissent de 257 à 155. La progression n'est pas régulière ; à la longueur 3, IDF1 tombe même à 59.4 et les changements d'identité montent à 424, mais la longueur maximale, 5 images, est la meilleure sur les trois métriques. Les auteurs observent qu'un CAL sur plusieurs images réduit nettement les boîtes en double, les changements d'identité et les détections manquées dans les scènes avec occultation.
D'autres ablations portent sur les astuces d'entraînement. La probabilité de suppression aléatoire des requêtes de piste donne le meilleur résultat à 0.1 ; la probabilité d'insertion de requêtes de faux positifs donne le MOTA le plus élevé à 0.3, mais IDF1 baisse continuellement dès 0.1. Pour l'intervalle d'échantillonnage aléatoire à l'entraînement, 10 est la meilleure valeur, avec 155 changements d'identité ; les intervalles 3 et 5 en donnent respectivement 218 et 324, et l'intervalle 12 est de nouveau un peu moins bon. Selon les auteurs, un intervalle trop petit fait facilement tomber dans un optimum local, tandis qu'un intervalle trop grand ne permet pas d'apprendre des évolutions sur une aussi longue portée.
Les limites reconnues par les auteurs
À la fin de l'article, les auteurs citent deux limites. Premièrement, la détection des nouveaux objets est loin d'être satisfaisante, et le MOTA n'est pas assez bon. Les requêtes de détection sont étouffées pour qu'elles ne cherchent pas les objets déjà suivis, ce qui va peut-être contre la nature même des requêtes d'objet et limite la détection des nouveaux objets. Deuxièmement, les requêtes se transmettent séquentiellement d'une image à l'autre, ce qui limite l'efficacité de l'entraînement ; les auteurs ont essayé le décodage parallèle de VisTR, qui ne parvient pas à gérer la complexité du suivi multi-objets.
La suite
La première limite a vite trouvé une réponse. Un peu plus d'un an plus tard, la même équipe publie MOTRv2, qui injecte dans MOTR les détections d'un YOLOX préentraîné sous forme de requêtes à ancres ; la détection est confiée à un détecteur spécialisé, et MOTR se concentre sur l'association. Le conflit entre suivi de bout en bout et détection est ensuite devenu un thème récurrent de cette lignée ; des méthodes ultérieures comme MeMOTR et MOTIP se comparent toutes à la famille MOTR.
ByteTrack confirme, sous un autre angle, la situation de MOTR sur MOT17. Sur ce même MOT17, un bon détecteur et un jeu de règles d'appariement soigneusement conçu suffisent pour obtenir des scores hors de portée de MOTR.
Conclusion
MOTR étend les requêtes d'objet de DETR en requêtes de piste qui accompagnent les objets, attribue les étiquettes avec TALA, gère les entrées, les sorties et l'agrégation temporelle avec QIM, et s'entraîne avec une perte moyenne collective sur des extraits entiers. Il n'a besoin d'aucune règle d'appariement écrite à la main, du début à la fin, et sur DanceTrack, où l'association est difficile, son HOTA dépasse de 6.5 points celui de ByteTrack.
Le prix à payer se lit dans les colonnes DetA et MOTA. Requêtes de piste et requêtes de détection se partagent un même décodeur, et les nouveaux objets sont plus difficiles à trouver ; sur MOT17, où la détection domine les scores, il s'incline devant ByteTrack, pourtant bien plus simple.
Quant au « frustratingly inferior » de l'article, c'est sans doute la phrase la plus honnête de toute cette série d'articles.