Article original
Object-Centric Learning with Slot Attention
- Publication
- NeurIPS 2020Conférence
- Premier dépôt sur arXiv
- arXiv:2006.15055
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingslotattention2020,
  title = {{Object-Centric Learning with Slot Attention}},
  author = {Francesco Locatello and Dirk Weissenborn and Thomas Unterthiner and Aravindh Mahendran and Georg Heigold and Jakob Uszkoreit and Alexey Dosovitskiy and Thomas Kipf},
  year = {2020},
  eprint = {2006.15055},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2006.15055}
}
Cet article n'est pas un article de suivi.
S'il figure dans cette série, c'est que d'autres l'ont ensuite utilisé pour le suivi multi-objets. Avant d'en arriver là, il faut comprendre ce qu'il fait.
En 2020, une équipe de Google Brain propose Slot Attention. Dans la liste des auteurs, Thomas Kipf, auteur correspondant, est l'auteur de GCN, et l'un des encadrants, Alexey Dosovitskiy, publiera ViT quelques mois plus tard. La même année, DETR réécrit la détection en prédiction d'ensemble à l'aide d'un jeu de requêtes d'objet, que TrackFormer et MOTR transformeront plus tard en requêtes de piste. Slot Attention fait quelque chose d'assez proche de DETR, mais part d'une idée tout autre, puisqu'il se passe de toute annotation et laisse le modèle découper tout seul l'image en objets, un par un.
Définir le problème
La carte de caractéristiques extraite par un réseau convolutif est une représentation « distribuée ». Chaque position de la carte mélange les informations de tout ce qui se trouve autour ; combien d'objets contient l'image et où se trouve chacun, rien de cela n'est explicitement séparé.
Or beaucoup de tâches de raisonnement veulent en entrée un ensemble d'objets distincts, par exemple un cube rouge ici, un cylindre vert là. La simulation physique, les systèmes multi-agents, le raisonnement visuel fonctionnent tous à l'échelle de l'objet. Les auteurs appellent ce type de représentation une représentation centrée sur les objets (object-centric).
Le problème, c'est qu'il est difficile de l'obtenir à partir d'images brutes ; il faut en général de la supervision, ou une architecture conçue pour une tâche précise. Beaucoup de travaux sautent donc carrément cette étape, et prennent directement l'état des objets dans un simulateur ou un moteur de jeu.
Les approches existantes ont chacune leurs défauts :
- Les modèles de décomposition de scène non supervisés comme IODINE ou MONet doivent enchaîner plusieurs tours de « décoder, comparer à l'image d'origine, réencoder », et s'entraînent très lentement.
- Dans les réseaux de capsules, chaque capsule se spécialise dans une catégorie d'objets, et la généralisation échoue dès qu'une combinaison inédite se présente.
- Dans les méthodes de prédiction d'ensemble comme DETR ou Set Transformer, chaque requête a son propre jeu de paramètres appris. Si l'on entraîne avec 100 requêtes, on teste forcément avec 100.
Les auteurs veulent un module qu'on puisse brancher directement à la sortie d'un réseau convolutif. Il reçoit vecteurs de caractéristiques et produit « slots », chacun décrivant un objet ; tous les slots ont la même forme, n'importe lequel peut se lier à n'importe quel objet, et leur nombre peut changer au moment du test.
Résoudre le problème
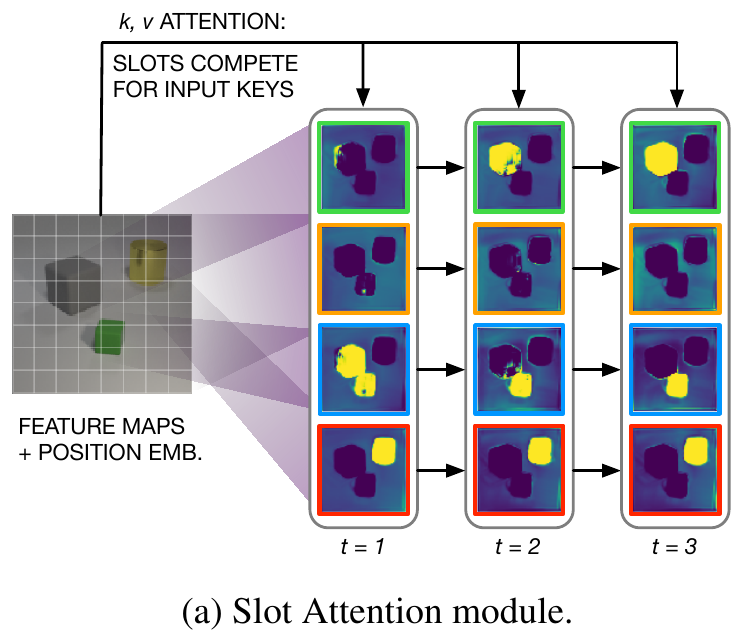
Cette figure se lit de gauche à droite. À gauche, la carte de caractéristiques en entrée ; à droite, ce que regarde chacun des quatre slots au fil des trois itérations. Au début, tout le monde voit flou ; plus on avance, plus chaque slot se concentre sur un seul objet.
Une itération
Au départ, les slots sont tirés au hasard dans une même loi gaussienne :
et sont des paramètres appris, partagés par tous les slots. C'est pour cela que le nombre de slots peut changer au moment du test ; on en tire autant qu'on veut.
On répète ensuite fois (l'article prend ). À chaque tour, trois projections linéaires transforment les entrées en clés et en valeurs , et les slots en requêtes , puis on calcule les scores d'une attention par produit scalaire :
Une attention ordinaire applique, pour chaque requête, une softmax dans la direction des entrées ; Slot Attention fait l'inverse et applique, pour chaque entrée, une softmax dans la direction des slots :
Autrement dit, chaque caractéristique d'entrée doit répartir son poids total de 1 entre les slots.
Chaque slot prend ensuite la moyenne pondérée des entrées qu'il a reçues, qui sert de contenu de mise à jour :
Enfin, un GRU prend le slot du tour précédent comme état et la mise à jour de ce tour comme entrée pour calculer le nouveau slot, puis vient un MLP résiduel facultatif. Entrées et slots passent par une LayerNorm au début de chaque tour.
Un calcul pour voir
Faisons tourner l'opération avec 4 entrées et 2 slots. Supposons que les scores obtenus soient :
| slot 1 | slot 2 | |
|---|---|---|
| Entrée 1 | 2.0 | 0.0 |
| Entrée 2 | 1.5 | 0.5 |
| Entrée 3 | 0.0 | 1.8 |
| Entrée 4 | 0.2 | 2.2 |
On applique une softmax à chaque ligne, et chaque entrée se répartit entre les deux slots :
| slot 1 | slot 2 | |
|---|---|---|
| Entrée 1 | 0.881 | 0.119 |
| Entrée 2 | 0.731 | 0.269 |
| Entrée 3 | 0.142 | 0.858 |
| Entrée 4 | 0.119 | 0.881 |
Le slot 1 récupère surtout les entrées 1 et 2, le slot 2 surtout les entrées 3 et 4. On normalise ensuite chaque colonne, et les poids de la moyenne pondérée du slot 1 sont 0.470, 0.390, 0.076 et 0.064, ceux du slot 2 0.056, 0.126, 0.403 et 0.414. Les deux slots se comportent comme deux centres de clusters, qui se sont partagé chacun un groupe d'entrées.
Pourquoi inverser la softmax ? Supposons que les deux slots soient identiques, avec la même requête ; les deux colonnes de scores valent alors 2.0, 1.5, 0.0, 0.2.
- Avec une attention ordinaire, qui applique la softmax sur les entrées, les deux slots reçoivent exactement les mêmes poids, 0.524, 0.318, 0.071, 0.087 ; tous deux fixent les entrées 1 et 2, et personne ne s'occupe des entrées 3 et 4.
- Avec la méthode de Slot Attention, chaque entrée se partage à égalité entre les deux slots, à raison de 0.5 chacun. Aucun ne peut prendre la part de l'autre, et les entrées 3 et 4 finissent forcément chez quelqu'un.
Chaque entrée doit être attribuée à un slot, ce qui met les slots en compétition : si l'un veut prendre un peu plus, les autres doivent prendre un peu moins. Après la mise à jour par le GRU et un nouveau tour, des écarts minimes au départ s'amplifient, jusqu'à ce que chaque slot se fixe sur un objet. Les ablations de l'annexe le confirment ; quand on remet la softmax sur les entrées, les résultats se dégradent nettement sur les deux tâches.
Et pourquoi une moyenne pondérée plutôt qu'une somme pondérée ? Parce que les scores sont normalisés sur les slots, la quantité totale reçue par chaque slot n'est pas fixe (1.873 et 2.127 dans l'exemple ci-dessus), et un slot qui n'a reçu aucun objet peut tendre vers 0. Avec une somme pondérée, l'amplitude des mises à jour varierait sans cesse ; avec une moyenne, l'entraînement reste stable.
Le coût de calcul de l'ensemble du module est en .
Symétries
Les auteurs démontrent deux propriétés de Slot Attention : invariance par rapport à l'ordre des entrées, équivariance par rapport à l'ordre des slots. Si l'on mélange les entrées, la sortie ne change pas ; si l'on mélange l'ordre des slots initiaux, la sortie est simplement mélangée de la même façon.
Cela garantit que chaque slot représente un objet sous le même format, et qu'il n'existe pas de « slot n° 1 chargé des cubes ». Il en va autrement des requêtes d'objet de DETR, où chaque requête a ses propres paramètres, et à force d'entraînement, chacune finit souvent par préférer certaines positions ou certaines tailles.
Deux usages
La découverte d'objets non supervisée. On place Slot Attention dans un autoencodeur. L'encodeur est un réseau convolutif avec embedding de position, suivi de Slot Attention ; le décodeur déploie chaque slot séparément en une image, avec une sortie RVB et un masque. Les masques de tous les slots passent par une softmax entre slots et servent de poids de mélange pour fusionner les images en une seule, dont on mesure l'erreur de reconstruction par rapport à l'image d'origine. Tout le processus se passe d'annotation.
La prédiction d'ensemble supervisée. Même encodeur ; chaque slot passe dans un MLP partagé qui prédit les attributs de l'objet. L'ordre des prédictions comme celui des étiquettes est arbitraire, donc l'algorithme hongrois fait l'appariement, comme dans DETR.
Discussion
Découverte d'objets
Les auteurs évaluent sur trois jeux de données synthétiques : CLEVR6 (scènes 3D CLEVR comptant jusqu'à 6 objets), Multi-dSprites (formes 2D colorées) et Tetrominoes (pièces de Tetris). La métrique est l'ARI, qui mesure l'accord entre la segmentation et les objets réels, fond exclu ; 100 correspond à un résultat parfait.
| Méthode | CLEVR6 | Multi-dSprites | Tetrominoes |
|---|---|---|---|
| Slot Attention | 98.8 | 91.3 | 99.5 |
| IODINE | 98.8 | 76.7 | 99.2 |
| MONet | 96.2 | 90.4 | — |
| Slot MLP | 60.4 | 60.3 | 25.1 |
D'après la Table 1 de l'article, ARI (%), moyenne sur cinq graines aléatoires. Pour Tetrominoes, un entraînement raté est exclu.
Slot MLP est une référence où Slot Attention est remplacé par un MLP, dont les slots de sortie ont un ordre fixe. Son score est bien plus bas, ce qui montre que le principe « tous les slots ont le même format et peuvent se lier à n'importe quel objet » est indispensable.
Slot Attention fait jeu égal avec IODINE ou mieux ; le vrai écart est dans l'efficacité. Sur CLEVR6, une V100 de 16 Go accepte une taille de lot de 64, contre 4 pour IODINE ; l'entraînement prend environ 24 heures sur 8 V100, contre environ 7 jours pour IODINE.
Les auteurs avouent aussi un mode d'échec. Sur Tetrominoes, il arrive qu'un entraînement reste coincé dans une solution qui découpe l'image en bandes horizontales, une fois sur cinq. Dans ce cas, l'erreur de reconstruction est nettement plus élevée, ce qui se voit dès l'entraînement ; le score du tableau exclut cet essai.
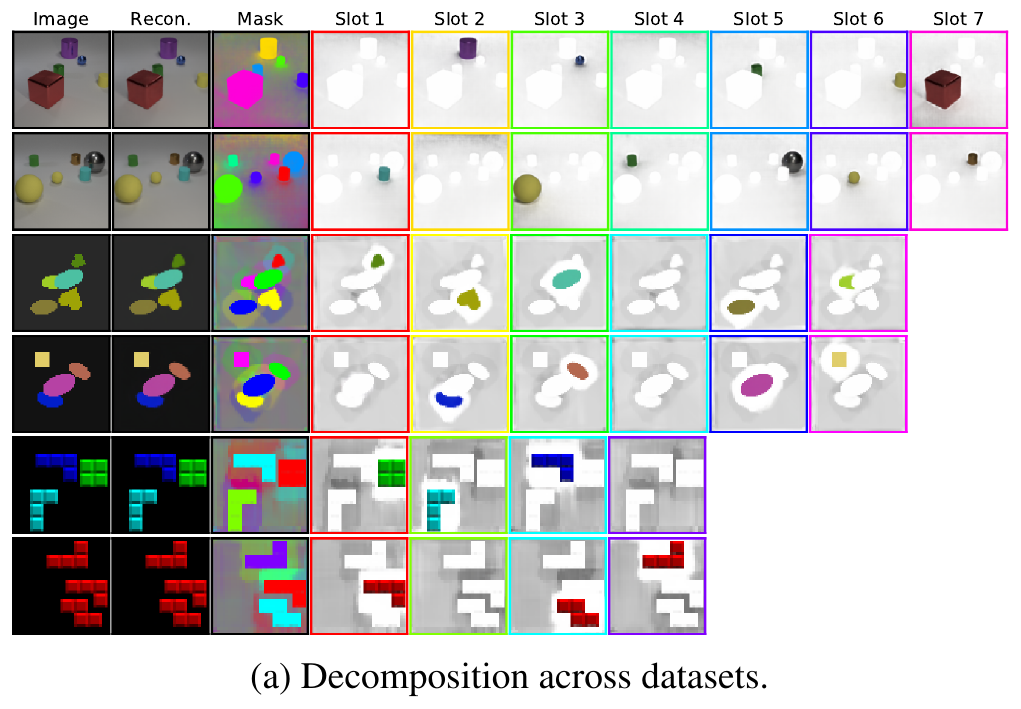
On voit sur cette figure que, quand il y a plus de slots que d'objets, les slots en trop restent vides et ne reçoivent qu'un peu de fond. Les auteurs constatent aussi qu'un fond uniforme est souvent dispersé sur tous les slots au lieu d'être concentré dans un seul ; la séparation et la reconstruction des objets n'en souffrent pas.
Si l'on trace l'attention à chaque itération, les slots commencent déjà au deuxième tour à se concentrer chacun sur un seul objet, alors qu'au premier tour, plusieurs objets peuvent encore se mélanger dans un même slot.
Plus d'itérations et plus d'objets qu'à l'entraînement
Entraîné avec 3 itérations, le modèle continue de progresser quand on passe à 7 itérations au test. Entraîné sur CLEVR6 et testé sur CLEVR10, qui compte jusqu'à 10 objets, avec un nombre de slots porté de 7 à 11, il segmente toujours très bien. C'est précisément l'avantage de la loi initiale partagée, et une conception comme celle de DETR, où chaque requête a ses propres paramètres, en est incapable.
Pour vérifier qu'il ne regroupe pas seulement par couleur, les auteurs testent aussi une version qui ne voit que la forme. Sur un Multi-dSprites binarisé, blanc sur fond noir, l'ARI est de 69.4, contre 64.8 pour IODINE ; sur CLEVR6 en niveaux de gris, il est de 98.5.
Prédiction d'ensemble
Sur CLEVR10, il s'agit de prédire la forme, la matière, la couleur, la taille et la position de chaque objet, avec l'AP comme mesure. Slot Attention fait jeu égal avec DSPN, la méthode précédente, ou mieux, alors que DSPN utilise un encodeur ResNet-34 plus profond. Augmenter le nombre d'itérations au test aide là aussi ; quand le modèle est entraîné sur des scènes de 6 objets et testé sur des scènes qui en comptent plus, l'AP ne baisse que lentement.
Cette tâche n'entraîne le modèle qu'à prédire des attributs, sans jamais lui fournir d'annotation de segmentation ; pourtant, les cartes d'attention des slots séparent naturellement les objets, avec un ARI de 78.0.
Ablations et limites
Dans les ablations de l'annexe, plusieurs choix de conception se révèlent utiles. La moyenne pondérée est plus stable que la somme pondérée ; l'embedding de position est indispensable pour prédire la position des objets ; une loi initiale partagée par tous les slots fait mieux, sur la tâche non supervisée, qu'un jeu de paramètres propre à chaque slot, et c'est aussi elle qui permet d'augmenter le nombre de slots au test ; il faut au moins deux itérations. Le nombre de slots n'a besoin que d'un plafond approximatif, sans devoir égaler exactement le nombre d'objets.
Les auteurs exposent aussi les limites. Toutes les expériences portent sur des données synthétiques contrôlées ; la découverte d'objets utilise le même décodeur et la même perte de reconstruction qu'IODINE, et devrait donc peiner tout autant face à des fonds et des textures complexes, ce qui demandera peut-être une perte perceptuelle ou une perte contrastive.
Conclusion
Par une toute petite modification, Slot Attention fait passer la softmax de l'attention du côté des entrées au côté des slots. Un jeu de slots identiques se retrouve en compétition, et chacun finit par revendiquer un objet de l'image. Avec la loi initiale partagée et la mise à jour par GRU, il décompose sans annotation des scènes synthétiques en objets, s'entraîne plusieurs fois plus vite qu'IODINE, et le nombre de slots comme le nombre d'itérations s'ajustent au moment du test.
La première piste que les auteurs citent dans leur conclusion, c'est la vidéo. Un peu plus d'un an plus tard, SAVi, signé lui aussi par Kipf et ses collègues, étend les slots à la vidéo en faisant des slots de l'image précédente les valeurs initiales de l'image suivante, si bien qu'un même objet reste tenu par le même slot d'une image à l'autre. Voilà qui ressemble déjà beaucoup à du suivi.
Encore un peu plus d'un an, et quelqu'un fait entrer pour de bon cette approche centrée sur les objets dans le suivi multi-objets.