Article original
MOT16: A Benchmark for Multi-Object Tracking
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:1603.00831
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingmot162016,
  title = {{MOT16: A Benchmark for Multi-Object Tracking}},
  author = {Anton Milan and Laura Leal-Taixe and Ian Reid and Stefan Roth and Konrad Schindler},
  year = {2016},
  eprint = {1603.00831},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1603.00831}
}
À force de lire des articles de suivi, on croise MOT16 et MOT17 presque partout. DeepSORT publie ses résultats sur MOT16, et les tableaux principaux de Tracktor, FairMOT, ByteTrack et BoT-SORT portent tous sur MOT17.
Cet article est leur point de départ.
En octobre 2014, des chercheurs de l'université d'Adélaïde, de l'ETH Zurich et de la TU Darmstadt mettent en ligne MOTChallenge. On y trouve un jeu de données commun, un programme d'évaluation centralisé et un classement où chacun peut soumettre ses résultats. La première version s'appelle MOT15 ; elle compte 11 vidéos d'entraînement et 11 vidéos de test. Au moment où cet article est écrit, 47 méthodes y ont déjà soumis des résultats, et plus de 180 utilisateurs se sont inscrits. C'est sur MOT15 que SORT a obtenu ses résultats.
Mais après plus d'un an d'usage, les problèmes de MOT15 apparaissent. Anton Milan, Laura Leal-Taixé et leurs collègues lancent donc une deuxième version, MOT16.
Définir le problème
Évaluer le suivi multi-objets est plus difficile qu'évaluer bien d'autres tâches de vision. Les auteurs en donnent trois raisons.
Premièrement, la bonne réponse elle-même est floue. Une personne en grande partie masquée est-elle une cible à suivre ? Et le reflet dans une vitrine, la personne sur une affiche, le mannequin ? Même des annotateurs humains peuvent ne pas être d'accord entre eux.
Deuxièmement, chaque indicateur raconte sa propre histoire. CLEAR MOT domine à l'époque, mais le seuil d'IoU qui décide qu'une « boîte prédite correspond à une boîte réelle » varie de 25 % à 50 % selon les articles ; les détails d'implémentation des programmes d'évaluation diffèrent aussi, et les résultats s'en ressentent fortement.
Troisièmement, il n'existe pas de séparation fixe entre entraînement et test. Prenons PETS 2009. Sur la séquence la plus simple, S2L1, avec de bonnes détections, la précision du suivi dépasse depuis longtemps 90 %. Mais chacun utilise un sous-ensemble, une méthode d'entraînement, un programme d'évaluation et des détections en entrée différents, si bien que les résultats ne sont pas vraiment comparables. Les auteurs posent la question sans détour : ces séquences sont-elles devenues trop faciles pour les méthodes actuelles ? Ou bien les méthodes font-elles simplement du surapprentissage, à moins que ce ne soit l'évaluation qui pose problème ?
MOTChallenge répond à ces questions avec des données communes, une évaluation centralisée et un classement public. Mais MOT15, la première version, a aussi ses défauts :
- Les règles d'annotation ne sont pas cohérentes. Les annotations de certaines séquences sont reprises telles quelles d'anciens jeux de données, avec des critères différents.
- La répartition de la densité de foule est déséquilibrée entre l'entraînement et le test.
- Certaines séquences sont trop simples et trop connues (PETS09-S2L1, par exemple), et les méthodes ont fini par les surapprendre.
- Les détections officielles sont trop mauvaises, au point que certains participants remplacent purement et simplement le détecteur.
Ce dernier point, l'article de SORT l'a déjà démontré. Il soutient que c'est justement en remplaçant les détections ACF officielles de MOT15 que ses résultats de suivi progressent fortement.
Résoudre le problème
MOT16 apporte des vidéos entièrement nouvelles, des règles d'annotation strictes et une méthode d'évaluation définie sans ambiguïté.
14 nouvelles vidéos
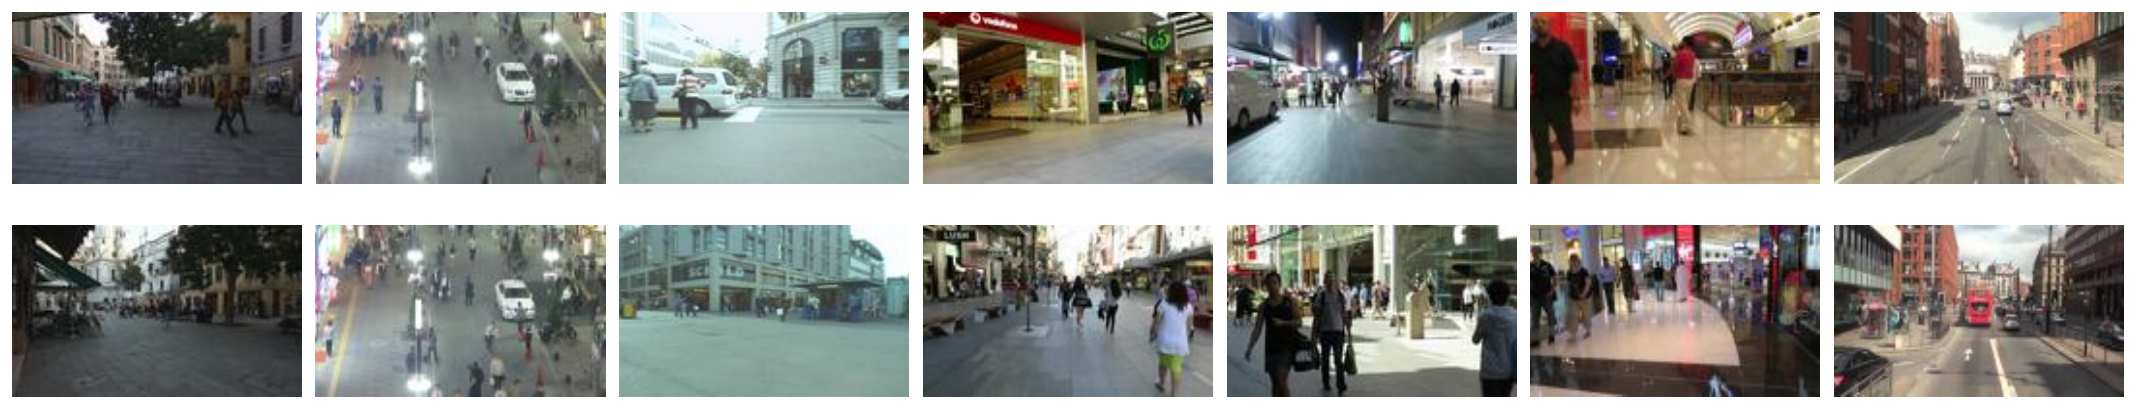
MOT16 compte 14 vidéos, moitié pour l'entraînement, moitié pour le test ; les annotations du test ne sont pas publiques. Par rapport à MOT15, il y a près de 3 fois plus de boîtes, et une densité de foule moyenne 3 fois plus élevée.
Ces vidéos ont été choisies délibérément très différentes :
- Caméra : fixe dans la scène, ou mobile, tenue à la main, posée sur une poussette ou montée sur une voiture.
- Point de vue : en plongée depuis une position élevée, à hauteur des piétons, ou en contre-plongée.
- Conditions : soleil (avec ombres et surexposition), temps couvert, nuit (beaucoup de flou de mouvement), intérieur.
- Fréquence d'images : 30 FPS le plus souvent, mais certaines vidéos sont à 25 ou 14 FPS.
D'après les statistiques de la Table 2 de l'article, le jeu d'entraînement compte 5 316 images, 512 trajectoires et 110 407 boîtes de piétons, soit 20.8 personnes par image en moyenne ; le jeu de test compte 5 919 images, 830 trajectoires et 182 326 boîtes de piétons, soit 30.8 personnes par image en moyenne.
Ces statistiques cachent un détail qui mérite l'attention. Dans le jeu de test, MOT16-03 est une foule filmée de nuit, vue d'en haut, avec 69.7 personnes par image en moyenne ; à elle seule, cette séquence contient 104 556 boîtes de piétons, soit 57 % de tout le jeu de test. Le MOTA est calculé sur l'ensemble des séquences mises bout à bout ; les performances sur cette seule séquence pèsent donc lourdement sur le score global.
Qui faut-il suivre ?
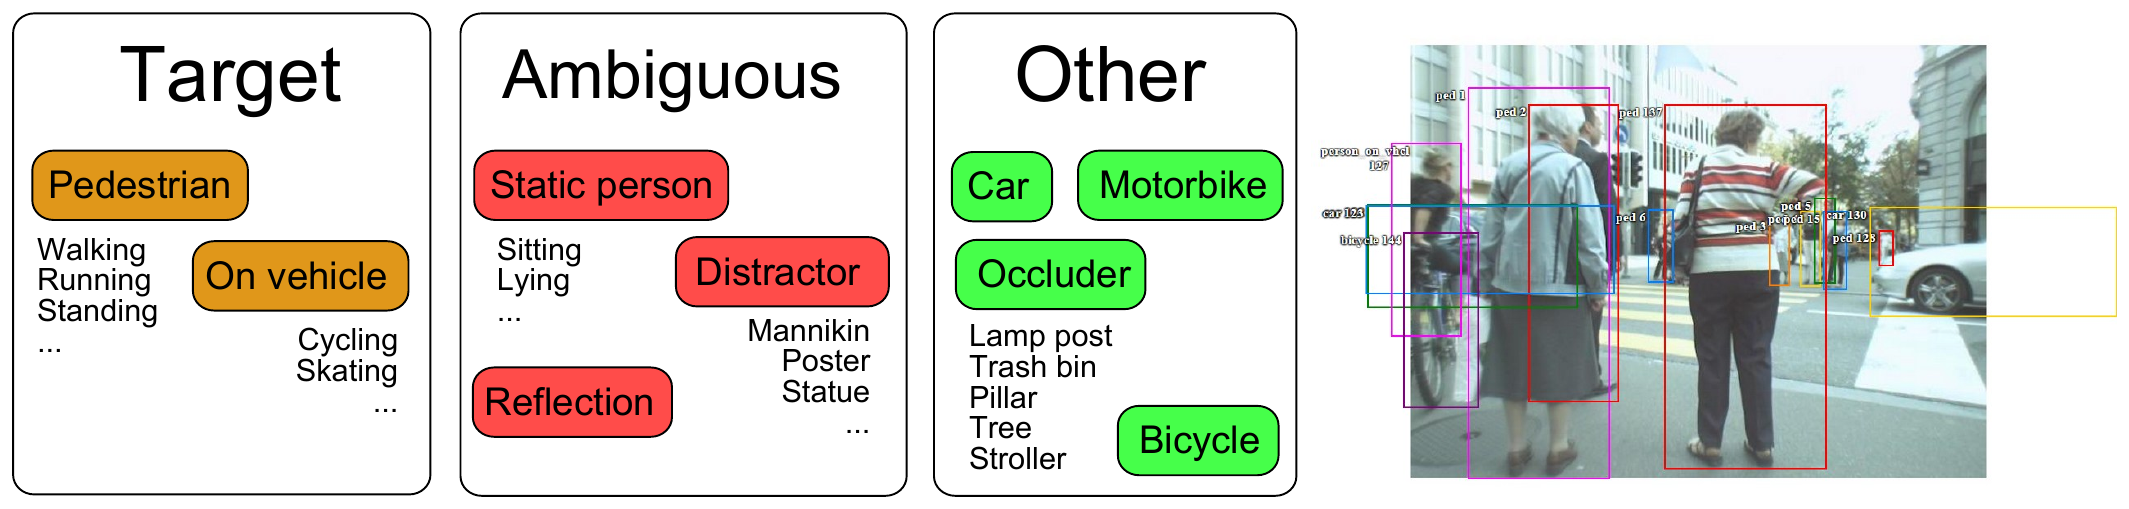
Toutes les séquences ont été entièrement réannotées par les chercheurs selon les mêmes règles, puis vérifiées de façon croisée. Le cœur de ces règles consiste à répartir « ce qui ressemble à une personne » en trois groupes :
- Cibles : toutes les personnes debout, qu'elles marchent, courent ou restent immobiles. C'est ce que le traqueur doit suivre.
- Catégories ambiguës : les personnes qui ne sont pas debout (assises, allongées), et toutes sortes de « doublures » humaines, comme les reflets, les affiches, les photos, les mannequins, ainsi que les personnes derrière une vitre.
- Autres : les véhicules en mouvement, motos, vélos et poussettes, ainsi que les obstacles comme les piliers ou les arbres.
Le deuxième groupe est l'idée la plus astucieuse de l'article. Un détecteur qui voit une personne sur une affiche risque fort de l'encadrer aussi ; si le traqueur suit sagement cette boîte, est-ce une erreur ? La réponse de MOT16, c'est que ces cas ne sont ni pénalisés ni récompensés. À l'évaluation, les boîtes prédites qui chevauchent à plus de 50 % un distracteur, une personne immobile, un reflet ou une personne sur un véhicule sont simplement retirées ; elles ne comptent pas comme faux positifs, et ne pas suivre ces cas ne compte pas non plus comme détection manquée.
Le troisième groupe ne participe pas à l'évaluation, mais ses annotations servent à l'entraînement, et aussi à calculer dans quelle mesure chaque piéton est masqué.
Les boîtes elles-mêmes obéissent à des règles :
- La boîte doit contenir tous les pixels de la personne, tout en restant aussi serrée que possible. Pour une personne qui marche de profil, la largeur de la boîte varie au rythme des pas ; pour les parties masquées, l'étendue complète est estimée à partir d'indices comme la taille de la personne, son ombre ou les images précédentes et suivantes ; pour une personne coupée par le bord de l'image, la boîte peut dépasser de l'image.
- On commence à annoter dès que la position est certaine, soit dès qu'environ 10 % de la personne est visible, et on s'arrête quand elle ne l'est plus.
- L'ID est conservé autant que possible. Tant que la personne reste dans l'image et que son trajet peut être déterminé clairement, elle garde le même ID ; quand elle est masquée, on continue à l'annoter tant qu'un raisonnement simple, comme la vitesse constante, suffit à fixer sa position. Si elle est masquée trop longtemps et que son trajet devient indéterminable, elle reçoit un nouvel ID à sa réapparition.
- Chaque boîte a une visibilité. Elle n'est pas annotée à la main ; elle est calculée automatiquement, de 0 à 1, à partir de l'hypothèse d'un plan de sol et de la position de toutes les boîtes.
Il reste enfin un « contrôle de cohérence », qui fait passer un détecteur de piétons sur toutes les vidéos et ajoute les personnes ou distracteurs détectés avec une confiance élevée mais oubliés dans les annotations.
Ces règles ont eu une influence profonde. L'analyse par visibilité que nous verrons dans Tracktor, et le problème des « boîtes qui dépassent de l'image » que CenterTrack et ByteTrack traitent à part, viennent tous de là.
Détections officielles et format des données
Les auteurs ont testé plusieurs détecteurs de piétons et fournissent finalement les détections de DPM v5 comme détections publiques officielles. La raison est que le R-CNN disponible à l'époque bat DPM sur toutes les classes sauf justement « personne » ; pour les piétons, il fait moins bien que DPM. Pour garder un rappel assez élevé, le seuil de détection est fixé très bas.
Toutes les annotations et détections sont des fichiers texte séparés par des virgules, une ligne par boîte ; les neuf champs sont, dans l'ordre, le numéro d'image, l'ID, les coordonnées x et y du coin supérieur gauche de la boîte, la largeur, la hauteur, le score de confiance (remplacé dans les fichiers d'annotation par un indicateur « à prendre en compte dans l'évaluation »), et les deux dernières colonnes, qui donnent dans les fichiers d'annotation la classe et la visibilité. Dans les fichiers de détection, l'ID vaut toujours −1, puisque rien n'a encore été suivi.
Ce format est toujours utilisé aujourd'hui. Quand vous voyez sur GitHub un traqueur écrire ses résultats ligne par ligne sous la forme frame,id,x,y,w,h,..., il y a neuf chances sur dix qu'il s'aligne sur MOTChallenge.
Comment l'évaluation est calculée
L'évaluation reprend CLEAR MOT (MOTA, MOTP) et les indicateurs de qualité des trajectoires proposés par Wu et Nevatia (MT, ML, FM). L'essentiel est de définir clairement chaque détail.
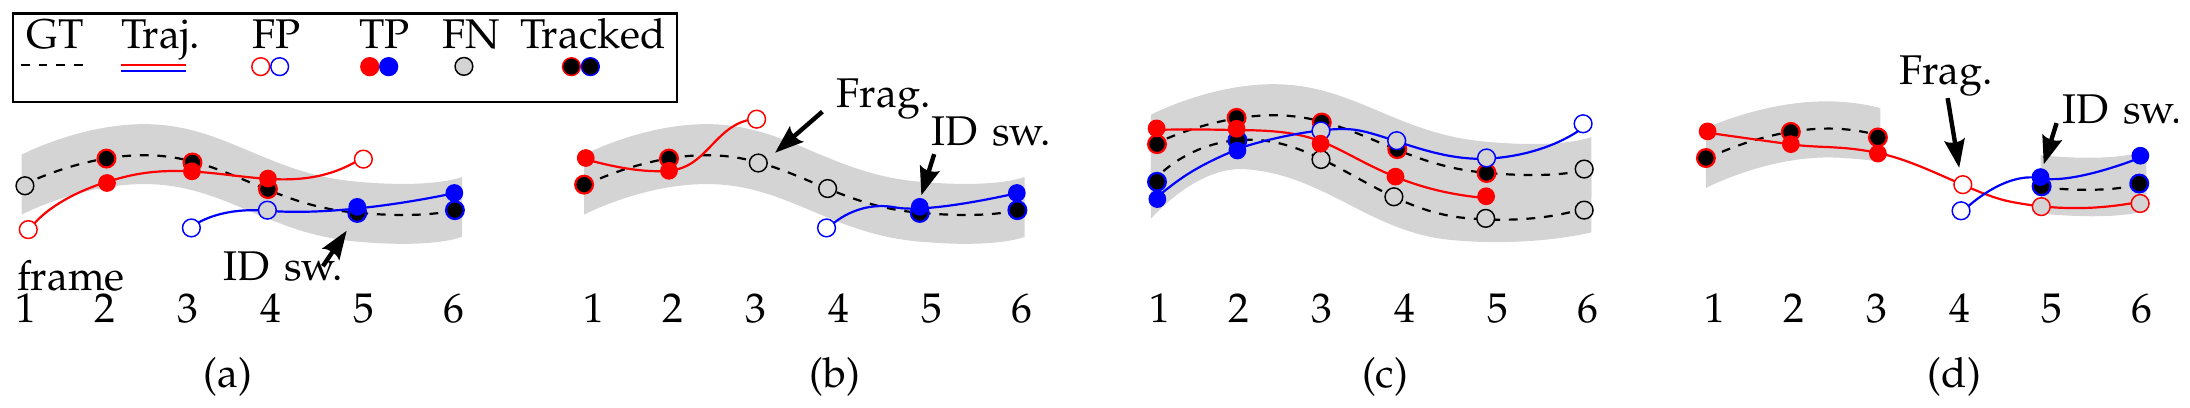
Appariement. À chaque image, l'algorithme hongrois apparie un à un les boîtes prédites et les boîtes réelles, avec un seuil d'IoU de 50 %. Mais l'appariement n'est pas fait indépendamment image par image. Si une cible réelle était appariée à la trajectoire à l'image précédente, et que sa distance à reste sous le seuil dans l'image actuelle, l'appariement est conservé, même si une autre boîte prédite est plus proche.
Changement d'identité. Si la trajectoire appariée à une cible réelle diffère de celle à laquelle elle était appariée la fois précédente, cela compte pour un changement d'identité (IDSW). Les auteurs précisent qu'une méthode qui suit deux fois plus de trajectoires aura naturellement plus de changements d'identité ; ils rapportent donc aussi un chiffre relatif, le nombre de changements d'identité divisé par le rappel.
Fragmentation. Quand une trajectoire réelle passe de « suivie » à « non suivie », puis est de nouveau suivie, cela compte pour une fragmentation (FM).
MOTA et MOTP. Le MOTA additionne les détections manquées, les faux positifs et les changements d'identité, divise par le nombre total de boîtes réelles, et soustrait le résultat de 1 ; il va de moins l'infini à 100 %, et peut être négatif s'il y a trop d'erreurs. Le MOTP est le chevauchement moyen de toutes les boîtes appariées ; les auteurs disent clairement qu'il reflète surtout la précision de localisation du détecteur, et en dit peu sur les performances du traqueur lui-même.
MT et ML. Une trajectoire réelle suivie pendant plus de 80 % de sa durée est dite « majoritairement suivie » ; en dessous de 20 %, « majoritairement perdue ». Ces deux indicateurs ne tiennent pas compte des changements d'ID.
Toutes les séquences de test sont calculées ensemble, et non séparément avant d'en faire la moyenne, car le nombre de personnes varie trop d'une séquence à l'autre.
Les auteurs exposent aussi franchement les limites de ces indicateurs. Le MOTA résume trois types d'erreurs en un seul nombre, ce qui facilite les comparaisons, mais « qu'il puisse servir seul d'unique indicateur est très discutable ». Les auteurs précisent aussi que cette évaluation ne traite pas la ré-identification. Une cible qui quitte l'image puis revient est traitée comme une nouvelle cible.
Discussion
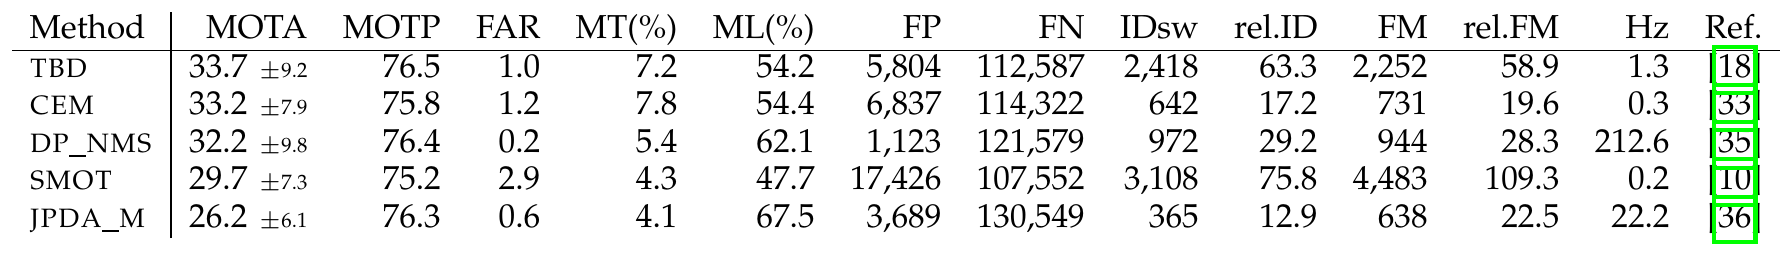
Les auteurs refont tourner, à partir du code publié par leurs auteurs, cinq méthodes courantes à l'époque ; elles couvrent le flot dans un réseau (DP_NMS), la minimisation d'énergie continue (CEM), la similarité de mouvement (SMOT), l'appariement en deux étapes (TBD) et une approximation de l'association probabiliste conjointe de données (JPDA_M).
Les auteurs expliquent aussi clairement comment les paramètres ont été réglés. En partant des valeurs par défaut suggérées par les auteurs de chaque méthode, chaque paramètre est tiré au hasard dans ; on fait 20 exécutions sur le jeu d'entraînement, on retient le jeu de paramètres au meilleur MOTA, et on ne l'exécute qu'une fois sur le jeu de test. Les auteurs précisent aussi que ces chiffres ne sont pas forcément les meilleures performances possibles de chaque méthode.
Trois points méritent l'attention :
- Tous les MOTA plafonnent un peu au-dessus de 30. Le meilleur, TBD, obtient 33.7, le moins bon, JPDA_M, 26.2.
- La plupart des gens sont perdus. Le ML de chaque méthode dépasse 47 %, et le FN dépasse cent mille partout. Autrement dit, les personnes que la détection n'a pas trouvées, le traqueur ne peut pas les rattraper, et les détections DPM officielles laissent passer beaucoup de monde.
- Un facteur mille sur la vitesse. DP_NMS tourne à 212.6 images par seconde, SMOT à seulement 0.2. Entre des méthodes de précision comparable, la vitesse peut varier à ce point.
En comparant ce tableau aux articles qui ont suivi, on voit l'ampleur de l'effet du détecteur. Un an plus tard, DeepSORT, avec des détections privées de bien meilleure qualité, obtient un MOTA de 61.4 sur ce même jeu de test MOT16 ; quelques années après, FairMOT atteint 74.9. Les méthodes de suivi ont bien sûr progressé, mais dans ce bond d'un peu plus de 30 à plus de 70 points, l'essentiel du mérite revient au détecteur.
La suite
En 2017, MOTChallenge lance MOT17. Les vidéos sont exactement celles de MOT16, mais les annotations ont été corrigées une nouvelle fois, et les détections officielles passent d'un seul jeu, DPM, à trois, DPM, Faster R-CNN et SDP ; les participants doivent faire tourner leur méthode une fois avec chacun, puis faire la moyenne des résultats. La catégorie « public detection » que nous verrons dans Tracktor se dispute avec cette configuration.
En 2020, MOT20 pousse la densité de foule à l'extrême ; d'après les statistiques de l'article de ByteTrack, son jeu de test compte en moyenne 170 personnes par image. La même année, Leal-Taixé et d'autres responsables de MOTChallenge participent à la proposition de HOTA, qui répond officiellement à cette phrase de l'article, « que le MOTA puisse servir seul d'unique indicateur est très discutable ».
Conclusion
MOT16 a donné au suivi multi-objets 14 nouvelles vidéos, des règles d'annotation refaites de zéro et une méthode d'évaluation qui définit clairement l'appariement, les changements d'identité et les fragmentations. Son idée la plus fine consiste à ranger les reflets, les affiches et les personnes assises dans des catégories ambiguës « ni pénalisées ni récompensées », pour que le traqueur ne perde pas de points à cause d'une réaction légitime du détecteur.
La prochaine fois que vous verrez des chiffres MOT17 dans le tableau d'un article, demandez-vous d'abord s'il s'agit de détections publiques ou de leurs propres détections. Puis réfléchissez à la part que pèse, dans le MOTA du jeu de test, la foule nocturne de MOT16-03.
Quant à savoir qui il faut suivre, dix ans plus tard, on s'en remet toujours à la réponse de cet article.