Article original
Simple Online and Realtime Tracking with a Deep Association Metric
- Publication
- ICIP 2017Conférence
- Premier dépôt sur arXiv
- arXiv:1703.07402
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingdeepsort2017,
  title = {{Simple Online and Realtime Tracking with a Deep Association Metric}},
  author = {Nicolai Wojke and Alex Bewley and Dietrich Paulus},
  year = {2017},
  eprint = {1703.07402},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1703.07402}
}
SORT réduit le traqueur au filtre de Kalman, à l'IoU et à l'algorithme hongrois ; il est très rapide, et son MOTA n'a pas à rougir. Mais son nombre de changements d'identité (ID switch) est toujours resté peu flatteur.
La cause n'est pas difficile à deviner. SORT ne connaît que la position et la taille des boîtes ; un objet masqué pendant deux images, et sa trajectoire est supprimée. Quand il réapparaît, le traqueur n'a aucun indice pour savoir qu'il « a déjà vu cette personne », et il n'a plus qu'à lui donner un nouvel ID.
Un an plus tard, Alex Bewley, l'auteur de SORT, comble ce manque avec Nicolai Wojke et Dietrich Paulus, de l'université de Coblence-Landau, en Allemagne. Ils s'y prennent de la façon la plus directe, en faisant en sorte que le traqueur se souvienne de l'apparence de chaque personne.
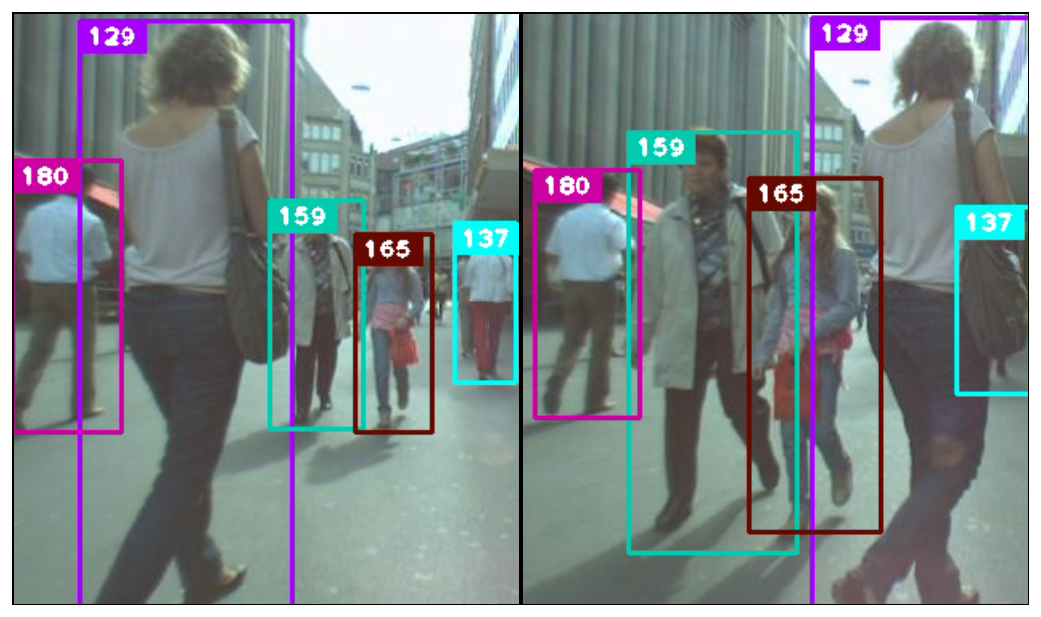
Voici la sortie de DeepSORT sur MOT16. Entre les deux images, les gens se croisent ; au premier plan, 129 passe du milieu de l'image vers la droite et masque 137, derrière ; au loin, 159 et 165 se rapprochent, et leurs boîtes deviennent plusieurs fois plus grandes. Les numéros des cinq personnes n'ont pas changé.
L'article ne fait que cinq pages, mais il est devenu pendant plusieurs années le traqueur le plus utilisé, et le « Deep » de son nom est souvent mal compris. Prenons le temps de le lire.
Définir le problème
Les auteurs commencent par chercher la cause des changements d'identité de SORT. SORT apparie les boîtes prédites et les boîtes de détection par leur IoU, et cette mesure n'est fiable que si l'estimation d'état est précise.
Dès qu'un objet est masqué, le filtre de Kalman ne peut plus que prédire, sans mise à jour ; la boîte prédite dérive de plus en plus, et ne chevauche plus la boîte de détection quand l'objet réapparaît. Dans les scènes de rue filmées de face, les piétons se masquent constamment les uns les autres ; SORT perd donc sans cesse le fil et redistribue des ID.
Pour régler cela, il faut un indice encore utilisable quand la position n'est plus fiable. Les auteurs choisissent l'apparence. Ils utilisent un réseau convolutif entraîné sur un grand jeu de données de ré-identification de personnes (person re-identification, re-ID) pour transformer chaque boîte de détection en vecteur de caractéristiques. Les caractéristiques d'une même personne à différents moments doivent être proches, celles de personnes différentes éloignées.
La conception reste fidèle à l'esprit de SORT, avec toute la complexité reléguée à l'étape hors ligne. Le réseau est entraîné à l'avance ; pendant le suivi en ligne, il n'y a que des recherches du plus proche voisin, sans aucun apprentissage en ligne.
Résoudre le problème
État et gestion des trajectoires
Le cadre du filtre de Kalman reprend dans les grandes lignes celui de SORT, mais l'état passe à huit dimensions :
est le centre de la boîte, le rapport largeur/hauteur, la hauteur, et les quatre derniers termes les vitesses correspondantes. Par rapport à SORT, l'aire est remplacée par la hauteur, et le rapport largeur/hauteur a désormais sa propre vitesse. Les de la boîte de détection servent directement d'observation.
Chaque trajectoire tient un compteur , le nombre d'images écoulées depuis son dernier appariement réussi. Il augmente de un à chaque prédiction, et revient à zéro à chaque appariement réussi. S'il dépasse la limite , on considère que l'objet a quitté la scène, et la trajectoire est supprimée.
Les trois premières images d'une nouvelle trajectoire sont une « période d'essai » (tentative). Pendant ces trois images, chaque appariement doit réussir, sinon la trajectoire est supprimée d'office ; ce n'est qu'après ces trois images qu'elle passe à l'état confirmé (confirmed).
Le de SORT valait 1 ; ici, vaut 30 dans les expériences. Une trajectoire peut survivre à une seconde entière de disparition, à condition d'être reconnue à son retour.
Deux distances
L'appariement reste un problème d'affectation, mais la matrice de coût combine désormais deux distances.
La première est la distance de Mahalanobis (Mahalanobis distance), qui décrit le mouvement :
sont la moyenne et la covariance de la distribution prédite de la -ième trajectoire, projetée dans l'espace d'observation, et est la -ième boîte de détection. Contrairement à l'IoU, la distance de Mahalanobis tient compte de l'incertitude : elle mesure à combien « d'écarts types » du centre prédit se trouve la boîte de détection.
Cette distance permet d'exclure les appariements impossibles. L'espace d'observation a quatre dimensions ; le carré de la distance de Mahalanobis suit donc une loi du khi-deux à 4 degrés de liberté. On prend comme seuil l'intervalle de confiance à 95 %, , au-delà duquel l'appariement est interdit.
La seconde est la distance d'apparence. Chaque boîte de détection passe dans le réseau et donne une caractéristique de norme unité ; chaque trajectoire conserve les caractéristiques de ses 100 derniers appariements réussis, qui forment une galerie . La distance d'apparence est la distance cosinus entre la caractéristique de la détection et la plus ressemblante de la galerie :
L'intérêt du minimum, c'est qu'une personne qui se retourne ou passe dans l'ombre reste reconnaissable, du moment que la galerie contient une caractéristique prise sous un angle proche. La distance d'apparence a aussi son propre seuil , fixé sur des données d'entraînement séparées ; le code officiel utilise 0.2 par défaut.
Les deux se combinent pour donner le coût final :
Et un appariement n'est admissible que s'il passe les deux seuils à la fois.
Les auteurs décrivent clairement la répartition des rôles. La distance de Mahalanobis convient à la prédiction à court terme ; elle est surtout utile quand l'objet vient d'être vu et que sa position est sûre. La distance d'apparence convient pour retrouver une identité après une longue occultation, quand l'information de mouvement n'est plus très discriminante.
Vient ensuite un détail souvent négligé. Dans les expériences, les auteurs fixent à 0.
Autrement dit, il ne reste que la distance d'apparence dans la matrice de coût, et la distance de Mahalanobis ne sert plus que de seuil, pour écarter les appariements impossibles du point de vue de la position. Les auteurs expliquent que, lorsque la caméra bouge nettement, les déplacements dans le plan de l'image varient beaucoup, et la prédiction du filtre de Kalman n'est qu'une estimation grossière. Beaucoup de tutoriels décrivent DeepSORT comme une « somme pondérée de la position et de l'apparence », mais pour ses résultats, l'article utilise en réalité « l'apparence pour classer, le mouvement pour filtrer ».
La cascade d'appariement
Plutôt que de mettre toutes les trajectoires et toutes les boîtes de détection dans un seul problème d'affectation, les auteurs conçoivent une cascade (matching cascade).
Pourquoi ? Le problème vient de la distance de Mahalanobis elle-même. Faisons le calcul une fois en une dimension (les chiffres sont choisis pour l'exemple).
Supposons que la trajectoire A ait été vue à l'image précédente, avec une position prédite à 100 et un écart type de 5 ; la trajectoire B est masquée depuis une bonne dizaine d'images, avec une position prédite à 120, mais faute de mise à jour, son écart type a gonflé jusqu'à 30. Une boîte de détection apparaît à 108.
- Pour A, la boîte est à 8 de distance, soit écart type ; le carré de la distance de Mahalanobis vaut 2.56.
- Pour B, la boîte est à 12 de distance, soit seulement écart type ; le carré de la distance de Mahalanobis vaut 0.16.
A, plus proche et dont l'état est plus sûr, perd pourtant.
Intuitivement, plus une trajectoire est restée longtemps invisible, moins on devrait être sûr qu'elle a un lien avec une boîte de détection quelconque, et plus la distance devrait grandir. Mais la distance de Mahalanobis prend l'écart type pour unité ; plus l'incertitude est grande, plus toute boîte de détection paraît « proche ». Quand deux trajectoires se disputent la même boîte, elle avantage la plus incertaine.
La cascade traite les trajectoires par couches, selon le temps depuis lequel elles n'ont pas été vues :
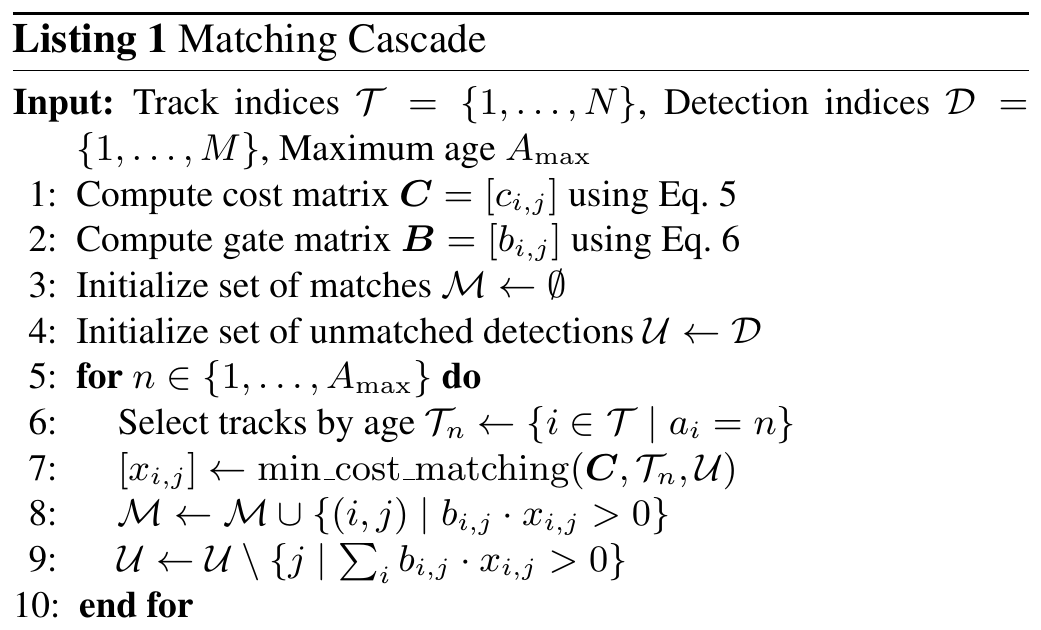
La boucle de la ligne 5 commence à ; elle traite d'abord les trajectoires appariées à l'image précédente, qui choisissent leurs boîtes de détection en premier ; les boîtes restantes passent ensuite aux trajectoires , et ainsi de suite jusqu'à . Dans l'exemple ci-dessus, A prend la boîte de détection dès la première couche, et B n'a même pas son tour.
Une dernière étape suit la cascade. Les trajectoires en période d'essai, ainsi que les trajectoires d'âge restées sans appariement, passent par un appariement IoU à la manière de SORT avec les boîtes de détection restantes. Cette étape gère les changements d'apparence soudains, par exemple quand une personne est à moitié masquée par un objet immobile ; elle donne aussi une chance de continuer aux trajectoires toutes neuves, dont la galerie d'apparence est encore maigre.
Le réseau d'apparence
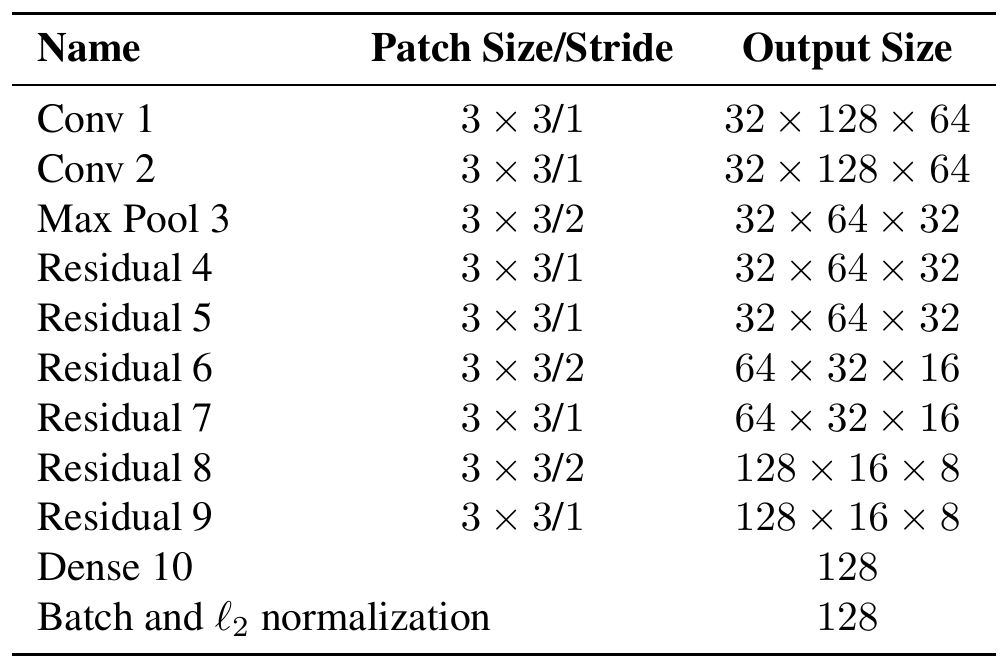
Le réseau est un réseau résiduel large, avec deux couches de convolution, six blocs résiduels et une dernière couche entièrement connectée qui produit 128 dimensions. La normalisation par lots et la normalisation L2 finales projettent les caractéristiques sur la sphère unité ; le produit scalaire de deux caractéristiques est alors leur similarité cosinus, ce qui correspond exactement à la distance d'apparence vue plus haut.
Le réseau compte environ 2 800 000 paramètres ; sur un GPU portable GTX 1050, il traite 32 boîtes en environ 30 millisecondes. Les données d'entraînement sont celles du jeu de ré-identification de piétons MARS, plus de 1 100 000 images de 1 261 personnes.
L'article ne détaille pas l'entraînement ; les auteurs disent que cela sort de leur cadre. La documentation du code officiel renvoie à la méthode de cosine metric learning d'un autre de leurs articles, publié l'année suivante.
Discussion
Les auteurs évaluent la méthode sur le jeu de test MOT16. MOT16 compte sept vidéos de test, avec des scènes de rue filmées de face par une caméra mobile, mais aussi des images de vidéosurveillance en plongée.
Les détections sont celles de Faster R-CNN publiées par Yu et al. (les auteurs de la méthode POI) ; entraînées sur des données publiques et privées, elles sont de bien meilleure qualité que les détections publiques officielles. Par souci d'équité, les auteurs refont tourner SORT avec les mêmes détections. Les réglages sont , , et un seuil de 0.3 sur le score de confiance des détections.
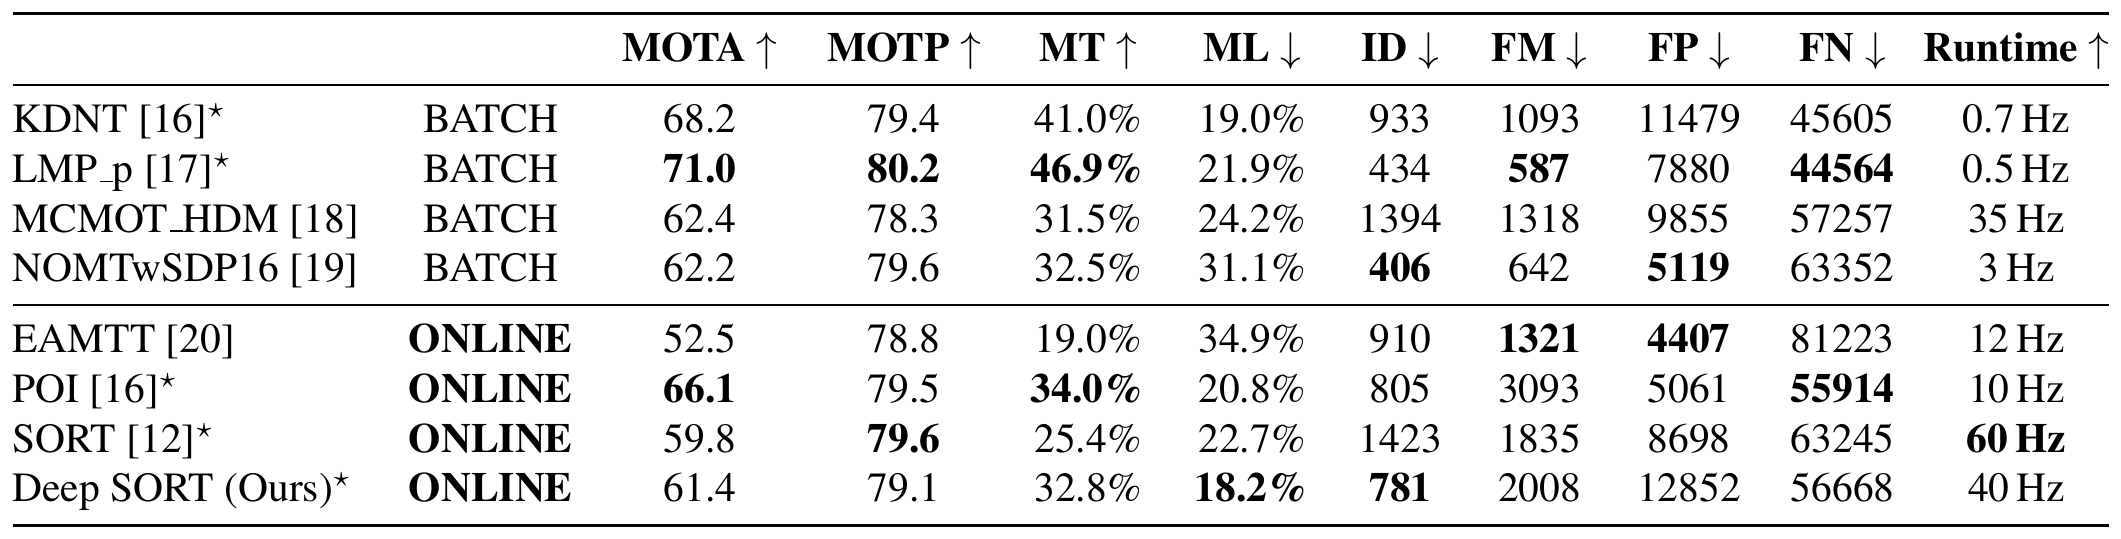
Dans ce tableau, toutes les méthodes marquées d'un astérisque utilisent les mêmes détections POI. Comparons d'abord les lignes SORT et Deep SORT, car ce sont les seules dont la différence tient uniquement au traqueur :
- Les changements d'identité passent de 1423 à 781, soit environ 45 % de moins. C'est le principal gain apporté par l'apparence, et c'est aussi le plus petit nombre du groupe online.
- MT passe de 25.4 % à 32.8 %, ML baisse de 22.7 % à 18.2 %. Les identités tiennent plus longtemps ; il y a plus de trajectoires suivies la majeure partie du temps, et moins de trajectoires presque entièrement perdues.
- FM passe de 1835 à 2008. Selon les auteurs, les trajectoires survivent désormais aux occultations et aux détections manquées, et les quelques images vides au milieu comptent pour une fragmentation.
- FP passe de 8698 à 12852. C'est la raison principale pour laquelle le MOTA ne monte que de 59.8 à 61.4.
Ce dernier point mérite qu'on s'y arrête. En examinant les sorties, les auteurs constatent que la plupart des faux positifs supplémentaires viennent de réponses sporadiques du détecteur sur le décor immobile. Avec , les trajectoires vivent longtemps, et ces faux positifs isolés finissent rattachés à des trajectoires, ce qui forme de fausses trajectoires stables, plantées sur place. Les auteurs observent aussi que les trajectoires sautent rarement d'un faux positif à l'autre. Autrement dit, ces faux positifs font surtout baisser le MOTA, et nuisent peu au maintien des identités. Relever le seuil de détection pourrait améliorer nettement le MOTA, mais l'article ne rapporte pas ce résultat.
Face à la méthode POI, qui utilise les mêmes détections POI, Deep SORT a un MOTA inférieur de près de 5 points, un peu moins de changements d'identité (781 contre 805), et une vitesse plusieurs fois supérieure.
Côté vitesse, le tableau indique 40 Hz ; dans le texte, les auteurs disent que l'implémentation complète tourne à environ 20 Hz, dont près de la moitié du temps passe à calculer les caractéristiques d'apparence. Dans les deux cas, le détecteur lui-même n'est pas compté.
La suite
Avec son code simple et son réseau de caractéristiques interchangeable, DeepSORT est vite devenu un équipement standard des projets d'ingénierie. MATLAB en propose un exemple officiel, et les projets GitHub qui combinent « YOLO + DeepSORT » ne se comptent plus.
Cinq ans plus tard, StrongSORT le prend comme point de départ d'une rénovation ; il remplace le réseau d'apparence et le filtre de Kalman, et retire aussi la cascade d'appariement pour revenir à une seule affectation globale. Les ablations de StrongSORT montrent que la cascade aide les traqueurs faibles en réduisant les appariements erronés ; une fois le traqueur renforcé, elle devient au contraire un carcan. Dans le tableau de StrongSORT, le DeepSORT d'origine perd 1.1 point d'IDF1 quand on remplace la cascade par un appariement ordinaire ; à mesure que le traqueur est renforcé, retirer la cascade rapporte de plus en plus, et les deux versions les plus fortes gagnent respectivement 1.8 et 1.4.
La conception de DeepSORT tient toujours ; c'est le problème que traitait la cascade (les trajectoires incertaines avantagées par la distance de Mahalanobis) qui devient moins grave quand les caractéristiques d'apparence sont assez fortes et que la matrice de coût n'est plus dominée par la distance de Mahalanobis.
Conclusion
Un réseau d'apparence entraîné hors ligne, plus une cascade d'appariement qui traite les trajectoires par couches selon leur âge, suffisent à réduire de 45 % les changements d'identité sur MOT16. Les trajectoires survivent à une seconde entière de disparition, et le suivi lui-même tourne toujours à plusieurs dizaines d'images par seconde.
Son « Deep » ne concerne que les caractéristiques d'apparence. Le modèle de mouvement, l'appariement et la gestion des trajectoires restent des règles écrites à la main ; passer à un meilleur réseau de re-ID est donc en général la mise à niveau la moins chère.
Ah, et si vous utilisez DeepSORT pour suivre autre chose que des piétons, pensez à remplacer le réseau de caractéristiques entraîné sur MARS. Il reconnaît plus d'un millier de piétons, mais pas vos camions.