Article original
Tracking without bells and whistles
- Publication
- ICCV 2019Conférence
- Premier dépôt sur arXiv
- arXiv:1903.05625
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingtracktor2019,
  title = {{Tracking without bells and whistles}},
  author = {Philipp Bergmann and Tim Meinhardt and Laura Leal-Taixe},
  year = {2019},
  eprint = {1903.05625},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1903.05625}
}
Les articles de suivi multi-objets deviennent de plus en plus compliqués. Modèles graphiques, multicoupes, champs aléatoires conditionnels, modèles de forces sociales, les optimisations globales sophistiquées se succèdent.
Pourtant, en deux ans, le MOTA sur MOT16 n'a progressé que de 2.4 points.
Philipp Bergmann, Tim Meinhardt et Laura Leal-Taixé, de l'université technique de Munich, veulent essayer une autre direction. Leal-Taixé compte aussi parmi les fondateurs de MOTChallenge et connaît ce classement mieux que personne. Ils retirent du suivi tout ce qui lui est spécifique, ne gardent qu'un détecteur, et regardent jusqu'où on peut aller.
Résultat, ce traqueur « sans fioritures » dépasse en MOTA toutes les méthodes publiées à l'époque, dans la catégorie public detection des trois benchmarks MOTChallenge.
Voilà qui intrigue. Si un détecteur suffit à résoudre l'essentiel du suivi, quel problème les algorithmes de suivi spécialisés résolvent-ils au juste ?
Définir le problème
SORT et DeepSORT, que nous avons déjà lus, découpent tous deux le suivi en deux étapes indépendantes. Le détecteur trouve les boîtes dans chaque image séparément, puis le traqueur s'efforce de les relier. Pour les relier, il faut prédire où l'objet sera à l'image suivante, juger si deux boîtes correspondent à la même personne, et gérer en plus les occultations, les détections manquées et les faux positifs.
Chacun de ces sous-problèmes a engendré toute une famille de méthodes. Mais les auteurs remarquent qu'un détecteur d'objets contient déjà un composant qui « prédit la position ».
Prenons Faster R-CNN. Il génère d'abord un grand nombre de boîtes candidates avec son réseau de propositions de régions (RPN), puis fait deux choses pour chacune : la tête de classification juge s'il y a une personne dans la boîte, et la tête de régression ajuste la boîte pour qu'elle épouse l'objet.
Le travail de la tête de régression, c'est précisément « on te donne une boîte approximative, corrige-la vers la vraie position de l'objet ».
Et si on lui donnait la boîte de l'image précédente ?
Tant que l'objet bouge peu entre deux images, la boîte de l'image précédente encadre encore à peu près la même personne dans l'image actuelle, et la tête de régression la tire vers la nouvelle position de cette personne. L'ID de la boîte est conservé tel quel, et la trajectoire s'allonge d'une image.
Pas besoin de filtre de Kalman, ni d'algorithme hongrois.
Résoudre le problème
Les auteurs appellent ce traqueur Tracktor ; il utilise un Faster R-CNN entraîné sur les données de détection de piétons de MOT17Det, avec un backbone ResNet-101 et un FPN.
Le processus ne compte que deux étapes. Suivons la figure de l'article pour voir ce qui se passe à l'image :
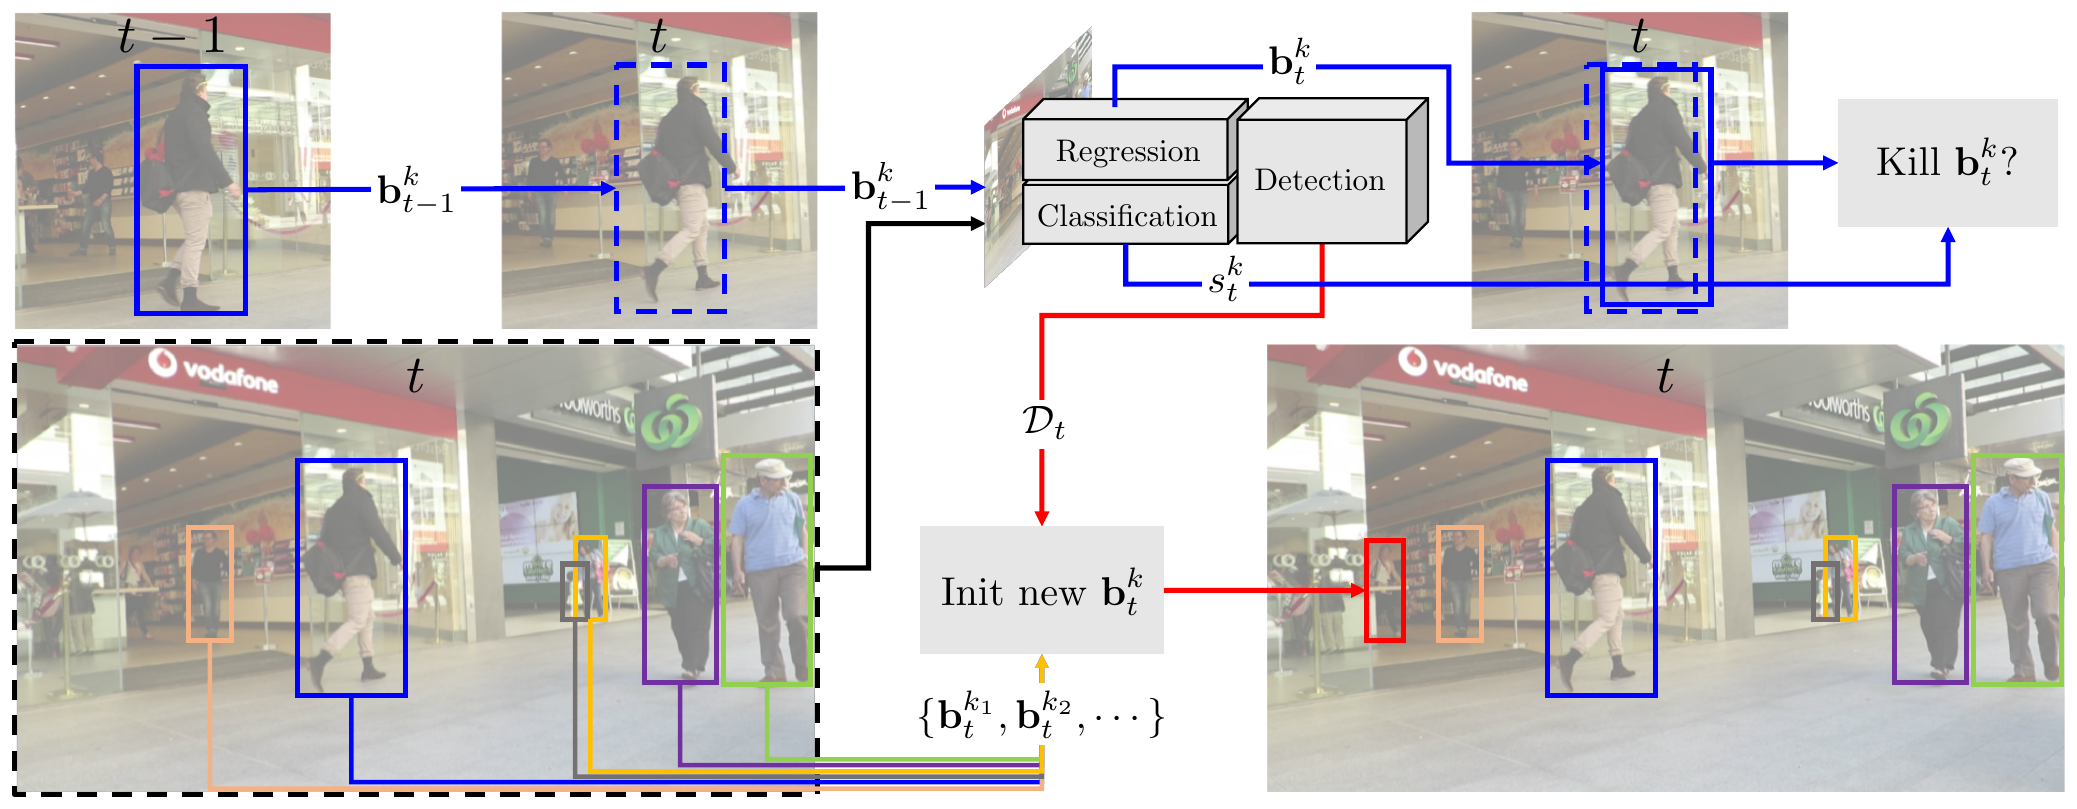
Première étape : la régression pousse l'ancienne boîte vers la nouvelle position
Regardons d'abord le piéton vêtu de sombre, en haut à gauche. À l'image , sa boîte est .
À l'image , Tracktor pose ces mêmes coordonnées sur la nouvelle image ; c'est la boîte bleue en pointillés de la figure. Le piéton a un peu avancé, et la boîte en pointillés ne l'encadre plus tout à fait.
Ensuite, Faster R-CNN fait un RoI pooling sur la carte de caractéristiques de l'image avec cette boîte en pointillés, exactement comme pour une boîte candidate ordinaire, et l'envoie dans les têtes de régression et de classification. La tête de régression produit la boîte corrigée , collée à la nouvelle position du piéton ; la tête de classification produit le score , qui dit s'il y a encore quelqu'un dans cette boîte.
L'ID de la boîte passe directement de à . Le suivi est fait, sans le moindre appariement.
Après la régression, deux situations mettent fin à une trajectoire (kill) :
- Score trop faible. Si , il n'y a plus personne dans la boîte. L'objet a pu sortir de l'image, ou être masqué par quelque chose qui n'est pas un piéton, comme un poteau ou une voiture.
- Collision avec quelqu'un d'autre. Quand deux personnes se croisent, les boîtes de deux trajectoires peuvent être régressées sur la même personne. Les auteurs appliquent une suppression des non-maxima (NMS) aux nouvelles boîtes de toutes les trajectoires, avec un seuil d'IoU ; la trajectoire supprimée prend fin.
Deuxième étape : les boîtes de détection ajoutent les nouveaux venus
Les trajectoires ne font que prolonger les objets déjà connus ; les personnes qui entrent dans l'image doivent être trouvées par le détecteur. Le détecteur tourne une fois sur toute l'image et donne les détections .
Une boîte de détection n'ouvre une nouvelle trajectoire que si son IoU avec toutes les trajectoires existantes est inférieure à . Autrement dit, elle doit couvrir un objet qu'aucune trajectoire n'explique encore. La boîte rouge en bas à droite de la figure a été ajoutée ainsi.
L'annexe de l'article donne les réglages , et , sans réglage particulier pour aucun benchmark. est plus permissif que ; les trajectoires existantes sont moins facilement supprimées par la NMS, les nouvelles apparaissent moins facilement, et le suivi gagne en stabilité.
Tracktor n'a été entraîné sur aucune annotation de suivi. Le détecteur a seulement appris « où sont les gens dans chaque image », jamais « qui est qui ».
Deux petites extensions
La régression ne marche que si l'objet bouge peu entre deux images consécutives. Quand la caméra bouge beaucoup ou que la vidéo a une faible fréquence d'images, cette condition n'est plus remplie. Dans les cas extrêmes, la boîte de l'image précédente peut ne plus encadrer personne dans l'image actuelle.
Les auteurs ajoutent deux modèles de mouvement simples :
- Compensation du mouvement de caméra (CMC). On aligne deux images consécutives avec le coefficient de corrélation amélioré (Enhanced Correlation Coefficient, ECC), on déplace d'abord l'ancienne boîte selon le mouvement de la caméra, puis on la confie à la tête de régression.
- Hypothèse de vitesse constante (CVA). Pour les vidéos à faible fréquence d'images. Dans toutes les expériences, seule la séquence AVG-TownCentre de MOT15 l'utilise.
L'autre extension est une ré-identification (reID) à court terme. Les trajectoires terminées ne sont pas jetées tout de suite, mais conservées un certain temps. Si une nouvelle boîte de détection apparaît entre-temps, un réseau siamois compare les distances d'apparence, et l'ancien ID est raccordé si la distance passe sous un seuil. Pour éviter de confondre les gens, les auteurs exigent aussi que l'IoU entre les deux boîtes soit assez grande, et le modèle de mouvement continue de faire avancer ces anciennes boîtes conservées.
Ce réseau de reID est un TriNet à backbone ResNet-50, entraîné avec une triplet loss sur les annotations de suivi de MOT17. Avec la reID, la méthode n'est donc plus, à strictement parler, « sans aucune annotation de suivi », ce que l'article dit clairement.
La version avec CMC et reID s'appelle Tracktor++.
Discussion
Ablations : combien vaut chaque extension
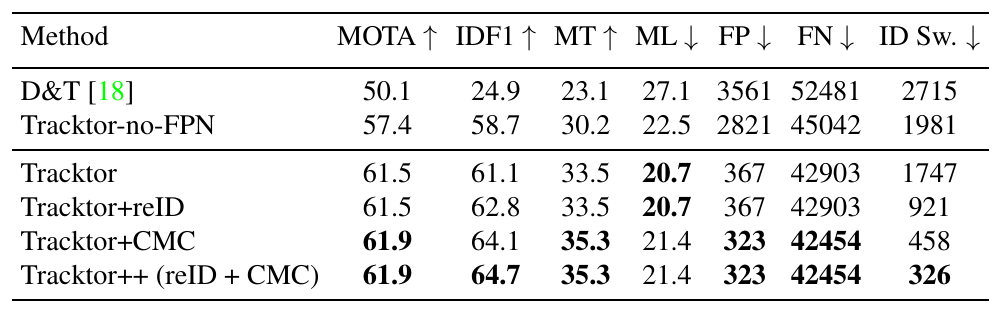
Ce tableau contient trois comparaisons, qui montrent chacune une chose :
- Suivre avec un détecteur fait mieux qu'un détecteur-traqueur entraîné spécialement. D&T est une méthode entraînée sur des annotations de suivi, qui produit de courtes trajectoires sur deux images, puis les raccorde hors ligne en longues trajectoires. Son MOTA est de 50.1, et son IDF1 de seulement 24.9 ; Tracktor, qui n'a jamais vu d'annotation de suivi, obtient 61.5 et 61.1.
- Un meilleur détecteur donne un meilleur suivi. Sans FPN, Tracktor-no-FPN voit son MOTA tomber de 61.5 à 57.4. La qualité du détecteur détermine directement celle de la régression.
- Les deux extensions servent surtout à sauver les ID. De Tracktor à Tracktor++, le MOTA ne gagne que 0.4, mais les changements d'identité passent de 1747 à 326, et l'IDF1 de 61.1 à 64.7. La CMC y contribue davantage que la reID : à elle seule, elle fait tomber les changements d'identité à 458. Plusieurs séquences de MOT17 sont filmées par une caméra mobile ; une ancienne boîte qui ne suit pas les secousses de la caméra est l'une des principales causes de rupture d'ID.
Les jeux de test
Sur les jeux de test des trois benchmarks, Tracktor++ obtient un MOTA de 53.5 sur MOT17, 54.4 sur MOT16 et 44.1 sur MOT15, à chaque fois le plus élevé des méthodes publiées en public detection à l'époque. Les trois benchmarks utilisent le même détecteur entraîné sur MOT17Det ; les données d'entraînement de MOT15 ne sont pas utilisées du tout.
Sur MOT17, Tracktor++ compte 12201 FP, contre 33212 pour le suivant, eHAF ; c'est beaucoup moins de faux positifs. Son IDF1 de 52.3 est en revanche légèrement inférieur aux 54.7 d'eHAF et aux 54.5 de jCC. L'avance en MOTA vient surtout du petit nombre de faux positifs ; pour le maintien des identités, la méthode se contente de suivre le rythme.
Les cas vraiment difficiles
Les auteurs ne s'arrêtent pas au classement. Sur le jeu d'entraînement de MOT17, ils comparent Tracktor aux autres méthodes de pointe, en regroupant les objets selon leur visibilité, leur taille et la longueur des trous de détection.
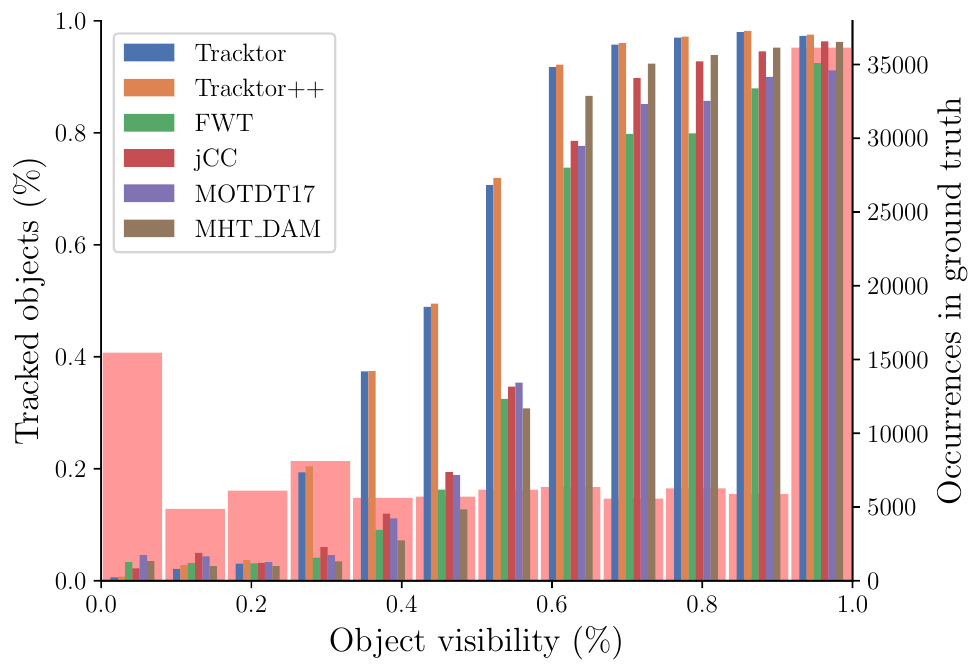
Les barres de couleur de cette figure donnent la proportion d'objets suivis par chaque méthode selon la visibilité ; les barres rouge pâle, le nombre de boîtes annotées pour chaque visibilité.
Regardons d'abord la moitié droite. Les objets dont la visibilité dépasse 0.6 sont bien suivis par toutes les méthodes, et les barres rouge pâle nous apprennent que c'est dans cette zone que les boîtes sont les plus nombreuses. Passons à la moitié gauche. Pour les objets dont la visibilité est inférieure à 0.3, toutes les méthodes en suivent moins de 20 %, qu'elles soient en ligne ou hors ligne, avec ou sans modèle d'apparence, avec ou sans interpolation.
Tracktor mène nettement entre 0.3 et 0.6, parce que sa tête de régression parvient encore à réencadrer une personne à moitié masquée ; dans la zone des occultations sévères, aucune méthode ne s'en sort bien. Les auteurs en concluent que les bons MOTA des jeux de test tiennent pour une large part à la distribution des données. La plupart des boîtes sont bien visibles dès le départ.
L'analyse par taille d'objet aboutit à la même conclusion. Parmi les objets de visibilité supérieure à 0.9, les personnes de plus de 250 pixels de haut sont bien suivies par toutes les méthodes ; plus l'objet est petit, moins toutes les méthodes réussissent. L'analyse des trous de détection montre que, sur les détections publiques DPM et Faster R-CNN, quand le trou dépasse 15 images, Tracktor comble les trous par régression bien mieux que les autres méthodes ; avec les détections SDP, de meilleure qualité, ce sont au contraire les méthodes à interpolation hors ligne qui en profitent le plus. Pour toutes les méthodes, la couverture baisse à mesure que le trou s'allonge.
Où est le plafond
Pour finir, les auteurs remplacent un à un les composants de Tracktor par la vérité terrain, et construisent ainsi une série d'oracles pour estimer la marge de progression maximale dans chaque direction :
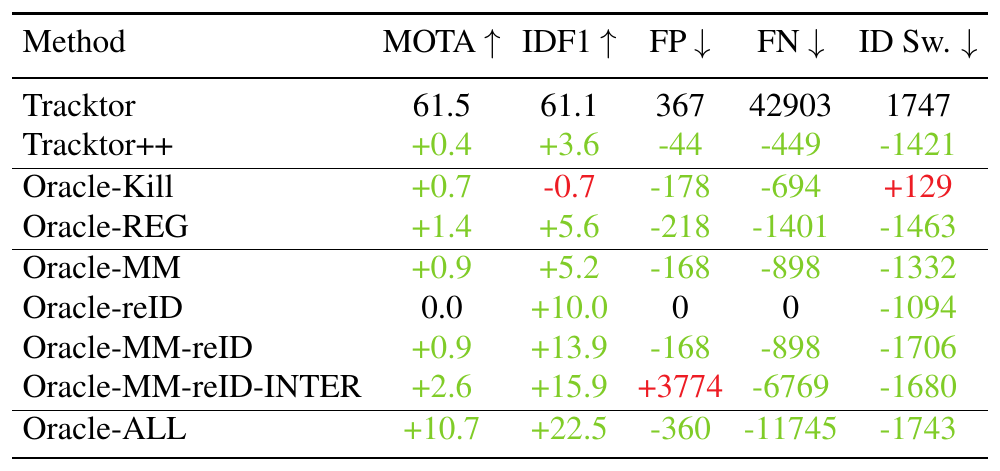
Quelques chiffres méritent l'attention :
- Une reID parfaite (Oracle-reID) ne change pas le MOTA, mais ajoute 10 points d'IDF1. La ré-identification ne s'occupe que de reconnaître les gens, pas de la justesse des boîtes.
- Un modèle de mouvement parfait plus la reID (Oracle-MM-reID) ajoute 13.9 points d'IDF1. Les auteurs y voient la limite haute de la voie d'extension de Tracktor++.
- Avec en plus une interpolation linéaire pendant les occultations (Oracle-MM-reID-INTER), l'IDF1 gagne 15.9 points et les FN baissent de 6769, mais les FP augmentent de 3774. Bon nombre des boîtes ajoutées par interpolation sont mal placées quand la caméra bouge ou que l'occultation dure longtemps.
- Tout remplacer par les annotations (Oracle-ALL) ajoute 10.7 points de MOTA, soit 72.2. C'est le plafond absolu de ce détecteur Faster R-CNN avec FPN.
Oracle-Kill est intéressant lui aussi. Quand les annotations décident du moment où une trajectoire prend fin, le MOTA gagne 0.7, mais les changements d'identité augmentent de 129. Plus les trajectoires restent longtemps, plus la tête de régression rencontre des boîtes masquées, difficiles à distinguer, et finit par tirer vers la mauvaise personne.
La proposition des auteurs
Les auteurs proposent de prendre Tracktor comme nouveau point de départ. Les objets grands et bien visibles seraient confiés à la régression image par image, et les cas difficiles restants à des méthodes spécialisées. Ils suggèrent deux directions : d'une part, un modèle de mouvement capable d'« imaginer » la position des objets pendant les longues occultations ; d'autre part, passer du « tracking-by-detection » au « tracking-by-tracklet », en faisant produire directement de courtes trajectoires par le détecteur, et en laissant les méthodes en aval traiter les cas difficiles.
Avec le recul, ces deux directions ont trouvé preneur. CenterTrack et FairMOT, qui placent détection et suivi dans un même réseau, sont arrivés très vite ; deux ans plus tard, Tim Meinhardt publie à son tour TrackFormer avec Leal-Taixé et d'autres, où les objets de l'image précédente entrent dans le décodeur Transformer de l'image suivante sous forme de « requêtes de piste », dans le prolongement de la même idée, « utiliser les objets de l'image précédente pour trouver ceux de l'image actuelle ».
Conclusion
Un détecteur entraîné, à qui l'on confie les boîtes de l'image précédente pour la régression, suffit à obtenir le meilleur MOTA en public detection sur trois benchmarks MOTChallenge ; avec la compensation du mouvement de caméra et une reID à court terme, les changements d'identité baissent encore de 80 %.
Plus que le classement, c'est l'analyse de la seconde moitié qui mérite d'être lue. Les objets très masqués et les très petits objets, aucune méthode ne les traitait bien à l'époque ; les beaux MOTA du classement venaient surtout de boîtes déjà bien visibles et faciles à suivre.
Le titre promet zéro fioriture, mais les auteurs en ont tout de même ajouté deux. Après quoi, ils ont honnêtement reconnu que les personnes les plus difficiles à suivre, personne ne savait encore les suivre.