Article original
Towards Real-Time Multi-Object Tracking
- Publication
- ECCV 2020Conférence
- Premier dépôt sur arXiv
- arXiv:1909.12605
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingjde2019,
  title = {{Towards Real-Time Multi-Object Tracking}},
  author = {Zhongdao Wang and Liang Zheng and Yixuan Liu and Yali Li and Shengjin Wang},
  year = {2019},
  eprint = {1909.12605},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1909.12605}
}
Les traqueurs de la génération de DeepSORT, POI et MOTDT procèdent tous à peu près de la même façon. On fait d'abord tourner un détecteur, puis on découpe chaque boîte de détection pour l'envoyer dans un autre réseau, de re-ID, qui extrait les caractéristiques d'apparence.
Deux réseaux tournent chacun de leur côté, et leurs temps s'additionnent. Plus il y a de monde dans l'image, plus il faut faire tourner la re-ID, et plus tout le système ralentit.
Beaucoup d'articles se disent « temps réel », mais à y regarder de près, le chronométrage ne compte souvent que l'étape d'association, sans le temps du détecteur ni celui de la re-ID. L'association est en temps réel ; le système de suivi complet, non.
Zhongdao Wang, de l'université Tsinghua, Liang Zheng, de l'Australian National University, et leurs collègues veulent construire un système réellement temps réel. Ils font en sorte que le détecteur reconnaisse les gens au passage, avec un seul réseau et une seule passe avant qui produisent à la fois les boîtes de détection et les caractéristiques d'apparence de chaque boîte. Ils appellent cette approche JDE (Joint Detection and Embedding).
Définir le problème
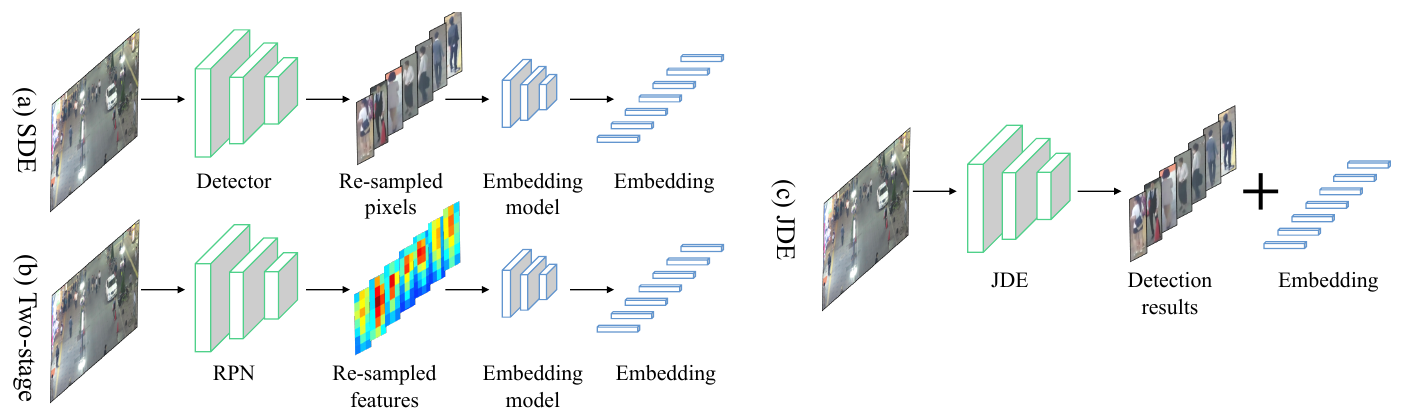
Les auteurs classent les approches de l'époque en trois catégories :
- (a) Détection et embedding séparés (Separate Detection and Embedding, SDE) : DeepSORT et POI en font partie. Le détecteur et le modèle de re-ID sont entièrement indépendants, et le calcul de la re-ID est proportionnel au nombre de personnes.
- (b) Modèles à deux étapes : sur un Faster R-CNN, on transforme la seconde étape pour qu'elle apprenne des caractéristiques d'apparence. Le RPN de la première étape produit toujours des boîtes ; la seconde étape extrait de la carte de caractéristiques celles de chaque boîte, et s'entraîne par apprentissage de métrique. Une partie du calcul est ainsi partagée, mais la conception en deux étapes est lente par nature, en général moins de 10 images par seconde, et le temps de la seconde étape augmente toujours avec le nombre de personnes.
- (c) JDE : on ajoute directement une sortie à un détecteur à une étape, et une seule passe avant donne les boîtes et les caractéristiques.
Pour réaliser (c), il faut que deux tâches aux objectifs très différents s'apprennent bien ensemble dans un même réseau. Les auteurs traitent la question sous cinq angles, un par un : les données d'entraînement, l'architecture du réseau, la fonction de perte, la pondération multitâche et la méthode d'évaluation.
Résoudre le problème
Architecture du réseau
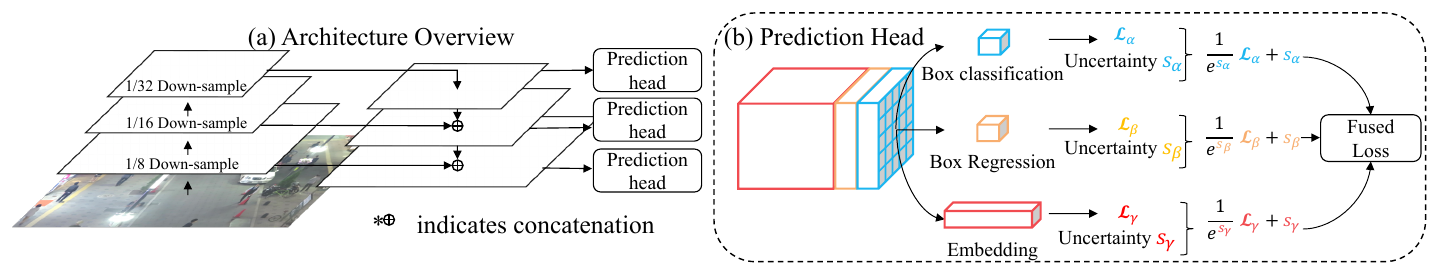
Le backbone est le DarkNet-53 de YOLOv3, suivi d'un réseau pyramidal de caractéristiques (FPN), avec des prédictions à trois échelles, 1/32, 1/16 et 1/8 de l'entrée. La taille apparente des piétons varie énormément selon leur distance, et la prédiction multi-échelle aide la détection.
Chaque échelle a une tête de prédiction, qui produit une carte de prédiction dense de taille . est le nombre de boîtes d'ancrage à cette échelle, la dimension des caractéristiques d'embedding. Cette carte se divise en trois parties :
- Classification des boîtes : , premier plan ou arrière-plan pour chaque boîte d'ancrage.
- Régression des boîtes : , quatre corrections pour chaque boîte d'ancrage.
- Carte d'embedding : , une caractéristique d'apparence de dimension par position.
Calculons les formes pour l'entrée par défaut, . Les cartes de caractéristiques des trois échelles mesurent , et . L'article ne donne pas la valeur de ; dans les expériences de FairMOT, JDE utilise 512 dimensions. Chaque échelle a ; chaque tête de prédiction produit donc canaux, et la couche la plus fine est un tenseur de .
Si une boîte d'ancrage est classée au premier plan, on va chercher à la même position de la carte d'embedding le vecteur de 512 dimensions qui s'y trouve, et il sert de caractéristique d'apparence à cette boîte. Détection et caractéristiques d'apparence sont calculées ensemble ; une personne de plus dans l'image ne change presque rien au calcul.
Branche de détection : des ancres taillées pour les piétons
La branche de détection ressemble beaucoup à un RPN, avec deux modifications :
- Des boîtes d'ancrage conçues pour les piétons. Toutes les boîtes d'ancrage ont un rapport largeur/hauteur de 1:3, avec 12 tailles au total, 4 par échelle ; leur largeur va de à pixels.
- Les seuils premier plan / arrière-plan. Une IoU supérieure à 0.5 avec une boîte réelle compte comme premier plan, comme en détection d'objets classique ; mais une IoU inférieure à 0.4 (au lieu des 0.3 habituels) compte déjà comme arrière-plan. Les auteurs constatent que cela réduit efficacement les faux positifs en cas d'occultation sévère.
La classification utilise l'entropie croisée, la régression des boîtes la perte smooth-L1.
Branche d'embedding : la classification à la place des triplets
L'embedding doit apprendre un espace où les caractéristiques d'une même personne se rapprochent et celles de personnes différentes s'éloignent. L'approche la plus intuitive est la triplet loss, avec laquelle MOTDT a été entraîné. Mais les combinaisons de triplets sont trop nombreuses, l'échantillonnage est difficile, l'entraînement peu stable et la convergence lente.
Les auteurs comparent trois pertes :
- La triplet loss : dans un mini-lot, on extrait tous les exemples négatifs et l'exemple positif le plus difficile.
- La borne supérieure lisse de la triplet loss : une variante plus stable, qui converge plus vite.
- L'entropie croisée : chaque identité du jeu d'entraînement est traitée comme une classe ; la caractéristique d'embedding extraite passe par une couche entièrement connectée pour classer l'identité.
Les auteurs comparent d'abord les deux dernières par leurs formules. La borne supérieure lisse s'écrit
et l'entropie croisée
Les deux se ressemblent presque trait pour trait, à deux différences près. Premièrement, l'entropie croisée représente chaque identité par un « poids de classe » apprenable , au lieu d'utiliser directement les caractéristiques des autres exemples. Deuxièmement, le dénominateur de l'entropie croisée contient toutes les autres identités, alors que les pertes de type triplet ne contiennent que les négatifs tirés dans le mini-lot. L'entropie croisée exige qu'une personne ressemble davantage à sa propre classe qu'à chacune des autres identités, une contrainte bien plus stricte que celle des triplets.
Les résultats expérimentaux sont sans appel. Avec la même pondération, la TPR@FAR=0.1 de l'embedding en recherche n'est que de 42.2 pour la triplet loss, de 44.3 pour la borne supérieure lisse, et de 88.2 pour l'entropie croisée, soit le double.
Les ancres de premier plan qui ont une boîte mais pas d'annotation d'identité sont ignorées dans le calcul de la perte d'embedding. Les caractéristiques d'embedding des trois échelles passent par la même couche entièrement connectée et partagent le même espace de caractéristiques ; une même personne détectée à des échelles différentes peut donc être comparée.
Comment équilibrer les trois pertes
Chaque tête de prédiction a trois pertes, soit neuf pour les trois échelles. Le plus simple serait de toutes les additionner avec le même poids, mais l'entraînement ne décolle alors quasiment pas.
Les auteurs comparent plusieurs stratégies de pondération :
- Poids égaux (Uniform) : l'AP de détection tombe à 6.8. La perte d'embedding est bien plus grande que les deux autres et domine tout l'entraînement ; la détection n'apprend rien de bon, et le MOTA n'est que de 36.9.
- MGDA-UB : la méthode d'optimisation multitâche la plus aboutie en théorie, mais elle donne un poids trop grand à la perte d'embedding, et le résultat est à peu près le même qu'avec des poids égaux, une AP de 8.3.
- Normalisation des pertes (Loss.Norm) : l'inverse de la moyenne mobile de chaque perte sert de poids ; MOTA de 57.9.
- Poids quasi optimaux (App.Opt) : limités à deux variables indépendantes, ils sont trouvés par recherche manuelle ; MOTA de 64.3.
- Pondération par l'incertitude (Uncertainty) : chaque perte reçoit un paramètre apprenable , et le réseau décide lui-même des poids :
Cette dernière méthode est la seule à dépasser la recherche manuelle, avec une AP de 83.0, une TPR de 90.4 et un MOTA de 65.8 ; ses 207 changements d'identité sont aussi le minimum. L'année suivante, FairMOT reprend la même pondération.
Données d'entraînement
JDE a besoin de données annotées à la fois en boîtes et en identités, mais les jeux de données de suivi sont trop petits. Les auteurs assemblent six jeux publics en un grand jeu d'entraînement. ETH et CityPersons n'ont que des boîtes et ne servent qu'à la détection ; CalTech, MOT16, CUHK-SYSU et PRW ont des annotations d'identité et entraînent les deux branches. Au total, environ 54 000 images, 270 000 boîtes et 8 700 identités. Les vidéos d'ETH qui recoupent le jeu de test de MOT16 ont été retirées.
Cet assemblage, appelé plus tard MIX dans FairMOT, est devenu le jeu d'entraînement standard des traqueurs one-shot.
Association
L'association n'est pas le sujet de l'article ; les auteurs conçoivent une association en ligne simple et rapide. Chaque trajectoire conserve un état d'apparence et un état de mouvement donné par un filtre de Kalman. À chaque image, on calcule pour toutes les paires détection-trajectoire la similarité d'apparence (similarité cosinus) et la distance de mouvement (distance de Mahalanobis), pondérées pour former le coût :
Après l'appariement par l'algorithme hongrois, l'état d'apparence de la trajectoire est mis à jour par une moyenne mobile exponentielle :
Seules les détections présentes deux images de suite ouvrent une nouvelle trajectoire ; une trajectoire n'est supprimée qu'après 30 images sans mise à jour, et entre-temps, elle reste dans un réservoir tampon, d'où elle peut être raccordée à son retour.
Cette mise à jour par EMA a ensuite été reprise telle quelle par StrongSORT et BoT-SORT. Les auteurs signalent aussi que vectoriser le filtre de Kalman (traiter toutes les trajectoires d'un coup) est crucial pour la vitesse ; quand le réseau est déjà rapide, c'est plutôt l'association qui risque de devenir le goulot d'étranglement.
Discussion
JDE est entraîné par SGD pendant 30 epochs, avec une résolution d'entrée par défaut de . Pour la validation, la détection est évaluée par l'AP sur le jeu de validation de CalTech, l'embedding par la TPR de recherche sur trois jeux de données, et le suivi par le MOTA sur le jeu d'entraînement de MOT15 ; la comparaison finale se fait sur le jeu de test de MOT16.
Méthode d'association
Les auteurs branchent d'abord un même modèle JDE sur SORT, puis sur leur propre association. Sur MOT15, peu peuplé, leur méthode obtient un MOTA de 67.5 et un IDF1 de 67.6, contre 66.9 et 55.8 pour SORT, et la vitesse passe de 44.1 à 46.2 FPS. Sur la séquence encombrée CVPR19-01 (61 personnes par image en moyenne), la vitesse passe de 26.4 à 33.9 FPS, et le MOTA comme l'IDF1 ne progressent que légèrement. La forte amélioration de l'IDF1 vient surtout des caractéristiques d'apparence.
Face aux systèmes séparés
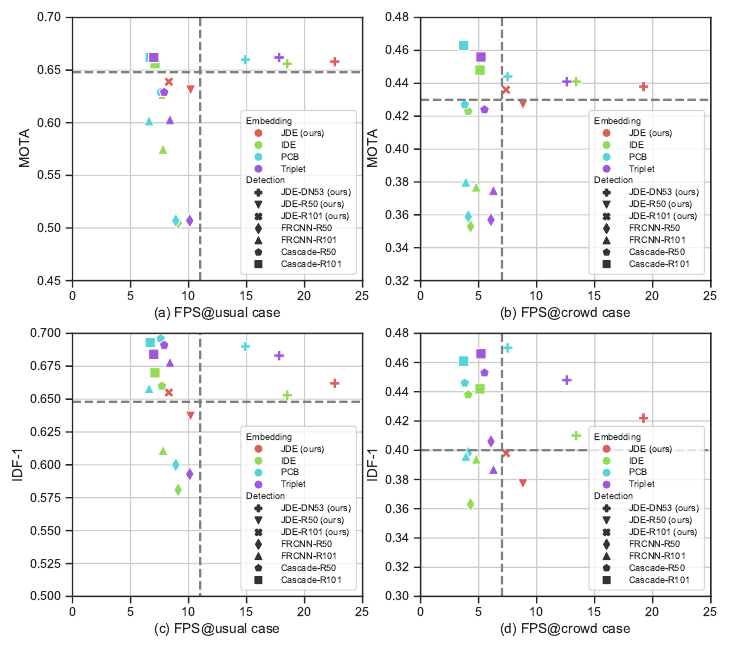
Par souci d'équité, les auteurs utilisent exactement les mêmes données d'entraînement, combinent deux à deux plusieurs détecteurs (JDE, Faster R-CNN, Cascade R-CNN) et plusieurs modèles de re-ID (IDE, Triplet, PCB), puis branchent la même association.
- Le meilleur compromis vitesse-précision. Avec peu de monde, JDE tourne à 22 images par seconde avec un MOTA de 65.8 ; la combinaison la plus forte, Cascade R-CNN (ResNet-101) plus PCB, atteint un MOTA de 66.2, mais à environ 6 images par seconde seulement.
- L'écart se creuse quand la foule grossit. Toutes les combinaisons SDE ralentissent fortement dans les scènes encombrées, car le temps de re-ID est proportionnel au nombre de personnes ; l'embedding de JDE est calculé avec la détection, et sa vitesse n'est presque pas affectée, le ralentissement venant surtout de l'association.
- L'embedding appris conjointement vaut celui appris séparément. En gardant le détecteur de JDE et en le combinant aux embeddings IDE, Triplet et PCB entraînés séparément, la précision de suivi reste très proche, et JDE dépasse même légèrement IDE.
Du côté de l'IDF1, le tableau est moins flatteur. Dans les scènes encombrées, l'IDF1 de JDE baisse davantage que celui des combinaisons SDE les plus fortes.
Le jeu de test MOT16
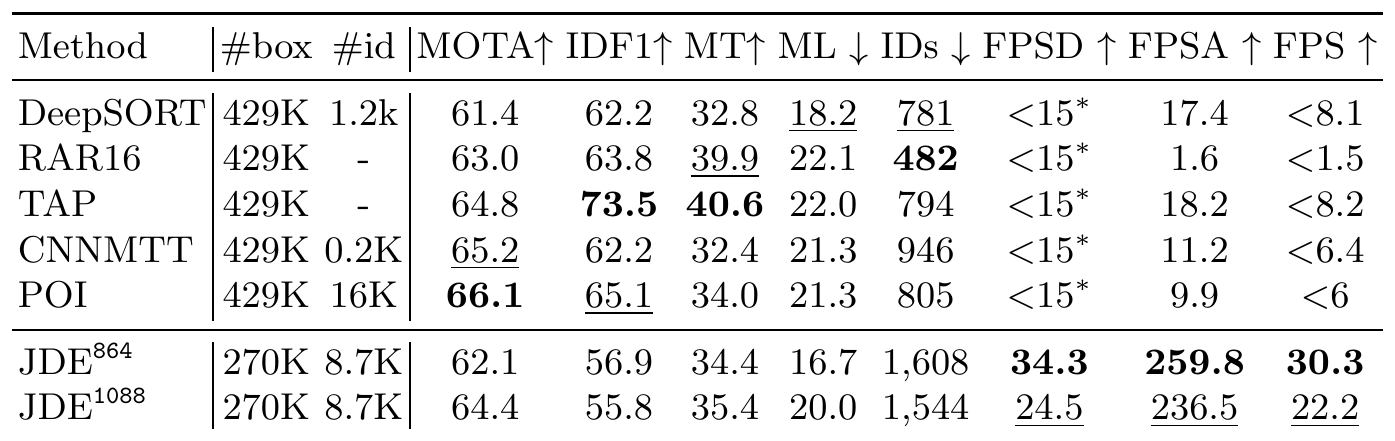
JDE utilise des données d'entraînement supplémentaires ; la comparaison se fait donc selon les règles private de MOT16. Les adversaires utilisent tous le même Faster R-CNN, entraîné sur un grand jeu privé de piétons ; ils diffèrent par leur modèle de re-ID et leur association.
En MOTA, les 64.4 de JDE dépassent DeepSORT de 3 points et restent 1.7 point sous POI, alors que JDE s'entraîne sur un peu plus de 60 % des boîtes de ses adversaires (270 000 contre 429 000). Pour la vitesse, beaucoup de méthodes ne rapportent pas leur temps complet ; les auteurs réimplémentent le détecteur qu'elles partagent pour estimer une borne supérieure. Même face à une borne aussi généreuse, JDE, à 22.2 images par seconde, est au moins deux à trois fois plus rapide. En réduisant la largeur d'entrée à 864, la vitesse monte à 30.3 FPS, et le MOTA ne descend qu'à 62.1.
Mais l'IDF1 et les changements d'identité sont les points faibles évidents de JDE. Son IDF1 de 55.8 est inférieur aux 62.2 de DeepSORT et aux 65.1 de POI ; ses 1 544 changements d'identité sont presque le double de ceux des autres méthodes.
Le problème vient des boîtes
Les auteurs soupçonnent d'abord l'embedding appris conjointement d'être plus faible. Mais en le remplaçant par un modèle entraîné séparément, l'IDF1 et les changements d'identité ne bougent presque pas.
La vraie cause est la détection. Quand les piétons se chevauchent beaucoup, les boîtes d'un détecteur à une étape dérivent facilement et se décalent ; en extrayant des caractéristiques avec une boîte décalée, on y mélange l'apparence d'une autre personne, et l'ID change. Ces changements d'identité surviennent souvent au milieu d'une trajectoire, ce qui fait particulièrement chuter l'IDF1. Les auteurs laissent à des travaux futurs la question de rendre les boîtes plus précises quand les piétons se chevauchent fortement.
La suite
Le problème a trouvé preneur six mois plus tard. FairMOT estime que le coupable, ce sont les boîtes d'ancrage. Une ancre peut encadrer plusieurs personnes, et plusieurs ancres peuvent correspondre à la même personne ; les caractéristiques de re-ID apprises sont donc floues. FairMOT passe à une représentation par points centraux, sans ancres, et réduit l'embedding à 64 ou 128 dimensions. Dans les expériences de FairMOT, il suffit de réduire l'embedding de JDE de 512 à 64 dimensions pour améliorer à la fois le MOTA, l'IDF1 et les changements d'identité.
Conclusion
JDE intègre les caractéristiques d'apparence dans un détecteur à une étape ; une seule passe avant produit à la fois les boîtes et les caractéristiques, et c'est le premier système complet de suivi multi-objets à approcher le temps réel. Sur MOT16, son MOTA est proche de celui de systèmes forts entraînés séparément, pour une vitesse deux à trois fois supérieure, et plus il y a de monde, plus l'avantage est net.
Ce qu'il faut surtout retenir de cet article, ce sont deux détails d'entraînement. Pour l'embedding, l'entropie croisée de classification d'identité fait deux fois mieux que la triplet loss ; pour la pondération multitâche, laisser des paramètres d'incertitude apprendre les poids fait mieux que la recherche manuelle. Ces deux recettes sont devenues presque standard dans les traqueurs one-shot qui ont suivi.
Le titre de l'article dit « Towards », et les auteurs savaient bien que le bout de chemin des boîtes mal alignées restait à parcourir dans l'article suivant.