Article original
Real-time Multiple People Tracking with Deeply Learned Candidate Selection and Person Re-Identification
- Publication
- ICME 2018Conférence
- Premier dépôt sur arXiv
- arXiv:1809.04427
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingmotdt2018,
  title = {{Real-time Multiple People Tracking with Deeply Learned Candidate Selection and Person Re-Identification}},
  author = {Long Chen and Haizhou Ai and Zijie Zhuang and Chong Shang},
  year = {2018},
  eprint = {1809.04427},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1809.04427}
}
Si vous avez lu le code de FairMOT ou de JDE, vous avez sans doute croisé le nom MOTDT dans la partie consacrée à l'association.
L'article de FairMOT le dit sans détour, son association en ligne « reprend l'association hiérarchique de MOTDT ». Et parmi les trois méthodes d'association classiques auxquelles ByteTrack se compare, à côté de SORT et de DeepSORT, la troisième est aussi MOTDT.
Ce nom revient souvent dans les tableaux des autres, mais l'article lui-même ne fait que six pages. Publié en 2018 par Long Chen, Haizhou Ai et leurs collègues de l'université Tsinghua, il s'attaque à une question que tout traqueur finit par se poser, que faire quand le détecteur n'est pas fiable.
Définir le problème
Dans une scène encombrée, le détecteur se trompe facilement. Il suffit d'un changement de posture ou d'une personne qui en masque une autre pour voir apparaître des détections manquées, des faux positifs ou des boîtes mal placées.
Les méthodes hors ligne (batch) peuvent regarder toute la vidéo et corriger ces erreurs grâce aux images futures, mais elles ne fonctionnent pas en temps réel, et ne conviennent pas aux applications qui exigent un résultat immédiat. Cet article ne traite que le suivi en ligne, qui ne peut utiliser que l'image courante et les images passées.
Dans le tracking-by-detection classique, les seules boîtes candidates à l'association sont les détections. Si le détecteur rate une personne, aucune boîte ne peut être attribuée à sa trajectoire dans cette image.
Les auteurs remarquent que détection et suivi peuvent en fait se compléter :
- La prédiction des trajectoires peut compenser une brève détection manquée ou une boîte imprécise. Si le détecteur n'a pas trouvé la personne dans cette image, la boîte prédite par le filtre de Kalman est toujours là.
- Les détections de haute confiance peuvent empêcher une trajectoire de dériver durablement vers l'arrière-plan. Une boîte prédite jamais corrigée par une détection finit tôt ou tard par s'égarer.
Prenons donc les deux comme boîtes candidates. Mais boîtes de détection et boîtes prédites ont des origines différentes ; comment les noter à la même aune, puis choisir les meilleures dans un tas de boîtes qui se chevauchent ?
Avant eux, Yan et al. avaient déjà essayé de prendre comme candidates les sorties du détecteur et du traqueur, mais avec des caractéristiques conçues à la main, comme des histogrammes de couleur ou le flot optique. Cet article veut le faire avec un réseau profond, et en temps réel.
Résoudre le problème
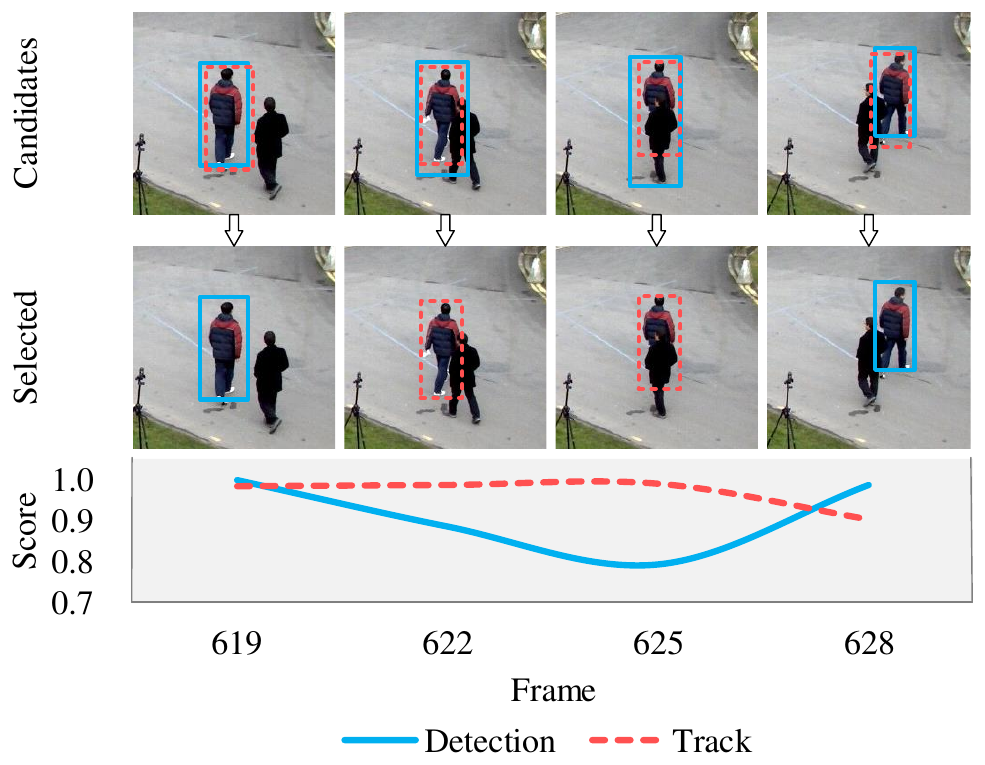
Cette figure résume toute l'idée de l'article. En trait plein bleu, la boîte de détection ; en pointillés rouges, la boîte prédite par la trajectoire ; en bas, les scores des deux.
Au début et à la fin, la boîte de détection a le meilleur score et elle est retenue ; au milieu, des images 622 à 625, la personne est en partie masquée, le score de la boîte de détection baisse, la boîte prédite devient plus fiable, et c'est elle qui est choisie.
La méthode se déroule en deux temps, d'abord sélectionner les candidates, puis faire l'association.
1. Un même classifieur pour noter toutes les candidates
Boîtes de détection et boîtes prédites réunies, les candidates sont nombreuses et se chevauchent beaucoup. Découper chacune et l'envoyer dans un réseau de classification serait trop lent.
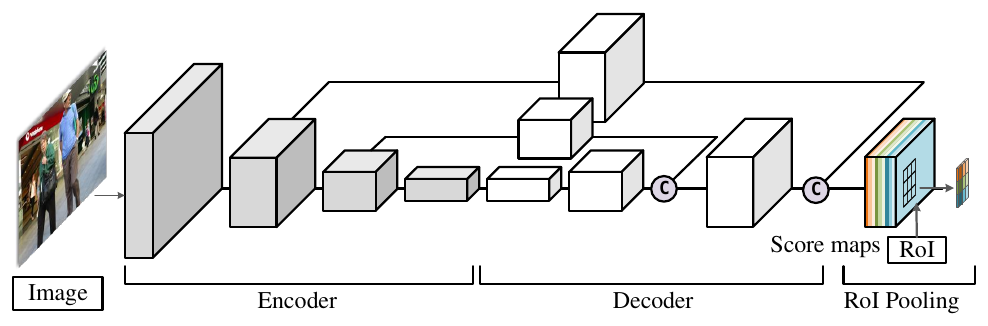
Les auteurs reprennent plutôt l'approche de R-FCN (region-based fully convolutional network) : le réseau ne passe qu'une fois sur l'image entière et produit quelques cartes de scores, que toutes les candidates partagent.
Le backbone est un SqueezeNet léger utilisé comme encodeur, suivi d'un décodeur avec suréchantillonnage qui augmente la résolution des cartes de scores. Pour une image d'entrée de , il ne faut que 8 millisecondes sur une GTX 1080 Ti.
La notation la plus simple consisterait à calculer sur toute l'image la probabilité que chaque point « soit une personne », puis à faire la moyenne de tous les points de la boîte. Mais on perd alors l'information spatiale. Une boîte qui ne couvre qu'une moitié de personne n'a que des points situés sur la personne, et sa moyenne reste élevée.
R-FCN règle ce problème avec des cartes de scores sensibles à la position. Le réseau produit cartes de scores ; chaque candidate est découpée en cellules, et chaque cellule ne lit que la carte de scores « qui correspond à sa position ». On fait enfin la moyenne des réponses des cellules, puis on passe par une sigmoïde :
Imaginons le cas . Le réseau produit 9 cartes de scores, qui réagissent respectivement au « coin supérieur gauche de la personne », au « haut de la personne »… jusqu'au « coin inférieur droit de la personne ». Quand une boîte encadre exactement une personne, la cellule en haut à gauche lit la carte du haut à gauche, celle en bas à droite la carte du bas à droite, et chaque cellule lit un score élevé. Si la boîte est décalée d'une demi-personne vers la droite, sa moitié droite tombe sur l'arrière-plan, les trois cellules de droite lisent des scores faibles, et la moyenne baisse.
Ce réseau ne fait que de la classification, pas de régression de boîtes. En pratique, ; les données d'entraînement sont des exemples positifs tirés au hasard autour des boîtes réelles, et autant d'exemples négatifs pris dans l'arrière-plan, issus de MS COCO et de deux vidéos d'entraînement de MOT16.
2. Confiance de trajectoire : combien de temps croire une boîte prédite ?
Une boîte prédite est utile à court terme, mais perd sa fiabilité avec le temps. Plus le filtre de Kalman reste longtemps sans mise à jour par une détection, plus sa prédiction est imprécise.
Les auteurs définissent un score de confiance pour chaque trajectoire. Une trajectoire peut être interrompue puis retrouvée plusieurs fois, et chaque reprise réinitialise le filtre de Kalman ; on ne regarde donc que le dernier segment continu, la tracklet :
est le nombre de détections appariées à cette tracklet, et le nombre de prédictions utilisées d'affilée depuis le dernier appariement à une détection.
Le comportement de cette formule est intuitif :
- Juste après un appariement à une détection, et la confiance vaut 1.
- À chaque prédiction supplémentaire, augmente de un, et la confiance baisse de façon logarithmique.
- Quand dépasse , la confiance tombe à zéro, et la boîte prédite de cette trajectoire ne peut plus servir de candidate.
- Une trajectoire doit avoir été appariée à au moins deux détections pour disposer d'assez d'observations pour établir un modèle de mouvement ; c'est seulement alors que sa boîte prédite peut servir de candidate.
3. Un score unifié
Le score des deux types de candidates est défini ainsi :
Le score d'une boîte de détection est simplement la probabilité de classification ; celui d'une boîte prédite est cette probabilité multipliée par la confiance de la trajectoire. Une boîte prédite a beau ressembler à une personne, si elle vient d'une trajectoire qu'aucune détection n'a confirmée depuis longtemps, son score est tiré vers le bas.
Une fois toutes les candidates notées, on applique une suppression des non-maxima (seuil d'IoU de 0.3), puis on élimine les boîtes dont le score est inférieur à 0.4.
4. Caractéristiques d'apparence
Pour décider, lors de l'association, si une candidate et une trajectoire correspondent à la même personne, les auteurs utilisent des caractéristiques de re-ID. Le réseau suit l'architecture à alignement de parties proposée par Zhao et al. : un backbone convolutif de GoogLeNet, suivi de branches entièrement connectées, chacune correspondant à une partie du corps ; il produit des caractéristiques de 512 dimensions, comparées par distance euclidienne.
Les données d'entraînement combinent trois jeux de ré-identification de piétons, Market-1501, CUHK01 et CUHK03, et l'entraînement utilise une triplet loss :
est une même personne, deux personnes différentes. Les triplets déjà bien séparés () ont une perte nulle, et l'entraînement se concentre sur les exemples difficiles.
5. Association hiérarchique
C'est la partie que JDE et FairMOT ont reprise plus tard. L'association se fait en deux niveaux :
- Premier niveau, candidates de détection × trajectoires, par l'apparence. On calcule la distance entre caractéristiques de re-ID, avec un seuil de 0.4.
- Second niveau, candidates restantes × trajectoires restantes, par l'IoU. Seuil de 0.3.
- Les boîtes de détection restantes ouvrent de nouvelles trajectoires.
Pourquoi deux niveaux ? La boîte prédite est extrapolée par le filtre de Kalman ; dans une scène encombrée, la zone qu'elle encadre peut contenir quelqu'un d'autre. En extrayant des caractéristiques d'apparence d'une telle boîte, on risque fort de mémoriser l'allure d'une autre personne. La comparaison d'apparence ne porte donc que sur les boîtes de détection, et l'apparence d'une trajectoire n'est mise à jour qu'avec les boîtes de détection qui lui ont été appariées ; les boîtes prédites ne participent qu'à l'appariement par IoU du second niveau.
C'est aussi plus rapide. À chaque image, il suffit d'extraire une fois les caractéristiques de re-ID des boîtes de détection, et jamais celles des boîtes prédites.
Discussion
Les expériences portent sur MOT16, avec les détections publiques officielles. Le jeu de validation, tiré de 5 vidéos d'entraînement, sert aux ablations.
La contribution de chaque composant
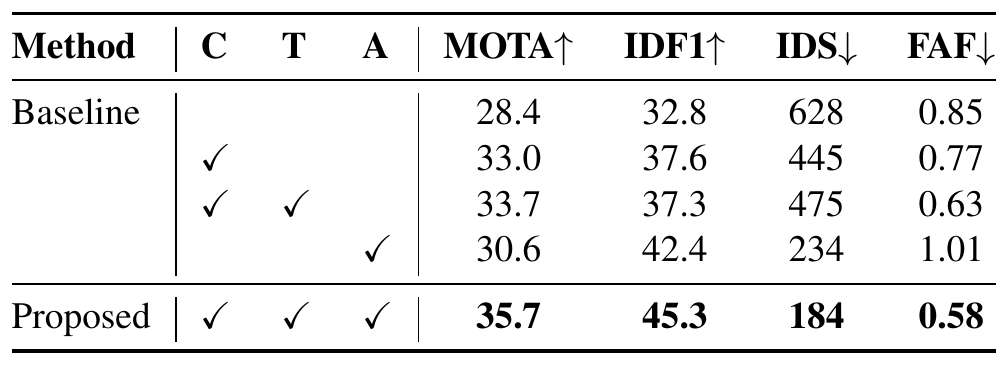
La référence est la plus simple qui soit, prédiction par filtre de Kalman et appariement par IoU, autrement dit la recette de SORT.
- Choisir les candidates parmi les détections et les prédictions avec le classifieur (C) fait passer le MOTA de 28.4 à 33.0, et les changements d'identité de 628 à 445. Prendre les boîtes prédites comme candidates rattrape bel et bien beaucoup de détections manquées.
- Ajouter la confiance de trajectoire (T) porte le MOTA à 33.7, et les faux positifs par image passent de 0.77 à 0.63. Les boîtes prédites peu fiables sont écartées, mais les changements d'identité remontent légèrement, à 475.
- Ajouter seulement les caractéristiques d'apparence (A) fait bondir l'IDF1 de 32.8 à 42.4, et les changements d'identité tombent à 234 ; mais le MOTA n'est que de 30.6, et les faux positifs par image montent même à 1.01.
- Avec les trois, on obtient un MOTA de 35.7, un IDF1 de 45.3 et 184 changements d'identité ; les quatre indicateurs sont à leur meilleur.
Les deux premiers composants améliorent surtout les indicateurs liés à la détection, les caractéristiques d'apparence surtout ceux liés à l'identité ; il faut les deux pour que tout soit en place.
Les caractéristiques d'apparence elles-mêmes ont aussi été comparées. Le tableau ci-dessous, d'après la Table 2 de l'article, compare différentes représentations d'apparence dans le même cadre :
| Apparence | Dim. | MOTA | IDF1 | Chang. d'ID |
|---|---|---|---|---|
| Sans apparence | – | 33.7 | 37.3 | 475 |
| Histogramme couleur | 750 | 34.9 | 38.6 | 250 |
| HOG | 1152 | 34.6 | 38.5 | 317 |
| Couleur + HOG | 1902 | 34.7 | 39.3 | 307 |
| Caractéristiques re-ID | 512 | 35.7 | 45.3 | 184 |
Les caractéristiques conçues à la main aident aussi, mais leur IDF1 plafonne autour de 39 ; les caractéristiques de re-ID apprises ont la plus petite dimension, et pourtant leur IDF1 est 6 points plus haut.
Vitesse
Les auteurs mesurent le temps de traitement par image sur MOT16-03, la séquence la plus encombrée (plus de 50 personnes par image en moyenne). Si l'on découpe chaque candidate pour la classifier séparément avec SqueezeNet suivi de deux couches entièrement connectées, il faut 206.2 millisecondes par image ; avec R-FCN et ses cartes de scores partagées, on descend à 66.3 millisecondes.
Le jeu de test MOT16
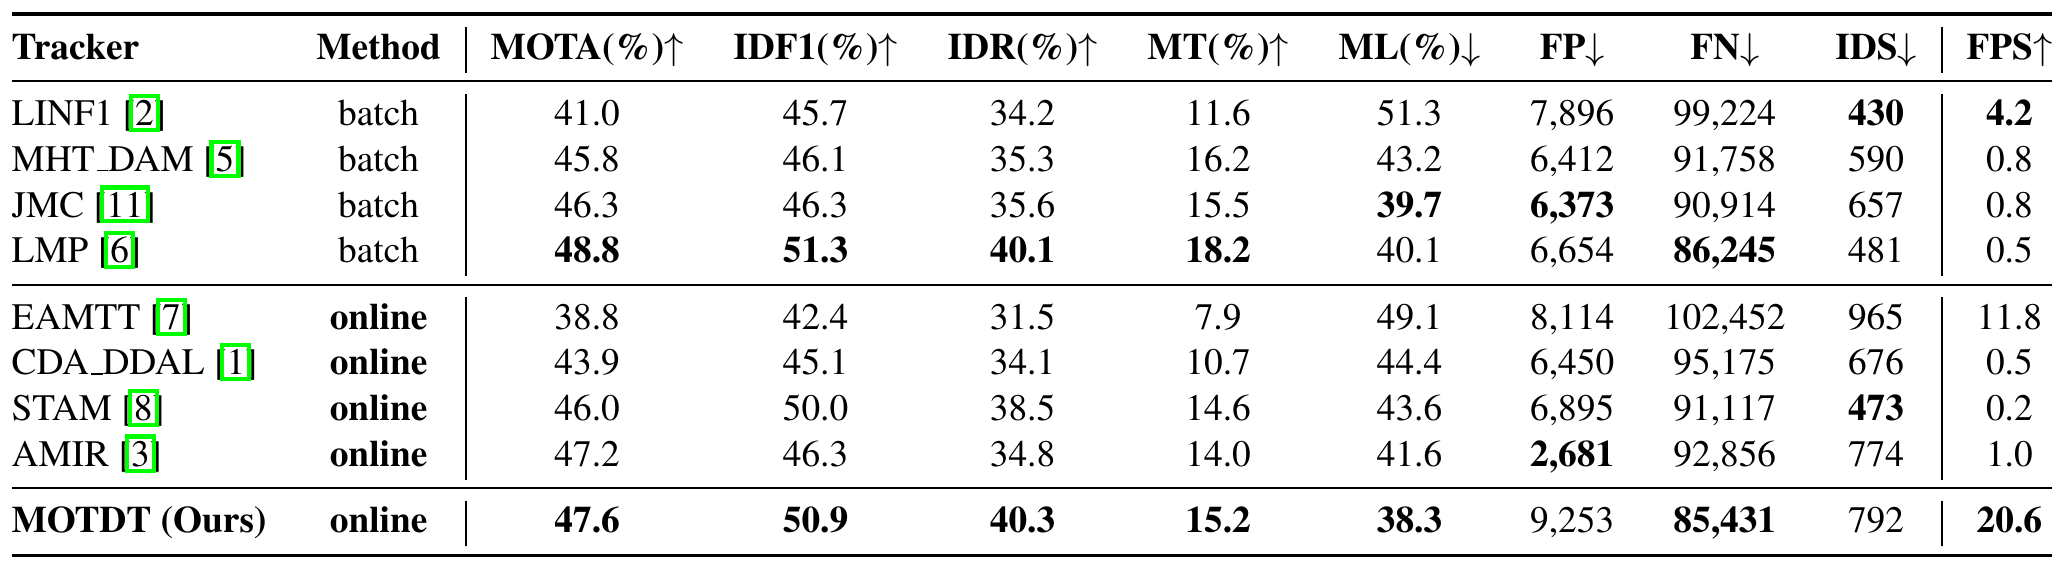
Avec les détections publiques, MOTDT obtient un MOTA de 47.6 et un IDF1 de 50.9, les deux meilleurs scores des méthodes en ligne du tableau ; son ML de 38.3 % et ses 85 431 FN sont même les plus bas de tout le tableau. Il tourne à 20.6 FPS, soit, selon les auteurs, environ 5 à 20 fois plus vite que la plupart des méthodes existantes ; dans le tableau, la plupart des méthodes ne traitent que 0.2 à 1 image par seconde, si bien que l'écart est en réalité plus grand. Face à LMP, la meilleure méthode hors ligne, le MOTA n'a que 1.2 point de retard, pour une vitesse 40 fois supérieure.
Deux colonnes sont toutefois moins flatteuses. Les FP s'élèvent à 9 253, plus du triple des 2 681 d'AMIR ; les 792 changements d'identité dépassent aussi les 473 de STAM et les 481 de LMP. On peut supposer qu'en prenant les boîtes prédites comme candidates, la méthode rattrape des détections manquées, mais garde aussi au passage des boîtes qui n'auraient pas dû exister.
La suite
Dans leur conclusion, les auteurs écrivent qu'ils veulent à l'avenir partager les couches de convolution entre la classification et les caractéristiques d'apparence, pour gagner encore en efficacité.
L'année suivante, Zhongdao Wang et ses collègues de Tsinghua publient JDE, qui produit à la fois les boîtes de détection et les caractéristiques de re-ID avec un seul réseau de détection ; au moment de l'association, son code officiel apparie lui aussi d'abord par l'apparence et le mouvement, puis traite le reste par l'IoU. L'année suivante, FairMOT reprend la même association en deux étapes. L'autre moitié de MOTDT, « prendre aussi les boîtes prédites comme candidates », n'a en revanche pas été reprise dans FairMOT.
En 2021, ByteTrack inclut MOTDT dans ses comparaisons, avec le même détecteur YOLOX, sur le jeu de validation de MOT17. MOTDT obtient un MOTA de 75.8, BYTE 76.6. Les auteurs de ByteTrack estiment qu'en utilisant les boîtes prédites comme boîtes de trajectoire, MOTDT risque de laisser la position dériver peu à peu ; BYTE, lui, va repêcher les personnes parmi les boîtes de détection à faible score, avec une position plus précise. Les deux articles traitent le même problème (comment éviter de perdre quelqu'un quand le détecteur n'est pas fiable), mais choisissent des matériaux de rattrapage différents.
Conclusion
MOTDT prend comme candidates à la fois les boîtes de détection et les boîtes prédites par les trajectoires ; un classifieur entièrement convolutif sensible à la position leur attribue un score unifié, et la confiance de trajectoire fait baisser les prédictions restées trop longtemps sans confirmation. À l'association, l'apparence ne sert qu'aux boîtes de détection, et l'IoU se charge du reste. Avec cette méthode, MOTDT obtient sur MOT16 le meilleur MOTA et le meilleur IDF1 des méthodes en ligne de l'époque, à 20 images par seconde.
Si vous voulez ajouter de la re-ID à votre traqueur, l'association hiérarchique est un point de départ très pratique. Les caractéristiques d'apparence ne sont extraites que des boîtes de détection fiables, et les boîtes prédites ne servent qu'à boucher les trous. La règle est simple, et elle évite directement l'erreur de « mémoriser le visage de quelqu'un d'autre comme le sien ».
Quant à la « sélection des candidates », qui occupe la moitié du titre, les traqueurs suivants n'en ont presque plus parlé.