Article original
FairMOT: On the Fairness of Detection and Re-Identification in Multiple Object Tracking
- Publication
- International Journal of Computer Vision 2021Revue
- Premier dépôt sur arXiv
- arXiv:2004.01888
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingfairmot2020,
  title = {{FairMOT: On the Fairness of Detection and Re-Identification in Multiple Object Tracking}},
  author = {Yifu Zhang and Chunyu Wang and Xinggang Wang and Wenjun Zeng and Wenyu Liu},
  year = {2020},
  eprint = {2004.01888},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2004.01888}
}
DeepSORT a appris au traqueur à reconnaître les gens, au prix d'un passage supplémentaire de chaque boîte de détection dans un réseau de re-ID. Dix personnes dans l'image, c'est dix découpes et dix calculs de caractéristiques ; cent personnes, cent calculs. Le détecteur et le réseau de re-ID extraient chacun leurs caractéristiques de l'image brute, sans rien partager.
Dès qu'il y a du monde, le système ralentit.
L'idée naturelle est de mettre les deux tâches dans un même réseau. Vers 2019, Track R-CNN ajoute une tête de re-ID à Mask R-CNN, et JDE (Joint Detection and Embedding) en ajoute une à YOLOv3 ; une seule passe avant produit à la fois les boîtes et les caractéristiques. Ces méthodes, appelées traqueurs one-shot, gagnent vraiment en vitesse, et leur détection reste correcte.
Mais les changements d'identité explosent.
Yifu Zhang, Chunyu Wang et leurs collègues, de l'université des sciences et technologies de Huazhong et de Microsoft Research Asia, veulent comprendre d'où vient le problème. Leur réponse, c'est que les deux tâches ne sont pas traitées équitablement dans le même réseau : la détection a toujours le premier rôle, et la re-ID n'est qu'un accessoire. La première version arXiv de l'article s'intitulait « A Simple Baseline for Multi-Object Tracking », avant de prendre son titre actuel, qui insiste sur « l'équité ».
Définir le problème
Si les traqueurs one-shot apprennent mal la re-ID, c'est, selon les auteurs, à cause de trois « injustices ».
L'injustice due aux ancres
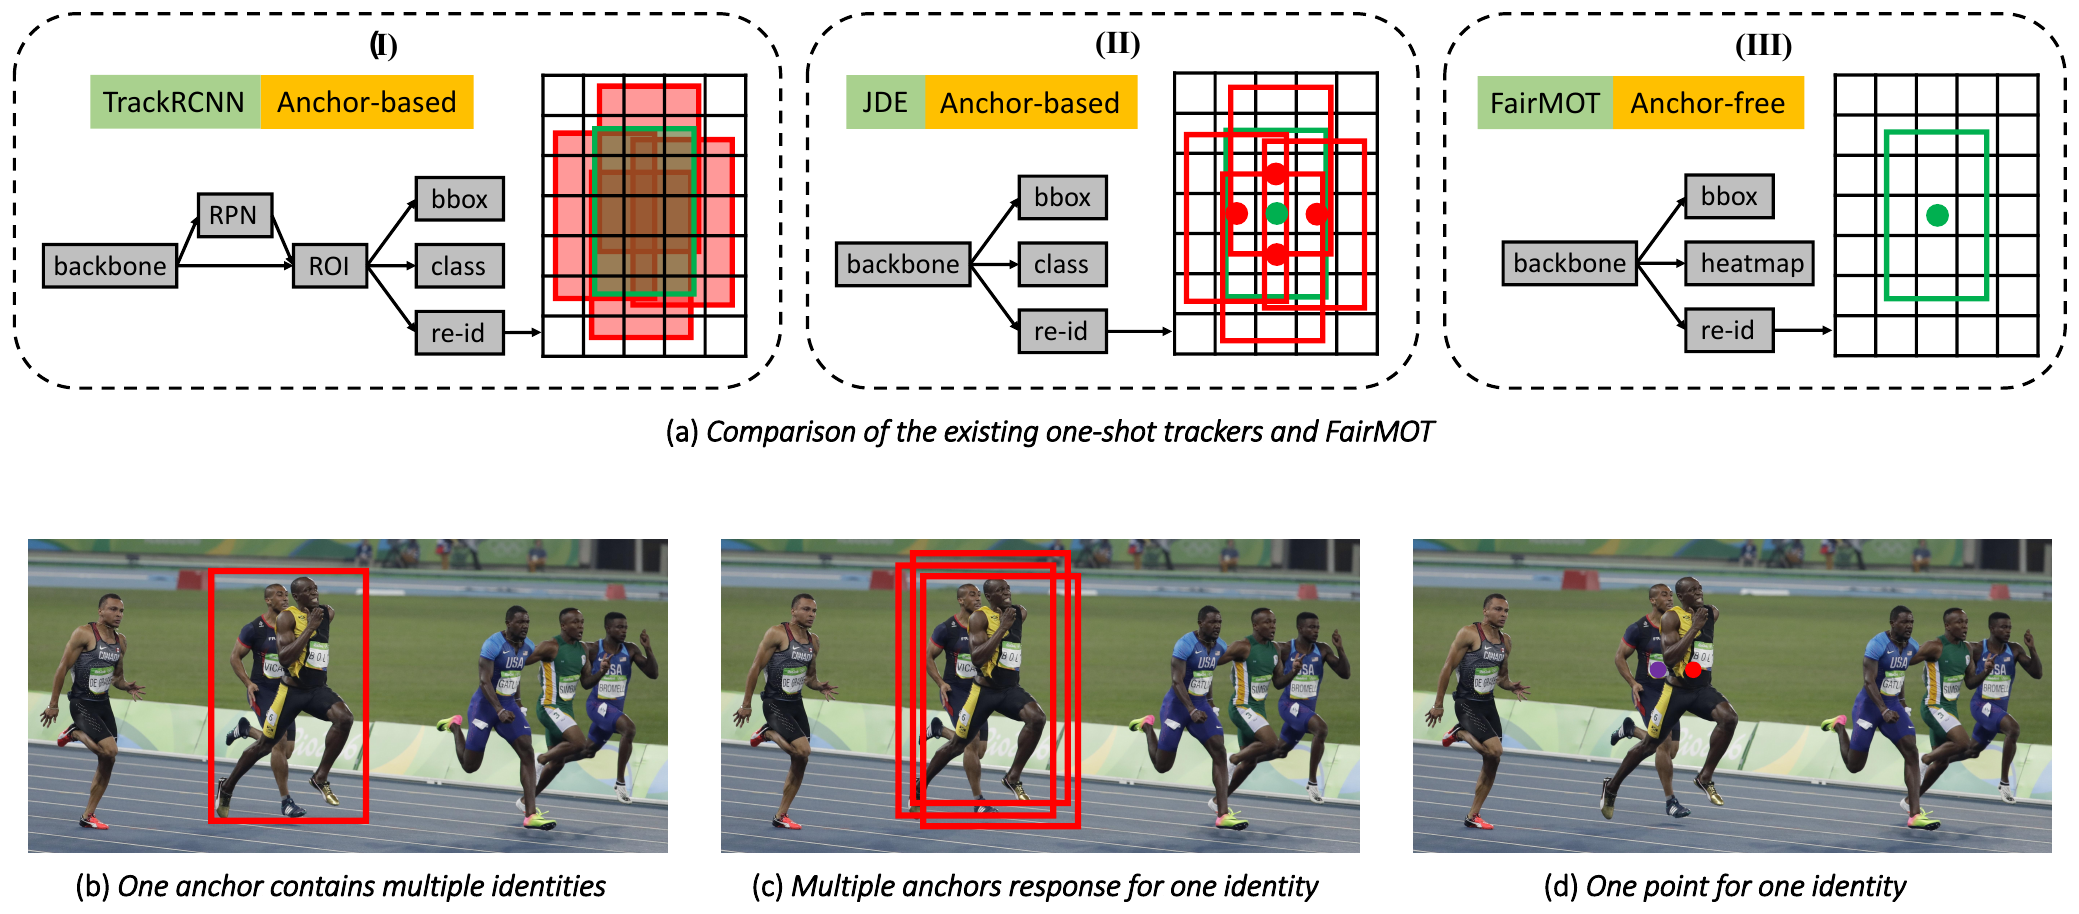
Track R-CNN et JDE sont tous deux dérivés de détecteurs à boîtes d'ancrage (anchor), et leurs caractéristiques de re-ID suivent les ancres. Cela pose trois problèmes :
- La re-ID est traitée comme une tâche secondaire. Track R-CNN génère d'abord des boîtes candidates avec le RPN, puis en extrait les caractéristiques de re-ID. Si les boîtes candidates sont imprécises, les caractéristiques ne valent rien ; à l'entraînement, le réseau apprend donc en priorité à bien produire les boîtes candidates, et la re-ID passe après.
- Une ancre correspond à plusieurs personnes. Dans la figure (b), la boîte rouge encadre deux sprinteurs à la fois. Quand on échantillonne la boîte avec RoI-Align, beaucoup de points tombent sur l'autre personne ou sur l'arrière-plan, et la caractéristique extraite mélange plusieurs personnes.
- Plusieurs ancres correspondent à la même personne. Dans la figure (c), trois ancres placées à des endroits différents ont toutes une IoU assez grande avec le même sprinteur, et doivent toutes produire la même identité. Ces trois ancres voient en réalité des portions d'image différentes, mais doivent apprendre la même caractéristique ; et il suffit qu'une augmentation de données décale un peu l'image pour que la même ancre soit attribuée à une autre personne.
En outre, les cartes de caractéristiques des détecteurs sont en général réduites d'un facteur 8, 16 ou 32 ; c'est acceptable pour la détection, mais trop grossier pour la re-ID, et la position des ancres risque fort de ne pas tomber sur le centre de l'objet.
L'injustice due aux caractéristiques
La détection et la re-ID attendent des caractéristiques très différentes. La détection veut que les objets d'une même classe aient des caractéristiques aussi semblables que possible ; quels que soient les vêtements de la personne, il faut reconnaître « c'est une personne ». La re-ID doit au contraire séparer les individus d'une même classe, et a besoin de plus de détails d'apparence de bas niveau.
Si les deux tâches partagent les mêmes caractéristiques, elles tirent chacune de leur côté.
L'injustice due aux dimensions
Le domaine de la re-ID utilise habituellement des caractéristiques de 512 ou 1024 dimensions, alors que la tête de détection ne produit que le nombre de classes plus quelques coordonnées de boîte. Selon les auteurs, un tel écart de dimensions fait que la perte de re-ID écrase celle de la détection.
Plus important encore, la re-ID du suivi multi-objets diffère de la re-ID ordinaire. La re-ID ordinaire compare une image requête à des dizaines de milliers de candidates, et a besoin d'un très fort pouvoir discriminant ; le suivi n'a besoin que de quelques appariements un à un entre deux images consécutives. Le suivi n'a pas l'usage d'autant de dimensions.
Résoudre le problème
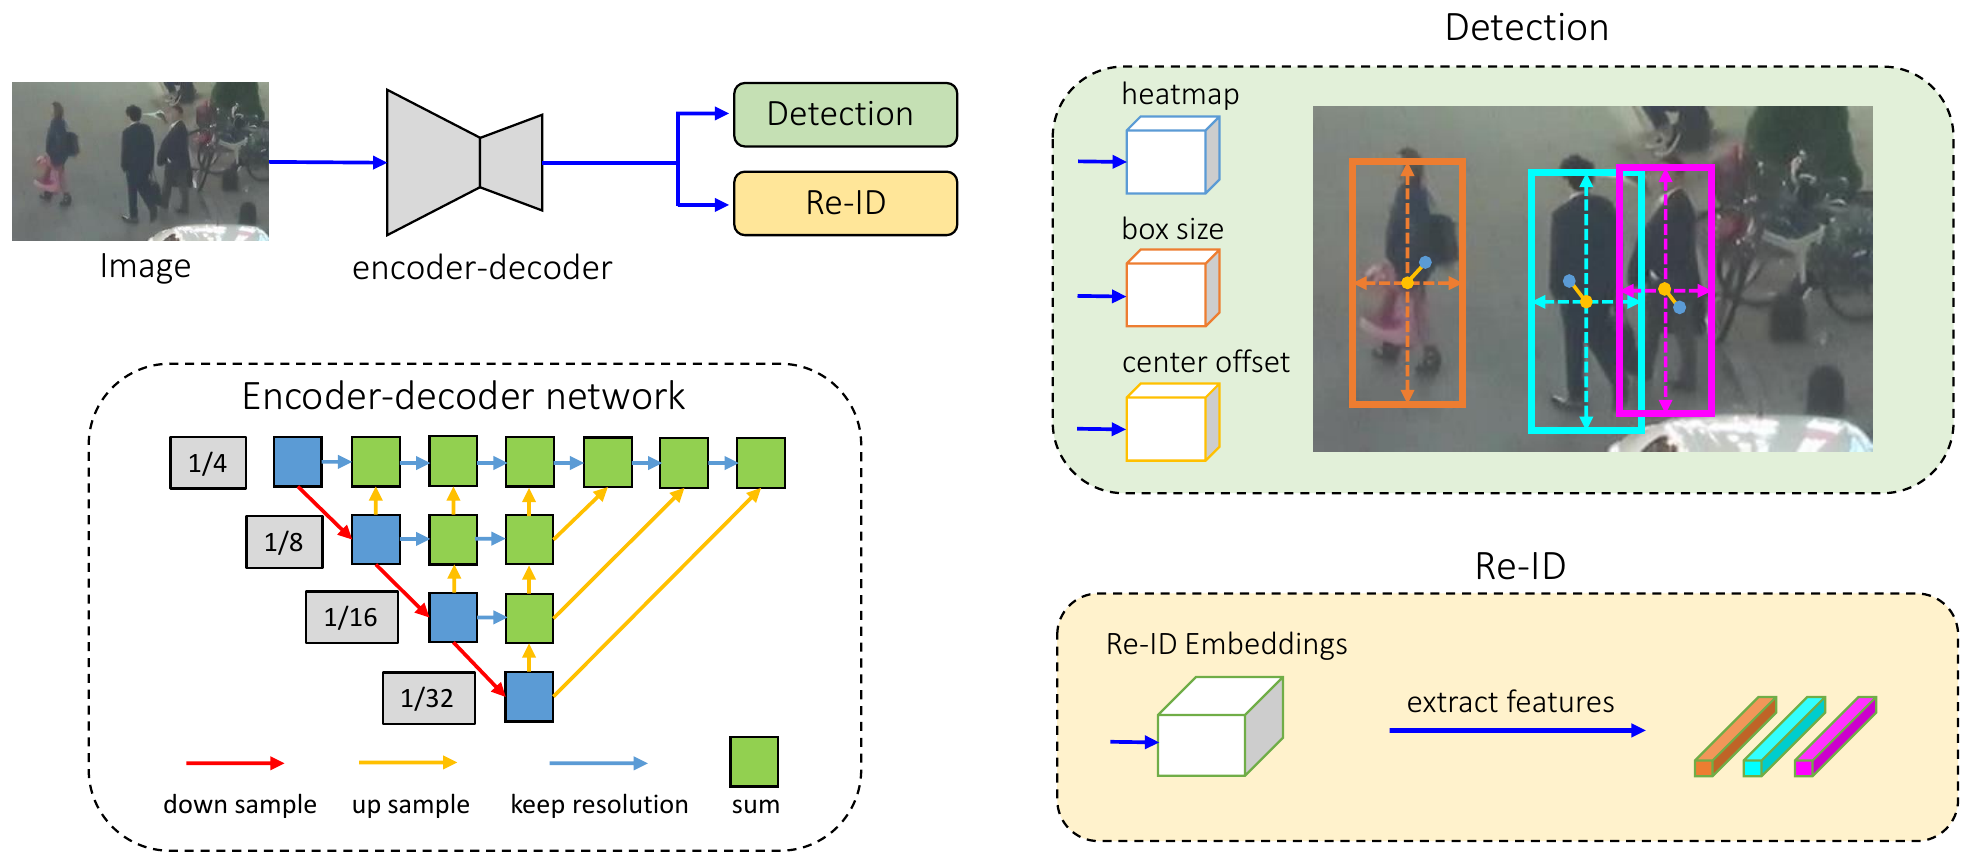
FairMOT apporte un remède à chacune des trois injustices. Il renonce aux ancres et adopte la détection de CenterNet, qui représente les objets par leur point central ; il utilise un backbone à fusion multicouche, pour que chaque tâche y prenne ce dont elle a besoin ; et il réduit la dimension des caractéristiques de re-ID.
Les deux branches ont exactement la même structure, et se branchent directement sur la même carte de caractéristiques produite par le backbone, sans que l'une passe avant l'autre.
Le backbone
Le backbone est DLA-34, formé d'un ResNet-34 et de la structure de fusion multicouche de Deep Layer Aggregation ; dans le module de suréchantillonnage, toutes les convolutions sont remplacées par des convolutions déformables (deformable convolution), pour que le champ récepteur s'adapte à la taille et à la posture des objets.
La carte de caractéristiques de sortie fait 1/4 de l'entrée. À l'entraînement comme à l'inférence, l'image d'entrée est redimensionnée en , et la carte de caractéristiques mesure donc .
Suivre une personne pas à pas
Prenons une personne pour voir comment les deux branches se partagent le travail sur la même carte de caractéristiques.
Supposons que, sur l'image d'entrée de , la boîte réelle d'une personne soit .
Première étape, trouver le centre. Le centre de la boîte est . La carte de caractéristiques est réduite d'un facteur 4 ; le centre tombe en , soit, après arrondi à l'entier, la cellule de la carte.
Deuxième étape, la carte de chaleur. La branche de carte de chaleur produit une carte de . L'objectif d'entraînement place un pic de valeur 1 en , qui décroît autour selon une gaussienne. S'il y a objets, la carte de chaleur cible est
La perte prend la forme de la focal loss de CenterNet. La prédiction doit être proche de 1 à la position du pic et proche de 0 ailleurs, mais plus une position est proche du pic, moins une erreur y est pénalisée.
Troisième étape, décalage et taille. L'arrondi à l'entier a fait perdre , ce qui peut causer jusqu'à 4 pixels d'erreur. Dans la cellule , la branche de décalage doit prédire pour ramener le centre à sa position exacte ; la branche de taille prédit, dans la même cellule, la largeur et la hauteur de la boîte, . Les deux utilisent une perte L1, et le terme de taille a un poids , repris de CenterNet.
Quatrième étape, la re-ID. La branche de re-ID utilise une convolution à 128 noyaux et produit ; chaque cellule a une caractéristique de 128 dimensions. La caractéristique de cette personne est le vecteur , pris dans en .
C'est là que se trouve le choix de conception décisif de FairMOT. Une personne ne correspond qu'à un seul point de la carte de caractéristiques, et carte de chaleur, décalage, taille et re-ID sont tous lus en ce point. Sans ancres, il n'y a plus de problème du type « une ancre, deux personnes » ou « trois ancres, une personne ».
L'entraînement de la re-ID
L'entraînement de la re-ID est traité comme un problème de classification. Chaque identité du jeu d'entraînement est une classe, classes en tout. La caractéristique prise au centre de l'objet passe par une couche entièrement connectée et un softmax, qui donnent la probabilité que l'objet appartienne à chaque identité, et la perte est calculée par entropie croisée :
L'entraînement n'utilise que les caractéristiques prises aux points centraux réels. À l'inférence, le centre de l'objet est déterminé par la carte de chaleur, et la caractéristique extraite sert directement à la comparaison ; la couche de classification ne sert plus.
L'équilibre entre les deux tâches
La perte de détection est la somme de la perte de carte de chaleur et de la perte de boîte, . Les pertes des deux tâches ne sont pas simplement additionnées ; elles sont pondérées par l'incertitude, selon la méthode de Kendall et al. :
et sont des paramètres apprenables. Plus la perte d'une tâche est grande et incertaine, plus son poids est réduit, mais les termes pénalisent une réduction illimitée des poids. Le réseau décide lui-même de la part qui revient à chaque tâche.
S'entraîner sur des images isolées
Les données de suivi exigent des annotations d'identité d'une image à l'autre, ce qui coûte cher. Les auteurs proposent en plus un « entraînement sur images isolées » : on prend des données de détection de piétons comme CrowdHuman, qui n'ont que des boîtes sans identités, on traite chaque boîte comme une identité distincte, puis on applique à toute l'image des augmentations de rotation, de mise à l'échelle, de translation, de couleur, etc.
La re-ID ainsi entraînée apprend que « cette personne est différente des autres personnes de l'image ». L'article qualifie cette méthode d'auto-supervisée, la documentation du code officiel parle de supervision faible ; quel que soit le nom, elle utilise des annotations de boîtes, et fait l'économie des annotations d'identité.
Inférence et association
À l'inférence, un max pooling sur la carte de chaleur fait office de suppression des non-maxima ; on garde les pics dont le score dépasse un seuil, puis on calcule les boîtes à partir des branches de décalage et de taille, et on prend les caractéristiques dans la branche de re-ID.
L'association reprend les deux étapes de MOTDT :
- Première étape, l'apparence d'abord. Un filtre de Kalman prédit la position de chaque trajectoire, et l'on calcule la distance de Mahalanobis ; on calcule aussi la distance cosinus entre les caractéristiques de re-ID des trajectoires et des détections. Les deux sont pondérées en , avec , et les paires dont la distance de Mahalanobis est trop grande sont exclues d'office. L'appariement se fait par l'algorithme hongrois, avec un seuil de 0.4.
- Deuxième étape, l'IoU pour combler les manques. Les boîtes de détection et les trajectoires restées sans partenaire sont appariées une nouvelle fois par l'IoU des boîtes, avec un seuil de 0.5.
Les caractéristiques d'apparence des trajectoires sont mises à jour à chaque image, pour s'adapter aux changements d'apparence. Les boîtes de détection toujours sans partenaire à la fin deviennent de nouvelles trajectoires ; les trajectoires sans appariement sont gardées 30 images, au cas où elles reviendraient.
Discussion
Les données d'entraînement sont les mêmes que pour JDE, et s'appellent MIX. ETH et CityPersons n'y ont que des boîtes et n'entraînent que la branche de détection ; CalTech, MOT17, CUHK-SYSU et PRW ont des annotations d'identité et entraînent les deux branches. Les ablations sont toutes faites sur le jeu de validation de MOT17.
La qualité de la re-ID est mesurée par la TPR@FAR=0.1, c'est-à-dire le taux de vrais positifs, à un taux de fausses acceptations de 0.1, d'une recherche faite avec les caractéristiques prises aux positions des boîtes réelles. Cet indicateur ne dépend pas des résultats de détection ; il ne juge que la qualité des caractéristiques elles-mêmes.
Où prendre les caractéristiques
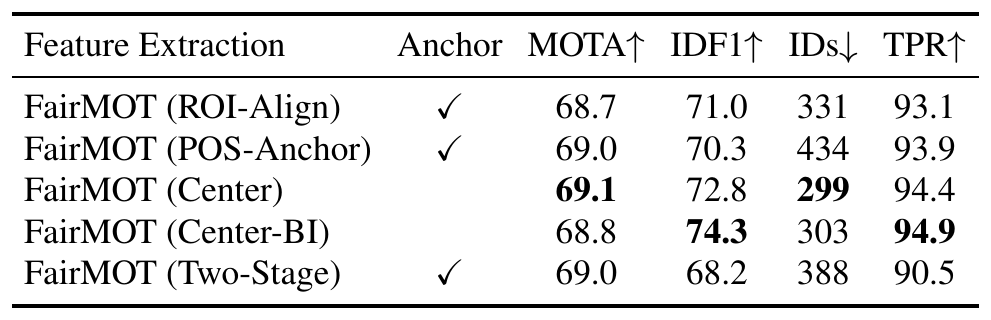
Les cinq méthodes sont toutes construites sur FairMOT ; la seule différence est l'endroit où l'on prend les caractéristiques de re-ID. ROI-Align est l'approche de Track R-CNN, POS-Anchor celle de JDE, Center celle de FairMOT ; Center-BI prend une position plus précise au centre par interpolation bilinéaire, et Two-Stage détecte d'abord, puis fait un ROI-Align sur les boîtes de détection.
Le MOTA tourne partout autour de 69, car la branche de détection est la même. La différence se joue sur l'IDF1 et les changements d'identité. Center compte 299 changements d'identité, environ 30 % de moins que les 434 de POS-Anchor ; Center-BI a la meilleure TPR. Le pire est Two-Stage, avec un IDF1 de seulement 68.2 et une TPR qui tombe à 90.5. Rendre la re-ID dépendante des résultats de détection pendant l'entraînement dégrade bel et bien la qualité des caractéristiques.
Détection et re-ID se battent-elles vraiment ?
Les auteurs font une expérience très directe. Avec un backbone ResNet-34, un premier groupe entraîne les deux branches ensemble, un second n'entraîne que la branche de détection, la branche de re-ID restant à son initialisation aléatoire.
Avec la détection seule, l'AP passe de 75.1 à 76.1 ; entraîner les deux tâches ensemble pénalise bien la détection. Fait intéressant, le groupe entraîné sur la seule détection a même un MOTA légèrement supérieur (63.7 contre 63.6), mais son IDF1 tombe de 67.2 à 60.4, et sa TPR de 90.9 à 36.7. Le MOTA dépend surtout de la détection ; même quand les caractéristiques de re-ID ne servent presque à rien, il ne le voit pas.
Avec DLA-34, et sa fusion multicouche, l'AP est de 81.2 et la TPR de 94.4, toutes deux meilleures qu'avec ResNet-34. Selon l'interprétation des auteurs, la fusion multicouche permet à chaque tâche de prendre dans des couches différentes les caractéristiques dont elle a besoin, et le conflit s'atténue.
La comparaison des backbones va dans le même sens. ResNet-50 est plus grand que ResNet-34 et plus précis sur ImageNet, mais le MOTA ne passe que de 63.6 à 63.7, et les changements d'identité augmentent même, de 435 à 501 ; ResNet-34 avec un FPN a moins de paramètres que ResNet-50, mais sa TPR passe de 90.9 à 94.2. Si l'on remplace dans DLA-34 les convolutions déformables par des convolutions ordinaires, le MOTA tombe de 69.1 à 65.0, et l'AP de 81.2 à 78.1. Une méthode qui ne prend ses caractéristiques qu'au seul point central dépend beaucoup d'un champ récepteur capable de s'adapter à la taille des objets.
Mieux vaut moins de dimensions
En réduisant les caractéristiques de re-ID de 512 à 64 dimensions :
- JDE : MOTA 59.9 → 60.3, IDF1 64.1 → 65.0, changements d'identité 536 → 474, TPR 76.8 → 82.0. Tout s'améliore.
- FairMOT : MOTA 68.5 → 69.2, AP 80.9 → 81.3, changements d'identité 312 → 283 ; mais l'IDF1 baisse légèrement, de 73.7 à 73.3, et la TPR de 94.6 à 94.3.
Le résultat de FairMOT est plus nuancé. Les caractéristiques de grande dimension sont un peu plus discriminantes en elles-mêmes, mais elles pénalisent la détection, et quand la détection se dégrade, tout le suivi suit. Les auteurs retiennent finalement 128 dimensions.
Comment pondérer les pertes
Avec des poids fixes (trouvés par recherche sur grille), le MOTA et l'AP sont les plus élevés et la TPR la plus basse ; le modèle penche vers la détection. MGDA-UB a la TPR la plus haute et le MOTA et l'AP les plus bas ; il penche vers la re-ID. GradNorm a le meilleur IDF1 et l'ensemble le plus équilibré, mais un entraînement plus long. Les auteurs choisissent finalement la pondération par l'incertitude, un peu moins bonne, mais bien plus simple.
Les trois pièces de l'association
Avec l'IoU seule pour l'association, on compte 648 changements d'identité ; avec les seules caractéristiques de re-ID, 435 ; avec la re-ID et le filtre de Kalman, 342 ; avec les trois, 299. Dans les scènes encombrées ou quand la caméra bouge vite, l'IoU seule fait sans cesse changer les ID ; quand un objet est partiellement masqué, les caractéristiques de re-ID deviennent peu fiables, et il faut alors les boîtes et le mouvement en renfort.
L'entraînement sur images isolées
Un modèle entraîné uniquement sur les images isolées de CrowdHuman, sans avoir jamais vu d'annotation d'identité, obtient directement sur le jeu de validation de MOT17 un MOTA de 64.1 et un IDF1 de 64.9. Préentraîné sur CrowdHuman puis affiné sur MOT17, il obtient un MOTA de 71.1 et un IDF1 de 75.6, bien au-dessus des 67.5 et 69.9 d'un entraînement sur MOT17 seul, et même au-dessus des 69.1 et 72.8 obtenus avec MIX plus MOT17.
MOTChallenge
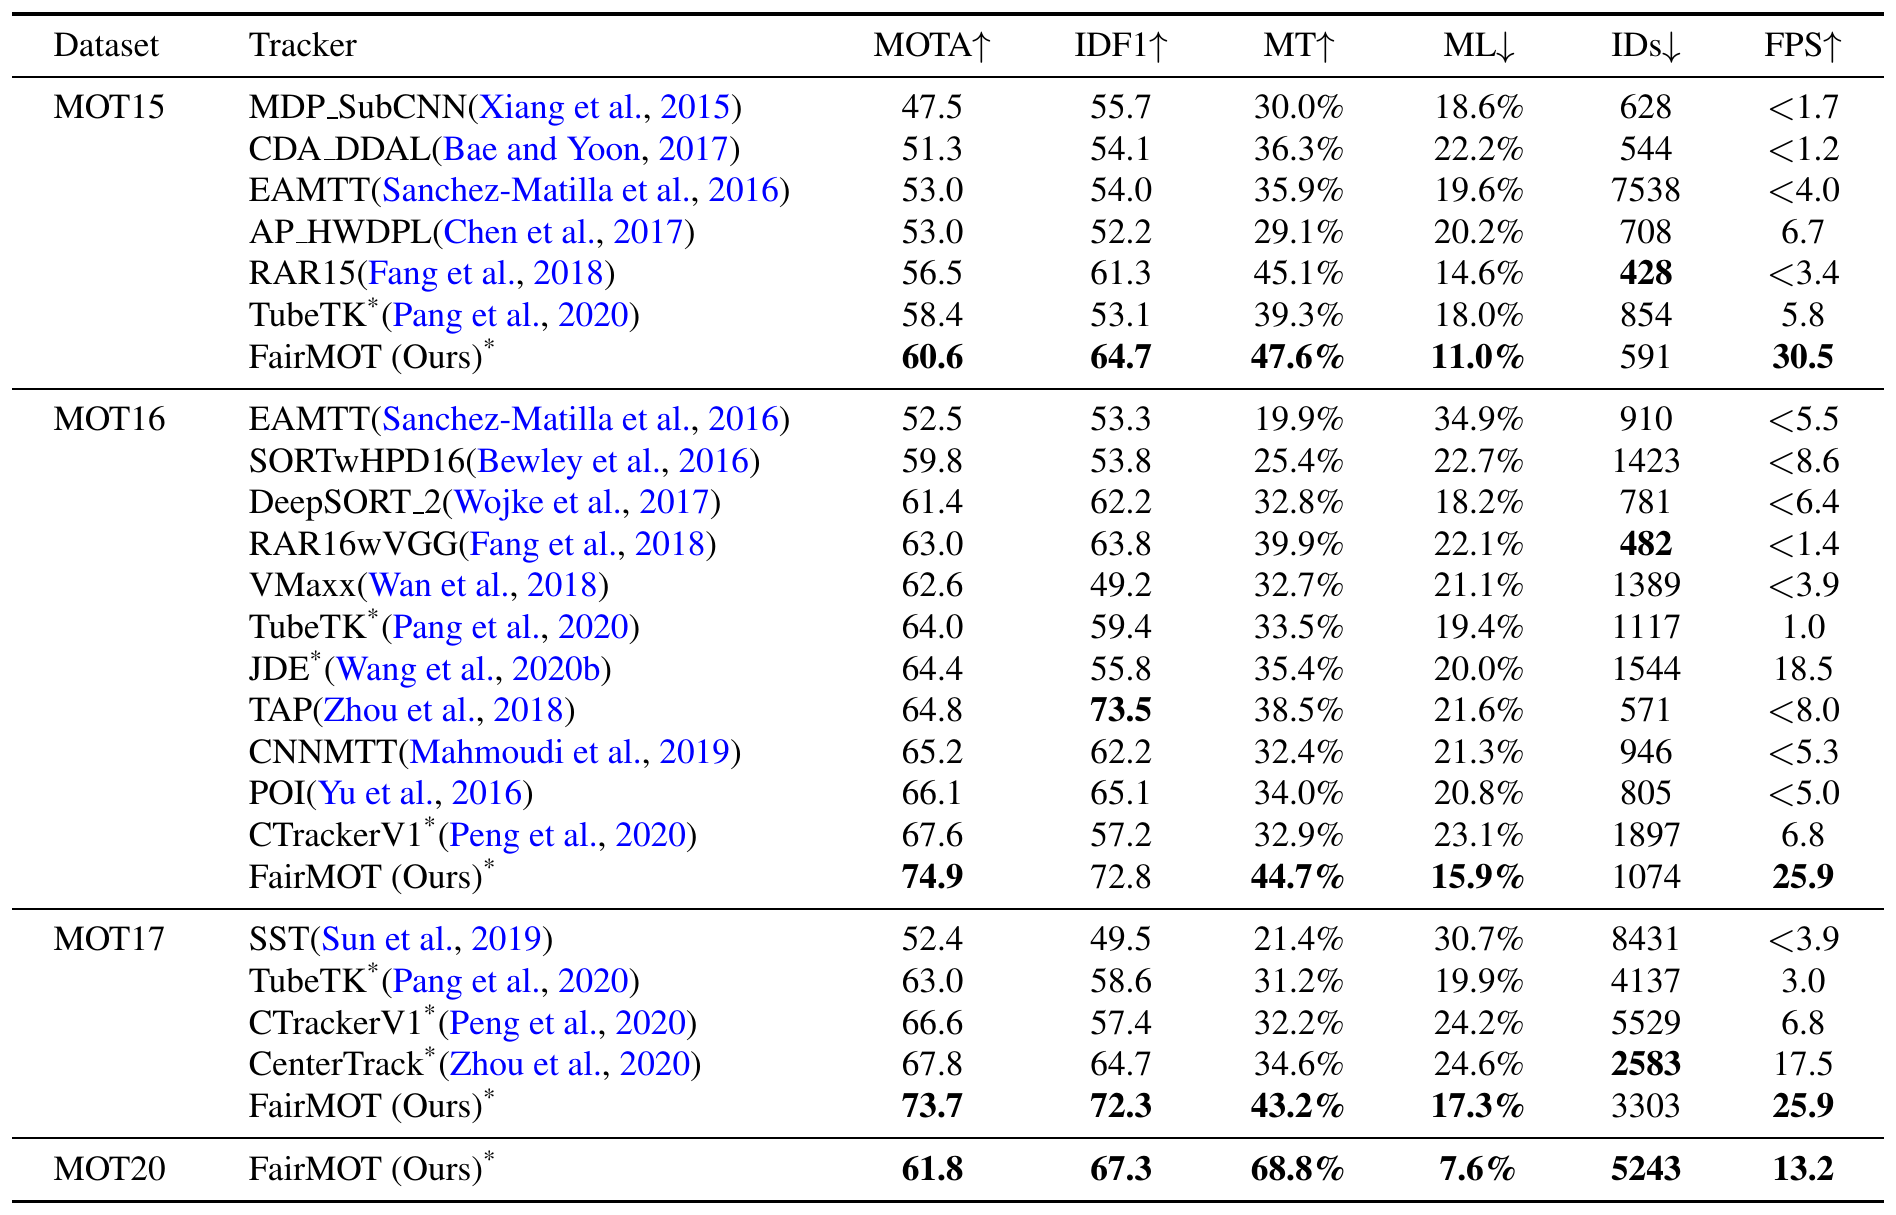
Ce tableau suit les règles private detector, où chacun utilise son propre détecteur. Les FPS comptent à la fois la détection et l'association, ce qui est plus sévère pour les méthodes two-step, et c'est justement ce que les traqueurs one-shot veulent démontrer.
FairMOT arrive premier sur les quatre jeux de données. Sur MOT17, son MOTA de 73.7 et son IDF1 de 72.3 dépassent d'environ 6 et 8 points ceux de CenterTrack, lui aussi one-shot, à 25.9 FPS. Sur MOT16, face à DeepSORT (DeepSORT_2 dans le tableau), le MOTA passe de 61.4 à 74.9, et la vitesse de moins de 6.4 FPS à 25.9.
La colonne des changements d'identité mérite toutefois un examen attentif. Sur MOT16, les 1074 changements de FairMOT dépassent les 781 de DeepSORT_2. FairMOT détecte davantage, avec un MT plus haut et un ML plus bas ; il suit davantage de trajectoires au départ, et le nombre absolu de changements d'identité augmente avec. Pour comparer la capacité à maintenir les identités, l'IDF1 est un indicateur plus adapté.
Côté vitesse, FairMOT ne tourne plus qu'à 13.2 FPS sur MOT20. En analysant le temps de chaque partie, les auteurs constatent que l'inférence du réseau de détection et de re-ID n'est presque pas affectée par le nombre de personnes, et que le filtre de Kalman et l'appariement par IoU ne prennent que 1 ou 2 millisecondes ; ce qui croît linéairement avec le nombre de personnes, c'est le temps de mise à jour des caractéristiques d'apparence de chaque trajectoire lors de la comparaison de re-ID.
La suite
Les critiques ultérieures de la communauté portent surtout sur les scènes encombrées. En 2023, par exemple, CSMOT relève que, dans les scènes encombrées, la détection de FairMOT manque de précision et ses caractéristiques de re-ID de pouvoir discriminant, et que ses performances de suivi baissent nettement. On peut supposer que cela tient au choix de ne prendre les caractéristiques qu'en un seul point central. Quand les gens sont serrés les uns contre les autres, autour du point central d'une personne, il y a souvent le corps de quelqu'un d'autre.
Conclusion
Pour l'explosion des changements d'identité des traqueurs one-shot, FairMOT trouve trois causes. Les ancres font apprendre à la re-ID des caractéristiques mélangées, le partage des caractéristiques fait tirer les deux tâches chacune de leur côté, et les caractéristiques de grande dimension écrasent la détection ; les remèdes correspondants consistent à représenter les objets par leur point central, à utiliser un backbone à fusion multicouche et à réduire la re-ID à 128 dimensions. Résultat, la méthode arrive première sur quatre jeux de données de MOTChallenge, avec un système complet à environ 26 images par seconde.
Quand vous mettez deux tâches dans un même réseau, pensez à mesurer séparément les indicateurs de re-ID. Dans le groupe entraîné sur la seule détection, les caractéristiques ne servaient déjà presque plus à rien, et le MOTA, lui, n'avait pas bougé d'un pouce.
Détail amusant, ByteTrack, signé Yifu Zhang un an et demi plus tard, se passe carrément de re-ID sur MOT17.