Article original
MOTRv2: Bootstrapping End-to-End Multi-Object Tracking by Pretrained Object Detectors
- Publication
- CVPR 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2211.09791
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingmotrv22022,
  title = {{MOTRv2: Bootstrapping End-to-End Multi-Object Tracking by Pretrained Object Detectors}},
  author = {Yuang Zhang and Tiancai Wang and Xiangyu Zhang},
  year = {2022},
  eprint = {2211.09791},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2211.09791}
}
MOTR a rendu le suivi multi-objets entièrement de bout en bout ; les requêtes de piste se transmettent d'image en image, les nouveaux objets reviennent aux requêtes de détection, et il n'y a besoin d'aucun appariement ni post-traitement.
Sur DanceTrack, MOTR avait la meilleure capacité d'association de l'époque, avec un AssA de 40.2, au-dessus de méthodes d'appariement par le mouvement comme ByteTrack et OC-SORT. Mais sa détection pèche. Sur DanceTrack, son DetA n'est que de 73.5, nettement sous les 80.3 d'OC-SORT ; sur MOT17, son MOTA de 73.4 est à près de 7 points des 80.3 de ByteTrack.
Yuang Zhang, de l'Université Jiao Tong de Shanghai, et Tiancai Wang et Xiangyu Zhang, de MEGVII, tous membres de l'équipe d'origine de MOTR, pensent que le problème vient de ce qu'un même décodeur doit apprendre deux choses à la fois. Dans MOTR, détection et association tirent chacune de leur côté, et la détection en pâtit.
Alors, autant appeler à la rescousse un détecteur tout prêt et très performant.
Définir le problème
La façon la plus directe de brancher un détecteur externe sur MOTR consiste à imiter TransTrack ; les requêtes de piste prédisent des boîtes, qui sont ensuite appariées par IoU avec celles du détecteur.
Les auteurs l'ont essayé ; la détection ne s'améliore que légèrement, et l'on retombe dans la vieille ornière du « prédire d'abord, apparier ensuite », en perdant au passage le caractère de bout en bout de MOTR.
Ce que veulent les auteurs, c'est prendre les détections en entrée, comme en tracking-by-detection, pour que MOTR n'ait plus qu'à se concentrer sur l'apprentissage de l'association. Comment « nourrir » avec des résultats de détection un Transformer centré sur les requêtes, voilà le problème que l'article veut résoudre.
Résoudre le problème
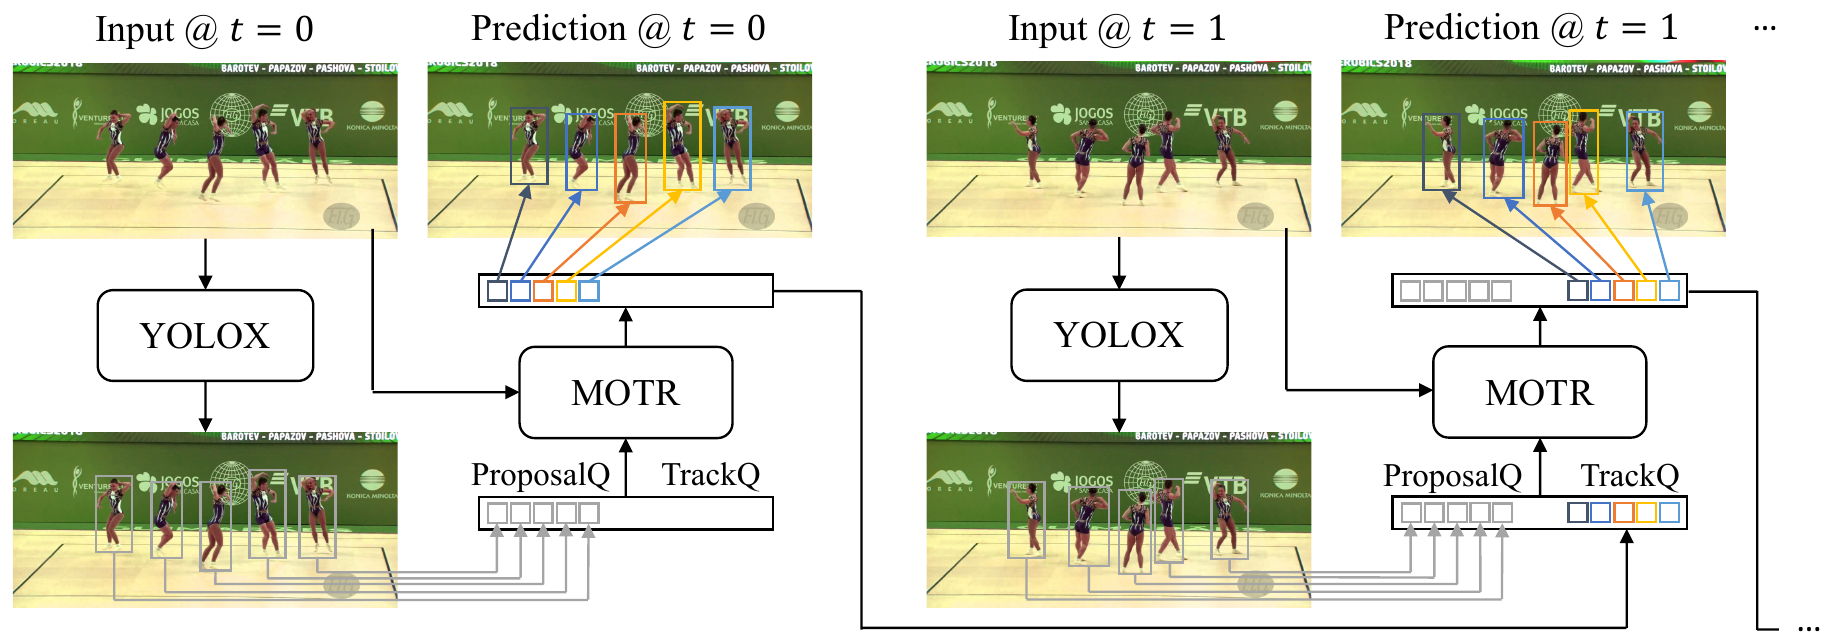
MOTRv2 se compose d'un détecteur YOLOX tout prêt et d'un MOTR modifié pour fonctionner avec des ancres.
Des requêtes à ancres
L'étape clé vient d'une idée de détecteurs comme DAB-DETR. Une requête n'est pas seulement un embedding abstrait ; elle porte aussi une boîte d'ancrage explicite (centre, largeur, hauteur). Le décodeur n'a plus qu'à prédire un décalage par rapport à l'ancre, ce qui facilite beaucoup la détection.
Les auteurs réécrivent les requêtes de détection et les requêtes de piste de MOTR sous cette forme à ancres. L'embedding de position apprenable d'origine est remplacé par un encodage sinus-cosinus des coordonnées de l'ancre.
Les boîtes du détecteur externe peuvent alors servir directement d'ancres, et l'information a priori de la détection entre ainsi dans MOTR.
Les requêtes de proposition
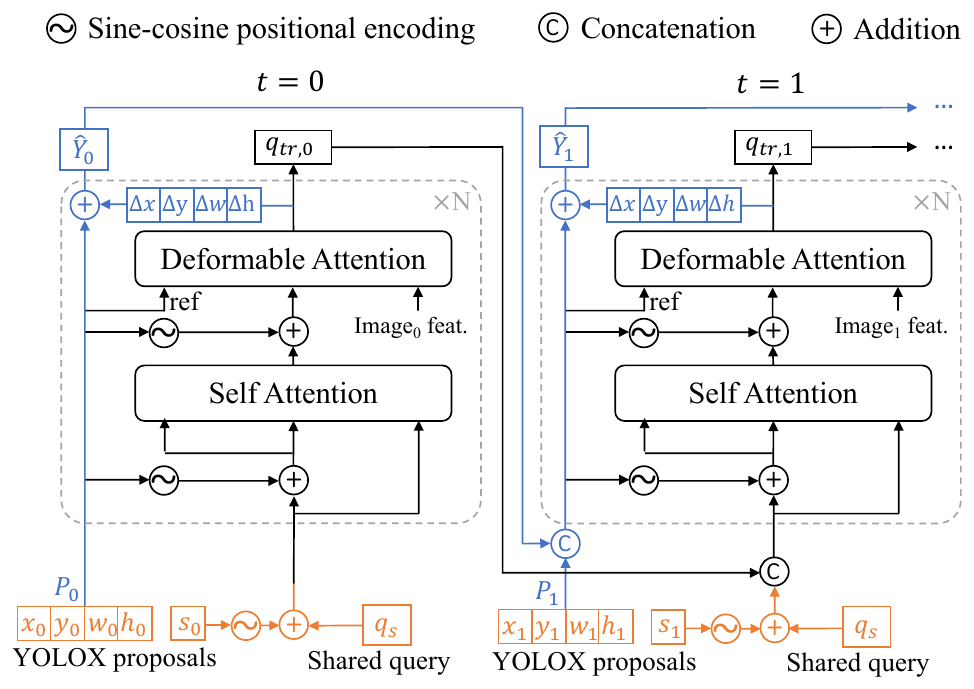
À chaque image, YOLOX produit boîtes candidates, chacune avec un centre , une largeur et une hauteur et un score de confiance . Pour manquer le moins d'objets possible, toute boîte dont le score dépasse 0.05 est conservée.
Les requêtes de proposition (proposal queries) sont produites en trois étapes :
- Une requête partagée apprenable , de taille , est dupliquée en .
- Le score de confiance de chaque boîte candidate est encodé en sinus-cosinus en un vecteur de dimension .
- La somme des deux donne les requêtes de proposition de l'image ; les boîtes candidates elles-mêmes leur servent d'ancres.
Toutes les requêtes de proposition partagent le même embedding ; elles ne diffèrent que par la position de leur ancre et leur score de confiance. Les auteurs gardent en plus 10 ancres apprenables, pour rattraper les objets manqués par YOLOX.
Les auteurs ont aussi vérifié s'il fallait encoder le score de confiance. Sans score, le HOTA de validation est de 63.0 ; avec une projection linéaire, 63.4 ; avec un encodage sinus-cosinus, 63.7. Le score de confiance est une information utile pour MOTR.
Transmettre les boîtes
La première image ne contient que de nouveaux objets. Les requêtes de proposition passent par le décodeur, qui produit des décalages par rapport aux boîtes de YOLOX ; ajoutés à celles-ci, ils donnent les boîtes prédites , et les requêtes mises à jour deviennent les requêtes de piste .
À chaque image suivante, les requêtes de piste de l'image précédente sont concaténées aux requêtes de proposition de l'image courante ; les boîtes prédites de l'image précédente sont de même concaténées aux boîtes YOLOX de l'image courante , et servent d'ancres à toutes les requêtes.
La répartition des rôles est ainsi fixée. Les requêtes de proposition ne s'occupent que des objets nouvellement apparus ou manqués jusque-là, et les requêtes de piste relocalisent les objets déjà suivis. La coordination entre les deux revient à l'auto-attention du décodeur. Les requêtes de proposition doivent regarder les requêtes de piste pour ne pas détecter une seconde fois une personne déjà suivie ; les requêtes de piste peuvent aussi s'appuyer sur les boîtes de YOLOX pour se positionner plus précisément.
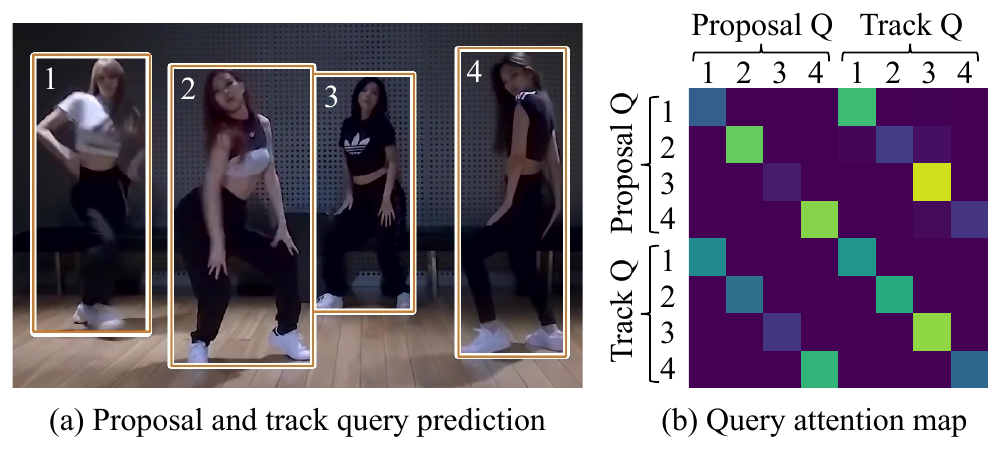
Les auteurs tracent la carte d'auto-attention. Entre la requête de proposition et la requête de piste d'une même personne, l'attention est nettement plus élevée ; les deux échangent bel et bien de l'information.
MOTR ne transmettait que le centre comme point de référence ; MOTRv2 transmet la boîte complète. Les auteurs comparent les deux approches ; sur l'AssA de la validation de DanceTrack, transmettre seulement le centre donne 49.2, et transmettre toute la boîte 53.1. La largeur et la hauteur de la boîte précédente aident beaucoup l'association.
Entraînement
À l'entraînement, chaque extrait compte 5 images, avec un intervalle entre images tiré au hasard entre 1 et 10.
Le MOTR d'origine insérait artificiellement de fausses requêtes de piste, ou en supprimait de vraies au hasard, pour simuler faux positifs et détections manquées. MOTRv2 ne le fait plus ; il transmet simplement les requêtes de piste dont le score de confiance dépasse 0.5. Les faux positifs et les détections manquées qui surviennent naturellement pendant l'entraînement constituent l'augmentation la plus réaliste.
Sur DanceTrack et MOT17, YOLOX n'est pas réentraîné ; les auteurs utilisent directement les poids publiés officiellement par DanceTrack et ByteTrack, et calculent à l'avance les boîtes candidates de toutes les images avant l'entraînement.
Deux autres astuces d'entraînement :
- Mélanger CrowdHuman. Comme pour MOTR, des images isolées de CrowdHuman sont transformées en fausses vidéos de 5 images, utilisées à l'entraînement avec DanceTrack.
- Débruitage des requêtes. La tâche auxiliaire de débruitage de DN-DETR est empruntée pour accélérer la convergence. Mais le bruit par défaut est trop fort, plus grand que le déplacement entre deux images adjacentes, et nuit à l'association ; en réduisant ce bruit, les auteurs gagnent 2.1 points de DetA.
Discussion
Ajouter les éléments un à un
| Réglage | HOTA val. | HOTA test |
|---|---|---|
| MOTR | 51.7 | 54.2 |
| + ajustements d'implémentation | 54.8 | |
| + transmission de la boîte entière | 57.1 | |
| + YOLOX et CrowdHuman | 63.7 | |
| + débruitage des requêtes | 64.5 | 69.9 |
| + association extra, données de val., ensemble de modèles | 73.4 |
D'après la Table 5 de l'article, DanceTrack ; chaque ligne s'ajoute à la précédente.
Des 54.2 de MOTR aux 69.9 de MOTRv2, le HOTA de test gagne 15.7 points. Le plus grand pas est le branchement de YOLOX avec un entraînement mêlé à CrowdHuman, qui fait gagner d'un coup 6.6 points en validation.
Les auteurs décomposent à part cette étape YOLOX et CrowdHuman :
| CrowdHuman | YOLOX | HOTA | DetA | AssA |
|---|---|---|---|---|
| 57.1 | 66.2 | 49.5 | ||
| ✓ | 60.7 | 74.8 | 49.6 | |
| ✓ | 56.7 | 73.7 | 43.9 | |
| ✓ | ✓ | 63.7 | 76.6 | 53.2 |
D'après la Table 6 de l'article, ensemble de validation de DanceTrack.
Avec CrowdHuman seul, la détection s'améliore, mais AssA perd 5.6 points, et HOTA baisse même légèrement. Selon les auteurs, les fausses vidéos de CrowdHuman sont produites par transformations affines, et le « mouvement » des personnes y est très différent de la danse ; de plus, l'entraînement se trouve détourné vers davantage de détections difficiles, au profit de la détection et au détriment de l'association.
Avec YOLOX, la situation s'inverse. La détection étant confiée à YOLOX, MOTR n'a plus à se débattre avec elle, et les données supplémentaires de CrowdHuman se transforment en capacité d'association ; AssA passe de 49.6 à 53.2.
Pris ensemble, ces deux tableaux illustrent exactement la thèse centrale de l'article. Dans MOTR, détection et association entrent en conflit, et c'est en déchargeant la détection que l'association peut être bien apprise.
DanceTrack
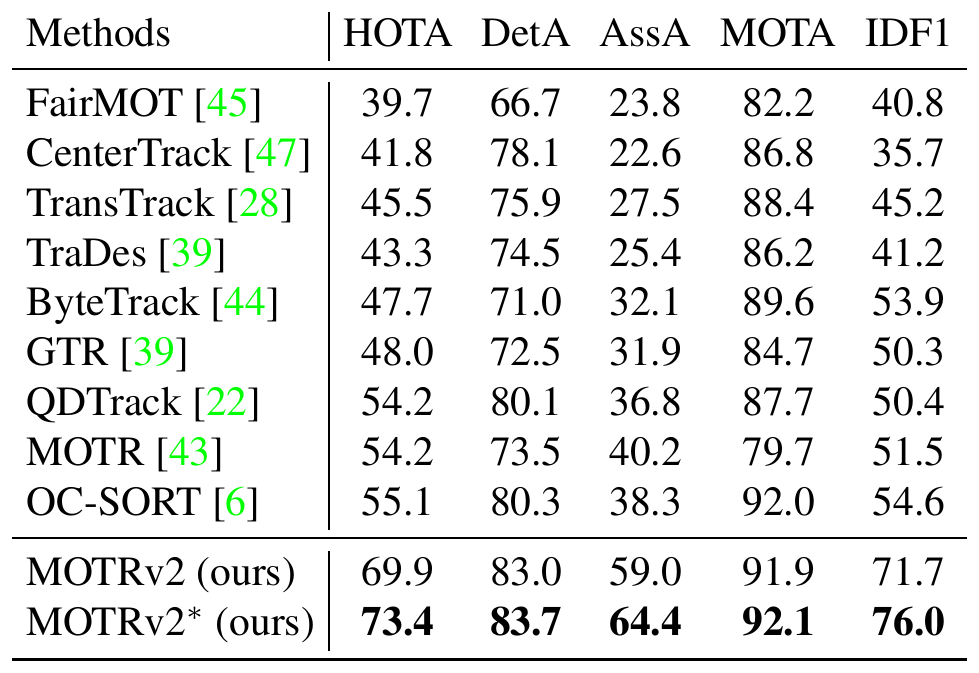
MOTRv2 obtient un HOTA de 69.9, 14.8 points au-dessus d'OC-SORT, le meilleur jusque-là. Son AssA de 59.0 dépasse de plus de vingt points les 38.3 d'OC-SORT ; son DetA de 83.0 est lui aussi au-dessus des 80.3 d'OC-SORT. L'association prend une large avance, et la détection n'est plus à la traîne.
Le MOTRv2* du tableau obtient 73.4 et a remporté la première édition du défi de suivi multi-personnes en danse de groupe. Mais ce chiffre ajoute un entraînement sur la validation, un ensemble de 4 modèles et une règle de post-traitement. Si, dans les 20 à 100 images qui suivent la fin d'une trajectoire, une seule nouvelle trajectoire apparaît, les deux sont considérées comme la même personne. Cette règle est très pratique, mais ce n'est plus du bout en bout.
BDD100K
BDD100K compte 8 classes. MOTRv2 attribue une requête partagée à chaque classe et obtient en validation un mMOTA de 43.6 et un mIDF1 de 56.5, soit 2.4 et 2.5 points au-dessus d'Unicorn, le meilleur jusque-là.
Face à un MOTR lui aussi entraîné conjointement avec les images de BDD100K et transmettant lui aussi la boîte entière, mais sans YOLOX, MOTRv2 gagne 8.1 points de mMOTA et 8.3 points de mIDF1 ; l'apport de YOLOX est tout aussi net dans un cadre multi-classes.
MOT17 et MOT20
Sur MOT17, MOTRv2 obtient un HOTA de 62.0, un MOTA de 78.6 et un IDF1 de 75.0, bien mieux que les 57.8, 73.4 et 68.6 de MOTR, mais toujours en dessous de ByteTrack (63.1, 80.3, 77.3) et de BoT-SORT (64.6, 80.6, 79.5).
Même chose sur MOT20. MOTRv2 obtient un HOTA de 60.3, puis 61.0 avec un entraînement conjoint sur MOT17, toujours sous les 61.3 de ByteTrack et les 62.4 d'OC-SORT indiqués dans le tableau.
Les auteurs attribuent l'écart à la quantité de données. MOT17 contient trop peu de vidéos d'entraînement pour entraîner un traqueur centré sur les requêtes ; en ajoutant MOT17 à l'entraînement, l'écart sur MOT20 se réduit un peu.
Pour bien exploiter les boîtes de YOLOX dans des scènes encombrées comme MOT17 et MOT20, les auteurs ajoutent un « alignement des requêtes de piste ». Les boîtes prédites par MOTR et celles de YOLOX sont appariées par l'algorithme hongrois sur l'IoU ; quand l'IoU dépasse 0.5, la boîte de YOLOX remplace l'ancre, et les prédictions restées sans partenaire sont supprimées comme faux positifs. Le seul alignement des ancres fait passer le MOTA de la demi-validation de MOT17 de 75.9 à 84.3. La transmission des embeddings de requête n'est pas modifiée, mais cette étape réintroduit en fait l'appariement par IoU.
Limites
Les auteurs citent trois limites :
- Un grand besoin de données. Sur de petits jeux de données, les résultats ne sont pas assez bons ; MOT17 en est un exemple.
- Des requêtes de piste en double. Quand deux personnes se croisent, il arrive qu'une requête de piste suive la mauvaise personne, si bien que deux requêtes de piste suivent la même personne.
- La vitesse. Sur une 2080Ti, YOLOX tourne à 25 images par seconde et MOTR à 9.5, soit 6.9 images par seconde au total.
Conclusion
MOTRv2 ne touche pas à l'association de MOTR ; il sous-traite la détection. Les boîtes du détecteur externe deviennent les ancres des requêtes, et MOTR n'a plus qu'à ajuster les positions et à décider qui est qui.
Sur une scène comme DanceTrack, où la détection est facile et l'association difficile, cette répartition des rôles fait des merveilles ; le HOTA gagne d'un coup près de 15 points.
Pourtant, pour mieux suivre sur MOT17, les auteurs finissent par aligner les ancres avec un appariement par IoU, et ajoutent une règle de post-traitement pour aller chercher la victoire sur DanceTrack. Pour obtenir les meilleurs scores, un traqueur de bout en bout doit finalement emprunter quelques tours au tracking-by-detection.