Article original
Deep OC-SORT: Multi-Pedestrian Tracking by Adaptive Re-Identification
- Publication
- ICIP 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2302.11813
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingdeepocsort2023,
  title = {{Deep OC-SORT: Multi-Pedestrian Tracking by Adaptive Re-Identification}},
  author = {Gerard Maggiolino and Adnan Ahmad and Jinkun Cao and Kris Kitani},
  year = {2023},
  eprint = {2302.11813},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.11813}
}
Vers 2022, les traqueurs à association par le mouvement sont revenus en vogue.
Les détecteurs devenant de plus en plus forts, ByteTrack, avec seulement un filtre de Kalman et l'IoU, a battu sur MOT17 toute une série de méthodes qui apprennent des caractéristiques d'apparence. OC-SORT a corrigé l'accumulation d'erreur du filtre de Kalman après une occultation, et fait mieux que toutes sortes de méthodes re-ID sur des scènes comme DanceTrack, où les apparences se distinguent mal et les mouvements sont complexes.
Mais les indices d'apparence ont leur utilité ; ils sont seulement difficiles à bien exploiter. BoT-SORT et StrongSORT ont eux aussi réintroduit l'apparence, mais de façon très simple. Les caractéristiques d'apparence des trajectoires sont mises à jour par une moyenne mobile exponentielle à poids fixe, et la distance d'apparence est ajoutée au coût de mouvement avec un poids fixe.
Gerard Maggiolino et Adnan Ahmad, de l'Université Carnegie Mellon, avec Jinkun Cao et Kris Kitani, les auteurs d'OC-SORT, veulent ajouter l'apparence à OC-SORT, en s'en servant moins quand elle n'est pas fiable, et davantage quand elle l'est.
Comme il s'agit d'ajouter des caractéristiques d'apparence profondes à OC-SORT, la méthode s'appelle Deep OC-SORT. Les auteurs précisent qu'il ne s'agit pas de refaire sur OC-SORT ce que DeepSORT avait fait sur SORT.
Définir le problème
Même avec un modèle re-ID très fort, les caractéristiques d'apparence extraites d'une boîte restent très bruitées ; la personne est à moitié cachée, un mouvement trop rapide rend l'image floue, ou quelqu'un d'habillé de façon très semblable se trouve juste à côté.
Les approches antérieures figent deux choses :
- Un poids de mise à jour fixe. Le poids de la moyenne mobile exponentielle est une constante ; quelle que soit la qualité de la détection dans l'image, la nouvelle caractéristique est mélangée au modèle d'apparence de la trajectoire dans la même proportion. Une boîte à moitié occultée pollue tout autant l'apparence de la trajectoire.
- Un poids de fusion fixe. Le coût d'apparence est ajouté au coût de mouvement dans une proportion fixe. Une détection qui ressemble particulièrement à une trajectoire et pas du tout aux autres, et une détection qui ressemble à peu près autant à plusieurs trajectoires, reçoivent la même part d'apparence dans le coût.
Les auteurs veulent que ces deux poids s'adaptent à la situation. Par ailleurs, OC-SORT dépend beaucoup de la position des détections, que le moindre mouvement de caméra perturbe ; ils ajoutent donc une compensation du mouvement de caméra.
Résoudre le problème
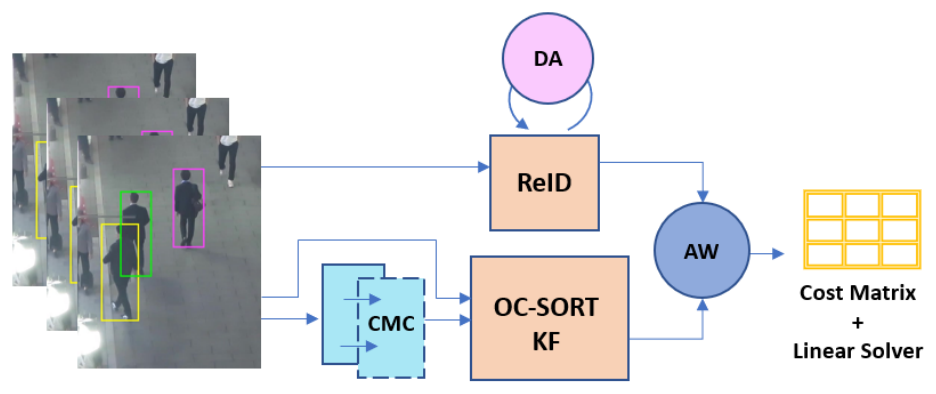
Deep OC-SORT reprend tout le processus d'OC-SORT, avec le momentum centré sur l'observation (OCM), la récupération centrée sur l'observation (OCR), le lissage en ligne (OOS) et, pour finir, l'algorithme hongrois. Il ajoute trois modules, la compensation du mouvement de caméra (CMC), l'apparence dynamique (DA) et la pondération adaptative (AW).
Compensation du mouvement de caméra
La compensation du mouvement de caméra utilise le module VidStab d'OpenCV pour estimer une transformation de similitude entre deux images adjacentes ; on extrait d'abord des points caractéristiques, on calcule le flot optique, puis RANSAC donne une matrice d'échelle et de rotation et une translation .
BoT-SORT compense lui aussi le mouvement de caméra, mais ne corrige que l'état du filtre de Kalman. Or OC-SORT utilise directement les boîtes observées passées à plusieurs endroits, qu'il faut tous corriger aussi :
- OOS : quand un objet réapparaît, OC-SORT interpole linéairement une trajectoire virtuelle à partir de la dernière observation, et met de nouveau à jour le filtre de Kalman. Le centre de la boîte de la dernière observation est d'abord corrigé par , avant l'interpolation.
- OCM : OC-SORT calcule la direction du mouvement à partir des dernières boîtes. Les coins supérieur gauche et inférieur droit de ces boîtes sont corrigés à chaque image par .
- OCR : la dernière boîte vue sert à retrouver les trajectoires perdues ; sa position est elle aussi corrigée à chaque image.
L'état du filtre de Kalman est , soit la position du centre, la surface, le rapport d'aspect, et les vitesses des trois premiers termes. La correction s'écrit
Seules la position et la vitesse du centre, ainsi que leurs covariances, sont corrigées. En théorie, on pourrait aussi appliquer l'échelle de la transformation à la surface, et approximer la rotation par un changement du rapport d'aspect ; mais la boîte englobante d'un objet tourné ne suit pas une relation linéaire, et il faudrait le masque de l'objet pour la calculer précisément. Les auteurs constatent qu'OCM et OCR tolèrent plutôt bien ce genre d'approximation, alors que le filtre de Kalman y est bien plus sensible ; ils ne corrigent donc que le centre. La correction est appliquée avant l'étape de prédiction du filtre de Kalman.
Apparence dynamique
La moyenne mobile exponentielle habituelle s'écrit
est la caractéristique d'apparence de la détection appariée dans l'image. Les auteurs remplacent le fixe par un qui varie avec la confiance de détection :
est la confiance de détection, le seuil de confiance qui sert à filtrer les détections bruitées, et .
L'idée est simple ; une confiance de détection basse indique en général un objet occulté ou une image floue, et les caractéristiques d'apparence extraites ne sont alors pas fiables non plus.
- Quand , pile au seuil, , et la nouvelle caractéristique est entièrement ignorée.
- Quand , , et la nouvelle caractéristique est intégrée dans la proportion maximale.
- Pour les confiances intermédiaires, on interpole linéairement.
est déjà un paramètre du traqueur, et n'est autre que l'ancien fixe. L'apparence dynamique n'introduit aucun nouvel hyperparamètre, et son coût de calcul est presque nul.
Pondération adaptative
La matrice de coût d'apparence est de taille , pour trajectoires et détections, et chaque case contient la similarité cosinus entre une trajectoire et une détection. L'approche habituelle l'ajoute à la matrice IoU avec un poids fixe : .
Les auteurs observent que la fiabilité d'un appariement d'apparence dépend de son « pouvoir discriminant ». Pour un véritable appariement d'apparence, il y a un écart net entre le meilleur score et le deuxième. Si une trajectoire ressemble à peu près autant à plusieurs détections, l'apparence ne devrait pas avoir trop voix au chapitre.
Pour la trajectoire , le pouvoir discriminant est défini comme le meilleur score de sa ligne, , moins le deuxième, , plafonné à :
Pour la détection , on calcule de la même façon sur sa colonne. La moyenne des deux donne le poids supplémentaire de la case :
La matrice de coût finale est
Les auteurs ne regardent volontairement que les deux premiers, plutôt qu'une mesure de distribution comme la divergence KL. L'écart entre les scores faibles qui suivent n'a rien à voir avec la fiabilité de l'appariement en question.
Implémentation
Le détecteur est le YOLOX de ByteTrack et d'autres méthodes, et le modèle re-ID le SBS50 de fast-reid.
Sur MOT17 et MOT20, et . Sur DanceTrack, et ; les auteurs expliquent que l'apparence y aide davantage que l'IoU.
Discussion
La contribution de chaque module
| Réglage | MOT17 HOTA | MOT17 IDF1 | MOT20 HOTA | DanceTrack HOTA | DanceTrack AssA |
|---|---|---|---|---|---|
| OC-SORT | 68.13 | 79.52 | 58.35 | 53.07 | 35.93 |
| +CMC | 69.66 | 82.44 | 58.33 | 53.57 | 36.68 |
| +App. | 68.59 | 80.18 | 59.10 | 58.03 | 42.37 |
| +App. +DA | 68.65 | 80.45 | 59.16 | 58.36 | 43.00 |
| +App. +DA +CMC | 69.80 | 82.56 | 59.35 | 58.46 | 43.33 |
| Tout (+AW) | 70.20 | 82.78 | 59.45 | 58.53 | 43.41 |
D'après la Table 3 de l'article, ensembles de validation des trois jeux de données ; « App. » désigne des caractéristiques d'apparence mises à jour par EMA à poids fixe. Les IDF1 de MOT20 sont, dans l'ordre, 74.77, 74.63, 75.71, 75.87, 76.11 et 76.30.
La compensation du mouvement de caméra, ajoutée seule, fait gagner près de 3 points d'IDF1 sur MOT17, et un peu sur DanceTrack ; sur MOT20, elle n'apporte aucune amélioration, car toutes les vidéos de MOT20 sont filmées par des caméras fixes.
Les caractéristiques d'apparence sont le plus grand pas sur DanceTrack. Le seul ajout d'une apparence à EMA fixe fait bondir le HOTA de 53.07 à 58.03, et AssA gagne plus de 6 points.
L'apparence dynamique et la pondération adaptative n'apportent que de petits gains, mais toujours positifs, sur les trois jeux de données et pour toutes les métriques.
L'apparence sert-elle vraiment sur DanceTrack ?
Ce résultat est très différent de ce qu'avait trouvé l'article DanceTrack. Quand les auteurs de DanceTrack fixaient la détection YOLOX pour ne comparer que les méthodes d'association, DeepSORT faisait moins bien que SORT, et ajouter l'apparence dégradait les résultats ; même chose dans l'expérience oracle avec les boîtes de vérité terrain, où l'ajout de l'apparence faisait baisser toutes les métriques.
Jinkun Cao est coauteur des deux articles. Sur la base d'OC-SORT, l'apparence devient au contraire l'élément qui apporte le plus sur DanceTrack.
Les réglages des deux articles sont très différents, avec d'autres modèles re-ID et d'autres modèles de mouvement. Le DeepSORT de l'article DanceTrack prend l'apparence comme principal critère d'appariement, sur le modèle de mouvement de SORT, qui se dérègle facilement après une occultation ; Deep OC-SORT, lui, ajoute l'apparence comme coût auxiliaire en plus de l'IoU, dans un traqueur de mouvement déjà très stable. Les danseurs se ressemblent beaucoup, mais pas parfaitement ; bien employée, l'apparence garde de l'information à exploiter.
Ensembles de test
| Jeu | Méthode | HOTA | MOTA | IDF1 | ID switch | AssA |
|---|---|---|---|---|---|---|
| MOT17 | OC-SORT | 63.2 | 78.0 | 77.5 | 1 950 | 63.2 |
| MOT17 | StrongSORT++ (hors ligne) | 64.4 | 79.6 | 79.5 | 1 194 | 64.4 |
| MOT17 | Deep OC-SORT | 64.9 | 79.4 | 80.6 | 1 023 | 65.9 |
| MOT20 | OC-SORT | 62.1 | 75.5 | 75.9 | 913 | 62.0 |
| MOT20 | StrongSORT++ (hors ligne) | 62.6 | 73.8 | 77.0 | 770 | 64.0 |
| MOT20 | Deep OC-SORT | 63.9 | 75.6 | 79.2 | 779 | 65.7 |
D'après la Table 1 de l'article, ensembles de test de MOT17 et de MOT20.
Sur MOT17, Deep OC-SORT obtient un HOTA de 64.9, deuxième du classement de l'époque ; sur MOT20, 63.9, premier. Par rapport à OC-SORT, les changements d'identité (ID switches) diminuent de près de moitié sur MOT17.
StrongSORT++ utilise des post-traitements hors ligne (AFLink, GSI) ; Deep OC-SORT, méthode purement en ligne, a pourtant une exactitude d'association (AssA) plus élevée.
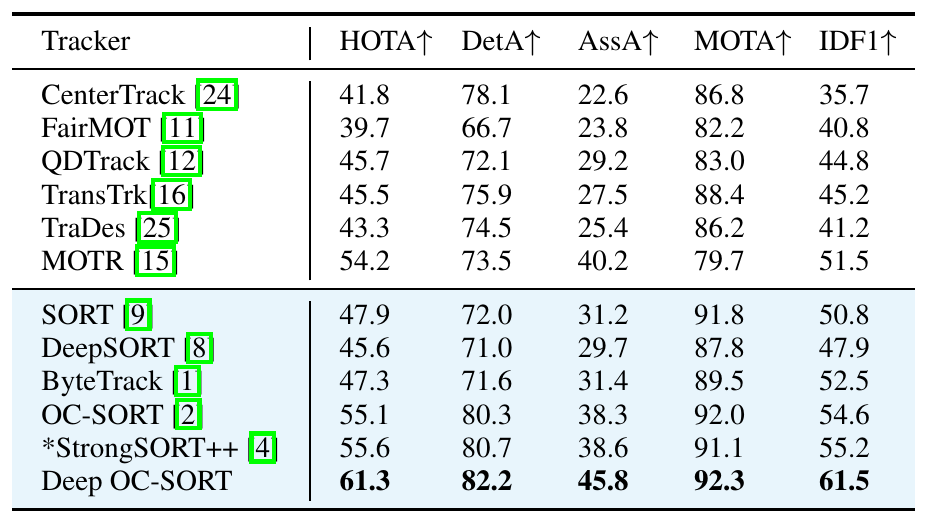
Sur DanceTrack, parmi les méthodes qui utilisent les mêmes détections YOLOX, Deep OC-SORT obtient un HOTA de 61.3, 6.2 points au-dessus d'OC-SORT, et son AssA passe de 38.3 à 45.8. DeepSORT moins bon que SORT, Deep OC-SORT meilleur qu'OC-SORT ; ces deux comparaisons, réunies dans le même tableau, montrent bien que tout dépend de la façon d'ajouter l'apparence.
Les auteurs affirment que c'est le meilleur résultat parmi les méthodes publiées. Pourtant, MOTRv2, mis en ligne sur arXiv trois mois plus tôt, avait déjà rapporté sur DanceTrack des scores bien plus élevés ; il n'était simplement pas encore publié officiellement, et ne figure pas dans ce tableau.
Limites
C'est un court article de conférence de 4 pages, et la profondeur de l'analyse s'en ressent.
Les trois nouveaux modules sont des règles conçues à la main ; le poids d'apparence et le plafond doivent être réglés séparément pour chaque jeu de données, et les réglages de DanceTrack sont très différents de ceux de MOT17. L'article ne donne pas non plus de vitesse. Avec un modèle re-ID en plus, qui doit extraire des caractéristiques pour chaque détection, il est forcément plus lent qu'OC-SORT, fondé uniquement sur le mouvement.
Conclusion
Deep OC-SORT réintroduit l'apparence dans OC-SORT, mais avec beaucoup de retenue. Pas de mise à jour de l'apparence quand la confiance de détection est basse, pas de poids d'apparence amplifié quand l'apparence ne discrimine pas, et quand la caméra bouge, toutes les anciennes boîtes utilisées sont corrigées ensemble.
Chaque module est petit, mais ensemble, ils apportent un gain régulier sur les trois jeux de données.
L'article DanceTrack expliquait à tout le monde que, quand les danseurs sont habillés pareil, l'apparence ne sert à rien. Un peu plus d'un an plus tard, l'un de ses auteurs réglait sur DanceTrack un poids d'apparence plus élevé que sur MOT17.