Article original
CO-MOT: Boosting End-to-end Transformer-based Multi-Object Tracking via Coopetition Label Assignment and Shadow Sets
- Publication
- ICLR 2025Conférence
- Premier dépôt sur arXiv
- arXiv:2305.12724
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingcomot2023,
  title = {{CO-MOT: Boosting End-to-end Transformer-based Multi-Object Tracking via Coopetition Label Assignment and Shadow Sets}},
  author = {Feng Yan and Weixin Luo and Yujie Zhong and Yiyang Gan and Lin Ma},
  year = {2023},
  eprint = {2305.12724},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2305.12724}
}
MOTR confie tout le suivi à un Transformer : une requête par personne, qui accompagne cette personne d'une image à l'autre, sans filtre de Kalman ni algorithme hongrois.
La conception est élégante, mais les résultats n'ont jamais rattrapé ceux des méthodes « détecter puis apparier » comme ByteTrack. MOTRv2 a fini par greffer un détecteur YOLOX ; les scores ont monté, le coût de calcul aussi, et l'avantage du « de bout en bout » s'est en bonne partie envolé.
Feng Yan, Weixin Luo et leurs collègues de Meituan réexaminent MOTR et constatent que le problème n'est pas dans le suivi, mais dans la façon de distribuer les étiquettes à l'entraînement.
Définir le problème
Les requêtes de détection laissées sur la touche
Le décodeur de MOTR contient deux sortes de requêtes. Les requêtes de suivi s'occupent des personnes déjà suivies, et se transmettent d'une image à la suivante ; les requêtes de détection cherchent les personnes qui viennent d'apparaître.
À l'entraînement, l'attribution des étiquettes s'appelle TALA (tracking aware label assignment). Elle attribue d'abord les personnes déjà suivies aux requêtes de suivi correspondantes, et seuls les objets nouveaux restants passent par un appariement biparti avec les requêtes de détection.
Le problème, c'est que ces « restants » sont trop peu nombreux. D'après le décompte des auteurs sur DanceTrack, nouvelles personnes et personnes déjà suivies sont dans un rapport de 213 pour 25 483. Les danseurs sont presque tous sur scène dès la première image, et peu de gens entrent ensuite. La plupart du temps, les requêtes de détection n'ont aucun exemple positif dont apprendre.
Pire, TALA revient à dire aux requêtes de détection : « un objet que quelqu'un suit déjà, n'y touche pas ». À l'inférence, quand la requête de suivi d'une trajectoire décroche, les requêtes de détection ne vont pas non plus récupérer la personne.
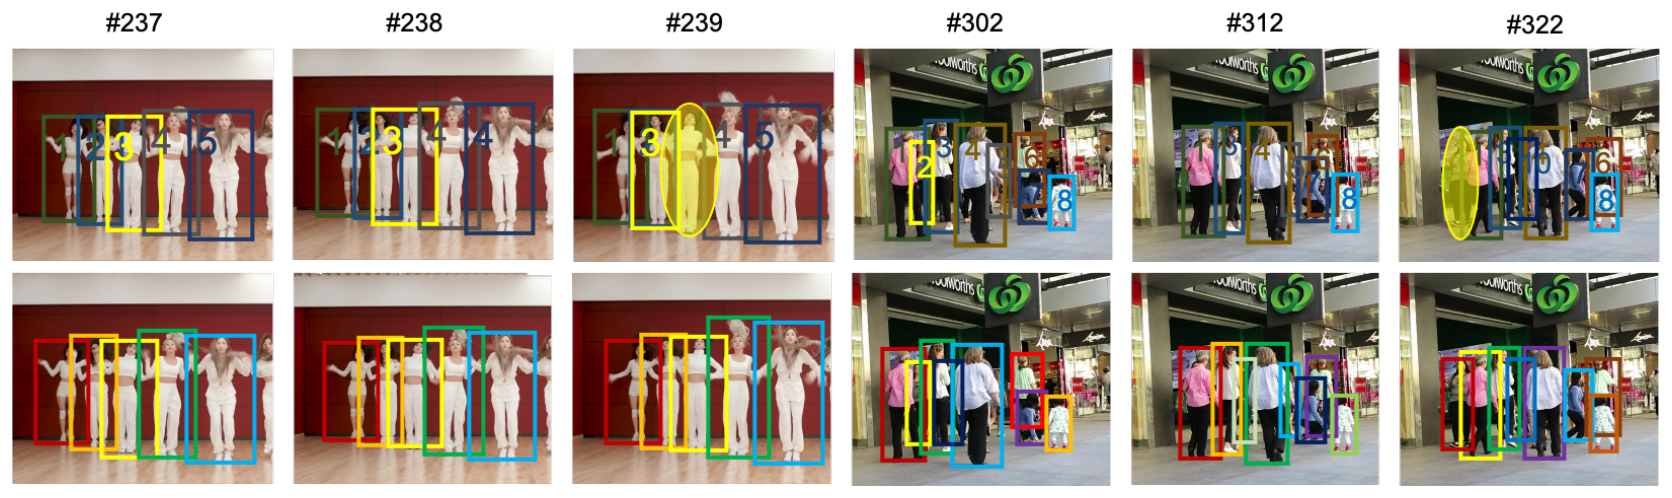
En haut, les résultats de suivi de MOTR ; en bas, le même modèle sans ses requêtes de suivi, en détection seule. En bas, tout le monde est encadré ; MOTR sait donc bien détecter, c'est la présence des requêtes de suivi qui étouffe la détection.
Mesurer chaque boîte comme une détection
Les auteurs prennent toutes les boîtes produites par le décodeur, qu'elles viennent du suivi ou de la détection, les traitent toutes comme des détections et les mesurent en mAP. Les colonnes indiquent si des requêtes de suivi sont utilisées à l'entraînement et à l'inférence :
| Modèle | Entraînement | Inférence | mAP |
|---|---|---|---|
| MOTR | ✓ | ✓ | 42.5 |
| MOTR | ✓ | 60.6 | |
| MOTRv2 | ✓ | ✓ | 70.7 |
| MOTRv2 | ✓ | 72.1 | |
| CO-MOT | ✓ | ✓ | 69.1 |
D'après la Table 1 de l'article, ensemble de validation de DanceTrack, dernière couche du décodeur.
Pour un même MOTR, retirer les requêtes de suivi à l'inférence fait bondir le mAP de 42.5 à 60.6, soit 18.1 de plus. MOTRv2, qui dispose des détections de YOLOX, ne gagne que 1.4 sans ses requêtes de suivi ; le détecteur greffé a presque entièrement réglé le problème de détection.
L'objectif de CO-MOT est de rendre à MOTR sa propre capacité de détection, sans détecteur greffé.
Résoudre le problème
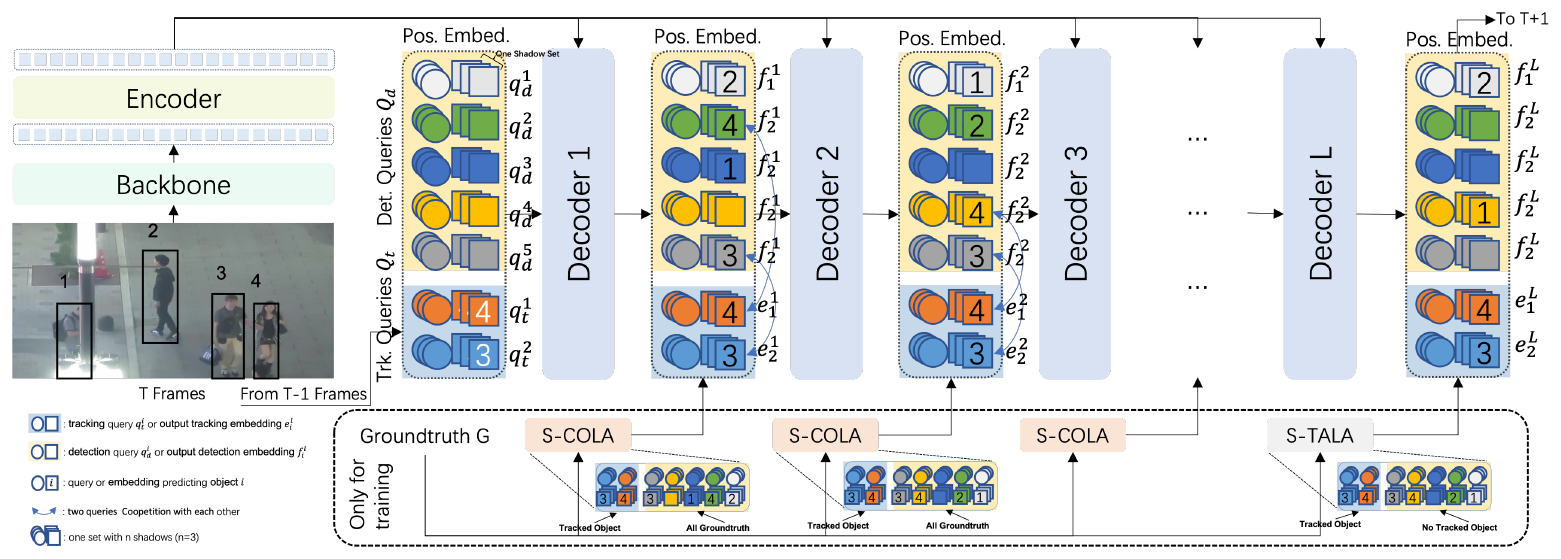
L'architecture de CO-MOT est rigoureusement celle de MOTR ; seule change l'attribution des étiquettes à l'entraînement, en deux volets.
Coopérer et rivaliser à la fois
La première modification s'appelle COLA (coopetition label assignment) ; coopetition est un mot-valise formé de coopération (cooperation) et de compétition (competition).
Le décodeur a six couches, et COLA permet aux requêtes de détection des cinq premières d'être appariées non seulement aux nouveaux objets, mais aussi aux personnes déjà suivies. Autrement dit, dans les couches intermédiaires, une même personne peut être prédite à la fois par une requête de suivi et par une requête de détection.
La dernière couche garde TALA, et les personnes déjà suivies n'y reviennent qu'aux requêtes de suivi. Sinon, à l'inférence, une même personne ferait surgir deux trajectoires.
L'intérêt vient de l'auto-attention du décodeur. Toutes les requêtes se regardent les unes les autres ; les requêtes de détection voient l'image courante, les requêtes de suivi portent la mémoire du passé. Quand elles prédisent la même personne, la requête de détection peut transmettre à la requête de suivi l'information de l'image courante, et lui prêter main-forte quand l'apparence change beaucoup.
Coopération dans les couches intermédiaires, compétition dans la dernière, d'où le nom de coopetition.
Chaque requête a ses clones de l'ombre
La seconde modification, ce sont les ensembles d'ombres (shadow sets).
Les modèles de la famille DETR utilisent un appariement un à un ; un objet ne donne un exemple positif qu'à une seule requête. Co-DETR et H-DETR répondent par un appariement un à plusieurs, où plusieurs requêtes apprennent le même objet. CO-MOT, lui, copie chaque requête en ombres, et le groupe entier est responsable du même objet.
L'initialisation des ombres demande du soin. Entièrement aléatoires, les ombres d'un même groupe sont trop différentes et convergent difficilement ; entièrement identiques, le groupe ne sert plus à rien. Les auteurs initialisent un groupe avec un même vecteur appris, auquel ils ajoutent un bruit d'écart type . Les différences sont presque imperceptibles au départ, et atteignent environ à la fin de l'entraînement.
À l'entraînement, chaque groupe d'ombres choisit un représentant pour l'appariement. Un groupe de requêtes de suivi est directement apparié à sa cible de l'image précédente ; pour un groupe de requêtes de détection, on calcule le coût d'appariement de chaque ombre avec chaque objet, et on prend le plus élevé comme représentant. Autrement dit, c'est la pire ombre du groupe qui décide à qui le groupe est attribué. Les autres ombres du groupe partagent le résultat de l'appariement et reçoivent toutes l'exemple positif.
À l'inférence, c'est l'inverse, et l'on se fonde sur le score de confiance le plus bas du groupe pour décider si le groupe a trouvé quelqu'un ; si c'est le cas, on renvoie la boîte de l'ombre au score le plus élevé.
Compter les exemples positifs sur un cas concret
Prenons un extrait d'entraînement pour voir combien ces deux modifications font apprendre de plus aux requêtes de détection.
À l'entraînement, CO-MOT prend 5 images à la fois. Supposons que 10 danseurs soient à l'image dès la première, que personne n'entre ni ne sorte, et que le décodeur ait 6 couches.
- TALA. À la première image, il n'y a pas encore de requête de suivi ; les 10 personnes sont toutes de nouveaux objets et reviennent aux requêtes de détection. Des images 2 à 5, tout le monde revient aux requêtes de suivi. Les requêtes de détection n'ont que 10 exemples positifs par couche, soit 60 sur 6 couches.
- COLA. Dans les 5 premières couches, les requêtes de détection peuvent être appariées à tous les objets des 5 images, soit 50 par couche et 250 au total ; la dernière couche en garde 10. Total, 260.
- Avec les ombres en plus. Les 3 ombres de chaque groupe reçoivent toutes l'exemple positif, et les requêtes de détection passent à 780 exemples positifs.
Exemple de calcul établi pour cette note.
Les requêtes de suivi ne perdent pas un seul exemple positif, et celles de détection passent de 60 à 780.
Discussion
L'apport de chaque modification
| Réglage | HOTA | DetA | AssA | IDF1 |
|---|---|---|---|---|
| Référence MOTR | 56.4 | 71.8 | 44.6 | 57.5 |
| + COLA | 60.2 | 73.2 | 49.7 | 62.4 |
| + ombres | 59.0 | 72.6 | 48.2 | 59.6 |
| Les deux | 61.8 | 73.5 | 52.2 | 63.3 |
D'après la Table 4 de l'article, ensemble de validation de DanceTrack.
COLA seul ajoute 3.8 de HOTA, les ensembles d'ombres seuls 2.6, et les deux ensemble 5.4.
Fait intéressant, DetA ne passe que de 71.8 à 73.5, alors qu'AssA saute de 44.6 à 52.2. COLA donne en apparence plus d'exemples positifs aux requêtes de détection, et devrait donc aider la détection ; en réalité, c'est l'association qu'il aide.
Les requêtes de détection aident-elles vraiment ?
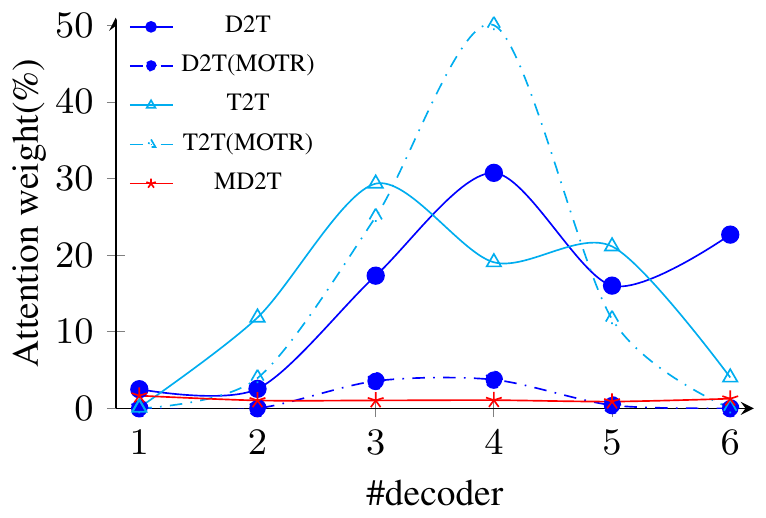
Pour s'en assurer, les auteurs tracent les poids d'attention de chaque couche du décodeur. Deux boîtes dont l'IoU dépasse 0.7 sont considérées comme prédisant la même personne.
Dans CO-MOT, la contribution aux requêtes de suivi des requêtes de détection qui prédisent la même personne dépasse 15 % dès la couche 3, et aux couches 4 et 6, elle dépasse même l'attention des requêtes de suivi à elles-mêmes. Dans MOTR, la même valeur n'est que de 3.74 % à la couche 4, contre 30.74 % dans CO-MOT.
Dans MOTR, requêtes de détection et requêtes de suivi s'occupent de personnes différentes, et n'ont pas grand-chose à se dire. CO-MOT les fait fixer la même personne dans les couches intermédiaires, et l'information circule.
Les ombres dans le détail
- L'initialisation. Un même vecteur plus un bruit minime donne un HOTA de 61.5, une copie exacte 60.6, une initialisation entièrement aléatoire 59.6.
- Le choix du représentant. Coût maximal à l'entraînement et score minimal à l'inférence forment la meilleure combinaison ; passer au score maximal à l'inférence donne le pire résultat, quel que soit le choix à l'entraînement. Laisser l'ombre la plus difficile décider de l'appariement à l'entraînement force le modèle à bien apprendre chaque ombre.
- Le nombre d'ombres. 3 est le meilleur choix (61.8), 2 donne 61.5 ; au-delà, la convergence devient difficile.
- Le nombre de couches avec COLA. Sur la première couche seulement, 59.0 ; sur les trois premières, 59.6 ; sur les cinq premières, 59.9. Plus on l'utilise, mieux c'est.
Face aux autres méthodes
Sur l'ensemble de test de DanceTrack, CO-MOT entraîné uniquement sur DanceTrack obtient un HOTA de 65.3, 11.1 de plus que MOTR, et au-dessus de MeMOTR (63.4), qui utilise lui aussi un ResNet-50. CO-MOT+, entraîné avec CrowdHuman en plus, atteint 69.4 de HOTA, à 0.5 seulement de MOTRv2 et de son YOLOX greffé (69.9), avec un AssA presque identique (58.9 contre 59.0).
| Modèle | Param. | FLOPs | Vitesse | HOTA |
|---|---|---|---|---|
| MOTR | 40M | 173G | 19 FPS | 54.2 |
| MOTRv2 | 139M | 455G | 14 FPS | 69.9 |
| CO-MOT+ | 40M | 173G | 19 FPS | 69.4 |
D'après la Figure 4 de l'article, ensemble de test de DanceTrack.
C'est le tableau le plus convaincant de CO-MOT. Avec le même nombre de paramètres et le même coût de calcul que MOTR, on rattrape MOTRv2, pour 38 % de son coût de calcul et une vitesse 1.4 fois supérieure. Seul l'entraînement a changé ; l'inférence ne coûte rien de plus.
Sur BDD100K, le TETA est de 52.8, au-dessus des 50.7 de MOTR mais sous les 54.9 de MOTRv2 ; l'AssocA, en revanche, est de 56.2, au-dessus des 51.9 de MOTRv2.
MOT17 résiste toujours
Sur l'ensemble de test de MOT17, CO-MOT obtient un HOTA de 60.1, mieux que les 57.8 de MOTR, mais toujours sous les 63.1 de ByteTrack ; avec un MOTA de 72.6, il reste loin derrière les 80.3 de ByteTrack.
Les auteurs avancent deux explications. D'abord, l'ensemble d'entraînement de MOT17 ne compte qu'environ 5 000 images, trop peu pour un Transformer. Ensuite, MOT17 regorge de petites cibles : les boîtes de moins de 0.5 % de la surface de l'image représentent 60.26 % des boîtes de MOT17, contre 1.17 % seulement dans DanceTrack. Les cas d'échec présentés dans l'article sont surtout des personnes bien visibles qui n'ont pas été détectées.
CO-MOT empêche le suivi d'étouffer la détection de MOTR, mais il ne change rien à la capacité de MOTR lui-même à détecter de petits objets.
Conclusion
CO-MOT a trouvé un angle mort dans l'entraînement de MOTR. On apprend aux requêtes de détection à « ne pas toucher aux personnes déjà suivies », si bien que lorsqu'une requête de suivi décroche, personne n'est là pour rattraper la personne.
COLA fait regarder la même personne aux deux sortes de requêtes dans les couches intermédiaires, et les ensembles d'ombres font apprendre chaque objet par plusieurs requêtes à la fois. Les deux modifications ne touchent que l'entraînement ; à l'inférence, l'architecture est exactement celle de MOTR.
Sur DanceTrack, CO-MOT+, sans détecteur greffé, n'est qu'à 0.5 de HOTA de MOTRv2 et de son YOLOX greffé, pour moins de 40 % de son coût de calcul. Sur MOT17, avec ses petites cibles nombreuses et ses données rares, l'écart avec les méthodes qui détectent puis apparient est toujours là.