Article original
TrackFormer: Multi-Object Tracking with Transformers
- Publication
- CVPR 2022Conférence
- Premier dépôt sur arXiv
- arXiv:2101.02702
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingtrackformer2021,
  title = {{TrackFormer: Multi-Object Tracking with Transformers}},
  author = {Tim Meinhardt and Alexander Kirillov and Laura Leal-Taixe and Christoph Feichtenhofer},
  year = {2021},
  eprint = {2101.02702},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2101.02702}
}
En 2019, Tracktor a montré que la tête de régression de boîtes d'un détecteur peut faire passer directement une boîte de l'image précédente à l'image courante, si bien que le suivi ne demande presque aucun entraînement supplémentaire. CenterTrack suit la même voie, avec des centres et des déplacements. Les auteurs appellent ce type de méthode le « suivi par régression » (tracking-by-regression).
Mais pour atteindre les meilleurs scores, ces méthodes finissent toutes par ajouter autre chose. Tracktor a besoin de re-ID et d'un modèle de mouvement ; d'autres méthodes se branchent sur une optimisation de graphe. La raison est que la régression de chaque boîte est indépendante et locale ; une boîte ne sait ni qui elle est, ni ce que font les autres trajectoires autour d'elle.
En 2020, DETR a formulé la détection d'objets comme une prédiction d'ensemble. Un ensemble de requêtes d'objet (object queries) apprenables traverse un décodeur Transformer, qui produit directement un ensemble de boîtes sans doublons, sans boîtes d'ancrage ni suppression des non-maxima.
Deux des auteurs de Tracktor, Tim Meinhardt et Laura Leal-Taixé, de l'Université technique de Munich, se sont associés à Alexander Kirillov et Christoph Feichtenhofer, de Facebook AI Research, pour transposer cette idée au suivi. Si une requête peut représenter un objet, il suffit de la laisser accompagner cet objet jusqu'à l'image suivante pour obtenir du suivi, non ?
Définir le problème
Une vidéo contient objets ; chaque objet a une trajectoire , qui enregistre sa boîte dans chaque image, de son entrée dans le champ à sa sortie, y compris les images où il est occulté.
Les auteurs formulent le suivi multi-objets comme un problème de prédiction d'ensemble image par image. À chaque image, le modèle doit produire un ensemble de boîtes munies d'une identité, qui indique où se trouvent les objets déjà suivis et lesquels viennent d'apparaître.
Détection, maintien des identités et création de nouvelles trajectoires se font tous dans un même passage de décodage, sans étape d'appariement séparée, sans optimisation de graphe, et sans modélisation explicite de l'apparence ou du mouvement. Les auteurs appellent ce nouveau paradigme le « suivi par attention » (tracking-by-attention).
Résoudre le problème
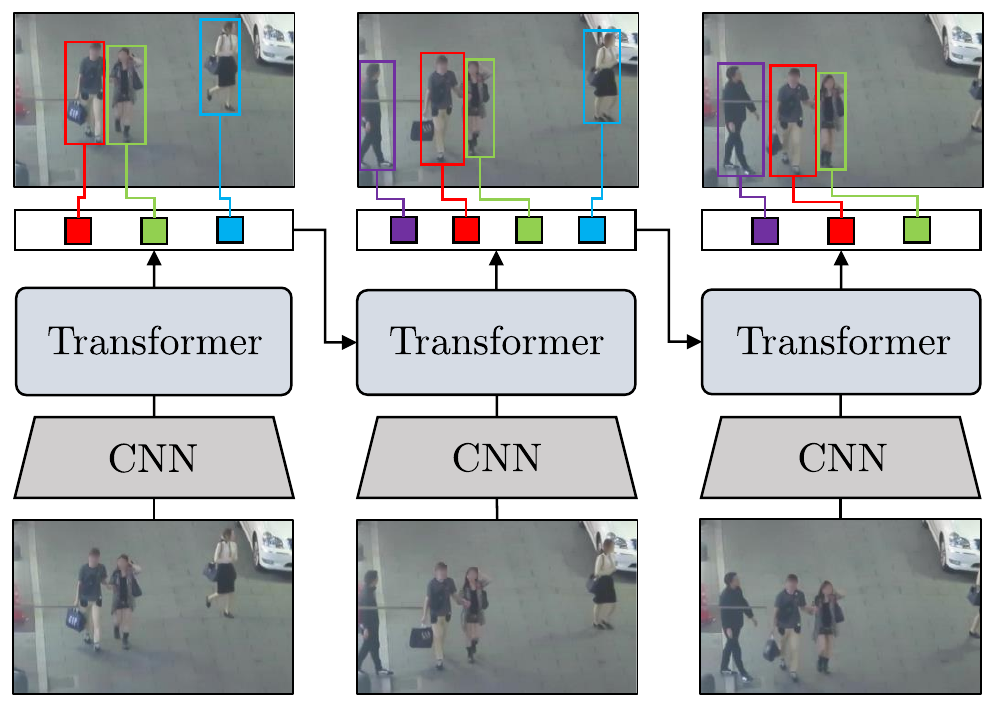
Architecture
L'ossature de TrackFormer est tout simplement Deformable DETR :
- ResNet-50 extrait les caractéristiques de l'image.
- Un encodeur Transformer de 6 couches applique l'auto-attention aux caractéristiques de l'image.
- Un décodeur Transformer de 6 couches applique l'auto-attention entre les requêtes, puis l'attention croisée sur les caractéristiques encodées de l'image.
- Un MLP projette chaque embedding de sortie vers une boîte et une classe.
Tout ce qui le distingue de DETR se trouve dans les requêtes du décodeur.
Deux types de requêtes
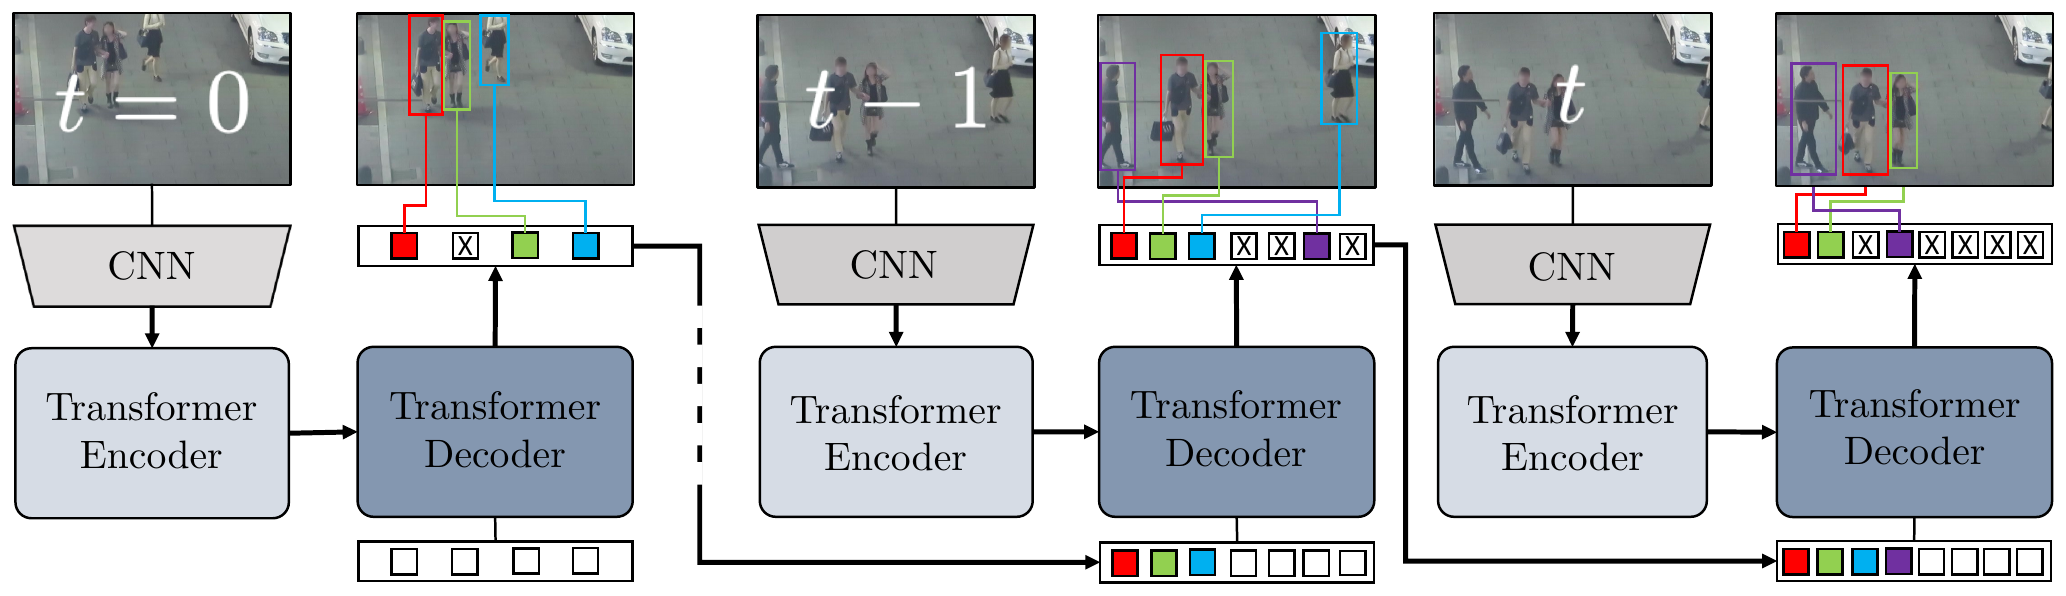
Les requêtes d'objet (object queries) sont, comme dans DETR, un ensemble fixe d'embeddings apprenables, chargés de découvrir de nouveaux objets dans n'importe quelle image. MOT17 compte au plus 52 personnes par image, et les auteurs utilisent 500 requêtes d'objet ; il faut bien plus de requêtes que d'objets dans l'image pour obtenir de bons résultats.
Les requêtes de piste (track queries) sont le cœur de l'article. Quand, dans une image, une requête d'objet détecte un objet (score de classification supérieur à 0.4), son embedding de sortie à la dernière couche du décodeur devient directement une requête de piste pour l'image suivante, avec un numéro d'identité.
À l'image suivante, le décodeur traite requêtes à la fois. Par l'attention croisée, chaque requête de piste va chercher son objet dans la nouvelle image et produit une boîte mise à jour ; l'embedding mis à jour passe à son tour à l'image d'après. Les identités se transmettent ainsi de manière autorégressive, image après image, sans le moindre appariement du début à la fin.
L'auto-attention entre les deux types de requêtes joue aussi un rôle. Les requêtes d'objet « voient » les requêtes de piste, et ne détectent donc pas une seconde fois une personne déjà suivie.
Pour aider les requêtes de piste à retrouver leur objet, l'implémentation ajoute deux détails. Le point de référence d'une requête de piste dans la deformable attention est placé directement au centre de sa boîte de l'image précédente ; l'attention croisée du décodeur regarde à la fois les cartes de caractéristiques de l'image précédente et de l'image courante, distinguées par un encodage temporel.
Fin et récupération des trajectoires
Une requête de piste est supprimée quand son score de classification tombe sous 0.4, ou quand son IoU avec une autre boîte dépasse 0.9. Les auteurs ont constaté que l'auto-attention du décodeur ne vient pas à bout de certains doublons qui se recouvrent fortement ; ils ont donc conservé cette suppression des non-maxima très permissive.
Une requête de piste supprimée n'est pas jetée tout de suite ; elle continue d'être décodée pendant 5 images, sans produire de sortie pendant cette période. Si son score repasse au-dessus de 0.4, elle redevient une trajectoire normale. C'est une forme de ré-identification à court terme, qui repose sur la même attention, sans entraînement re-ID supplémentaire.
Mais une requête de piste porte une information de position ; si l'objet reste occulté trop longtemps ou se déplace trop loin, elle ne le retrouve plus.
Entraînement
Pour que les requêtes de piste apprennent à accompagner leur objet, il faut entraîner sur deux images adjacentes :
- À l'image , la détection se fait avec les seules requêtes d'objet.
- Les objets détectés deviennent des requêtes de piste, envoyées avec les requêtes d'objet dans l'image .
Chaque sortie de l'image doit être attribuée à un objet réel ou au fond. Soit et les ensembles d'identités réelles des deux images ; les règles d'attribution sont les suivantes :
- (présents dans les deux images) : les requêtes de piste sont associées directement par identité ; c'est une attribution ferme.
- (présents dans l'image précédente, disparus dans l'image courante) : les requêtes de piste correspondantes doivent prédire le fond.
- (nouveaux venus) : ils reviennent aux requêtes d'objet, avec l'appariement de coût minimal trouvé par l'algorithme hongrois de DETR.
Le coût d'appariement combine la probabilité de classe et l'écart entre les boîtes :
où le coût de boîte combine la distance L1 et l'IoU généralisé :
Une fois l'attribution faite, la perte de chaque requête est
Toute requête non attribuée est traitée comme fond.
Trois augmentations
Avec seulement deux images adjacentes, les situations de suivi que voit le modèle sont trop simples. Les auteurs ajoutent trois augmentations :
- Élargir l'écart entre images. L'image n'est pas forcément celle qui précède immédiatement ; elle est tirée dans une plage autour de , pour simuler les mouvements de caméra et les faibles fréquences d'images.
- Détections manquées. Avec une probabilité , certaines requêtes de piste sont retirées, si bien que ces objets doivent être redétectés par les requêtes d'objet à l'image . C'est la clé pour entraîner les deux types de requêtes ensemble.
- Faux positifs. Avec une probabilité , on ajoute à une requête de piste une fausse requête de piste, prise parmi les embeddings de sortie de l'image précédente classés comme fond et qui la recouvrent fortement. Le modèle s'exerce ainsi à supprimer des trajectoires en cas d'occultation.
Données
Un Transformer a besoin de beaucoup de données, et MOT17 ne compte que 7 vidéos d'entraînement. Comme CenterTrack, les auteurs simulent deux images adjacentes à partir d'images isolées de CrowdHuman, en appliquant à une même image un redimensionnement et un recadrage aléatoires d'au plus 20 %.
Le modèle en détections privées est d'abord entraîné à partir de zéro pendant 85 epochs sur CrowdHuman, puis fine-tuné pendant 40 epochs sur un mélange de CrowdHuman et de MOT17 ; il faut environ deux jours sur 7 GPU de 32 Go.
Discussion
Ablation des composants
| Réglage | MOTA | Δ | IDF1 | Δ |
|---|---|---|---|---|
| TrackFormer complet | 71.3 | 73.4 | ||
| Sans préentraînement CrowdHuman | 69.3 | −2.0 | 71.8 | −1.6 |
| Puis sans ré-ID par requête de piste | 69.2 | −0.1 | 70.4 | −1.4 |
| Puis sans augmentation FP | 68.4 | −0.8 | 70.0 | −0.4 |
| Puis sans augmentation d'écart | 64.0 | −4.4 | 59.2 | −10.8 |
| Puis sans requêtes de piste | 61.0 | −3.0 | 45.1 | −14.1 |
D'après la Table 3 de l'article, ensemble d'entraînement de MOT17 coupé en deux moitiés, détections privées ; chaque ligne retire un élément de plus que la précédente.
Ce tableau est cumulatif ; chaque ligne a un composant de moins que la précédente.
Parmi les techniques d'entraînement, c'est l'augmentation de l'écart entre images qui pèse le plus ; sans elle, MOTA perd 4.4 points et IDF1 10.8 points. Entraîné uniquement sur des images immédiatement consécutives, le modèle surapprend vite et n'apprend pas à suivre un objet qui se déplace beaucoup.
La dernière ligne retire jusqu'aux requêtes de piste ; le modèle n'est entraîné qu'à la détection et passe à un appariement glouton par distance entre centres, comme CenterTrack. IDF1 perd encore 14.1 points. Cette ligne représente les approches antérieures, fondées sur un appariement par règles.
MOT17 et MOT20
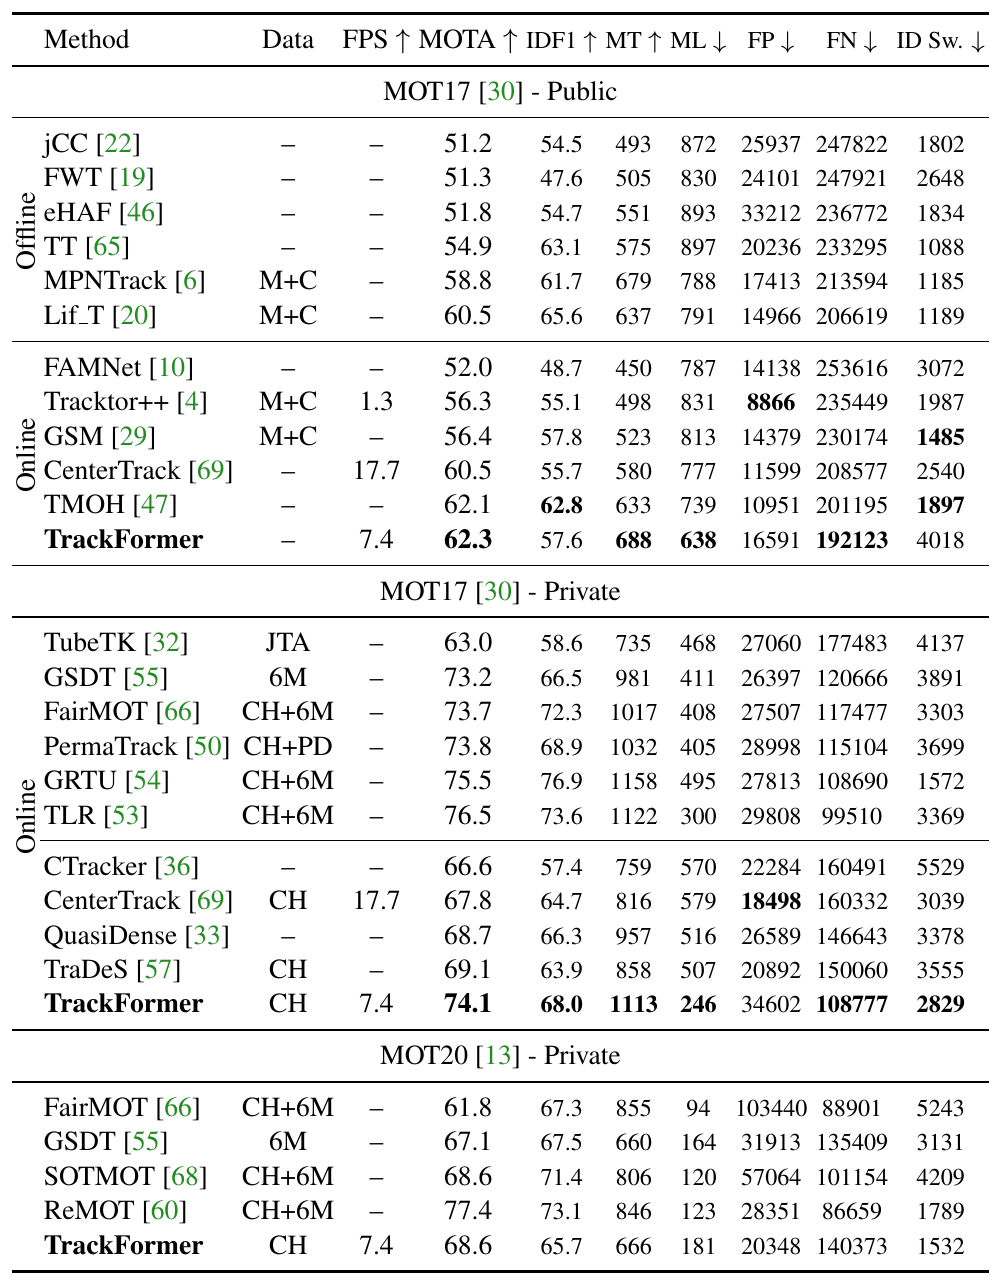
En détections privées, TrackFormer obtient sur MOT17 un MOTA de 74.1 et un IDF1 de 68.0. Parmi les méthodes qui n'utilisent que CrowdHuman comme données supplémentaires, son MOTA dépasse de 5.0 points celui de TraDeS, deuxième, et de 6.3 points celui de CenterTrack. Il n'a que 108 777 FN, plus de cinquante mille de moins que CenterTrack, ce qui donne un rappel bien plus élevé.
Mais le tableau contient aussi plusieurs méthodes qui utilisent 6 jeux de données de suivi supplémentaires, comme FairMOT, GRTU et TLR, et toutes ont un IDF1 plus élevé que le sien. Sur MOT20, son MOTA est à égalité avec celui de SOTMOT, mais près de 9 points sous celui de ReMOT, et son IDF1 est aussi en retrait.
Il tourne à 7.4 images par seconde, moins de la moitié des 17.7 de CenterTrack.
Comment comparer en détections publiques
TrackFormer ne fonctionne pas en associant des boîtes de détection fournies en entrée ; il ne peut donc pas prendre directement les détections publiques comme entrée. Les auteurs passent par un filtrage ; seule une requête d'objet dont l'IoU avec une boîte de détection publique dépasse 0.5 peut ouvrir une nouvelle trajectoire.
CenterTrack applique un filtrage similaire, mais fondé sur les centres ; il suffit que le centre d'une détection publique tombe dans la boîte. Dans l'annexe, les auteurs comparent les deux filtrages et constatent qu'avec la version par centres, trois jeux de détections publiques de qualités très différentes (DPM, FRCNN, SDP) donnent des résultats presque identiques ; la qualité des détections ne se reflète donc pas dans les scores. La version par IoU est plus stricte et fait baisser tous les scores, mais elle reste plus fidèle à l'idée de « prendre les détections publiques en entrée ».
Avec le filtrage par IoU, TrackFormer obtient un MOTA de 62.3, au niveau des meilleures méthodes en ligne ; mais avec 4 018 changements d'identité (ID switches), il détient le chiffre le plus élevé du tableau.
Ajouter des masques
On peut aussi ajouter à TrackFormer une tête de segmentation pour faire du suivi et de la segmentation multi-objets sur MOTS20. Les auteurs constatent qu'après un entraînement conjoint avec les masques, IDF1 gagne 1.2 point, même en ne regardant que le suivi des boîtes ; l'information des masques aide à démêler certaines occultations ambiguës pendant l'entraînement.
Limites et suite
TrackFormer n'est entraîné que sur deux images adjacentes, et l'information temporelle apprise par les requêtes de piste reste très courte. Les auteurs écrivent eux-mêmes dans l'article que les méthodes qui vont au-delà de l'entraînement et de l'inférence sur deux images devraient être prometteuses.
C'est exactement ce que fait MOTR quelques mois plus tard ; il étend l'entraînement à un court extrait entier, transmet les requêtes de piste sur plusieurs images, et supprime les règles comme la NMS des trajectoires et la ré-identification. Par ailleurs, les scores de TrackFormer cités dans les tableaux comparatifs de MOTR et, plus tard, de MOTRv2 sont un MOTA de 65.0 et un IDF1 de 63.9 sur MOT17 ; ce sont les chiffres d'une version antérieure. C'est la version définitive, entraînée sur des images adjacentes simulées à partir de CrowdHuman, qui atteint les 74.1 et 68.0 présentés ici.
Conclusion
TrackFormer fait représenter chaque objet par une requête qui, une fois l'objet détecté, l'accompagne image après image. Les nouveaux objets reviennent aux requêtes d'objet, les anciens aux requêtes de piste ; les deux se voient mutuellement dans le même décodeur, et l'étape d'appariement disparaît.
Ses chiffres ne sont pas en tête partout, et il est lent. Mais il a montré une autre façon d'écrire le suivi, sur laquelle MOTR puis MOTRv2 ont continué de bâtir.
Deux ans plus tôt, Meinhardt et Leal-Taixé montraient avec Tracktor qu'on pouvait bien suivre des objets sans entraînement spécifique au suivi. Cette fois, le suivi est devenu une affaire de deux jours d'entraînement sur sept GPU.