Article original
SWE-bench: Can Language Models Resolve Real-World GitHub Issues?
- Publication
- ICLR 2024Conférence
- Premier dépôt sur arXiv
- arXiv:2310.06770
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelevaluationswebench2023,
  title = {{SWE-bench: Can Language Models Resolve Real-World GitHub Issues?}},
  author = {Carlos E. Jimenez and John Yang and Alexander Wettig and Shunyu Yao and Kexin Pei and Ofir Press and Karthik Narasimhan},
  year = {2023},
  eprint = {2310.06770},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2310.06770}
}
En 2023, la capacité des modèles de langage à programmer se mesure surtout avec des benchmarks comme HumanEval : on donne la signature et la description d'une fonction, le modèle écrit le corps, et l'on lance quelques tests unitaires. Les problèmes sont indépendants les uns des autres, et quelques lignes suffisent à les résoudre.
Le vrai travail logiciel ne ressemble pas à ça. Corriger un bug peut demander de retrouver le code concerné dans un projet de plusieurs milliers de fichiers, de comprendre comment des fonctions réparties dans différents fichiers s'appellent entre elles, de dénicher la ligne fautive au milieu d'une logique embrouillée, puis de la corriger sans rien casser d'autre.
Les benchmarks de l'époque approchaient l'un après l'autre du score parfait, et ne permettaient plus de mesurer de quoi les meilleurs modèles étaient réellement capables. Jimenez, Yang et leurs collègues de Princeton se sont donc tournés vers GitHub. Les projets open source regorgent de vrais signalements de problèmes (issues) et des pull requests qui les ont effectivement corrigés, avec en prime les tests du projet lui-même.
Définir le problème
Un bon benchmark doit être assez difficile pour mettre en échec les modèles existants, tout en ayant des réponses faciles à vérifier. Les problèmes de programmation ont l'avantage de pouvoir être testés, mais les benchmarks de code existants sont trop simples et trop propres.
Les auteurs veulent un benchmark qui remplisse plusieurs conditions : des problèmes issus du travail réel, des entrées longues et touffues, des modifications parfois réparties sur plusieurs fichiers, un verdict rendu par les tests d'origine du projet, et la possibilité d'ajouter sans cesse de nouveaux problèmes, pour éviter que le modèle ait vu la réponse pendant son entraînement.
Résoudre le problème
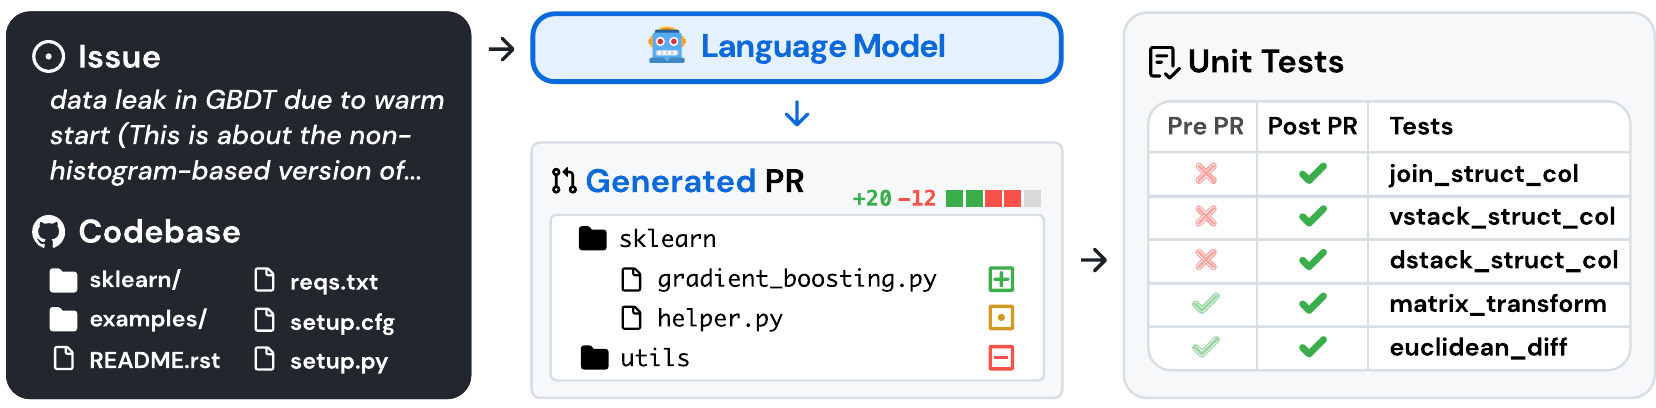
La tâche est simple à énoncer. On donne au modèle le texte d'une issue et le dépôt entier, et il doit produire une modification, au format d'un fichier patch qui indique les lignes à changer. À l'évaluation, le programme Unix patch applique la modification, puis on lance les tests liés à ce problème ; le problème n'est considéré comme résolu que si la modification s'applique et que tous les tests passent. Le score du benchmark est la proportion de problèmes résolus.
De 90 000 pull requests à 2 294 problèmes
Les auteurs filtrent en trois temps :
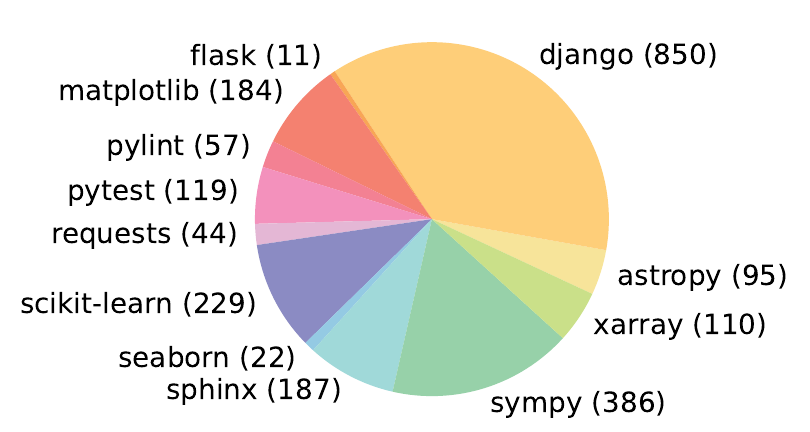
- Choisir les projets et collecter les données : 12 projets Python open source populaires, pour environ 90 000 pull requests au total. Les projets populaires sont en général mieux maintenus, avec des règles de contribution claires et des tests plus complets. La version du dépôt associée à chaque pull request est son commit de base.
- Filtrer sur les attributs : on ne garde que les pull requests fusionnées qui résolvent une issue et modifient des fichiers de test. Si les fichiers de test ont été modifiés, c'est que l'auteur a probablement ajouté des tests pour vérifier que le problème est corrigé.
- Filtrer sur l'exécution : on applique d'abord uniquement les modifications de tests de la pull request et l'on note les résultats des tests ; puis on applique le reste des modifications du code et l'on note à nouveau. Un problème n'est gardé que si au moins un test passe de l'échec à la réussite ; ceux dont l'installation échoue ou dont l'exécution plante sont aussi éliminés.
Il reste au final 2 294 problèmes.
À quoi ressemblent les problèmes
| Élément | Moyenne | Max |
|---|---|---|
| Texte de l'issue (mots) | 195.1 | 4 477 |
| Fichiers du dépôt (hors tests) | 3 010 | 5 890 |
| Lignes du dépôt (hors tests) | 438K | 886K |
| Lignes modifiées par la référence | 32.8 | 5 888 |
| Fichiers modifiés par la référence | 1.7 | 31 |
| Fonctions modifiées par la référence | 3 | 36 |
| Tests échec → réussite | 9.1 | 1 633 |
| Total des tests | 120.8 | 9 459 |
D'après la Table 1 de l'article ; la « référence » est la modification effectivement fusionnée (gold patch).
En moyenne, le dépôt d'un problème compte 3 000 fichiers et 438 000 lignes de code, mais il n'y a que 1.7 fichier et un peu plus de 30 lignes à modifier. Le modèle doit retrouver, dans une immense masse de code, les quelques lignes qui doivent vraiment changer.
Les tests sont de deux sortes. Les tests qui échouent avant la modification et passent après (fail-to-pass, F2P) vérifient que le problème signalé dans l'issue est corrigé ; chaque problème en a au moins un, et 40 % en ont deux ou plus. Les tests qui doivent passer avant comme après (pass-to-pass, P2P) vérifient que les fonctionnalités existantes n'ont pas été cassées ; on en compte 51 par problème en valeur médiane.
Il faut que les deux sortes de tests passent pour que le problème soit résolu. Prenons un exemple simple. Une issue signale que l'année 1900 est prise à tort pour une année bissextile, et le test F2P vérifie 1900 ; si le correctif se contente d'ajouter « non divisible par 100 », 1900 est corrigée, mais 2000 devient à son tour une année non bissextile, et les tests P2P qui passaient jusque-là attrapent l'erreur.
Les atouts de cette conception
- Réalisme : problèmes et solutions ont été soumis par de vrais utilisateurs, et demandent les compétences d'un ingénieur expérimenté.
- Mise à jour continue : la collecte ne demande presque aucune intervention humaine et s'applique à n'importe quel projet Python. Il suffit d'évaluer le modèle sur des issues apparues après la date limite de ses données d'entraînement pour être sûr que la réponse ne s'y trouve pas.
- Entrées longues et touffues : une issue fait en moyenne 195 mots, et un dépôt compte facilement plus d'un millier de fichiers.
- Modifications sur plusieurs fichiers : contrairement à HumanEval, où l'on ne modifie qu'une fonction, ou aux exercices à trous, rien n'indique ici où il faut intervenir.
- Solutions ouvertes : la modification du modèle n'a pas à être identique à la référence, il suffit qu'elle passe les tests ; récupération de documents, contexte long, agents et autres approches peuvent être comparés selon le même critère.
Faire tourner les 2 294 problèmes coûte cher en temps et en appels d'API ; les auteurs ont donc aussi sélectionné 300 problèmes pour former SWE-bench Lite, plutôt orienté vers des bugs fonctionnels assez circonscrits, et qui couvre 11 des 12 projets.
SWE-Llama
Parmi les modèles open source, seul CodeLlama pouvait alors traiter un contexte aussi long, mais la version disponible suivait mal les instructions pour produire une modification à l'échelle d'un dépôt entier, et sortait souvent du texte de remplissage ou du code sans rapport. Avec la même procédure, les auteurs ont collecté 19 000 paires issue / pull request dans 37 autres projets Python, sans exiger cette fois de modification des tests, et sans aucun recouvrement avec les projets du benchmark.
Ils fine-tunent CodeLlama-Python 7B et 13B sur ces données pour obtenir SWE-Llama. Pour économiser la mémoire, seules les couches d'attention sont fine-tunées, avec LoRA, et les séquences d'entraînement de plus de 30 000 tokens sont exclues, ce qui laisse environ 10 000 exemples effectivement utilisés. L'entrée comprend l'instruction, l'issue et les fichiers de code concernés ; la cible est la modification de référence.
Faire tenir le dépôt dans le contexte
Un dépôt de 438 000 lignes en moyenne ne pouvait pas tenir en entier dans les contextes de l'époque. Les auteurs choisissent les fichiers de deux façons :
- Récupération BM25 : le texte de l'issue sert de requête pour récupérer les fichiers pertinents, jusqu'à une limite de 13 000, 27 000 ou 50 000 tokens. Il s'agit de code interrogé par une requête en langue naturelle, et requêtes comme documents sont très longs ; les auteurs jugent donc la récupération dense peu adaptée.
- Récupération oracle : on donne directement les fichiers modifiés par la référence. C'est irréaliste, puisqu'un ingénieur ne sait pas au départ quels fichiers modifier, mais c'est utile pour l'analyse.
Avec une limite de 27 000 tokens, BM25 retrouve tous les fichiers oracle pour environ 40 % des problèmes, mais pour près de la moitié des problèmes, il n'en trouve aucun.
Les modèles évalués sont ChatGPT-3.5 (contexte de 16K), GPT-4 (32K), Claude 2 (100K) et SWE-Llama. Plus le contexte est court, moins il y a de problèmes dont les fichiers oracle tiennent en entier ; c'est le cas de 84.1 % des problèmes pour GPT-4, et de 58.1 % seulement pour ChatGPT-3.5.
Discussion
Presque rien n'est résolu
| Modèle | Résolus | Applicables | Lite résolus |
|---|---|---|---|
| Claude 3 Opus | 3.79 | 46.56 | 4.33 |
| Claude 2 | 1.97 | 43.07 | 3.00 |
| ChatGPT-3.5 | 0.17 | 26.33 | 0.33 |
| GPT-4-turbo | 1.31 | 26.90 | 2.67 |
| SWE-Llama 7b | 0.70 | 51.74 | 1.33 |
| SWE-Llama 13b | 0.70 | 53.62 | 1.00 |
D'après la Table 5 de l'article ; récupération BM25, en %.
Le meilleur modèle résout moins de 4 % des problèmes, et le meilleur au moment de la publication, Claude 2, moins de 2 %. Plus de la moitié des modifications n'ont même pas le bon format et ne s'appliquent tout simplement pas.
Avec les fichiers oracle, c'est un peu mieux. Claude 2 passe de moins de 2 % à 4.80 %, SWE-Llama 13b atteint 3.97 %, et GPT-4 (testé seulement sur un quart des problèmes, tiré au hasard) 1.74 %.
La difficulté varie beaucoup d'un projet à l'autre
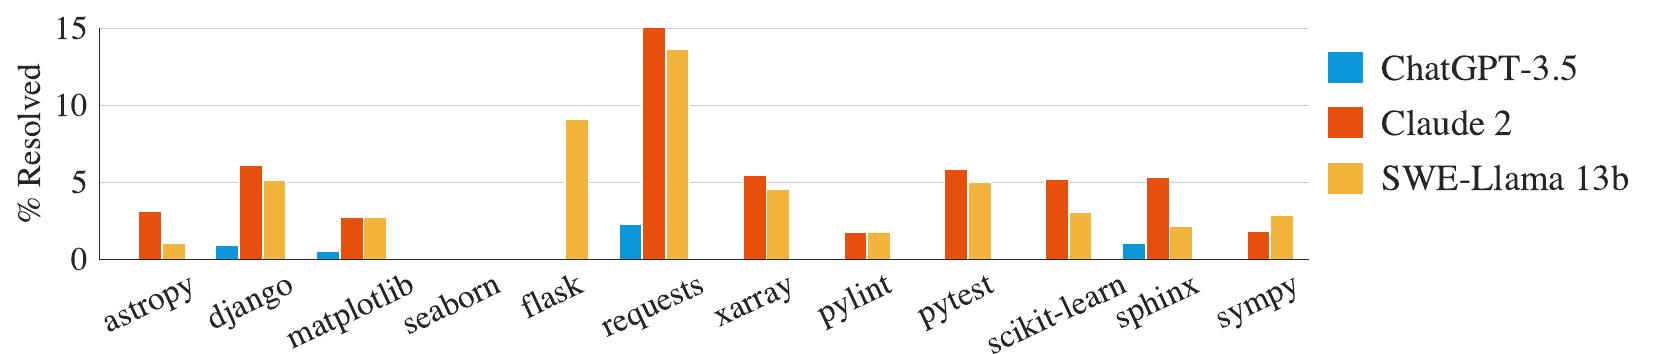
D'un projet à l'autre, les trois modèles suivent les mêmes tendances, mais les problèmes qu'ils résolvent se recoupent peu. En configuration oracle, Claude 2 résout 110 problèmes et SWE-Llama 13b 91, mais parmi les problèmes résolus par SWE-Llama, Claude 2 n'en résout que 42 %.
Certaines issues contiennent des images, intégrées au texte sous forme de liens d'image Markdown. C'est le cas de 32 % des problèmes de matplotlib et de 10 % de ceux de seaborn, contre 2 % seulement sur l'ensemble. Ces problèmes demanderaient peut-être un modèle multimodal, ou des outils capables de traiter les images.
Plus le contexte est long, moins c'est bon
Les performances de Claude 2 baissent nettement à mesure que la longueur totale de l'entrée augmente, et il en va de même pour les autres modèles. Quand la limite de BM25 passe de 13 000 à 50 000 tokens, les fichiers oracle sont retrouvés plus souvent, mais le taux de résolution de Claude 2 descend au contraire de 1.96 % à 1.22 %. Face à trop de code sans rapport avec le problème, le modèle ne trouve plus l'endroit à modifier.
Les auteurs mènent aussi une expérience « oracle replié » : on donne toujours les fichiers oracle, mais on ne garde que les lignes modifiées par la référence, avec 15 lignes au-dessus et au-dessous, et tout le reste est replié. Claude 2 passe de 4.8 % à 5.9 %, et GPT-4 monte à 3.40 %.
Autres observations
- Aucun lien avec la date de l'issue : en séparant les problèmes d'avant et d'après 2023, la plupart des modèles obtiennent des résultats comparables (GPT-4 n'a été testé que sur un quart des problèmes, et obtient 0 sur le groupe d'après 2023). Pour les auteurs, cela montre que même un modèle qui a vu d'anciennes versions du dépôt aurait du mal à tricher en récitant les réponses.
- Les modèles fine-tunés supportent mal un changement de contexte : SWE-Llama a été entraîné avec les fichiers oracle et a appris que « chaque fichier fourni doit être modifié » ; face à la pile de fichiers sans rapport que fournit BM25, il s'en sort très mal.
- Écrire un patch est plus facile que réécrire un fichier entier : les modèles voient surtout des fichiers de code complets et rarement des patchs ; les auteurs ont donc essayé de leur faire produire directement le fichier entier modifié. Le résultat est encore pire ; en récupération oracle, Claude 2 tombe de 4.8 % à 2.2 %.
- Les modèles modifient moins : en comptant le nombre total de lignes du fichier de modification (contexte compris), les modifications appliquées avec succès ne font en moyenne que 17 à 30 lignes, contre 34 à 44 lignes pour les références des mêmes problèmes, et 74.5 lignes pour l'ensemble des références. Les modèles ne modifient presque toujours qu'un seul fichier.
Un exemple non corrigé
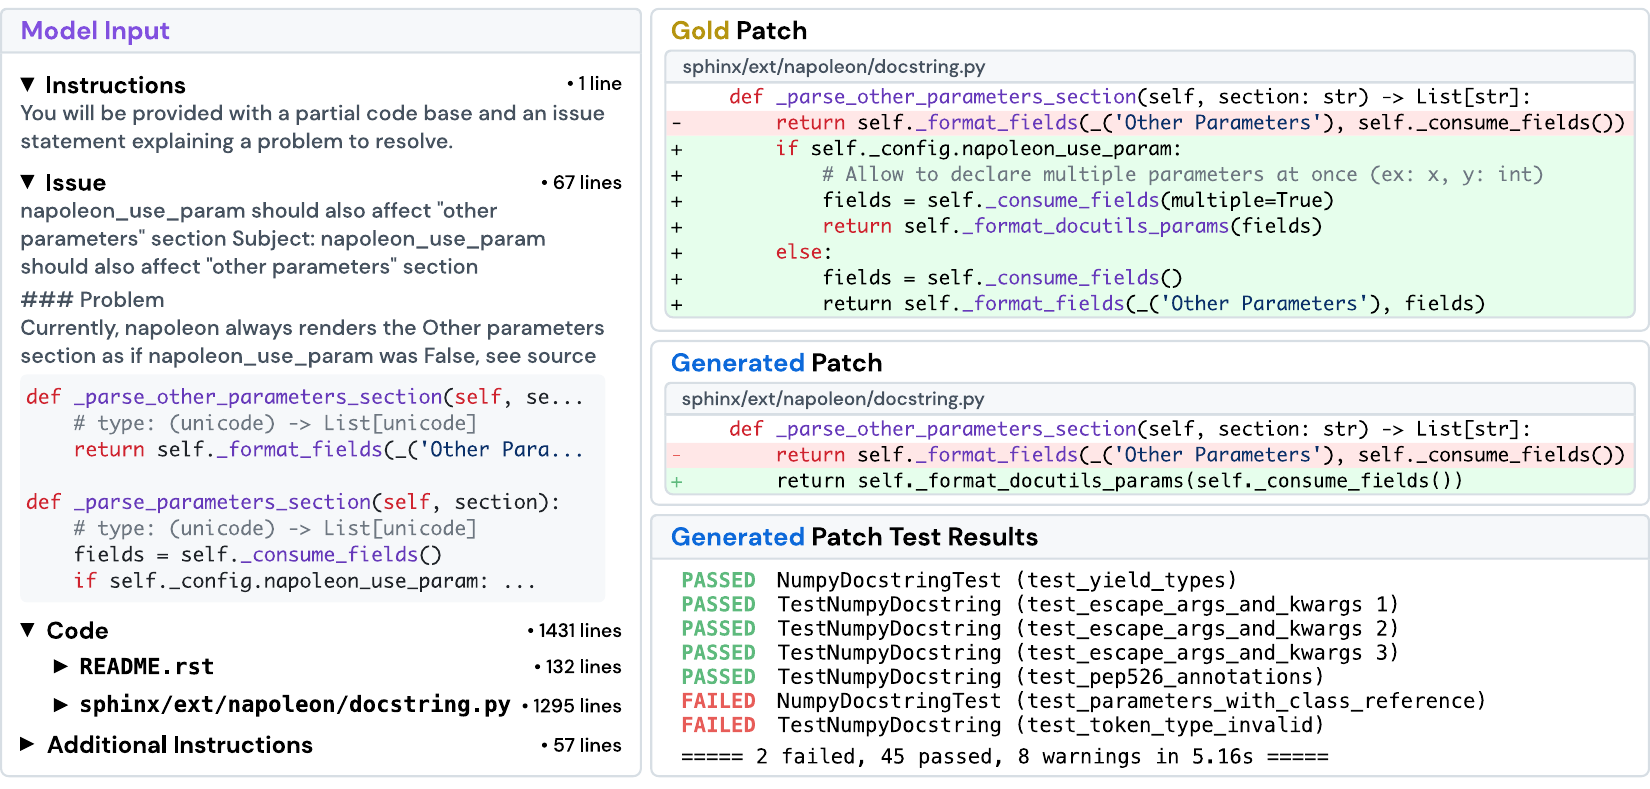
Cette issue signale que, dans l'extension napoleon de Sphinx, la section « Other Parameters » est mal formatée quand napoleon_use_param vaut True. L'issue est très détaillée et inclut même l'extrait de code probablement en cause.
En configuration oracle, l'entrée fait 1 558 lignes et 20 882 tokens. SWE-Llama modifie la bonne fonction, mais la fait se comporter comme si napoleon_use_param valait True, quel que soit le réglage ; la référence, elle, vérifie d'abord le réglage, sur le modèle de la fonction voisine _parse_parameters_section. Un des tests compare justement la sortie avec ce réglage à False, et repère l'erreur aussitôt.
Les auteurs ont examiné 11 sorties de SWE-Llama et de Claude 2 et en dégagent quelques tendances. Le code écrit par les modèles est rudimentaire et se sert peu des bibliothèques existantes ou des utilitaires déjà présents dans le dépôt ; les solutions sont « gloutonnes », ne corrigent que le cas décrit dans l'issue, et se soucient peu du style de code ou des conventions du projet, par exemple le choix entre imports relatifs et absolus. Les références écrites par des humains en profitent souvent pour améliorer la structure, et règlent au passage des problèmes connexes susceptibles de survenir.
Limites
- Python uniquement : les auteurs espèrent appliquer la même procédure de collecte à d'autres langages.
- Des baselines, rien de plus : l'article s'en tient à l'approche la plus simple, récupérer quelques fichiers et produire la modification en une fois. Les auteurs encouragent à essayer ensuite d'autres approches, comme les agents ou l'usage d'outils.
- Ce que les tests ne voient pas : un code qui passe les tests peut rester incomplet, inefficace ou difficile à lire ; sur ces points, les modifications écrites par les modèles sont souvent moins bonnes que celles des humains.
La suite
L'approche par agents que les auteurs suggéraient dans leurs limites a vite été concrétisée par la même équipe. En mai 2024, SWE-agent dote le modèle de langage d'une interface dédiée, qui lui permet de parcourir tout le dépôt, d'ouvrir des fichiers, de les éditer et de lancer les tests ; il résout 12.5 % des problèmes du SWE-bench complet.
Le 13 août 2024, OpenAI publie SWE-bench Verified. L'entreprise a fait examiner 1 699 problèmes tirés au hasard par 93 développeurs Python expérimentés, qui ont écarté ceux dont la description manquait de clarté ou dont les tests étaient injustes envers des solutions correctes ; il en est resté 500. Avec le meilleur framework open source de l'époque, GPT-4o en résout 33.2 %.
SWE-bench Verified est ensuite devenu l'indicateur de programmation le plus souvent cité à la sortie de nouveaux modèles. En octobre 2024, la version améliorée de Claude 3.5 Sonnet passe de 33.4 % à 49.0 % ; en mai 2025, Claude Opus 4 atteint 72.5 %. Ces scores portent tous sur Verified, filtré à la main, et ne se comparent pas directement aux chiffres des 2 294 problèmes d'origine ; reste qu'il n'a fallu qu'un an et demi pour passer de moins de 2 % à environ 70 %.
Conclusion
SWE-bench a extrait 2 294 issues réelles des 90 000 pull requests de 12 projets Python populaires, et juge la correction avec les tests du projet lui-même. Au moment de la publication, le meilleur modèle, Claude 2, en résolvait moins de 2 %, et 4.8 % seulement quand on lui donnait les bons fichiers.
La difficulté ne se limite pas à écrire du code. Le modèle doit trouver, dans un dépôt de 438 000 lignes, la trentaine de lignes à modifier, et plus on lui donne de code, moins il la trouve ; il doit aussi modifier sans rien casser, sous l'œil d'une médiane de 51 tests P2P par problème.
Ce benchmark était assez réaliste pour ne pas être saturé de sitôt. Un an et demi plus tard, les scores du classement étaient passés d'un seul chiffre à environ 70 %, grâce à des modèles plus forts, mais aussi parce que les modèles avaient appris à faire comme un ingénieur, à fouiller le dépôt, à lancer les tests et à lire les messages d'erreur avant de corriger.