Article original
Reflexion: Language Agents with Verbal Reinforcement Learning
- Publication
- NeurIPS 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2303.11366
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{reinforcementlearningreflexion2023,
  title = {{Reflexion: Language Agents with Verbal Reinforcement Learning}},
  author = {Noah Shinn and Federico Cassano and Edward Berman and Ashwin Gopinath and Karthik Narasimhan and Shunyu Yao},
  year = {2023},
  eprint = {2303.11366},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2303.11366}
}
Au printemps 2023, les travaux qui utilisent des modèles de langage comme agents se multiplient d'un coup. Avec ReAct, le modèle réfléchit tout en cherchant des informations ; avec Toolformer, il appelle lui-même des outils ; d'autres le font agir dans des jeux, des pages web ou des environnements de programmation.
Aucun de ces agents n'apprend de ses échecs. L'apprentissage par renforcement classique sait tirer les leçons d'un échec, mais il exige énormément d'essais et un fine-tuning coûteux, peu réaliste pour des modèles de plusieurs dizaines de milliards de paramètres. Les agents de l'époque n'ont donc que les exemples de leur prompt ; l'erreur commise cette fois-ci se répète à l'identique la fois suivante.
Shinn et al., de la Northeastern University aux États-Unis (rejoints dans les versions ultérieures par Narasimhan et Yao, de Princeton), prennent le problème sous un autre angle. Après une erreur, un humain repense à ce qui n'a pas marché et à ce qu'il faudra faire la prochaine fois ; un modèle peut faire de même, en écrivant sa réflexion sous forme de texte et en la plaçant dans le prompt de la tentative suivante. Les poids ne bougent pas d'un iota ; tout ce qui est appris est écrit dans le texte.
Définir le problème
Un agent effectue une suite d'actions dans un environnement et reçoit un retour à la fin. Ce retour est souvent très épars, parfois un simple « réussi » ou « échoué », ou un score.
Pour l'apprentissage par renforcement classique, la difficulté d'apprendre d'un tel signal tient à l'attribution du mérite (credit assignment). Sur une suite de plusieurs dizaines d'actions, laquelle a mal tourné ? Avec un simple 0 ou 1, difficile de répondre.
Les auteurs se demandent si un modèle de langage pourrait « amplifier » lui-même ce signal épars en conseils concrets, comme « à l'étape 3, j'ai pris le mauvais objet ; la prochaine fois, il faut d'abord chercher la lampe sur le bureau », puis se servir de ce texte pour guider la tentative suivante.
Résoudre le problème
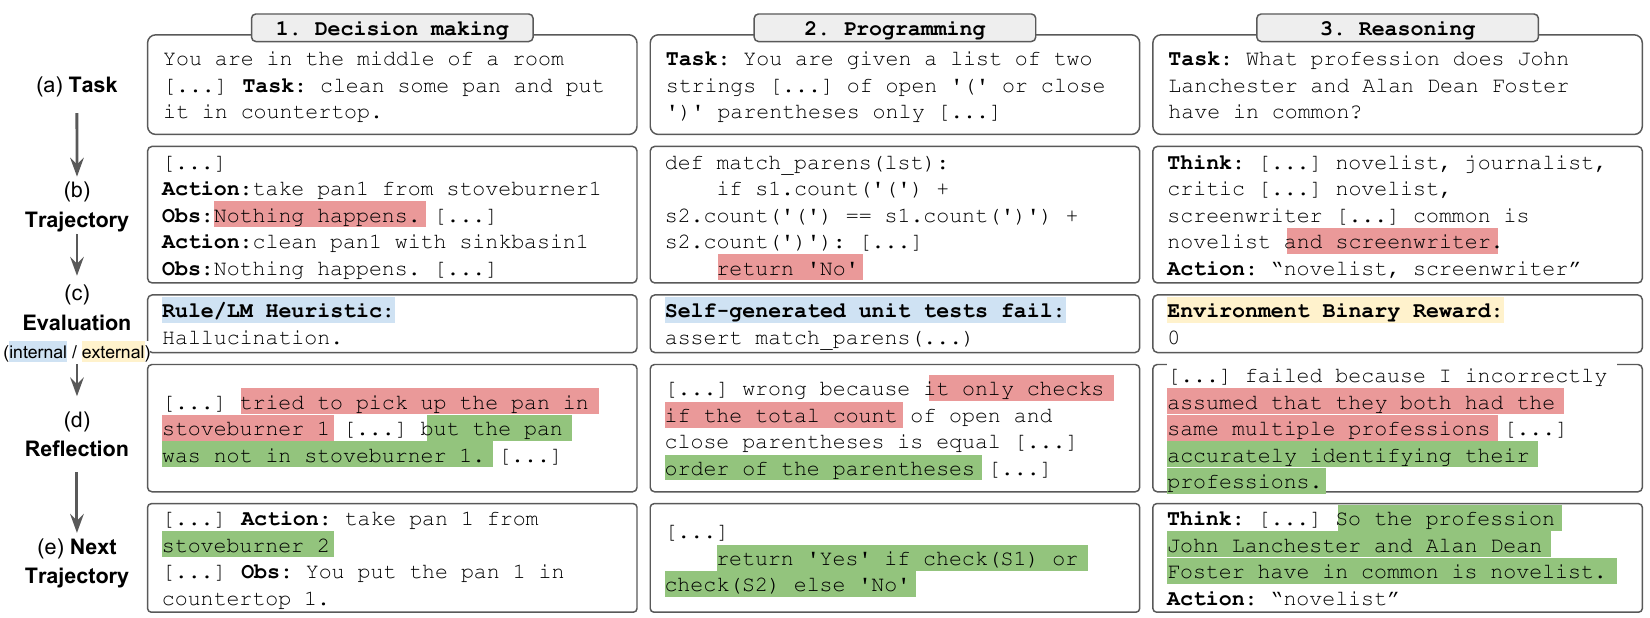
Trois modèles
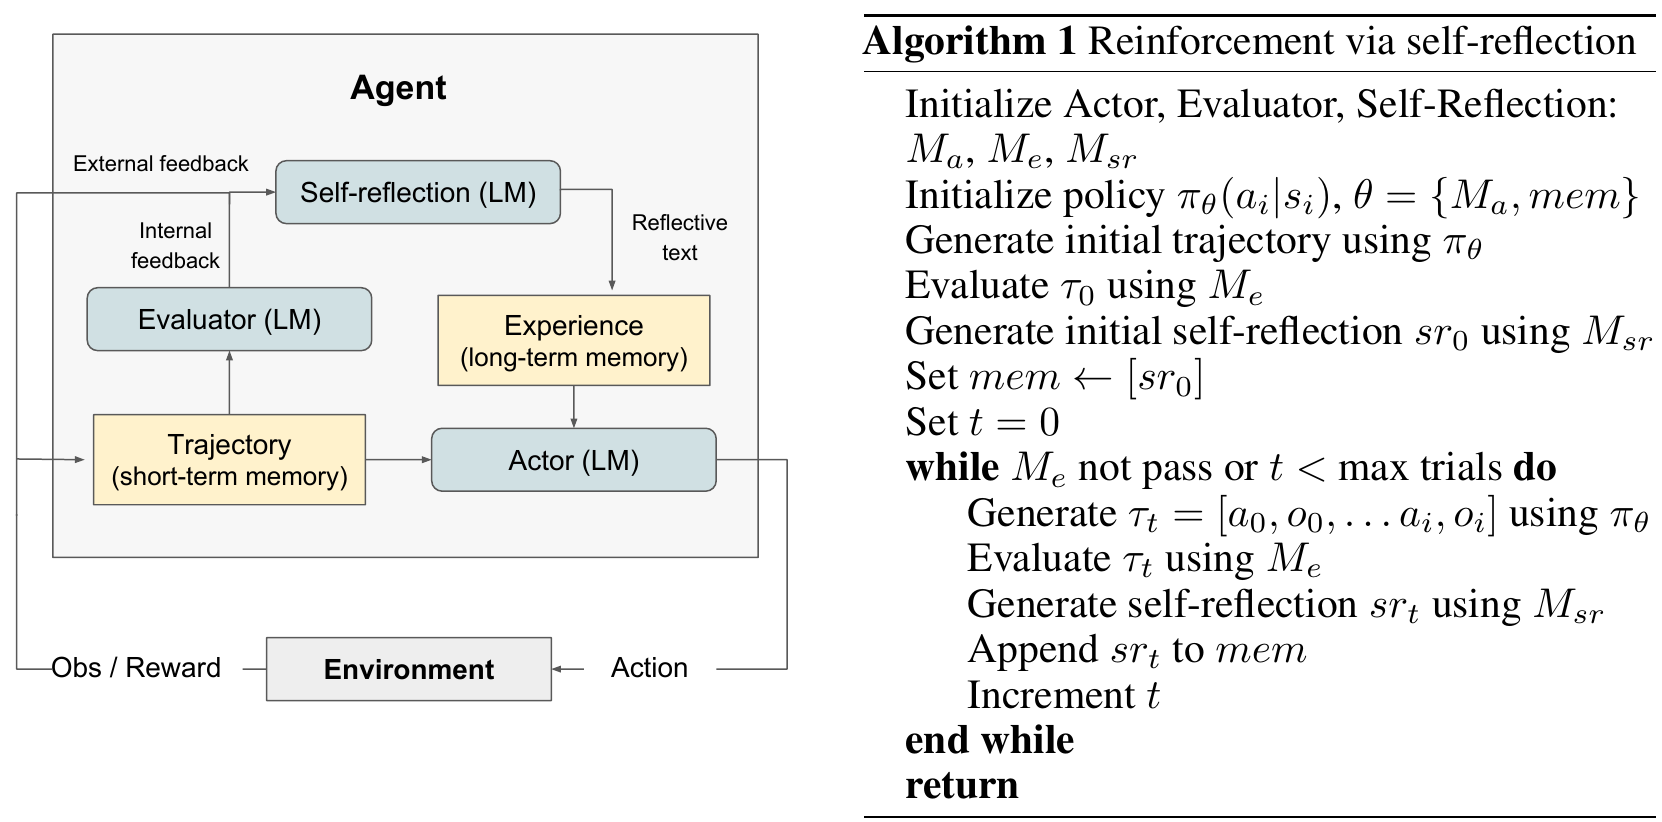
Reflexion se compose de trois rôles, qui peuvent tous être joués par le même modèle de langage avec des prompts différents :
- Actor : agit dans l'environnement, en produisant du texte et des actions. Les auteurs essaient deux variantes, la chaîne de pensée et ReAct, et ajoutent au prompt une section de mémoire.
- Evaluator : évalue la tentative. Pour les questions de raisonnement, le critère est la correspondance exacte avec la réponse de référence (exact match) ; pour les tâches de décision, des règles écrites à l'avance, ou un autre modèle de langage qui juge du succès ; pour la programmation, l'exécution des tests unitaires écrits par le modèle lui-même.
- Self-reflection : à partir du signal de succès ou d'échec, de la trajectoire de la tentative et de la mémoire passée, écrit une réflexion qui explique ce qui n'a pas marché et comment faire la prochaine fois.
Deux mémoires
La trajectoire complète de la tentative en cours constitue la mémoire à court terme, riche en détails ; le texte des réflexions forme la mémoire à long terme, plus concise, qui conserve les leçons apprises. À la tentative suivante, l'Actor voit les deux à la fois.
La mémoire à long terme ne peut pas grossir indéfiniment, sous peine de dépasser la longueur maximale du prompt. Les auteurs ne gardent que les dernières réflexions, 3 pour les tâches de décision et de raisonnement, 1 pour la programmation.
Déroulement
- L'Actor fait une tentative et produit la trajectoire .
- L'Evaluator donne un score .
- Le Self-reflection écrit, à partir de , une réflexion , placée en mémoire.
- On répète ; l'Actor réessaie avec sa mémoire, on évalue, on écrit une nouvelle réflexion et on l'ajoute à la mémoire, jusqu'à ce que l'Evaluator juge la tentative réussie ou que les essais soient épuisés.
Les auteurs parlent d'apprentissage par renforcement « verbal ». En apprentissage par renforcement classique, la politique est déterminée par les poids ; ici, la politique, c'est « modèle de langage + mémoire », et on la met à jour en réécrivant le texte de la mémoire. Les auteurs reconnaissent d'ailleurs franchement que l'approche repose sur la capacité du modèle de langage à s'autoévaluer, et que rien ne garantit son succès.
Discussion
Décision : AlfWorld
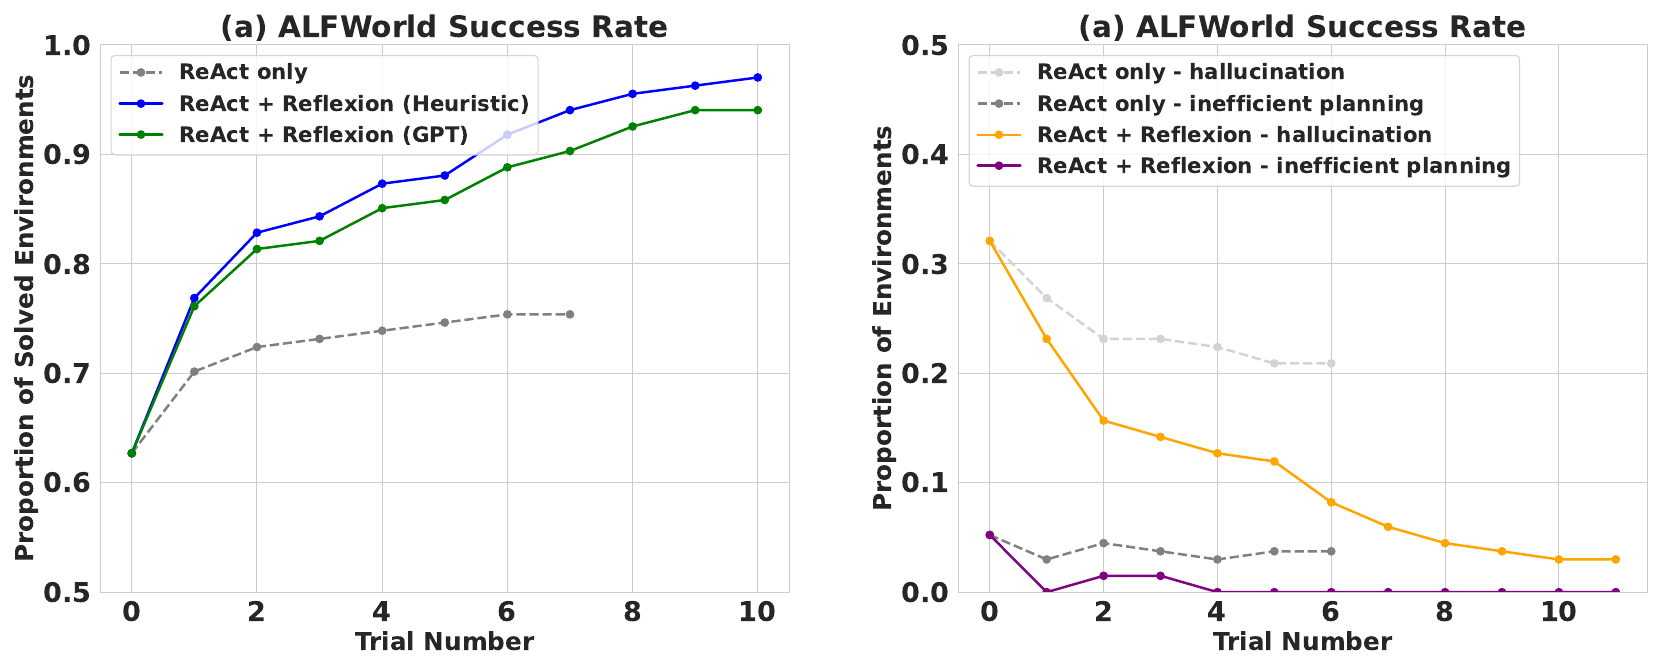
AlfWorld est un environnement domestique en version texte ; l'agent doit accomplir des tâches au moyen de commandes textuelles, comme trouver une spatule cachée dans un tiroir, apporter un couteau sur la planche à découper ou mettre une tomate à refroidir au réfrigérateur. Les auteurs reprennent le dispositif de ReAct et testent sur 134 environnements, avec ReAct comme Actor.
L'environnement indique seulement si la tâche est terminée ; c'est donc à l'Evaluator de décider quand il y a échec. Les auteurs utilisent deux règles simples. Si la même action est répétée plus de 3 fois avec la même réponse, c'est une hallucination ; si l'agent dépasse 30 actions dans l'environnement, c'est une planification inefficace.
Résultat, ReAct + Reflexion résout 130 tâches sur 134, alors que ReAct seul cesse de progresser après le 6e ou 7e essai.
La figure de droite classe les échecs par cause. L'échec le plus fréquent de ReAct consiste à croire qu'il possède déjà un objet alors que ce n'est pas le cas, puis à enchaîner une longue série d'actions sans jamais retrouver l'erreur ; ce type d'hallucination reste bloqué autour de 22 %. Reflexion condense une longue trajectoire ratée en quelques phrases de rappel, et l'erreur est évitée la fois suivante.
L'annexe donne un exemple concret. La tâche est « examiner la tasse à l'aide de la lampe de bureau » ; l'agent trouve d'abord la tasse et la prend, puis cherche la lampe, et finit par ne pas pouvoir s'en servir. Il écrit alors dans sa réflexion : « Mon plan était de trouver la tasse, puis la lampe, mais la tâche demande d'examiner la tasse avec la lampe ; j'aurais dû chercher la lampe d'abord. J'ai remarqué que la lampe était sur le bureau 1 ; la prochaine fois, j'irai directement au bureau 1. » À la deuxième tentative, l'agent termine en trois actions.
Raisonnement : HotPotQA
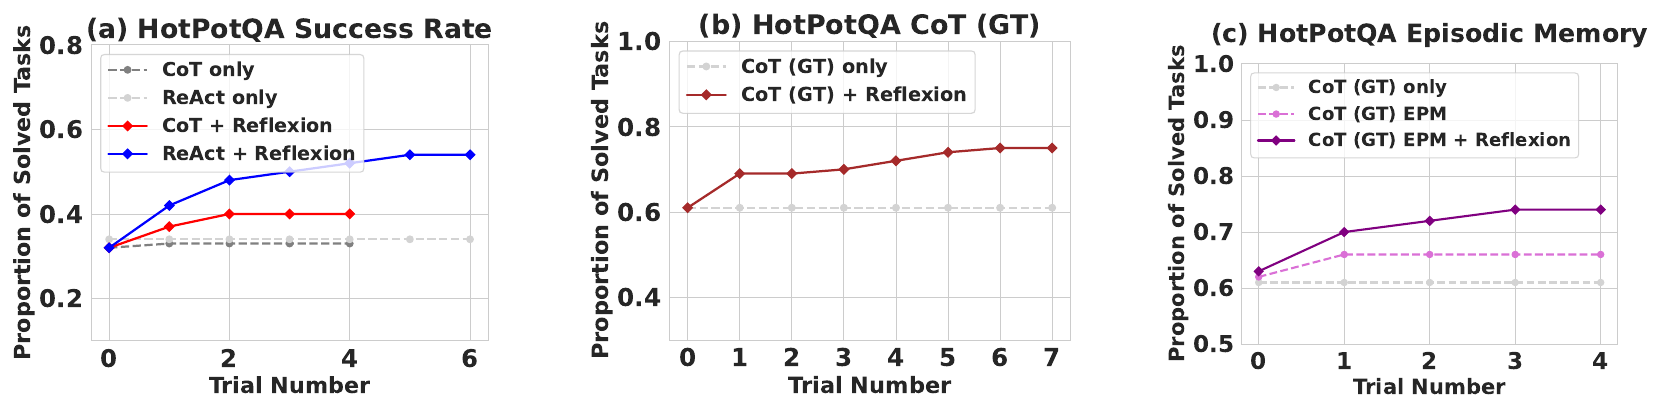
HotPotQA rassemble des questions dont la réponse demande de croiser plusieurs articles de Wikipédia. Les auteurs testent trois agents, chacun sur 100 questions :
- ReAct : peut chercher via l'API de Wikipédia, en raisonnant au fil des recherches.
- Chaîne de pensée : aucune recherche, uniquement du raisonnement.
- Chaîne de pensée avec les bons paragraphes de contexte (CoT (GT)) : on donne directement au modèle les paragraphes corrects fournis avec le jeu de données, pour tester la seule capacité de raisonnement.
Seuls, les trois agents ont beau réessayer, ils ne résolvent aucune nouvelle question, même en échantillonnant à une température de 0.7. Avec Reflexion, ReAct gagne environ 20 points. La chaîne de pensée avec les bons paragraphes part de plus haut, mais se trompe encore sur 39 % des questions ; Reflexion fait encore monter sa précision de 14 points.
Le progrès vient-il de la réflexion, ou simplement du fait de voir la tentative précédente ? L'ablation de la figure de droite sépare les deux. Mettre seulement la trajectoire complète précédente dans le prompt aide un peu ; ajouter une réflexion à la première personne apporte 8 points de plus. Les auteurs en concluent que faire simplement réécrire le modèle est moins efficace que de le faire réfléchir avant de réécrire.
Attention à la façon dont on note ici. Sur HotPotQA, après chaque tentative, l'environnement juge la réponse d'après la réponse de référence et dit à l'agent s'il a réussi ou échoué. Autrement dit, l'agent sait chaque fois qu'il s'est trompé, sans savoir quelle est la bonne réponse. Nous reviendrons plus loin sur ce dispositif.
Programmation : HumanEval, MBPP et LeetCode
La programmation est le terrain où Reflexion brille le plus, parce que l'agent peut s'y évaluer sans réponse de référence, en écrivant ses propres tests.
Les auteurs demandent d'abord au modèle, par chaîne de pensée, d'écrire toutes sortes de tests unitaires, les vérifient avec un arbre syntaxique pour ne garder que ceux qui sont syntaxiquement valides, puis en tirent au plus 6 pour former la suite de tests. Une fois le programme écrit, on lance ces tests ; s'ils échouent, l'agent réfléchit et réécrit, et il ne soumet sa solution que lorsque tous passent. Comme tout le processus ne touche jamais aux tests cachés du problème, la solution soumise compte toujours comme un pass@1.
| Benchmark (langage) | Record antérieur | GPT-4 | Reflexion |
|---|---|---|---|
| HumanEval (Python) | 65.8 | 80.1 | 91.0 |
| HumanEval (Rust) | - | 60.0 | 68.0 |
| MBPP (Python) | 67.7 | 80.1 | 77.1 |
| MBPP (Rust) | - | 70.9 | 75.4 |
| LeetCode Hard (Python) | - | 7.5 | 15.0 |
D'après la Table 1 de l'article ; le record antérieur est celui de CodeT avec GPT-3.5 ou Codex ; valeurs en pass@1 %.
- Les problèmes en Rust sont des problèmes Python traduits automatiquement avec MultiPL-E ; pour HumanEval, seuls les 50 plus difficiles sont retenus. Ils servent à montrer que la méthode est indépendante du langage.
- LeetCode Hard est un nouveau jeu de 40 problèmes construit par les auteurs, tous publiés après le 8 octobre 2022 (date limite des données de préentraînement de GPT-4).
- Le score de GPT-4 a été mesuré par les auteurs eux-mêmes ; ses 80.1 % sur HumanEval dépassent les 67.0 % annoncés dans le rapport technique de GPT-4.
Sur HumanEval Python, on passe de 80.1 % à 91.0 %, mais sur MBPP Python, on recule au contraire de 80.1 % à 77.1 %. En cherchant pourquoi, les auteurs découvrent que le problème vient des tests écrits par le modèle lui-même.
Les tests peuvent pécher de deux façons. Soit ils sont trop laxistes, un programme faux les passe tous, et l'agent soumet trop tôt une mauvaise réponse ; soit ils sont eux-mêmes faux, un programme correct échoue, et l'agent se met à réfléchir sur un programme qui n'avait rien de faux. Les auteurs jugent le second cas plus acceptable, puisque l'agent a encore une chance de comprendre, en réfléchissant, que ce sont les tests qui sont faux.
Sur MBPP Python, la proportion de cas « tous les tests passent, mais le programme est faux » est de 16.3 %, contre seulement 1.4 % sur HumanEval Python. Les précisions de base des deux benchmarks sont proches ; la différence tient à la qualité des tests.
Et si l'on retire une pièce ?
Les auteurs font une ablation sur les 50 problèmes les plus difficiles de HumanEval Rust, avec GPT-4 comme modèle de base :
| Variante | Tests générés | Réflexion | pass@1 |
|---|---|---|---|
| Modèle de base | Non | Non | 60% |
| Sans tests | Non | Oui | 52% |
| Sans réflexion | Oui | Non | 60% |
| Reflexion | Oui | Oui | 68% |
D'après la Table 3 de l'article.
Réfléchir sans écrire de tests donne même un résultat inférieur au modèle de base. L'agent n'a aucun moyen de savoir si le programme actuel est correct ; il doit donc épuiser toutes les itérations, en modifiant le code au fil de l'eau, jusqu'à abîmer des programmes qui étaient corrects.
Avec des tests mais sans réflexion, aucun progrès. Les tests et le compilateur repèrent bien les erreurs de syntaxe et de logique, mais quand le modèle réécrit directement le code, ses modifications ne correspondent pas à ces erreurs. Les auteurs en déduisent que les méthodes de débogage par essais et erreurs à l'aveugle, sans réflexion, sont peu efficaces sur des tâches plus difficiles comme l'écriture de programmes en Rust.
Il faut un modèle assez fort
L'annexe refait l'expérience avec d'autres modèles. Sur HumanEval Python, le modèle open source starchat-beta obtient 26 % avec ou sans Reflexion ; sur HotPotQA, text-davinci-003, gpt-3.5-turbo et gpt-4 progressent tous avec Reflexion. Les auteurs en concluent que savoir écrire des autocorrections utiles est une capacité propre aux modèles plus forts et plus grands.
Limites
- Optimum local : Reflexion est au fond une optimisation de politique par le texte, et peut encore rester coincé sur une solution médiocre. L'expérience WebShop de l'annexe en est un exemple ; l'agent doit trouver, sur un site marchand, un produit qui correspond à une demande, et en 4 essais, il ne progresse pas, ses réflexions ne l'aidant en rien. Selon les auteurs, ce type de tâche demande une exploration très variée et inventive, par exemple en changeant de mots-clés de recherche, ce dont Reflexion est incapable.
- Mémoire rudimentaire : une simple fenêtre glissante qui garde les dernières réflexions ; les auteurs suggèrent de passer à l'avenir à une base de données vectorielle ou SQL.
- Limites des tests : il est difficile d'écrire des tests fiables pour des fonctions non déterministes, des fonctions qui appellent des API externes, ou des fonctions dont la sortie dépend du matériel ou qui font du calcul parallèle.
Les auteurs rappellent aussi que les expériences de génération automatique de code doivent tourner dans un environnement isolé, car le code généré n'est soumis à aucune vérification avant d'être exécuté.
La suite
En octobre 2023, dans Large Language Models Cannot Self-Correct Reasoning Yet, Huang et al., de Google DeepMind et de l'UIUC, pointent un problème commun à ce type de travaux sur l'autocorrection. Les méthodes concernées, Reflexion comprise, s'appuient sur la réponse de référence pour décider quand arrêter de corriger ; on s'arrête quand la réponse est juste, et l'on ne continue que si elle est fausse. Or, en situation réelle, on ne connaît pas la bonne réponse.
Ils conçoivent un groupe témoin très incisif. On utilise toujours la réponse de référence pour décider s'il faut réessayer, mais la « correction » consiste à choisir au hasard une autre des options restantes. CommonsenseQA étant à cinq choix, chaque erreur élimine une option, et l'on tombe forcément sur la bonne en quatre tours au plus.
Sur CommonsenseQA, GPT-3.5 et GPT-4 partent respectivement de 75.8 % et 82.0 %. Après deux tours de hasard, GPT-3.5 atteint 87.9 %, à peu près autant que les 89.7 % obtenus après deux tours d'autocorrection par le modèle ; GPT-4 atteint 91.0 % au hasard, plus que les 85.5 % de l'autocorrection ; après quatre tours, les deux sont à 100 %. Tant que quelqu'un vous dit « c'est faux, recommence », vous devenez de plus en plus précis, même sans réfléchir du tout. Une fois la réponse de référence retirée, ils constatent que quand le modèle corrige lui-même ses réponses à des questions de raisonnement, les scores baissent au lieu de monter.
Cette critique vise surtout les questions de raisonnement. La programmation est un cas différent ; les tests et l'exécuteur sont en eux-mêmes des vérifications qui se passent de réponse de référence, et c'est précisément ainsi que Reflexion a obtenu ses 91 % sur HumanEval. Huang et al. notent eux aussi que les tâches comme la génération de code, qu'on peut vérifier avec un exécuteur et des tests unitaires, sont une autre affaire.
Les agents de programmation qui ont suivi ont pris le même chemin, en écrivant le code, lançant les tests, lisant les messages d'erreur et corrigeant, encore et encore. La différence, c'est que les tests sont désormais ceux du projet lui-même, et le retour, de vrais messages d'erreur.
Conclusion
Reflexion ne touche pas aux poids ; il écrit l'expérience de chaque échec sous forme de réflexion et la place dans le prompt de la tentative suivante. Sur AlfWorld, il résout 130 tâches sur 134 ; sur HotPotQA, il gagne environ 20 points ; sur HumanEval Python, le pass@1 passe de 80.1 % à 91.0 %.
C'est en programmation qu'il est le plus convaincant. Les tests sont écrits par le modèle lui-même, qui n'a vu aucune réponse de référence avant de soumettre ; et l'ablation montre que tests et réflexion sont indispensables l'un à l'autre, puisque réfléchir sans tester fait même baisser le score.
La partie sur le raisonnement est à prendre avec des pincettes ; on dit chaque fois à l'agent « c'est faux », et c'est justement l'information qui manque le plus dans le monde réel. Aussi bonne que soit la réflexion, encore faut-il que quelqu'un lui dise d'abord qu'il s'est trompé.