Article original
Evaluating Large Language Models Trained on Code
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2107.03374
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modelevaluationcodex2021,
  title = {{Evaluating Large Language Models Trained on Code}},
  author = {Mark Chen and Jerry Tworek and Heewoo Jun and Qiming Yuan and Henrique Ponde de Oliveira Pinto and Jared Kaplan and Harri Edwards and Yuri Burda and Nicholas Joseph and Greg Brockman and Alex Ray and Raul Puri and Gretchen Krueger and Michael Petrov and Heidy Khlaaf and Girish Sastry and Pamela Mishkin and Brooke Chan and Scott Gray and Nick Ryder and Mikhail Pavlov and Alethea Power and Lukasz Kaiser and Mohammad Bavarian and Clemens Winter and Philippe Tillet and Felipe Petroski Such and Dave Cummings and Matthias Plappert and Fotios Chantzis and Elizabeth Barnes and Ariel Herbert-Voss and William Hebgen Guss and Alex Nichol and Alex Paino and Nikolas Tezak and Jie Tang and Igor Babuschkin and Suchir Balaji and Shantanu Jain and William Saunders and Christopher Hesse and Andrew N. Carr and Jan Leike and Josh Achiam and Vedant Misra and Evan Morikawa and Alec Radford and Matthew Knight and Miles Brundage and Mira Murati and Katie Mayer and Peter Welinder and Bob McGrew and Dario Amodei and Sam McCandlish and Ilya Sutskever and Wojciech Zaremba},
  year = {2021},
  eprint = {2107.03374},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2107.03374}
}
Fin juin 2021, GitHub lance la préversion technique de Copilot. On écrit dans l'éditeur le nom d'une fonction et un commentaire, et il complète le corps de la fonction. Une semaine plus tard, OpenAI publie cet article, qui présente le modèle sous-jacent, Codex ; dès le premier paragraphe, l'article précise que Copilot utilise une autre version de Codex, destinée à la production.
L'idée vient de GPT-3. Les auteurs avaient remarqué plus tôt qu'après avoir lu une docstring Python, GPT-3 savait écrire quelques programmes simples. C'était rudimentaire, mais GPT-3 n'avait jamais été entraîné spécialement sur du code. Ils ont donc poursuivi l'entraînement de GPT sur le code de GitHub, pour voir jusqu'où il pouvait aller.
Cela dit, l'effort principal de l'article porte sur la question « comment juger si le modèle écrit bien ». HumanEval et pass@k, qu'il a laissés derrière lui, sont devenus l'épreuve et le barème de référence des modèles de code, et ont survécu à Codex lui-même.
Définir le problème
Jusque-là, les modèles de génération de code étaient le plus souvent notés par comparaison. On confrontait le programme écrit par le modèle à une solution de référence ; s'il était identique, ou si son score BLEU était assez élevé, on le considérait comme bien écrit.
Le problème, c'est qu'un programme peut s'écrire d'innombrables façons. return [i + 1 for i in l] et une boucle for qui fait des append un à un font exactement la même chose, alors que leurs textes diffèrent beaucoup ; à l'inverse, de deux programmes qui ne diffèrent que d'un caractère, l'un peut être juste et l'autre faux. Les auteurs ont d'ailleurs vérifié plus loin que les programmes erronés de Codex ont souvent un score BLEU plus élevé que les programmes corrects.
Les auteurs proposent de regarder plutôt la correction fonctionnelle ; un programme n'est juste que s'il passe les tests unitaires. C'est aussi la façon dont les ingénieurs jugent un programme au quotidien ; le développement piloté par les tests consiste justement à écrire d'abord les besoins sous forme de tests, puis l'implémentation.
Pour noter de cette façon, il faut d'abord régler trois choses :
- Les questions de l'examen ne doivent pas figurer dans les données d'entraînement. Codex a lu la majeure partie de GitHub, et rien que pour les solutions aux problèmes de Codeforces, GitHub compte plus d'une dizaine de dépôts publics.
- Il faut savoir calculer un score équitable quand on tire de nombreuses réponses pour un même problème.
- Le code écrit par le modèle n'est pas digne de confiance ; il faut un endroit où l'exécuter en toute sécurité.
Le troisième point relève de l'ingénierie. Les auteurs utilisent le runtime de conteneurs gVisor pour isoler l'hôte des conteneurs, puis un pare-feu eBPF qui bloque toutes les connexions réseau autres que celles du contrôle des expériences. Les deux premiers, ce sont HumanEval et pass@k.
HumanEval
Les auteurs ont écrit à la main 164 problèmes ; chacun comporte une signature de fonction, une docstring, une solution de référence et en moyenne 7.7 tests unitaires. Les problèmes couvrent la compréhension du langage, le raisonnement, l'algorithmique et des mathématiques simples ; certains ont à peu près la difficulté d'une question simple d'entretien d'embauche en développement logiciel.
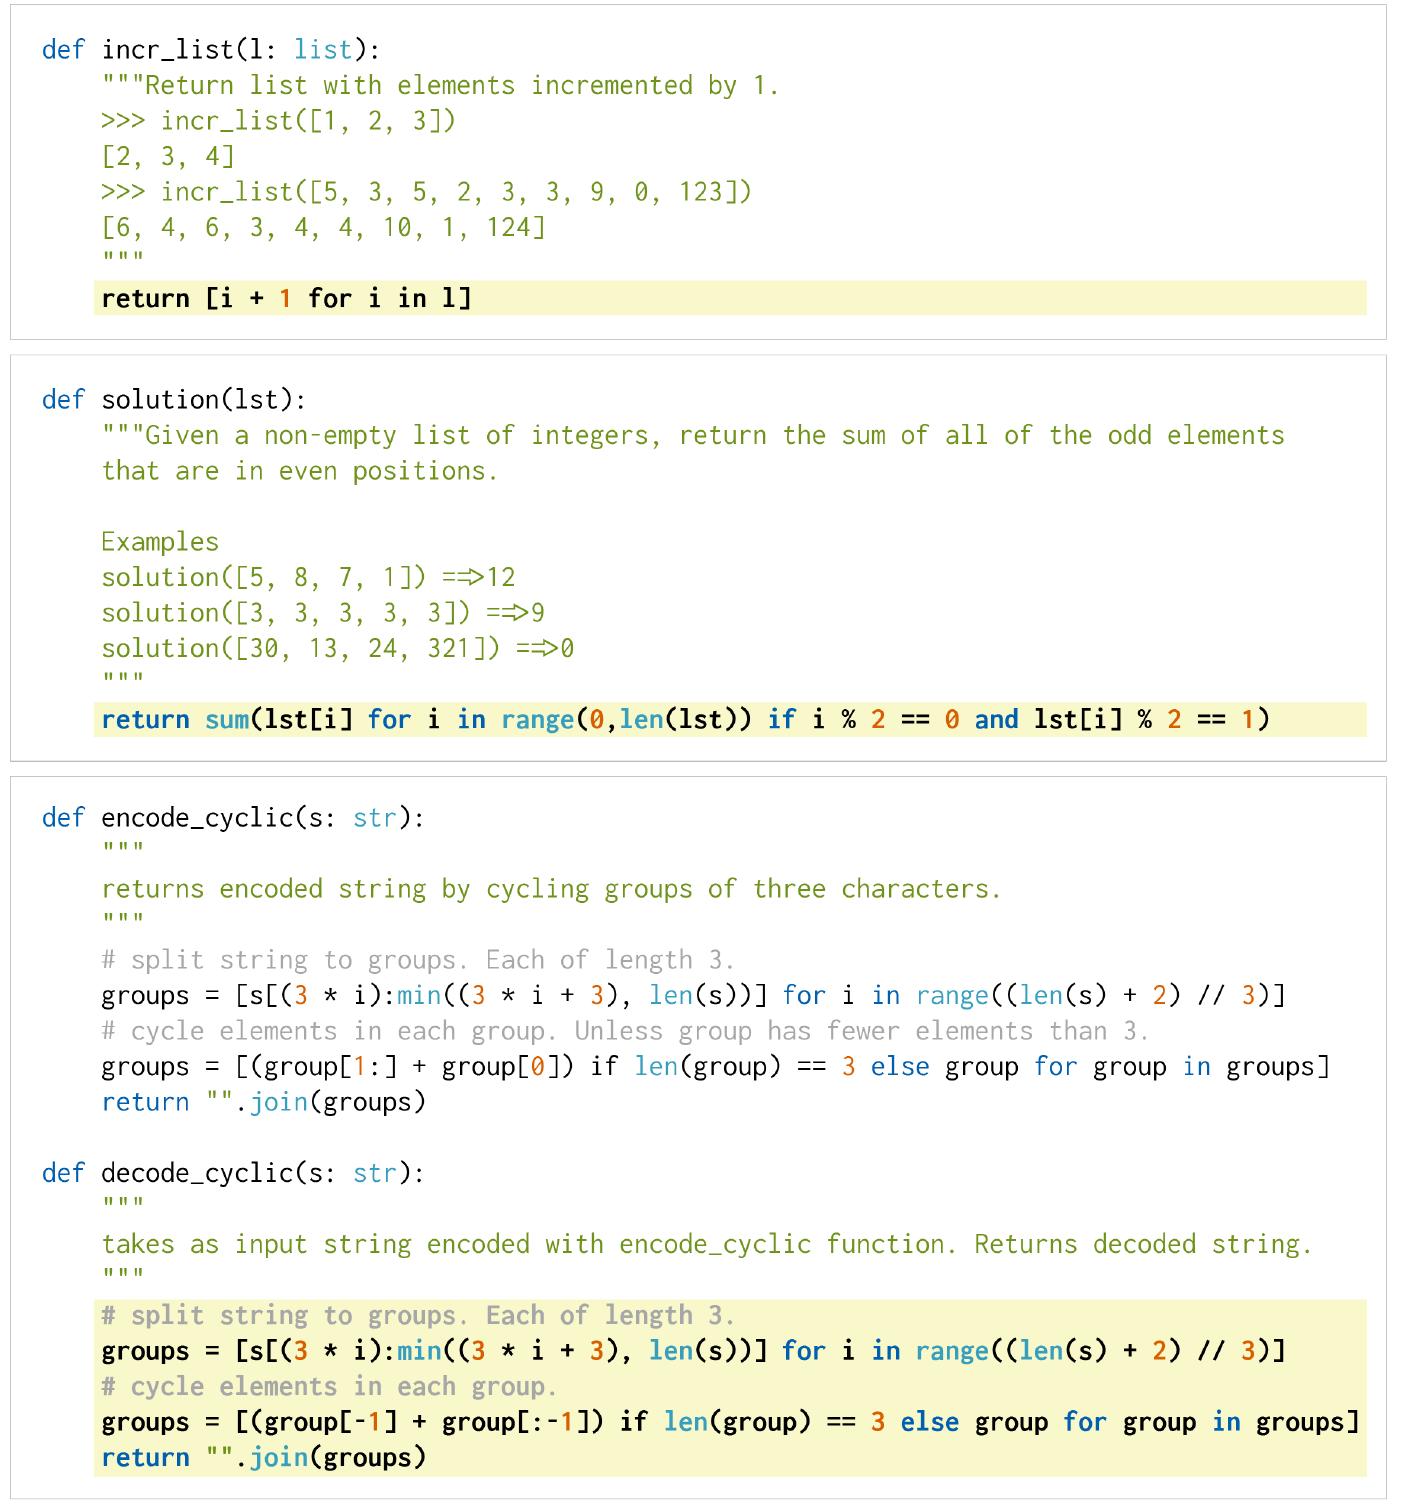
Sur fond blanc, le prompt donné au modèle ; sur fond jaune, la réponse qu'il a écrite. Les trois problèmes vont du plus facile au plus difficile ; la probabilité que Codex-12B les résolve en un seul tirage est respectivement de 0.9, 0.17 et 0.005. Pour le plus difficile, il faut d'abord comprendre comment encode_cyclic fait tourner chaque groupe de trois caractères, puis écrire l'opération inverse.
Le prompt ne contient que l'en-tête, la signature de la fonction et la docstring. Le modèle continuerait d'écrire sans fin ; on l'arrête donc dès qu'il produit \nclass, \ndef, \n#, \nif ou \nprint, faute de quoi il enchaînerait sur la fonction suivante ou sur du code de test.
pass@k
On peut faire tirer au modèle de nombreuses réponses pour un même problème. pass@k consiste à tirer k réponses ; si l'une d'elles passe les tests, le problème compte comme résolu, puis on fait la moyenne sur tous les problèmes.
Le calcul le plus direct consiste à tirer réellement k fois par problème, mais la variance est alors très grande. Les auteurs tirent plutôt échantillons par problème (l'article utilise , ), comptent les qui passent les tests, et font l'estimation suivante :
La fraction est la probabilité qu'en prenant au hasard échantillons parmi les , ils soient tous faux ; en la retranchant de 1, on obtient la probabilité qu'au moins un des soit juste.
Calculés directement, les coefficients binomiaux deviennent gigantesques ; l'article fournit donc une version numériquement stable, qui développe le produit terme à terme. Appliquons-la à un problème :
import numpy as np
from math import comb

def pass_at_k(n, c, k):
    """Version de la Figure 3 de l'article : sur n échantillons, c passent les tests ; estime pass@k"""
    if n - c < k:
        return 1.0
    return 1.0 - np.prod(1.0 - k / np.arange(n - c + 1, n + 1))

n, c = 200, 10              # 200 tirages pour un problème, dont 10 passent les tests
for k in (1, 10, 100):
    exact = 1 - comb(n - c, k) / comb(n, k)       # calcul direct avec les coefficients binomiaux
    naive = 1 - (1 - c / n) ** k                  # extrapolation brute à partir de pass@1
    print(f"k={k:3d}  unbiased={pass_at_k(n, c, k):.4f}  comb={exact:.4f}  naive={naive:.4f}")

# k=  1  unbiased=0.0500  comb=0.0500  naive=0.0500
# k= 10  unbiased=0.4085  comb=0.4085  naive=0.4013
# k=100  unbiased=0.9992  comb=0.9992  naive=0.9941
La version stable donne le même résultat que le calcul direct avec les coefficients binomiaux. La formule intuitive donne en revanche une valeur légèrement trop basse, et l'article démontre en annexe qu'elle sous-estime toujours. Elle revient à tirer fois « avec remise » parmi les échantillons, alors que l'estimateur sans biais tire sans remise.
Il y a un piège dans lequel on tombe encore plus facilement. pass@k doit être estimé problème par problème, puis moyenné ; on ne peut pas le déduire du pass@1 de l'ensemble du jeu de données. Prenons trois problèmes de difficultés très différentes, dont les probabilités de réussite en un tirage sont de 0.9, 0.17 et 0.005, c'est-à-dire les trois exemples de HumanEval vus plus haut. Supposons 200 tirages par problème, dont respectivement 180, 34 et 1 réussis.
Le pass@1 moyen des trois problèmes est de 0.358 ; si l'on en déduit pass@100, on obtient 1.0. En réalité, le problème le plus difficile n'est réussi qu'une fois sur 200 tirages ; en en prenant 100 au hasard, on n'a qu'une chance sur deux de tomber sur ce tirage-là, si bien que la moyenne des trois problèmes est de 0.833. Quand les difficultés des problèmes sont très différentes, les résultats des problèmes faciles masquent les problèmes difficiles.
Résoudre le problème
Codex : poursuivre l'entraînement de GPT sur GitHub
Les données d'entraînement sont des fichiers Python collectés en mai 2020 dans 54 millions de dépôts publics de GitHub ; après dédoublonnage, les fichiers de moins de 1 Mo totalisent 179 Go. Les auteurs écartent ensuite les fichiers probablement générés automatiquement, ceux dont la longueur moyenne des lignes dépasse 100, dont la ligne la plus longue dépasse 1 000, ou dont la proportion de caractères alphanumériques est trop faible ; il reste au final 159 Go.
Le modèle est fine-tuné à partir des poids de la famille GPT-3, jusqu'à 12 milliards de paramètres. Les auteurs pensaient au départ que GPT, qui possède déjà de solides représentations du langage naturel, serait un meilleur point de départ. Au final, les performances sont à peu près les mêmes qu'avec un entraînement à partir de zéro, probablement, d'après eux, parce que les données de fine-tuning sont trop volumineuses. Partir de GPT fait toutefois converger plus vite, et c'est donc ce qu'ils font dans toutes les expériences suivantes. L'entraînement porte sur 100 milliards de tokens au total, avec le taux d'apprentissage du modèle GPT correspondant.
Le tokeniseur est lui aussi repris de GPT-3, mais la distribution des mots dans le code est très différente de celle du langage naturel, et le plus gros gaspillage vient des espaces d'indentation. Les auteurs ajoutent un jeu de tokens qui représentent des suites d'espaces de différentes longueurs ; le même code demande alors environ 30 % de tokens en moins.
L'échantillonnage se fait par nucleus sampling avec top p = 0.95, et la température doit être ajustée selon k. Pour le modèle de 679M, la meilleure température est de 0.2 pour pass@1 et de 0.8 pour pass@100. Quand k est grand, mieux vaut des échantillons aussi différents que possible les uns des autres, puisqu'il suffit qu'un seul soit juste.
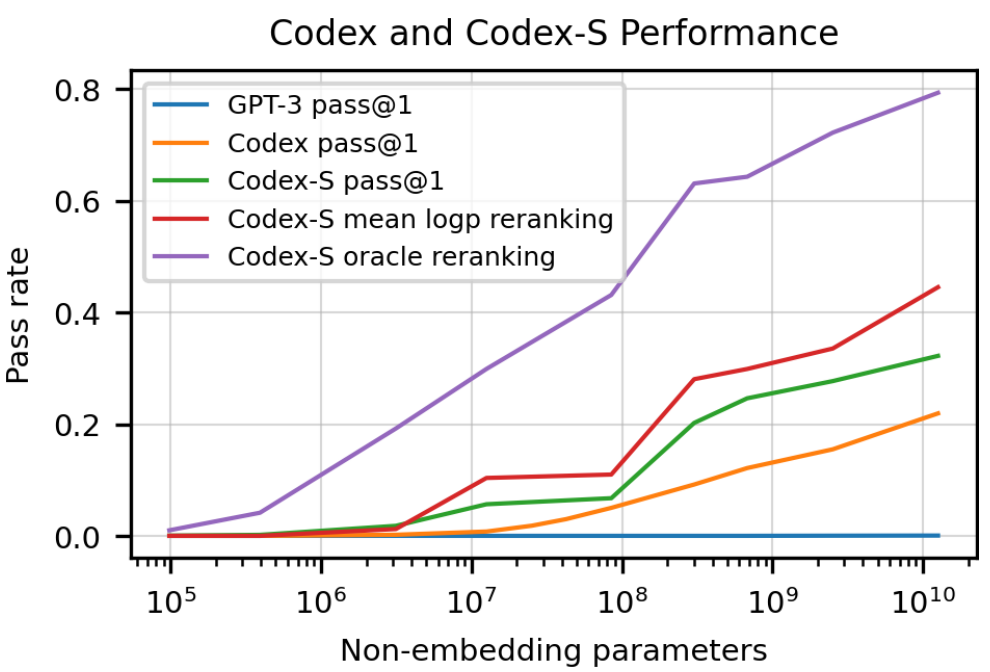
Cette figure rassemble les résultats de tout l'article. L'abscisse est le nombre de paramètres hors embeddings. La ligne bleue est le pass@1 de GPT-3, collé à 0 d'un bout à l'autre ; la ligne orange est Codex, la ligne verte Codex-S, présenté à la section suivante. Tous les échantillons de la figure sont tirés à une température de 0.8 ; ces deux courbes de pass@1 sont donc en dessous des meilleurs résultats rapportés dans l'article. Avec la température la mieux adaptée à chacun, le Codex de 12B résout 28.8 % des problèmes en un tirage, et Codex-S 37.7 %. Les lignes rouge et violette font tirer à Codex-S 100 échantillons par problème ; elles diffèrent par la manière de choisir. La ligne rouge retient celui dont la log-probabilité moyenne est la plus élevée, soit 44.5 % ; pour la ligne violette, c'est un oracle connaissant les résultats des tests qui choisit, et il suffit qu'un des 100 passe, soit 77.5 %.
La comparaison avec d'autres modèles :
| Modèle | pass@1 | pass@10 | pass@100 |
|---|---|---|---|
| TabNine | 2.58 % | 4.35 % | 7.59 % |
| GPT-Neo 2.7B | 6.41 % | 11.27 % | 21.37 % |
| GPT-J 6B | 11.62 % | 15.74 % | 27.74 % |
| Codex-300M | 13.17 % | 20.37 % | 36.27 % |
| Codex-2.5B | 21.36 % | 35.42 % | 59.50 % |
| Codex-12B | 28.81 % | 46.81 % | 72.31 % |
D'après la Table 1 de l'article.
GPT-Neo et GPT-J sont des modèles open source d'EleutherAI entraînés sur The Pile, dont environ 8 % des données sont du code GitHub ; à taille égale, les modèles GPT sont presque à 0. GPT-J 6B équivaut à peu près à Codex-300M, avec 20 fois plus de paramètres. TabNine était alors l'un des principaux outils d'autocomplétion de code ; son plus grand modèle gratuit équivaut à peu près à Codex-12M.
Codex-S : des données d'entraînement plus proches de l'examen
Le Python de GitHub ne se limite pas à des fonctions autonomes ; on y trouve des classes, des fichiers de configuration, des scripts, et même des fichiers qui servent à stocker des données, très loin de « lire une docstring et écrire une fonction ». Les auteurs collectent donc un ensemble de fonctions autonomes correctement implémentées, et procèdent à un nouveau fine-tuning supervisé ; le résultat s'appelle Codex-S.
Les données ont deux sources :
- Sites de programmation compétitive et de préparation aux entretiens : l'énoncé du problème sert de docstring, accompagné de la signature de la fonction et de la solution. Comme les tests complets ne sont généralement pas publics, les auteurs construisent des tests à partir des exemples de l'énoncé, ou soumettent volontairement des solutions fausses pour extraire d'autres cas de test des retours du site. 10 000 problèmes au total.
- Projets open source dotés d'intégration continue (CI) : avec
sys.setprofilede Python, les auteurs enregistrent les entrées et les sorties de chaque fonction pendant les tests d'intégration, puis les transforment en tests unitaires. Ils montent les environnements et lancent les tests en suivant les fichiers de configuration de travis et de tox, et utilisent aussi des paquets de PyPI. Ces fonctions sont pour la plupart des briques d'outils en ligne de commande ; elles demandent d'implémenter une fonctionnalité en suivant la docstring, et non de trouver un algorithme. Environ 40 000 problèmes au total.
La qualité des problèmes collectés automatiquement est inégale. Certains énoncés sont incomplets, et une réponse correcte peut alors être jugée fausse par les tests ; d'autres dépendent d'un état, et chaque exécution donne un résultat différent. Les auteurs font tirer à Codex-12B 100 réponses par problème ; si aucune ne passe, le problème est considéré comme mal posé ou trop difficile, et supprimé. Cette vérification est relancée plusieurs fois, ce qui élimine aussi les problèmes aux résultats instables.
À l'entraînement, la perte n'est calculée que sur la solution de référence ; la partie prompt est masquée. Le taux d'apprentissage est le dixième de celui de Codex, et l'entraînement se poursuit jusqu'à ce que la perte de validation cesse de baisser, ce qui demande moins de 10 milliards de tokens.
Toutes tailles de modèle confondues, Codex-S dépasse Codex en moyenne de 6.5 points de pourcentage en pass@1, et de 15.1 points en pass@100.
Comment choisir quand il n'y a pas de tests
pass@k suppose que quelqu'un sait quelle réponse est juste. En usage réel, comme outil d'autocomplétion, l'utilisateur ne voit qu'une seule suggestion et n'a pas de tests unitaires sous la main.
Les auteurs comparent plusieurs façons de choisir. Retenir l'échantillon dont la « log-probabilité moyenne par token » est la plus élevée fait mieux qu'un choix au hasard ; retenir celui dont la « log-probabilité totale » est la plus élevée peut au contraire faire un peu moins bien que le hasard.
Une autre idée consiste à écrire dans l'autre sens. Les auteurs entraînent Codex-D, qui lit du code et écrit une docstring, puis s'en servent pour calculer la probabilité de « retrouver la docstring d'origine à partir de ce code », et retiennent l'échantillon pour lequel elle est la plus élevée. Cette méthode bat le hasard, mais perd face à la log-probabilité moyenne, et surapprend très vite.
Codex-D lui-même ne manque pas d'intérêt. Les auteurs notent à la main les docstrings qu'il écrit, et ne les comptent justes que si elles décrivent le code de façon univoque et exacte ; son pass@1 est de 20.3 %, contre 32.2 % pour Codex-S écrivant du code dans les mêmes conditions. Les auteurs avancent une explication possible, à savoir que les développeurs soignent rarement leurs docstrings ; le modèle a même appris à écrire « I just found this function online » et « This test is not correctly written and it's not my solution ».
Discussion
Plus la consigne est longue, plus il se trompe
Les auteurs prennent comme briques 13 opérations simples sur les chaînes de caractères, par exemple « convertir la chaîne en minuscules » ou « supprimer un caractère sur trois », les enchaînent pour former des docstrings de plus en plus longues, puis regardent si Codex-12B parvient à écrire le programme.
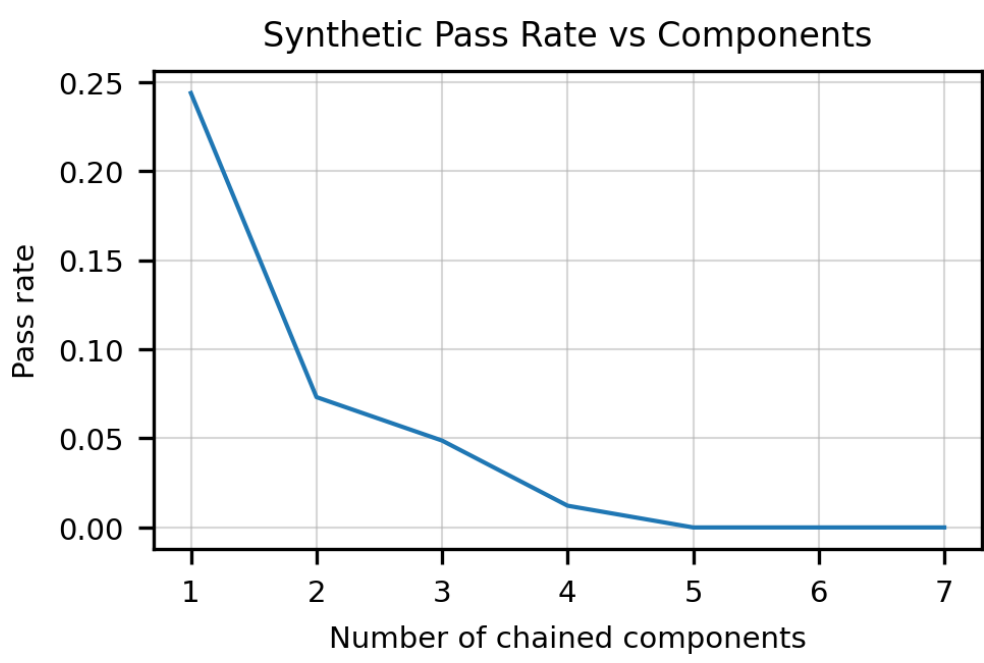
Chaque brique supplémentaire divise le taux de réussite par deux ou trois environ, et à partir de cinq briques il tombe à 0. Un ingénieur humain ne se comporte pas ainsi ; quelqu'un qui sait en écrire deux en écrit sept, ça lui prend juste plus de temps.
Autre difficulté, appliquer chaque opération à la bonne variable. L'article donne l'exemple suivant, qui demande d'« ajouter 3 à y, de soustraire 4 à x et à w, puis de renvoyer le produit des quatre nombres » :
def do_work(x, y, z, w):
    """ Add 3 to y, then subtract 4
    from both x and w. Return the
    product of the four numbers. """
    t = y + 3
    u = x - 4
    v = z * w
    return v
Codex-12B ne soustrait pas 4 à w, et ne renvoie au final que le produit de deux nombres.
Il sait faire, mais il recopie l'erreur
C'est l'expérience la plus visionnaire de l'article. Les auteurs placent d'abord quelques exemples dans le prompt, soit des programmes corrects, soit des programmes qui contiennent des erreurs subtiles, comme une erreur de borne décalée d'une unité ou un caractère mal tapé, puis demandent au modèle de traiter le problème suivant.
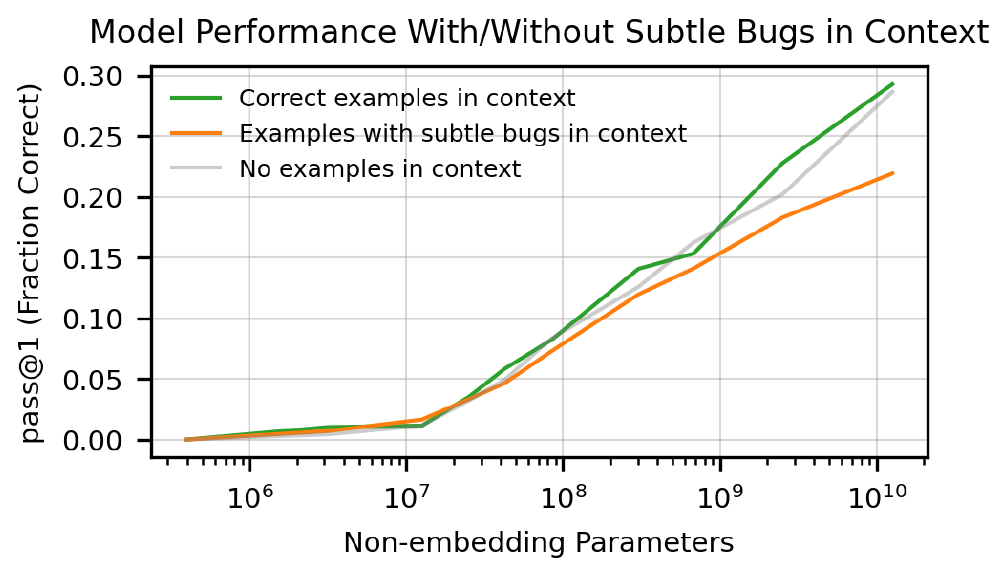
La ligne verte correspond aux exemples corrects, l'orange aux exemples fautifs, la grise à l'absence d'exemples. Pour les petits modèles, les trois lignes sont proches ; plus le modèle grandit, plus l'orange prend du retard, environ 0.22 contre 0.29 à 12B. Les auteurs ont aussi essayé de demander explicitement dans le prompt d'« écrire du code correct » ; cela n'aide qu'un peu.
L'objectif d'entraînement de Codex est d'imiter ses données d'entraînement ; s'il y a des bugs dans le contexte, il écrit à son tour du code bogué. Il est capable d'écrire juste, mais ne fait pas ce que l'utilisateur veut vraiment. L'article appelle cela le désalignement (misalignment) et le distingue du manque de capacité ; ne pas savoir faire est un problème de capacité, savoir faire et ne pas le faire, c'est du désalignement. Le plus ennuyeux, c'est que cet écart se creuse à mesure que le modèle grandit. Parmi les pistes d'amélioration que l'article énumère en annexe figure d'ailleurs l'apprentissage par renforcement à partir de retours humains.
Analyse des risques
La section 7 de l'article est une analyse des risques, au moins aussi longue que les expériences qui précèdent.
- Dépendance excessive : Codex peut proposer du code qui a l'air juste mais ne fait pas ce que l'utilisateur demande, et les débutants s'y laissent particulièrement prendre. Plus le modèle est performant, plus on baisse facilement la garde.
- Sécurité : le modèle peut écrire du code vulnérable. D'après leurs tests, les auteurs estiment qu'avec ses capacités de l'époque, Codex n'abaissait pas nettement la barrière à l'entrée pour écrire des logiciels malveillants.
- Économie : un ingénieur ne passe pas toute sa journée à écrire du code, l'effet à court terme reste donc limité ; mais Codex fait appel aux différents paquets à des fréquences différentes, et les auteurs des paquets qu'il recommande pourraient en tirer avantage.
- Droit : le code généré reproduit à l'identique les données d'entraînement dans moins de 0.1 % des cas, et il s'agit surtout de tournures idiomatiques qui reviennent sans cesse dans le langage.
La suite
HumanEval est vite devenu l'examen standard des modèles de code ; presque tous les rapports techniques de LLM indiquent leur pass@1. Mais 164 problèmes avec 7.7 tests en moyenne, à force de servir, on finit par en voir les failles. En 2023, EvalPlus ajoute automatiquement un grand nombre de tests à chaque problème, environ 80 fois plus qu'à l'origine au total ; le pass@k des modèles perd jusqu'à 19.3 à 28.9 %, et le classement change. Bon nombre de programmes qui « passaient » n'avaient simplement pas été pris en défaut par les tests.
Les scores ont aussi été très vite poussés au plafond. En 2023, GPT-4 obtient 67 % ; en 2024, le pass@1 des modèles de pointe dépasse déjà 90 %. Il a donc fallu passer à des évaluations plus proches du travail réel, comme SWE-bench, qui demande au modèle de résoudre des issues GitHub.
Quant au modèle Codex, OpenAI a retiré la série Codex de son API dès mars 2023. Le nom, lui, a resservi. En avril 2025, OpenAI lance Codex CLI, qui écrit du code dans le terminal, puis en mai un agent de programmation dans le cloud ; les deux s'appellent Codex.
Conclusion
Codex a montré qu'après un entraînement prolongé sur une grande quantité de code, GPT sait écrire, à partir d'une docstring, des fonctions qui tournent. En un seul tirage, le 12B résout 28.8 % de HumanEval ; avec 100 tirages par problème, plus de 70 % des problèmes sont résolus au moins une fois.
Ce que l'article a laissé de plus durable, ce sont les règles de notation. La justesse d'un programme est confiée aux tests, sans comparaison littérale avec une solution de référence ; pass@k est estimé problème par problème, puis moyenné. Les modèles de code des années suivantes se sont presque tous mesurés selon ces règles.
Alors, si la docstring est écrite à la va-vite, difficile d'attendre du modèle qu'il soit beaucoup plus sérieux. Parmi les docstrings qu'il a lues sur GitHub, il y avait même « I just found this function online ».