Article original
Toolformer: Language Models Can Teach Themselves to Use Tools
- Publication
- NeurIPS 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2302.04761
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modeltuningtoolformer2023,
  title = {{Toolformer: Language Models Can Teach Themselves to Use Tools}},
  author = {Timo Schick and Jane Dwivedi-Yu and Roberto Dessì and Roberta Raileanu and Maria Lomeli and Luke Zettlemoyer and Nicola Cancedda and Thomas Scialom},
  year = {2023},
  eprint = {2302.04761},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2302.04761}
}
Les grands modèles de langage ont quelque chose de paradoxal. Quelques exemples leur suffisent pour aborder une nouvelle tâche, et ils rédigent, traduisent et répondent aux questions de façon tout à fait convaincante ; pourtant, ils se trompent souvent sur une simple division, se souviennent mal du lieu de naissance de quelqu'un et ignorent la date du jour. Une calculatrice, un moteur de recherche ou un calendrier régleraient ces problèmes.
Début 2023, faire utiliser des outils à un modèle n'avait rien de nouveau. Mais les approches se rangeaient en gros dans deux familles. La première exige beaucoup d'annotations humaines ; LaMDA, par exemple, fait montrer par des annotateurs quand il faut aller chercher une information. La seconde écrit des prompts few-shot propres à une tâche, qui indiquent d'avance au modèle qu'ici il faut la calculatrice et là le moteur de recherche. La première coûte cher, la seconde est à réécrire à chaque nouvelle tâche.
Schick et al., chez Meta, veulent que le modèle apprenne seul. Ils ne fournissent que quelques démonstrations par outil, laissent le modèle insérer lui-même des appels d'outils dans une grande quantité de texte ordinaire, et c'est encore lui qui juge quels appels l'ont vraiment aidé.
Définir le problème
Les auteurs veulent que cette capacité à utiliser des outils remplisse deux conditions :
- Autosupervision : pas besoin de grandes quantités d'annotations humaines. Pas seulement parce qu'elles coûtent cher, mais aussi parce que l'information qu'un humain juge utile n'est pas forcément celle dont le modèle a besoin.
- Généralité préservée : c'est le modèle qui décide s'il utilise un outil, lequel et comment, sans que cette capacité soit liée à une tâche précise.
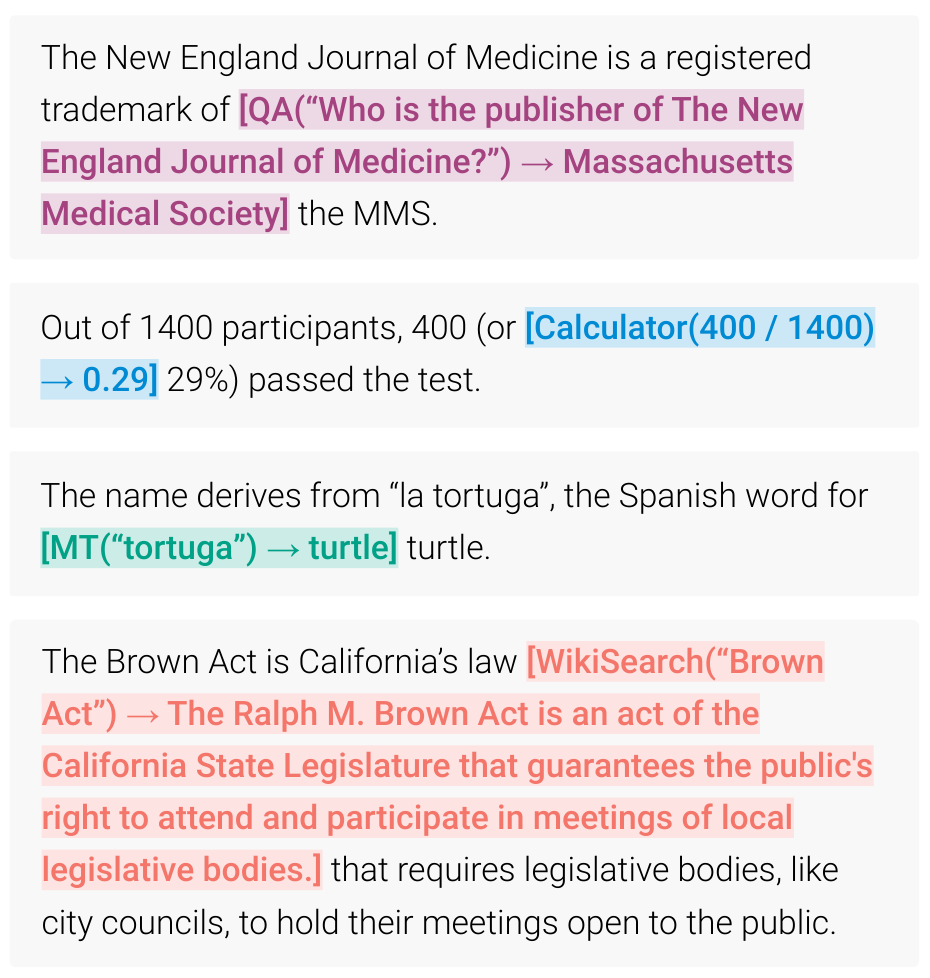
Pour que les appels d'outils puissent s'écrire directement dans le texte, les auteurs représentent chaque appel d'API par une chaîne de texte. Un appel se compose du nom de l'API, , et d'une entrée , et son résultat est :
En pratique, les caractères existants « [ », « ] » et « -> » remplacent les symboles spéciaux, ce qui évite de modifier le vocabulaire du modèle.
Résoudre le problème
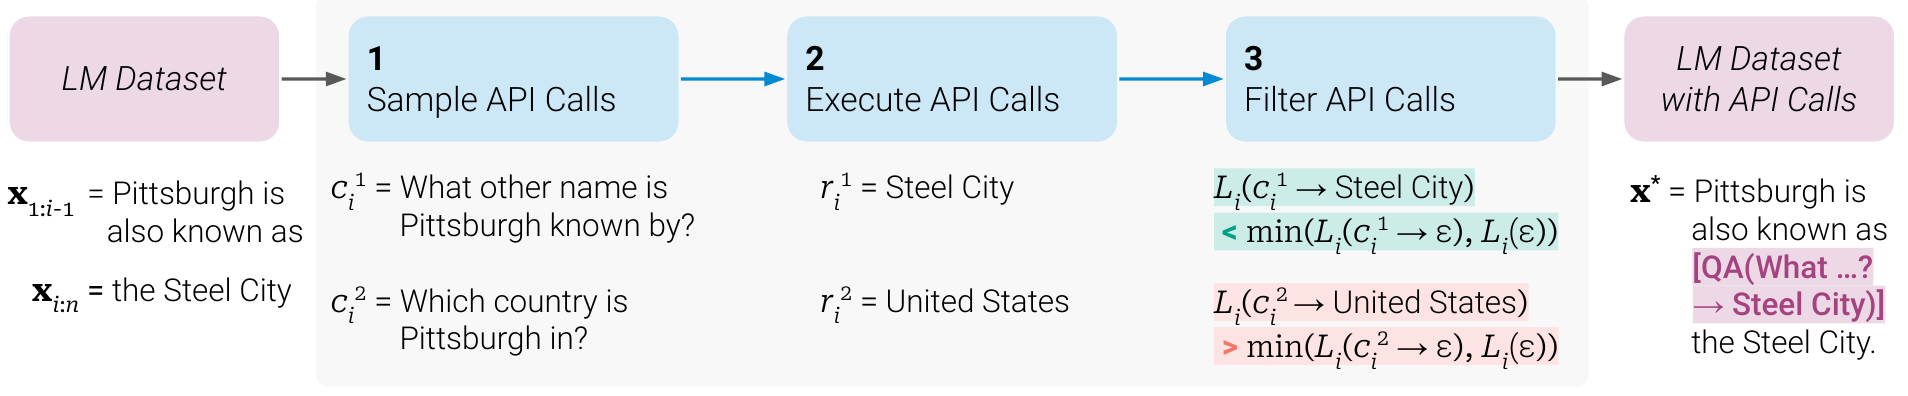
Tout le processus consiste à retravailler un jeu de données ordinaire d'entraînement de modèle de langage. Le jeu d'origine, , n'est que du texte brut ; les auteurs y font insérer des appels d'outils par le modèle, obtiennent un nouveau jeu , puis s'en servent pour fine-tuner le modèle lui-même.
1. Échantillonner des appels
Chaque outil a son propre prompt, avec quelques démonstrations. Voici celui de l'outil de questions-réponses :
Your task is to add calls to a Question Answering API to a piece of text.
The questions should help you get information required to complete the text.
You can call the API by writing "[QA(question)]" where "question" is the
question you want to ask. Here are some examples of API calls:
Input: Joe Biden was born in Scranton, Pennsylvania.
Output: Joe Biden was born in [QA("Where was Joe Biden born?")] Scranton,
[QA("In which state is Scranton?")] Pennsylvania.
Input: Coca-Cola, or Coke, is a carbonated soft drink manufactured by
the Coca-Cola Company.
Output: Coca-Cola, or [QA("What other name is Coca-Cola known by?")] Coke,
is a carbonated soft drink manufactured by [QA("Who manufactures Coca-Cola?")]
the Coca-Cola Company.
Input: x
Output:
Prompt de la Figure 3 de l'article.
On place un texte dans le prompt et l'on calcule, pour chaque position , la probabilité que le modèle commence à écrire <API> à cet endroit. On garde les positions dont la probabilité dépasse le seuil , au plus ; pour chacune, on échantillonne ensuite au plus appels.
2. Exécuter les appels
Les auteurs prévoient cinq outils, dont les entrées et les sorties sont du texte :
| Outil | Exemple d'entrée | Exemple de sortie |
|---|---|---|
| Questions-réponses | Where was the Knights of Columbus founded? | New Haven, Connecticut |
| Recherche Wikipédia | Fishing Reel Types | Un extrait de Wikipédia sur les types de cannes et de moulinets |
| Calculatrice | 27 + 4 * 2 | 35 |
| Calendrier | (aucune entrée) | Today is Monday, January 30, 2023. |
| Traduction | sûreté nucléaire | nuclear safety |
D'après la Table 1 de l'article.
- Questions-réponses : Atlas, un modèle de langage fine-tuné sur Natural Questions, qui récupère des documents avant de répondre.
- Recherche Wikipédia : une recherche BM25 sur le Wikipédia de KILT, qui renvoie de courts extraits.
- Calculatrice : les quatre opérations seulement, avec un résultat arrondi à deux décimales.
- Calendrier : aucune entrée ; renvoie la date du jour.
- Traduction : NLLB, avec 600M de paramètres ; fastText détecte automatiquement la langue source, et tout est traduit en anglais.
3. Filtrer : l'appel a-t-il vraiment aidé ?
C'est l'étape la plus importante de l'article. Les auteurs se servent de la perte du modèle lui-même pour juger si un appel est utile.
Soit l'entropie croisée pondérée des prédictions du modèle sur les tokens qui suivent la position , lorsqu'on fait précéder le texte de :
On compare ensuite deux situations :
correspond à un appel accompagné de son résultat ; à l'absence d'appel ou à un appel sans résultat, en retenant la meilleure des deux. Seuls les appels tels que sont conservés.
La comparaison avec « appel sans résultat » sert à écarter un cas particulier. Parfois, le simple fait d'écrire la question suffit à suggérer la suite du texte ; le mérite d'un tel appel ne revient pas à l'outil, et il ne doit pas être conservé.
Les poids s'obtiennent en normalisant ; les poids bruts du 1er au 5e token après l'appel valent successivement 1, 0.8, 0.6, 0.4 et 0.2, puis 0 au-delà. Plus un token est proche, plus il pèse, de sorte que l'appel apparaisse là où l'information sert vraiment. Prenons la phrase « Pittsburgh is also known as the Steel City ». Si l'on insère avant the un appel de questions-réponses qui renvoie « Steel City », le modèle est presque certain que le mot suivant est Steel, la perte chute, et l'appel est conservé ; demander dans quel pays se trouve Pittsburgh et obtenir « United States » n'aide en rien à prédire « the Steel City », et l'appel est écarté.
Le filtrage cache encore un détail. À ce stade, le modèle n'a jamais vu d'appel d'outil ; insérer l'appel de force au milieu d'une phrase en casserait la fluidité et ferait au contraire monter la perplexité. Pour calculer , les auteurs placent donc l'appel et son résultat tout au début du texte, en préfixe.
4. Fine-tuning
Les appels conservés pour les différents outils sont fusionnés et réinsérés dans le texte d'origine, ce qui donne . Hormis les appels ajoutés, le texte de est strictement identique à celui de ; en s'y fine-tunant, le modèle voit donc les mêmes connaissances qu'avant, et ses capacités linguistiques ne devraient pas en souffrir.
Le texte est un sous-ensemble de CCNet, et le modèle est GPT-J 6B. Pour économiser le calcul nécessaire à l'annotation, les auteurs sélectionnent d'abord par des règles les textes les plus susceptibles de nécessiter un outil ; la calculatrice, par exemple, ne traite que des passages contenant au moins trois nombres. Le fine-tuning utilise une taille de lot de 128, un taux d'apprentissage de et un échauffement linéaire sur les premiers 10 % des pas.
Le nombre d'appels conservés varie selon l'outil. Avec un seuil de filtrage , on obtient 60 974 appels pour la recherche Wikipédia, 20 587 pour le calendrier, 18 526 pour les questions-réponses, 1 034 pour la traduction, et seulement 994 pour la calculatrice.
Inférence
Après le fine-tuning, on décode normalement. Quand le modèle écrit « → », c'est qu'il attend le résultat d'un outil ; on suspend alors le décodage, on appelle réellement l'outil, on ajoute le résultat suivi de « ] », puis on laisse le modèle reprendre. Par exemple, le décodage s'arrête quand le modèle a écrit « [Calculator(400 / 1400) → » ; la calculatrice renvoie 0.29, on ajoute « 0.29] », et le modèle continue avec « 29% ».
Le décodage est aussi modifié sur deux points. Dès que <API> figure parmi les 10 tokens les plus probables, le modèle commence un appel, sans qu'il soit nécessaire que ce token arrive en tête, pour l'encourager à se servir davantage des outils ; et chaque entrée n'a droit qu'à un appel au plus, pour éviter que le modèle tourne en boucle à appeler des outils sans jamais écrire de réponse.
Discussion
Dispositif expérimental
Quatre modèles sont comparés en priorité : le GPT-J d'origine ; GPT-J + CC, fine-tuné sur le même texte de CCNet mais sans appels d'outils ; Toolformer ; et Toolformer avec la probabilité de <API> fixée à 0, donc privé d'outils. La comparaison inclut aussi OPT 66B et GPT-3 175B (davinci, sans fine-tuning sur instructions).
Tout se fait en zero-shot ; la tâche est décrite en texte, sans exemple, et l'on ne dit pas au modèle quel outil utiliser. La notation est assez souple ; par exemple, une réponse compte comme juste si elle figure parmi les premiers mots de la sortie du modèle.
Résultats
| Tâche | GPT-J | Sans outils | Toolformer | GPT-3 175B |
|---|---|---|---|---|
| LAMA SQuAD | 17.8 | 22.1 | 33.8 | 26.8 |
| LAMA Google-RE | 4.9 | 6.3 | 11.5 | 7.0 |
| LAMA T-REx | 31.9 | 34.9 | 53.5 | 39.8 |
| ASDiv | 7.5 | 14.8 | 40.4 | 14.0 |
| SVAMP | 5.2 | 6.3 | 29.4 | 10.0 |
| MAWPS | 9.9 | 15.0 | 44.0 | 19.8 |
| WebQS | 18.5 | 18.9 | 26.3 | 29.0 |
| Natural Questions | 12.8 | 12.6 | 17.7 | 22.6 |
| TriviaQA | 43.9 | 46.7 | 48.8 | 65.9 |
| TempLAMA | 13.7 | 12.7 | 16.3 | 15.5 |
| Dateset | 3.9 | 5.9 | 27.3 | 0.8 |
D'après les Tables 3, 4, 5 et 7 de l'article ; « Sans outils » désigne Toolformer avec les appels d'API interdits ; valeurs en %.
Questions de connaissances à trous (LAMA) : sur 98.1 % des questions, le modèle va de lui-même interroger l'outil de questions-réponses, et il bat GPT-3 sur les trois sous-ensembles. Comme les phrases de LAMA viennent de Wikipédia, la recherche Wikipédia est désactivée ici, pour ne pas rendre la tâche trop facile.
Problèmes de maths : la calculatrice est appelée sur 97.9 % des problèmes, et les scores font plus que doubler par rapport à la version sans outils, loin devant GPT-3. Curieusement, Toolformer sans outils fait déjà mieux que GPT-J ; selon les auteurs, après avoir vu beaucoup d'opérations accompagnées de leur résultat, le modèle s'est lui-même amélioré en calcul.
Questions ouvertes : l'outil de questions-réponses a été fine-tuné sur Natural Questions, et s'en servir reviendrait à tricher ; il est donc désactivé. Le modèle se rabat sur la recherche Wikipédia dans 99.3 % des cas et bat les autres GPT-J, mais reste derrière GPT-3. Les auteurs y voient deux raisons. Le moteur de recherche BM25, rudimentaire, renvoie souvent des résultats hors sujet, et Toolformer ne sait ni reformuler sa requête ni regarder plus loin dans les résultats.
Questions temporelles : Dateset demande de connaître la date du jour pour répondre, par exemple « Quel jour de la semaine était-on il y a 30 jours ? » ; le calendrier est utilisé sur 54.8 % des questions, et le score passe de 5.9 % à 27.3 %. TempLAMA porte sur des faits qui changent avec le temps, comme l'équipe dans laquelle joue un joueur ; Toolformer y progresse aussi, mais n'utilise le calendrier que sur 0.2 % des questions et s'appuie surtout sur la recherche et les questions-réponses. Le mieux serait de chercher d'abord la date, puis de poser la question avec cette date, mais chaque question n'a droit qu'à un appel, et comme les appels des données d'entraînement ont été échantillonnés outil par outil, le modèle n'a jamais vu ce genre d'enchaînement.
Questions-réponses multilingues (MLQA) : les questions sont en arabe, allemand, espagnol, hindi, vietnamien ou chinois simplifié, et le paragraphe de contexte est en anglais. Selon la langue, le modèle traduit d'abord la question en anglais pour 63.8 % à 94.9 % des questions, et fait mieux que sans outils ; le hindi fait exception, avec seulement 7.3 % de traductions. Toolformer ne bat pas pour autant régulièrement le GPT-J d'origine, car le fine-tuning sur CCNet a lui-même dégradé certaines langues.
Pas de perte en modélisation du langage
| Modèle | WikiText | CCNet |
|---|---|---|
| GPT-J | 9.9 | 10.6 |
| GPT-J + CC | 10.3 | 10.5 |
| Toolformer (sans outils) | 10.3 | 10.5 |
D'après la Table 8 de l'article ; les valeurs sont des perplexités, plus elles sont basses, mieux c'est.
Le fine-tuning sur CCNet dégrade légèrement la perplexité sur WikiText, mais la présence ou non d'appels d'outils n'y change rien. La perplexité avec outils activés, elle, est impossible à calculer, car chaque position pourrait donner lieu à un appel de n'importe quel outil, et il faudrait sommer sur toutes les possibilités pour obtenir une probabilité.
Quelle taille faut-il pour apprendre ?
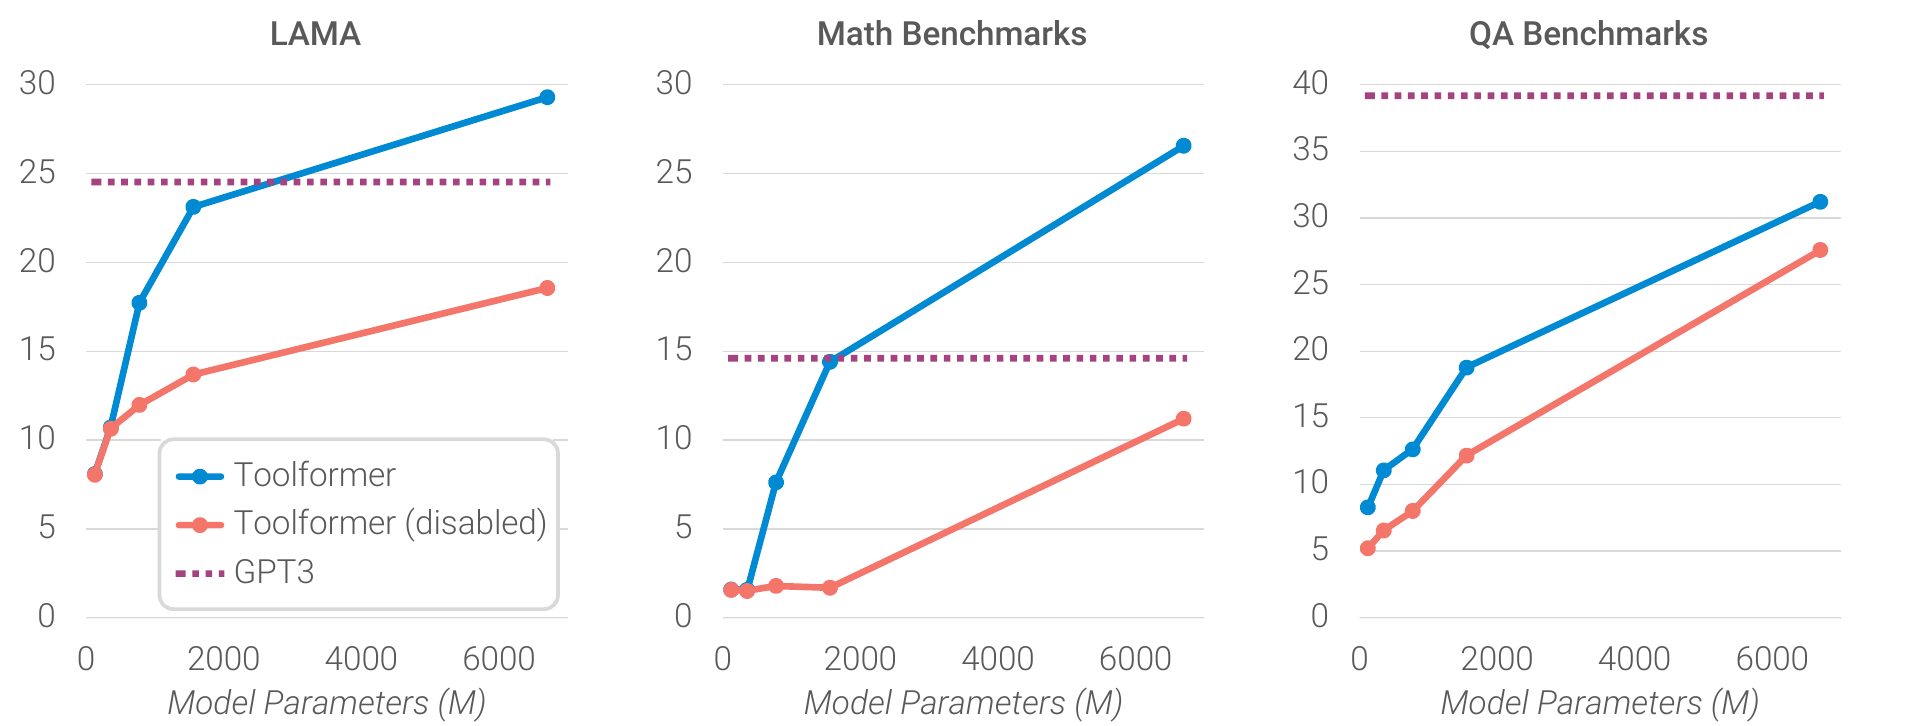
Les auteurs refont l'expérience avec quatre tailles de GPT-2, en ne fournissant que trois outils, les questions-réponses, la calculatrice et la recherche Wikipédia. La capacité à utiliser les outils n'apparaît que vers 775M de paramètres ; en dessous, les modèles font à peu près aussi bien avec ou sans outils. La recherche Wikipédia fait exception, et même les petits modèles en tirent parti ; les auteurs supposent que c'est parce que cette API est plus simple. Quand le modèle grandit, il devient meilleur sans outils, mais aussi dans l'usage des outils, si bien que l'écart entre les deux persiste.
Le seuil de décodage
| T-REx | Taux d'appel | WebQS | Taux d'appel | |
|---|---|---|---|---|
| 0 | 34.9 | 0.0% | 18.9 | 0.0% |
| 1 | 47.8 | 40.3% | 19.3 | 8.5% |
| 3 | 52.9 | 82.8% | 26.3 | 99.3% |
| 10 | 53.5 | 98.1% | 26.3 | 100% |
D'après la Table 9 de l'article, sélection de colonnes ; les colonnes T-REx et WebQS donnent la précision (%).
est le rang que <API> doit atteindre pour qu'un appel commence ; revient à désactiver les outils, et correspond au décodage glouton ordinaire. Avec le décodage glouton ordinaire, le modèle n'appelle un outil que sur 8.5 % des questions de WebQS, et le score ne bouge presque pas ; il faut élargir le seuil aux 3 premiers rangs pour qu'il se mette à s'en servir massivement.
Avec , sur les questions où le modèle décide de ne pas appeler d'outil, le score (44.3 % sur T-REx, 19.9 % sur WebQS) est même supérieur à la moyenne obtenue quand les outils sont complètement interdits (34.9 % et 18.9 %). Le modèle sait donc plus ou moins quelles questions le dépassent, et réserve les outils à celles-là. Quand on élargit le seuil, ce discernement disparaît.
À quoi ressemblent les appels conservés
Les auteurs listent quelques exemples triés par score de filtrage décroissant. Les scores élevés correspondent le plus souvent à des appels sensés, comme une recherche sur Flodden à propos du plus ancien vitrail commémoratif de guerre du Royaume-Uni, avec un score de 5.49, ou une question sur la longueur du Nil après « The Nile has an approximate length of », avec un score de 2.08.
Les scores bas correspondent surtout à des appels inutiles, comme le calcul de 85 / 23 après « 85 patients (23%) », avec un score de −0.02. Mais après « Catch this fast train to success! », une recherche sur « Fast train success » tombe sur une chanson de 1971 sans aucun rapport et fait pourtant baisser la perplexité, avec un score de 0.92. Les auteurs estiment qu'un peu de ce bruit n'est pas forcément un mal, puisqu'il apprend au modèle à ne pas croire aveuglément chaque résultat d'outil.
Limites
Les auteurs listent eux-mêmes les points suivants :
- Pas d'enchaînement d'outils : impossible, par exemple, de chercher la date puis de s'en servir pour poser une question, car les appels de chaque outil ont été échantillonnés séparément et les données d'entraînement ne contiennent aucun exemple de ce type.
- Pas d'interaction : un moteur de recherche peut renvoyer des centaines de résultats, mais le modèle ne sait ni les parcourir ni modifier sa requête.
- Sensibilité à la formulation : la décision d'appeler ou non un outil dépend facilement de la façon dont l'entrée est rédigée.
- Très peu efficace : traiter plus d'un million de documents ne donne que quelques milliers d'appels utiles à la calculatrice. Les auteurs suggèrent de procéder par itérations, comme d'autres méthodes de bootstrapping.
- Coût ignoré : le coût de calcul varie beaucoup d'un outil à l'autre, et le modèle n'en tient pas compte dans ses décisions.
La suite
Quatre mois après la publication de Toolformer, l'usage d'outils est devenu une fonctionnalité standard des modèles commerciaux, mais par une autre voie. Le 13 juin 2023, OpenAI ajoute le function calling à son API ; le développeur décrit ses fonctions en JSON, et quand le modèle juge qu'il en a besoin, il produit un objet JSON avec les arguments, que l'application exécute avant de renvoyer le résultat au modèle. Les outils sont définis par le développeur, et le modèle a appris pendant son entraînement à les appeler d'après leur description ; il n'a plus besoin de tâtonner seul dans du texte ordinaire.
L'enchaînement et l'interaction, que Toolformer listait parmi ses limites, sont devenus des capacités de base dans la boucle d'un agent ; le modèle appelle un outil, lit le résultat, décide de l'étape suivante, et une tâche peut demander des dizaines d'allers-retours. En novembre 2024, Anthropic propose le Model Context Protocol, un standard ouvert pour connecter les assistants d'IA à toutes sortes de sources de données et d'outils, et la façon de brancher les outils commence elle aussi à s'unifier.
Conclusion
Toolformer ne donne que quelques démonstrations par outil, laisse GPT-J insérer lui-même des appels d'outils dans du texte ordinaire, puis les filtre selon qu'ils rendent ou non la suite du texte plus facile à prédire. Après fine-tuning, ce modèle de 6B bat GPT-3 175B sur les questions de connaissances à trous, les problèmes de maths et les questions de dates, sans rien perdre en modélisation du langage.
Le choix le plus intéressant de l'article est de laisser le modèle juger lui-même de l'utilité d'un outil. Où insérer une question, quelle réponse aide, tout est décidé par la perte du modèle, sans que personne ne lui dise rien ; même l'appel qui a déniché la vieille chanson de 1971 n'a été conservé que parce que le modèle l'a jugé utile.
L'usage d'outils qui a suivi n'a pas repris cette autosupervision ; ce sont désormais les développeurs qui rédigent la description des outils, et le modèle les appelle en conséquence, ce qui est simple et contrôlable. Le format, lui, est resté. L'appel s'écrit dans le texte, le résultat y est réinséré, et le modèle reprend sa rédaction ; c'est ainsi que fonctionne chaque étape des agents d'aujourd'hui.